

For nogle måneder siden — en offentlig til PostgreSQL.
I mellemtiden har du allerede brugt det mere end 6000 gange, men en af de nyttige funktioner kan være forblevet uopdaget — det er struktureringstip, der ser omtrent sådan ud:
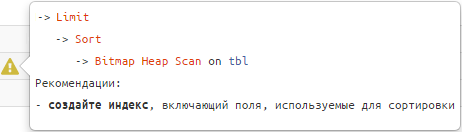
Lyt til dem, og dine forespørgsler vil "blive glatte og silkeagtige". 🙂
Og hvis vi snakker alvorligt, så er mange situationer, der gør en forespørgsel langsom og "ressourcekrævende", typiske og kan genkendes ud fra strukturen og dataene i planen..
I dette tilfælde behøver hver enkelt udvikler ikke at finde en optimeringsmulighed på egen hånd, kun baseret på sin egen erfaring — vi kan hjælpe ham med at forstå, hvad der sker, hvad der kan være årsagen, og hvordan man kan nærme sig løsningen. Det, vi har gjort.
Lad os se nærmere på disse tilfælde — hvordan de identificeres, og hvilke anbefalinger de fører til.
For at få en bedre forståelse af emnet kan du først lytte til det relevante afsnit fra , og derefter gå videre til en detaljeret analyse af hvert eksempel:
#1: индексная «недосортировка»
Når der opstår
Vis den seneste faktura for kunden "OOO Kolokolchik".
Hvordan man identificerer
-> Limit
   -> Sort
      -> Index [Only] Scan [Backward] | Bitmap Heap Scan
Anbefalinger
Den brugte indeks udvide med sorteringsfelter.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fakta"
, (random() * 1000)::integer fk_cli; -- 1K forskellige fremmede nøgler

CREATE INDEX ON tbl(fk_cli); -- indeks for fremmednøgle

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- filtrering på et specifikt forhold
ORDER BY
  pk DESC -- vi vil kun have én "seneste" post
LIMIT 1; 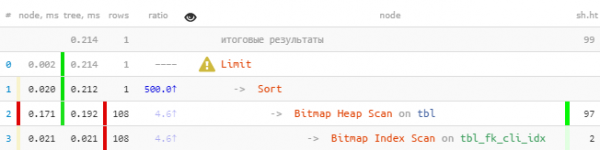
Man kan straks bemærke, at der blev læst mere end 100 poster fra indekset, som så blev sorteret, og der blev så kun tilbageholdt én.
Vi retter:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- tilføjet sorter nøgle
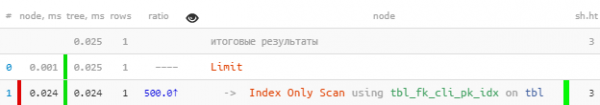
Selv med et så primitivt udtræk — vil det være 8,5 gange hurtigere og 33 gange færre læsninger.Effekten vil være mere mærkbar, jo flere "fakta" du har pr. værdi af fk.
Jeg bemærker, at denne indeks vil fungere som en "præfikse" ikke værre end den tidligere, og til andre forespørgsler med fk, hvor der ikke har været og ikke er sortering på pk kan læses og ). Det vil også sikre en normal understøttelse af eksplicit fremmednøgle for dette felt.
#2: пересечение индексов (BitmapAnd)
Når der opstår
Vis alle aftaler for kunden «OOO Kolokolchik», indgået på vegne af «NAO Lyutik».
Hvordan man identificerer
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Anbefalinger
Oprette sammensat index for felter fra begge kilder eller udvide en af de eksisterende med felter fra den anden.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakta"
, (random() *  100)::integer fk_org  -- 100 forskellige fremmednøgler
, (random() * 1000)::integer fk_cli; -- 1K forskellige fremmednøgler

CREATE INDEX ON tbl(fk_org); -- index for fremmednøgle
CREATE INDEX ON tbl(fk_cli); -- index for fremmednøgle

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- udvælgelse efter en specifik par 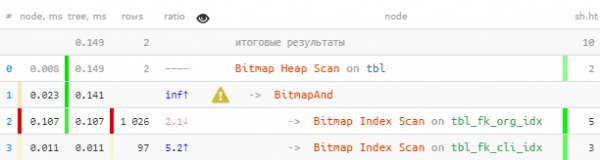
Vi retter:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
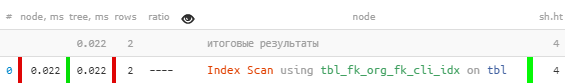
Her er gevinsten mindre, da Bitmap Heap Scan er effektiv i sig selv. Men alligevel 7 gange hurtigere og 2,5 gange færre læsninger.
#3: объединение индексов (BitmapOr)
Når der opstår
Vis de første 20 ældste "egne" eller ufordelte ansøgninger til behandling, hvor "egne" har prioritet.
Hvordan man identificerer
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Anbefalinger
Brug UNION [ALL] til at kombinere delspørgsmål for hver af OR-blokkene af betingelser.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fakta"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- med en sandsynlighed på 1:16 bliver optagelsen "uafgjort"
    ELSE (random() * 100)::integer -- 100 forskellige fremmednøgler
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index med "tilsyneladende passende" sortering

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- egne
  fk_own IS NULL -- ... eller "uafgjorte"
ORDER BY
  pk
, (fk_own = 1) DESC -- først "egne"
LIMIT 20;
Vi retter:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- først "egne" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- så "uafgjorte" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- men i alt - 20, der er ikke brug for mere 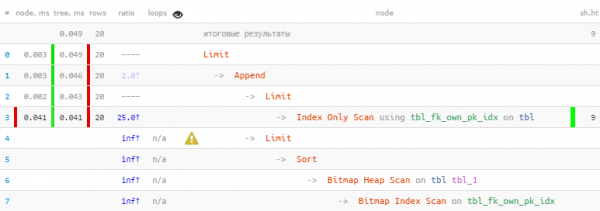
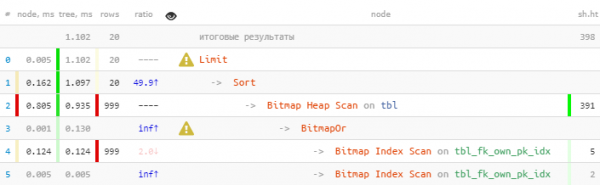
Vi udnyttede, at de 20 nødvendige poster allerede blev hentet i første blok, så den anden, med den mere "omkostningstunge" Bitmap Heap Scan, blev ikke engang udført — i sidste ende 22 gange hurtigere, med 44 gange færre læsninger!
En mere detaljeret fortælling om denne optimeringsmetode med konkrete eksempler kan læses i artiklerne og .
Generel version ordnet udvælgelse efter flere nøgler (og ikke kun efter et par const/NULL) er beskrevet i artiklen .
#4: читаем много лишнего
Når der opstår
Som regel opstår det ved ønsket om at "tilføje endnu et filter" til en allerede eksisterende forespørgsel.
"Har I ikke en sådan, men med perlemorsknapper?» film "Den diamantarm"
For eksempel, ved at modificere opgaven ovenfor, vis de første 20 ældste "kritiske" ansøgninger til behandling, uanset deres tildeling.
Hvordan man identificerer
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rækker 80% af læst
   && loops × RRbF > 100 -- og derudover mere end 100 poster i alt
Anbefalinger
Opret [mere] specialiseret indeks med WHERE-betingelse eller inkludere yderligere felter i indekset.
Hvis filtreringsbetingelsen er "statisk" for dine opgaver - det vil sige ikke forventer udvidelse af listen over værdier i fremtiden - er det bedre at bruge et WHERE-indeks. Forskellige boolean/enum-statusser passer godt ind i denne kategori.
Hvis filtreringsbetingelsen kan have forskellige værdier, er det bedre at udvide indekset med disse felter - ligesom i situationen med BitmapAnd ovenfor.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "fakta"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 forskellige fremmede nøgler
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, at ansøgningen er "kritisk"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 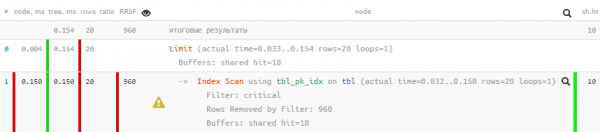
Vi retter:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- tilføjede "statisk" filtreringsbetingelse
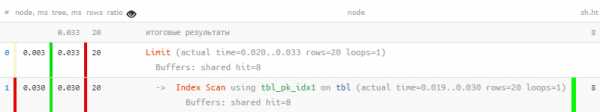
Som vi ser, er filtreringen fra planen helt forsvundet, og forespørgslen blev 5 gange hurtigere.
#5: разреженная таблица
Når der opstår
Forskellige forsøg på at lave en egen kø til behandling af opgaver, når et stort antal opdateringer/sletninger af poster i tabellen fører til en situation med mange "døde" poster.
Hvordan man identificerer
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rækker + RRbF)  64
Anbefalinger
Regelmæssigt manuelt udføre VACUUM [FULL] eller sikre, at det bliver udført hyppigt nok ved at finjustere dets parametre, herunder .
I de fleste tilfælde viser sådanne problemer sig at være forårsaget af dårlig strukturering af forespørgsler ved kald fra forretningslogik som dem, der blev diskuteret i .
Men man skal forstå, at selv VACUUM FULL ikke altid kan hjælpe. For sådanne tilfælde er det værd at se på algoritmen fra artiklen .
#6: чтение с «середины» индекса
Når der opstår
Det ser ud til, at vi har læst lidt, og alt er efter indekset, og ingen unødvendige blev filtreret - men stadig er der læst væsentligt flere sider, end ønsket.
Hvordan man identificerer
-> Index [Only] Scan [Backward]
   && loops × (rækker + RRbF)  64
Anbefalinger
Tag et grundigt kig på strukturen af den anvendte indeks og de nøglefelter, der er angivet i forespørgslen – sandsynligvis, er en del af indekset ikke angivet.Sandsynligvis bliver du nødt til at oprette et lignende indeks, men uden præfiksfelter eller .
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakta"
, (random() *  100)::integer fk_org  -- 100 forskellige fremmede nøgler
, (random() * 1000)::integer fk_cli; -- 1K forskellige fremmede nøgler

CREATE INDEX ON tbl(fk_org, fk_cli); -- alt næsten som i #2
-- blot har vi allerede anset et separat indeks på fk_cli for unødigt og fjernet det.

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- men fk_org er ikke angivet, selvom det står i indekset før
LIMIT 20; 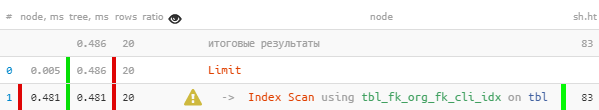
Det ser ud til at være i orden, selv med indekset, men det virker på en eller anden måde mistænkeligt – for hver af de 20 læste poster måtte vi udlæse 4 datasider, 32KB per post – er det for meget? Og navnet på indekset tbl_fk_org_fk_cli_idx giver anledning til overvejelser.
Vi retter:
CREATE INDEX ON tbl(fk_cli); 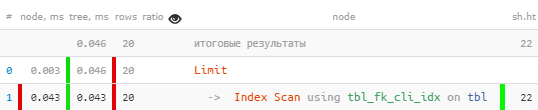
Pludselig – 10 gange hurtigere, og det kræver 4 gange mindre læsning.!
Andre eksempler på situationer med ineffektiv brug af indekser kan ses i artiklen .
#7: CTE × CTE
Når der opstår
I forespørgslen har vi indtastet "fed" CTE fra forskellige tabeller, og så besluttede vi at lave mellem dem JOIN.
Denne sag er relevant for versioner under v12 eller forespørgsler med WITH MATERIALIZED.
Hvordan man identificerer
-> CTE Scan
   && loops > 10
   && loops × (rows + RRbF) > 10000
      -- for stort cartesisk produkt af CTE.
Anbefalinger
Tag nøje analysere forespørgslen – er ? Если все-таки да, то anvende „ordbogsordning“ i hstore/json efter modellen beskrevet i .
#8: swap на диск (temp written)
Når der opstår
Bearbejdning (sortering eller unificering) af et stort antal poster passer ikke ind i den afsatte hukommelse.
Hvordan man identificerer
-> *
   && temp skrevet > 0
Anbefalinger
Hvis den anvendte hukommelse til operationen ikke overstiger den angivne værdi af parameteren , bør den justeres. Man kan gøre det straks i konfigurationen for alle eller via SET [LOCAL] for en specifik forespørgsel/transaktion.
Eksempel:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 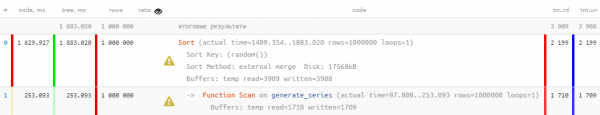
Vi retter:
SET work_mem = '128MB'; -- før udførelse af forespørgslen. 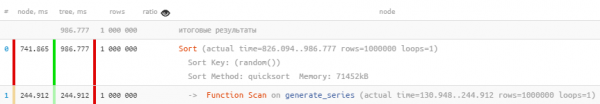
Af åbenlyse årsager, hvis der kun bruges hukommelse og ikke disk, vil forespørgslen køre meget hurtigere. Dette mindsker også belastningen på HDD.
Men man skal forstå, at man ikke altid kan afsætte meget og meget hukommelse – der er simpelthen ikke nok til alle.
#9: неактуальная статистика
Når der opstår
Databasen fyldtes med det samme, men vi nåede ikke at køre ANALYZE.
Hvordan man identificerer
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && ratio >> 10
Anbefalinger
Fortsæt med ANALYZE.
Yderligere er denne situation beskrevet i .
#10: «что-то пошло не так»
Når der opstår
Der opstod en låsevent, pålagt af en konkurrerende forespørgsel, eller der var ikke nok hardware-ressourcer i CPU/hypervisor.
Hvordan man identificerer
-> *
   && (delte hits / 8K) + (delte læsninger / 1K) < tid / 1000
      -- RAM hit = 64MB/s, HDD læs = 8MB/s
   && tid > 100ms -- vi læste lidt, men det tog for lang tid
Anbefalinger
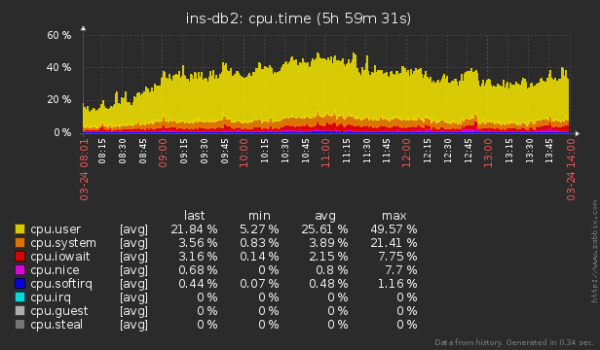
Brug et eksternt system til overvågning af serverne for blokeringer eller unormalt ressourceforbrug. Vi har allerede delt vores tilgang til, hvordan man organiserer denne proces for hundreder af servere. og .
Kilde: habr.com
