

Pakken tidyr er en del af kernen i et af de mest populære biblioteker på R-sproget — tidyverse.
Hovedformålet med pakken er at bringe data i et pænt format.
Der findes allerede en artikel på Habr, dedikeret til denne pakke, men den er dateret til 2015. Jeg vil gerne tale om de mest aktuelle ændringer, som dens forfatter Hadley Wickham netop har annonceret.
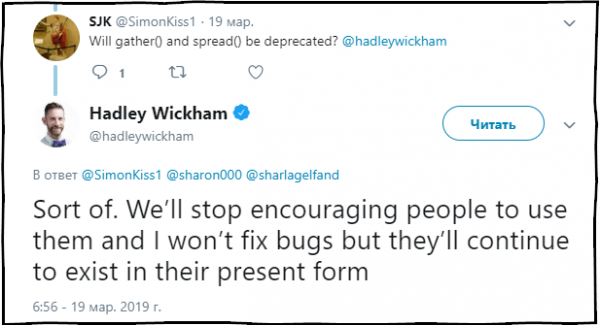
SJK: Vil funktionerne gather() og spread() blive forældede?
Hadley Wickham: I en vis grad. Vi vil stoppe med at anbefale brugen af disse funktioner og rette fejl i dem, men de vil fortsat være til stede i pakken i deres nuværende form.
Indhold
Hvis du er interesseret i dataanalyse, kan mine og kanaler være interessante for dig. Størstedelen af indholdet er dedikeret til R-sproget.
Konceptet TidyData
Formålet tidyr — at hjælpe dig med at bringe data i såkaldt pænt format. Pæne data er data, hvor:
- Hver variabel er i en søjle.
- Hver observation er en række.
- Hver værdi er en celle.
Data, der er bragt til tidy data, er betydeligt nemmere at arbejde med under analysemåling.
Hovedfunktionerne i tidyr-pakken
tidyr indeholder et sæt funktioner beregnet til at transformere tabeller:
fill()— fylder manglende værdier i en søjle med de foregående værdier;separate()— opdeler et felt i flere via en separator;unite()— udfører en operation om at samle flere felter til ét, svarende til funktionenseparate();pivot_longer()— funktionen der omdanner data fra bredt format til langt;pivot_wider()— funktionen der omdanner data fra langt format til bredt. Operationen er den omvendte af den, der udføres af funktionenpivot_longer().gather()forældet — funktionen der omdanner data fra bredt format til langt;spread()forældet — funktionen der omdanner data fra langt format til bredt. Operationen er den omvendte af den, der udføres af funktionengather().
Den nye koncept for transformation af data fra bredt format til langt og omvendt
Tidligere blev funktioner brugt til denne slags transformationer gather() og spread(). Gennem årene er det blevet tydeligt, at for de fleste brugere, inklusive pakken forfatter, var navnene på disse funktioner og deres argumenter ikke særlig intuitive og forårsagede vanskeligheder ved at finde og forstå, hvilken af disse funktioner der omdanner en data ramme fra bred til lang format og omvendt.
Af denne grund er der tidyr tilføjet to nye, vigtige funktioner, der er designet til at transformere data rammer.
De nye funktioner pivot_longer() og pivot_wider() er inspireret af nogle funktioner fra pakken cdata, skabt af John Mount og Nina Zumel.
Installation af den mest aktuelle version af tidyr 0.8.3.9000
For at installere den nyeste, mest aktuelle version af pakken tidyr 0.8.3.9000, hvor de nye funktioner er tilgængelige, brug følgende kode.
devtools::install_github("tidyverse/tidyr")
På tidspunktet for skrivningen er disse funktioner kun tilgængelige i dev versionen af pakken på GitHub.
Overgang til de nye funktioner
Det er faktisk ikke svært at konvertere gamle scripts til at arbejde med de nye funktioner, for bedre at forstå dette, tager jeg et eksempel fra dokumentationen for de gamle funktioner og viser, hvordan de samme operationer udføres med de nye pivot_*() funktioner.
Transformation fra bredt format til langt.
Eksempel på kode fra dokumentationen til funktionen gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Transformation fra langt format til bredt.
Eksempel på kode fra dokumentationen til funktionen spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Da der i de ovenstående eksempler arbejdes med pivot_longer() og pivot_wider(), er der i den oprindelige tabel stocks ingen kolonner nævnt i argumenterne names_to og values_to deres navne skal angives i citationstegn.
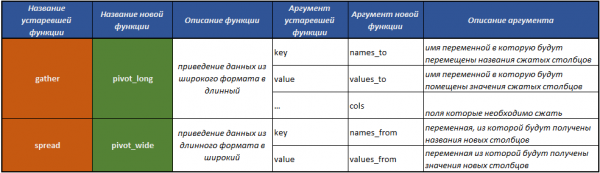
En tabel, som vil gøre det lettere for dig at forstå, hvordan du går over til at arbejde med det nye koncept tidyr.
Bemærkning fra forfatteren
Hele den efterfølgende tekst er en adaptiv, jeg ville endda sige fri oversættelse fra den officielle hjemmeside for tidyverse-biblioteket.
Et enkelt eksempel på transformation af data fra bredt format til langt
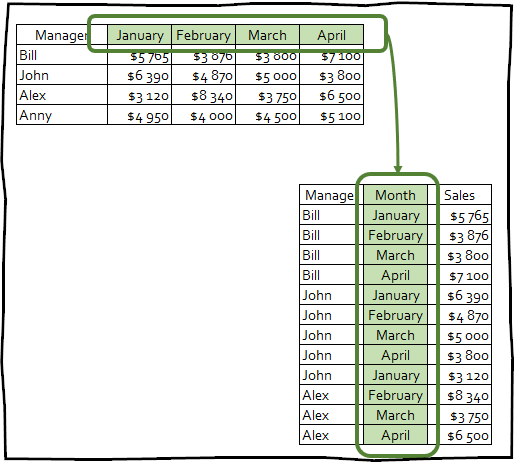
pivot_longer () — gør datasæt længere, ved at reducere antallet af kolonner og øge antallet af rækker.
For at udføre de eksempler, der præsenteres i artiklen, skal de nødvendige pakker først inkluderes:
library(tidyr)
library(dplyr)
library(readr)
Antag, at vi har en tabel med resultaterne af en undersøgelse, hvor der (blandt andet) blev spurgt folk om deres religion og årsindkomst:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Denne tabel indeholder data om respondenternes religion i rækkerne, mens indkomstniveauet er spredt over kolonnenavne. Antallet af respondenter fra hver kategori opbevares i celleværdierne på krydsningen mellem religion og indkomstniveau. For at få tabellen i et pænt, korrekt format er det nok at bruge pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # En tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostiker 2 Agnostiker 10-20k 34
#> 3 Agnostiker 20-30k 60
#> 4 Agnostiker 30-40k 81
#> 5 Agnostiker 40-50k 76
#> 6 Agnostiker 50-75k 137
#> 7 Agnostiker 75-100k 122
#> 8 Agnostiker 100-150k 109
#> 9 Agnostiker >150k 84
#> 10 Agnostiker Ved ikke/afvist 96
#> # … med 170 flere rækkerFunktionsargumenter pivot_longer()
- Det første argument cols, beskriver hvilke kolonner der skal samles. I dette tilfælde alle kolonner bortset fra time.
- Argumentet names_to giver et navn til den variabel, der vil blive oprettet ud fra kolonnenavnene, som vi har samlet.
- values_to giver et navn til den variabel, der vil blive oprettet ud fra dataene lagret i celleværdierne i de samlede kolonner.
Specificationer
Dette er den nye funktionalitet i pakken tidyr, som tidligere var utilgængelig, når man arbejdede med forældede funktioner.
Specificationen er et datasæt, hvor hver række svarer til en kolonne i det nye output-datasæt, og to specielle kolonner, der starter med:
- .name indeholder det oprindelige kolonnenavn.
- .value indeholder navnet på den kolonne, hvor celleværdierne vil blive placeret.
De øvrige kolonner i specifikationen afspejler hvordan kolonnenavne fra .name.
Specificationen beskriver metadataene gemt i kolonnenavnet, med en række for hver kolonne og en kolonne for hver variabel samlet med kolonnenavnet, det kan virke forvirrende nu, men efter at have gennemgået flere eksempler vil det blive meget klarere.
Meningen med specifikationen er, at du kan udtrække, ændre og angive nye metadata til den transformerede dataframe.
Den fungerer til at arbejde med specifikationer, når tabellen omformes fra bred til lang, og bruger funktionen pivot_longer_spec().
Hvordan denne funktion fungerer, er at den tager enhver dataframe og danner dens metadata som beskrevet ovenfor.
Som eksempel lad os tage datasættet who, som leveres med pakken tidyr. Dette datasæt indeholder oplysninger leveret af Verdenssundhedsorganisationen om forekomsten af tuberkulose.
who
#> # A tibble: 7.240 x 60
#>    land iso2  iso3   år ny_sp_m014 ny_sp_m1524 ny_sp_m2534
#>
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … med 7.230 flere rækker, og 53 flere variabler
Lad os bygge specifikationen.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsFelter land, iso2, iso3 er allerede variabler. Vores opgave er at vende kolonnerne med new_sp_m014 efter newrel_f65.
I navne på disse kolonner gemmes følgende oplysninger:
- Præfiks
new_angiver, at kolonnen indeholder data om nye tilfælde af tuberkulose; den nuværende dataramme indeholder kun oplysninger om nye sygdomstilfælde, så dette præfiks bærer ingen meningsfuld belastning i denne kontekst. sp/rel/sp/epbeskriver metoden til sygdomsdiagnose.m/fpatientens køn.014/1524/2535/3544/4554/65patientens aldersgruppe.
Vi kan adskille disse kolonner med funktionen extract(), ved brug af et regulært udtryk.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsBemærk, at kolonnen .name skal forblive uændret, da det er vores indeks i kolonnenavne fra det oprindelige datasæt.
Køn og alder (kolonnerne gender og age) har faste og kendte værdier, derfor anbefales det at konvertere disse kolonner til faktorer:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Endelig, for at anvende den specifikation, vi har oprettet, på den oprindelige dataramme who skal vi bruge argumentet spec i funktionen pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
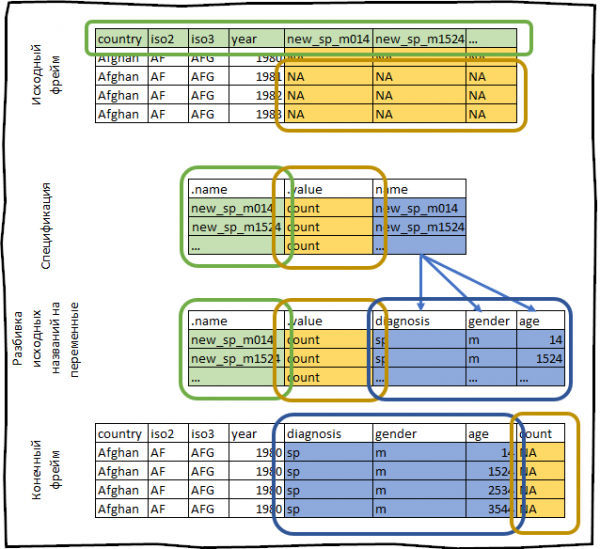
Alt, hvad vi lige har gjort, kan skematiseres som følger:
Specifikation med brug af flere værdier (.value)
I det ovenstående eksempel skal kolonnen for specifikationen .value indeholdt kun én værdi, hvilket ofte er tilfældet.
Men lejlighedsvis kan der opstå en situation, hvor det er nødvendigt at samle data fra kolonner med forskellige datatyper. Ved hjælp af den forældede funktion spread() ville det være temmelig vanskeligt at gøre.
Det følgende eksempel er hentet fra til pakken data.table.
Lad os oprette et træningsdataframe.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Det oprettede data frame indeholder for hver række oplysninger om børn i én familie. I familier kan der være ét eller to børn. For hvert barn gives der oplysninger om fødselsdato og køn, hvor dataene for hvert barn ligger i separate kolonner; vores opgave er at bringe disse data i et format, der er korrekt til analyse.
Bemærk, at vi har to variable med information om hvert barn: dets køn og fødselsdato (kolonner med præfikset dob indeholder fødselsdato, kolonner med præfikset gender indeholder barnets køn). I det forventede resultat skal de være i separate kolonner. Vi kan gøre dette ved at generere en specifikation, hvor kolonnen .value vil have to forskellige værdier.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Lad os tage det trin for trin, hvilke handlinger der udføres i den ovenfor nævnte kode.
pivot_longer_spec(-family)— vi opretter en specifikation, der komprimerer alle eksisterende kolonner undtagen kolonnen family.separate(col = name, into = c(".value", "child"))— vi opdeler kolonnen .name, som indeholder navne på de oprindelige felter, efter understregning og placerer de opnåede værdier i kolonnerne .value og child.mutate(child = parse_number(child))— vi konverterer værdierne i feltet child fra tekst til numerisk datatype.
Nu kan vi anvende den opnåede specifikation på det oprindelige dataframe og bringe tabellen i den ønskede form.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Vi bruger argumentet na.rm = TRUE, fordi den nuværende datamodel tvinger os til at oprette unødvendige rækker for ikke-eksisterende observationer. Da familie 2 kun har ét barn, na.rm = TRUE garanterer, at familie 2 vil have én række i outputtet.
Transformation af dataframes fra langt format til bredt
pivot_wider() — er den omvendte transformation og omvendt øger antallet af kolonner i dataframen ved at reducere antallet af rækker.
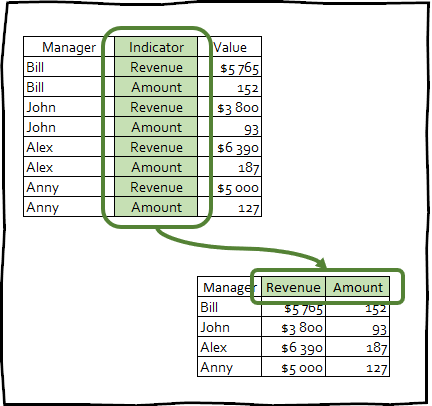
Denne type transformation bruges sjældent til at bringe data i et pænt format, men denne teknik kan være nyttig til at oprette pivottabeller til brug i præsentationer eller til integration med andre værktøjer.
I virkeligheden er funktionerne pivot_longer() og pivot_wider() symmetrisk og udfører modsatte handlinger, dvs: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) og df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) vil returnere den oprindelige df.
Det enkleste eksempel på at bringe en tabel til bredt format
For at demonstrere funktionen pivot_wider() vil vi bruge datasættet fish_encounters, som indeholder oplysninger om, hvordan forskellige stationer registrerer fiskebevægelser i floden.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
I de fleste tilfælde vil denne tabel være mere informativ og praktisk, hvis oplysningerne præsenteres i separate kolonner for hver station.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # En tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &;  &;  &;   &; &; &; &; &; &;
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … med 9 flere rækker, og 1 mere variabel: MAW
Dette datasæt registrerer kun oplysningerne, når fisken er blevet registreret af stationen, dvs. hvis en fisk ikke er blevet fanget af en station, vil der ikke være sådanne data i tabellen. Dette betyder, at outputtet vil blive fyldt med NA.
Men i dette tilfælde ved vi, at mangel på registrering betyder, at fisken ikke blev set, så vi kan bruge argumentet values_fill i funktionen pivot_wider() og udfylde disse manglende værdier med nuller:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generering af kolonnenavn ud fra flere oprindelige variabler
Forestil dig, at vi har en tabel, der indeholder en kombination af produkter, lande og år. For at generere et test datasæt kan du køre følgende kode:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsVores opgave er at udvide datasættet, så en kolonne indeholder data for hver kombination af produkt og land. For at gøre dette skal du blot sende til argumentet names_from en vektor, der indeholder navne på de kombinerede felter.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsDu kan også anvende specifikationerne til funktionen pivot_wider(). Men når den gives i pivot_wider() specificeringen udfører en transformation, der er modsat pivot_longer(): kolonner oprettes, som angivet i .name, ved brug af værdier fra .value og andre kolonner.
For dette datasæt kan du generere en brugerdefineret specifikation, hvis du ønsker, at hver mulig kombination af land og produkt skal have sin egen kolonne, ikke kun dem, der er til stede i dataene:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Flere avancerede eksempler på arbejde med det nye tidyr-koncept
Bringing data into a tidy format med eksemplet på datasæt om indkomst og husleje i USA
Datasættet us_rent_income indeholder oplysninger om gennemsnitsindkomsten og huslejen for hver stat i USA for 2017 (datasættet er tilgængeligt i pakken tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … med 94 flere rækker
I den form, som dataene er gemt i datasættet us_rent_income er det ekstremt besværligt at arbejde med dem, så vi ønsker at oprette et datasæt med kolonnerne: rent, rent_moe, come, income_moe. Der er mange måder at oprette denne specifikation på, men det vigtigste er, at vi skal generere hver kombination af variabelværdierne og estimate/moe, og derefter generere kolonnenavnet.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeAt give denne specifikation pivot_wider() giver os det resultat, vi søger:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Verdensbanken
Nogle gange kræver det flere skridt at få et datasæt i den ønskede form.
Datasæt world_bank_pop indeholder data fra Verdensbanken om befolkningen i hvert land fra 2000 til 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Vores mål er at skabe et pænt datasæt, hvor hver variabel er i sin egen kolonne. Det er stadig uklart, hvilke trin der er nødvendige, men vi begynder med det mest oplagte problem: året er fordelt over flere kolonner.
For at rette dette skal vi bruge funktionen pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsNæste skridt er at se på variablen indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Hvor SP.POP.GROW er befolkningstilvæksten, SP.POP.TOTL er den samlede befolkning, og SP.URB.* er det samme, men kun for byområder. Lad os opdele disse værdier i to variabler: area — område (total eller urban) og en variabel, der indeholder de faktiske data (population eller growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsNu er det kun tilbage at opdele variablen variable i to kolonner:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsKontaktliste
I det sidste eksempel, forestil dig at du har en kontaktliste, som du har kopieret og indsat fra en webside:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
At bringe denne liste ind i tabelform er ret vanskeligt, fordi der ikke er nogen variabel, der identificerer, hvilke data der tilhører hvilken kontakt. Vi kan rette dette ved at bemærke, at dataene for hver ny kontakt starter med navnet ("name"), så vi kan oprette en unik identifikator og øge den med én hver gang, der i kolonnen field mødes værdien “name”:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Nu, hvor vi har en unik identifikator for hver kontakt, kan vi dreje feltet og værdien til kolonner:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Konklusion
Personligt mener jeg, at det nye koncept tidyr er faktisk meget mere intuitivt og langt overgår de forældede funktioner spread() og gather(). Jeg håber, at denne artikel har hjulpet dig med at forstå pivot_longer() og pivot_wider().
Kilde: habr.com
