

Kube-scheduler er en uundgåelig komponent i Kubernetes, der er ansvarlig for at planlægge pods på noder i henhold til de angivne politikker. I mange tilfælde behøver vi ikke at tænke over, hvilke specifikke politikker der ligger til grund for planlægningen, da standardpolitikkerne for kube-scheduler er tilstrækkelige til de fleste daglige opgaver. Der opstår dog situationer, hvor vi har brug for mere finjusteret kontrol over fordelingen af pods, og der er to veje til at løse denne opgave:
- Oprette en kube-scheduler med et brugerdefineret sæt regler
- Skrive vores egen scheduler og lære den at arbejde med API-serverens anmodninger
I denne artikel vil jeg beskrive implementeringen af den første mulighed for at løse problemet med ujævn planlægning af pods i et af vores projekter.
Kort introduktion til kube-schedulerens arbejde
Det er særligt vigtigt at bemærke, at kube-scheduler ikke er ansvarlig for den direkte planlægning af pods — det er kun ansvarligt for at bestemme, hvilken node der skal placeres en pod på. Med andre ord er resultatet af kube-schedulerens arbejde navnet på den node, som det returnerer til API-serveren ved anmodning om planlægning, og hermed slutter dets arbejde.
Først opretter kube-scheduler en liste over de noder, hvor en pod kan planlægges i henhold til predicates politikker. Derefter tildeles hver node på denne liste et bestemt antal point i henhold til prioriteringspolitikkerne. I sidste ende vælges den node, der har fået det højeste antal point. Hvis flere noder har opnået den samme maksimale score, vælges en tilfældig node. Du kan finde listen og beskrivelsen af predicates (filtrering) og prioriteringspolitikker (scoring) i .
Beskrivelse af problemets kerne
På trods af det store antal forskellige Kubernetes-klynger, som Nixys varetager, stødte vi først på problemet med pod-planlægning for nylig, da et af vores projekter skulle køre et stort antal periodiske opgaver (~100 CronJob-empfærdigheder). For at forenkle beskrivelsen af problemet, lad os tage et eksempel på en mikrotjeneste, hvor der hver minut kører en cron-opgave, der skaber en vis belastning på CPU'en. Tre fuldstændig identiske noder (24 vCPU hver) blev tildelt til at køre cron-opgaven.
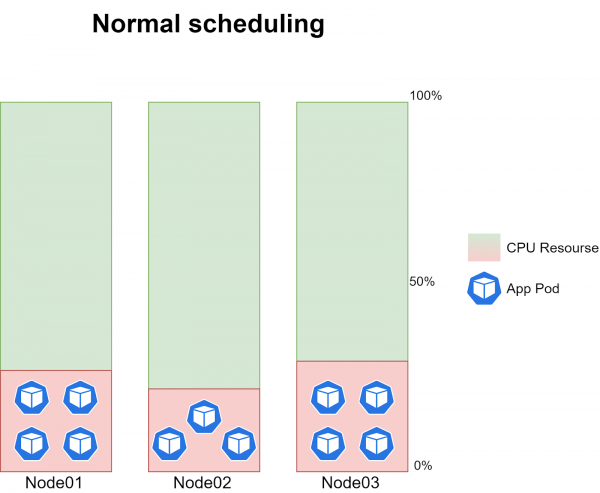
Det kan ikke præcist fastslås, hvor lang tid en CronJob vil tage, da mængden af inddata konstant ændrer sig. I gennemsnit kører der 3-4 instanser af opgaven på hver node ved normal drift af kube-scheduler, hvilket skaber ca. 20-30% belastning på CPU'en på hver node.
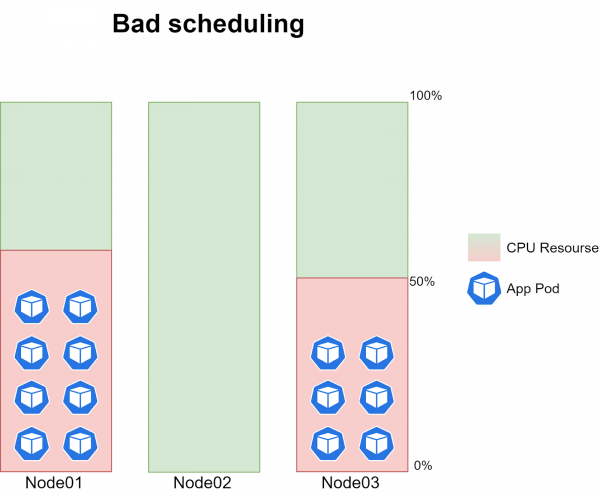
Problemet ligger i, at pods fra cron-jobbet nogle gange ikke blev planlagt på en af de tre noder. Det vil sige, at på et givent tidspunkt blev der ikke planlagt nogen pods på en node, mens der på de to andre noder kørte 6-8 instanser af opgaven, hvilket skabte ca. 40-60% belastning på CPU'en.
Problemet opstod med en helt tilfældig periodisk forekomst og korrelerede sjældent med, hvornår en ny version af koden blev rullet ud.
Ved at hæve logningsniveauet for kube-scheduler til niveau 10 (-v=10) begyndte vi at registrere, hvor mange point hver node opnåede under vurderingsprocessen. Ved normal planlægning kunne man se følgende oplysninger i loggene:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1387 millicores 4161694720 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1347 millicores 4444810240 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1387 millicores 4161694720 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1687 millicores 4790840320 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1347 millicores 4444810240 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1687 millicores 4790840320 memory bytes, score 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node01 -> Score 100043
generic_scheduler.go:781] Host Node02 -> Score 100043
generic_scheduler.go:781] Host Node03 -> Score 100043
Det vil sige, at hvis man kigger på informationerne fra loggene, scorede hver af noderne det samme antal samlede point, og en tilfældig node blev valgt til planlægningen. På tidspunktet for det problematiske planlægning så loggene således ud:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 hukommelsesbytes, total anmodning 1587 millicores 4581125120 hukommelsesbytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 hukommelsesbytes, total anmodning 1087 millicores 3532549120 hukommelsesbytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 hukommelsesbytes, total anmodning 1587 millicores 4581125120 hukommelsesbytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 hukommelsesbytes, total anmodning 987 millicores 3322833920 hukommelsesbytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 hukommelsesbytes, total anmodning 987 millicores 3322833920 hukommelsesbytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 hukommelsesbytes, total anmodning 1087 millicores 3532549120 hukommelsesbytes, score 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node03 -> Score 100041
generic_scheduler.go:781] Host Node02 -> Score 100041
generic_scheduler.go:781] Host Node01 -> Score 100038
Det fremgår, at en af noderne scorede færre samlede point end de andre, og derfor blev planlægningen kun udført på de to noder, der opnåede den maksimale score. På denne måde har vi bekræftet, at problemet ligger i planlægningen af podene.
Den videre algoritme til løsning af problemet var åbenlys for os — vi skulle analysere loggene, forstå hvilken prioritet noden ikke fik point for, og om nødvendigt justere politikkerne for den standard kube-scheduler. Men her stødte vi på to væsentlige udfordringer:
- På det maksimale logningsniveau (10) vises scoresæt kun for nogle prioriteringer. I det ovenfor nævnte loguddrag kan man se, at for alle prioriteringer, der fremgår i loggen, får noderne det samme antal point ved normal og problematisk planlægning, men det endelige resultat adskiller sig i tilfældet med problematisk planlægning. Derfor kan man konkludere, at for nogle prioriteringer sker pointtællingen “off-screen”, og vi har ingen mulighed for at forstå, hvilken specifik prioritet noden ikke fik point for. Dette problem har vi detaljeret beskrevet i Kubernetes-repositoriet på Github. På tidspunktet for artiklens skrivning havde vi modtaget et svar fra udviklerne om, at logningssupport ville blive tilføjet i opdateringerne af Kubernetes v1.15, v1.16 og v1.17.
- Der er ingen simpel måde at forstå, hvilken specifik politik konfiguration kube-scheduler aktuelt arbejder med. Ja, listen er nævnt, men der er ingen information om, hvilke specifikke vægte der er tildelt hver af prioriteringspolitikkerne. Man kan kun se vægtene eller redigere politikkerne for den standard kube-scheduler i Det skal bemærkes, at vi én gang lykkedes at fastslå, at noden ikke fik point for politikken ImageLocalityPriority, der tildeler point til noden, hvis den allerede har det billede, der er nødvendigt for at køre applikationen. D.v.s. på tidspunktet for udrulning af den nye version af applikationen, kunne cron-opgaven nå at køre på to noder, mens den hentede det nye billede fra docker registry, og derved fik de to noder en højere samlet score i forhold til den tredje. .
Det skal bemærkes, at vi én gang har oplevet, at noden ikke opnåede point under politikken ImageLocalityPriority, som tildeler point til noden, hvis den allerede har det billede, der er nødvendigt for at starte applikationen. Det vil sige, at i øjeblikket for udrulning af den nye version af applikationen, lykkedes det cron-opgaven at starte på to noder, hvor den hentede det nye billede fra docker registry, og derved opnåede de to noder en højere samlet score i forhold til den tredje.
Som jeg allerede har nævnt ovenfor, ser vi ikke information om evalueringen af politikken ImageLocalityPriority i loggene. For at bekræfte vores antagelse, deployerede vi et billede med den nye version af applikationen til den tredje node, hvorefter planlægningen fungerede korrekt. Problemet med planlægning blev faktisk sjældent observeret på grund af politikken ImageLocalityPriority; oftere var det relateret til noget andet. Da vi ikke kunne debugge hver af politikkerne i listen over prioriteringer fra den standard kube-scheduler, opstod der et behov for fleksibel administration af pod-planlægningspolitikker.
Problemformulering
Vi ønskede, at løsningen på problemet skulle være så præcis som mulig, hvilket betyder, at de vigtigste enheder i Kubernetes (her refereres til den standard kube-scheduler) skulle forblive uændrede. Vi ville ikke løse problemet ét sted og skabe det et andet sted. Derfor kom vi frem til to løsningsmuligheder, som blev nævnt i indledningen af artikel - oprettelse af en ekstra scheduler eller skrivning af vores egen. Hovedkravet til planlægning af cron-opgaver er en jævn fordeling af belastningen på de tre noder. Dette krav kan imødekommes med de eksisterende politikker fra kube-scheduler, så der er ikke nogen mening i at skrive vores egen scheduler til vores opgave.
Instruktionen til oprettelse og Deployment af den ekstra kube-scheduler er beskrevet i . Vi mente dog, at Deployment-enhederne ikke var tilstrækkelige til at sikre fejltolerance for en så kritisk service som kube-scheduler, så vi besluttede at implementere den nye kube-scheduler som Static Pod, som Kubelet direkte vil overvåge. Dermed har vi følgende krav til den nye kube-scheduler:
- Servicen skal implementeres som Static Pod på alle mastere i klyngen
- Der skal være sikret fejltolerance i tilfælde af, at den aktive pod med kube-scheduler ikke er tilgængelig
- Det primære fokus ved planlægning skal være mængden af tilgængelige ressourcer på noden (LeastRequestedPriority)
Implementeringen af løsningen
Det skal straks nævnes, at alle arbejdet vil blive udført i Kubernetes v1.14.7, da det præcist var denne version, der blev brugt i projektet. Lad os starte med at skrive manifestet for vores nye kube-scheduler. Vi tager udgangspunkt i manifestet for standarden (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) og bringer det til følgende form:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Kort om de vigtigste ændringer:
- Vi har ændret navnet på pod'en og containeren til kube-scheduler-cron
- Vi angav brug af portene 10151 og 10159, da denne mulighed er defineret
hostNetwork: trueog vi kan ikke bruge de samme porte som standard kube-scheduler (10251 og 10259) - Ved hjælp af parameteren —config angav vi konfigurationsfilen, som tjenesten skal starte med
- Vi har konfigureret montering af konfigurationsfilen (scheduler-custom.conf) og planen for politikker (scheduler-custom-policy-config.json) fra værten
Husk, at vores kube-scheduler kræver rettigheder svarende til standarden. Redigerer dens cluster-rolle:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Lad os nu tale om, hvad der skal findes i konfigurationsfilen og filen med planlægningspolitikker:
- Konfigurationsfil (scheduler-custom.conf)
For at få konfigurationen af den standard kube-scheduler skal du bruge parameteren--write-config-toaf . Den opnåede konfiguration placeres i filen /etc/kubernetes/scheduler-custom.conf og bringes i følgende form:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Kort om de vigtigste ændringer:
- Vi har angivet navnet på vores tjeneste kube-scheduler-cron i schedulerName.
- I parameteren
lockObjectNameskal vi også angive navnet på vores tjeneste og sørge for, at parameterenleaderElecter sat til true (i tilfælde af at du har en enkelt master-node, kan du sætte den til false). - Vi har angivet stien til filen med beskrivelsen af planlægningspolitikker i parameteren
algorithmSource.
Lad os uddybe det andet punkt, hvor vi redigerer parametrene for nøgleordet leaderElection. For at sikre høj tilgængelighed aktiverede vi (leaderElect) processen til valg af leder (master) mellem pods af vores kube-scheduler ved hjælp af en fælles endpoint (resourceLock) med navnet kube-scheduler-cron (lockObjectName) i navnerummet kube-system (lockObjectNamespace). Du kan finde ud af, hvordan Kubernetes sikrer høj tilgængelighed for essentielle komponenter (herunder kube-scheduler) i .
- Planlægningspolitiker filen (scheduler-custom-policy-config.json)
Som jeg nævnte tidligere — vi kan kun finde ud af, hvilke specifikke politikker den standard kube-scheduler arbejder med ved at analysere dens kode. Det vil sige, vi kan ikke få filen med planlægningspolitikker fra den standard kube-scheduler ligesom med konfigurationsfilen. Lad os beskrive de politikker, vi er interesserede i, i filen /etc/kubernetes/scheduler-custom-policy-config.json som følger:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Således laver kube-scheduler først en liste over noder, hvorpå en pod kan planlægges i henhold til politikken GeneralPredicates (som inkluderer et sæt politikker som PodFitsResources, PodFitsHostPorts, HostName og MatchNodeSelector). Derefter evalueres hver node i henhold til et sæt politikker i prioritetsarrayet. For at opfylde kravene i vores opgave har vi anset et sådant sæt politikker for at være den optimale løsning. Jeg minder om, at sæt af politikker med deres detaljerede beskrivelse er tilgængelige i . For at udføre din opgave kan du simpelthen ændre det sæt politikker, der anvendes, og tildele deres tilsvarende vægte.
Manifestet for den nye kube-scheduler, som vi lavede i begyndelsen af kapitlet, vil vi kalde kube-scheduler-custom.yaml og placere det på den følgende sti /etc/kubernetes/manifests på de tre master-noder. Hvis alt er gjort korrekt, vil Kubelet på hver node starte en pod, og i loggen for vores nye kube-scheduler vil vi se oplysninger om, at vores politikfile er blevet anvendt med succes:
Oprettelse af scheduler fra konfiguration: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registrering af predikat: GeneralPredicates
Predikattypen GeneralPredicates er allerede registreret, hvilket genbruges.
Registrering af prioritet: ServiceSpreadingPriority
Prioritetstypen ServiceSpreadingPriority er allerede registreret, hvilket genbruges.
Registrering af prioritet: EqualPriority
Prioritetstypen EqualPriority er allerede registreret, hvilket genbruges.
Registrering af prioritet: LeastRequestedPriority
Prioritetstypen LeastRequestedPriority er allerede registreret, hvilket genbruges.
Registrering af prioritet: NodePreferAvoidPodsPriority
Prioritetstypen NodePreferAvoidPodsPriority er allerede registreret, hvilket genbruges.
Registrering af prioritet: NodeAffinityPriority
Prioritetstypen NodeAffinityPriority er allerede registreret, hvilket genbruges.
Oprettelse af scheduler med fit-predikater 'map[GeneralPredicates:{}]' og prioriteringsfunktioner 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Nu er det eneste, der er tilbage, at angive i spec'en for vores CronJob, at alle planlægningsanmodninger for dens pods skal håndteres af vores nye kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Konklusion
Resultatet blev, at vi fik en ekstra kube-scheduler med et unikt sæt af planlægningspolitikker, som kubelet direkte overvåger. Desuden har vi konfigureret valg af en ny leder blandt pods i vores kube-scheduler i tilfælde af, at den gamle leder bliver utilgængelig af en eller anden grund.
Normale applikationer og tjenester fortsætter med at blive planlagt gennem den default kube-scheduler, mens alle cron-opgaver er fuldstændigt overført til den nye. Den belastning, der skabes af cron-opgaverne, fordeles nu jævnt over alle noder. I betragtning af at størstedelen af cron-opgaverne udføres på de samme noder som hovedapplikationerne i projektet, har dette betydeligt reduceret risikoen for flytning af pods på grund af mangel på ressourcer. Efter implementeringen af den ekstra kube-scheduler er der ikke længere opstået problemer med ujævn planlægning af cron-opgaver.
Læs også andre artikler på vores blog:
Kilde: habr.com
