

Denne artikel beskriver implementeringen af rør i Unix-kernen. Jeg blev lidt skuffet over, at en nyere artikel med titlen "" viste sig at være ikke om den indre opbygning. Jeg blev nysgerrig og gravede i gamle kilder for at finde svaret.
Hvad handler det om?
Rør — "formentlig den vigtigste opfindelse i Unix" — er et kendetegn ved den underliggende Unix-filosofi om at samle små programmer, samt den velkendte skrivning i kommandolinjen:
$ echo hello | wc -c
6
Denne funktionalitet afhænger af det systemopkald, der tilbydes af kernen pipe, som beskrevet i dokumentationen og :
Rør giver en envejs kommunikationskanal mellem processer. Et rør har en indgang (write end) og en udgang (read end). Data, der skrives til indgangen af røret, kan læses fra udgangen.
Røret oprettes ved hjælp af opkaldet
pipe(2), som returnerer to filbeskrivelser: den ene henviser til indgangen til røret, den anden til udgangen.
Resultaterne af sporing af ovenstående kommando viser oprettelsen af røret og dataflowet gennem det fra en proces til en anden:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
Forælderprocessen kalder pipe(), for at få tilsluttede filbeskrivelser. En datterprosess skriver til en beskrivelse, mens en anden proces læser de samme data fra den anden beskrivelse. Skallen bruger dup2 til at "omdøbe" beskrivere 3 og 4, så de svarer til stdin og stdout.
Uden rør ville skallen skulle skrive resultatet af en proces til en fil og overføre det til en anden proces, så den kunne læse dataene fra filen. Dette ville resultere i et større forbrug af ressourcer og diskplads. Men rør er ikke kun gode, fordi de undgår brug af midlertidige filer:
Hvis en proces forsøger at læse fra et tomt rør, så vil
read(2)blokere indtil data er tilgængelige. Hvis en proces forsøger at skrive til et fyldt rør, så vilwrite(2)blokere indtil der er læst tilstrækkelige data fra røret til at udføre skrivningen.
Som et vigtigt krav i POSIX: skrivning til røret op til PIPE_BUF bytes (mindst 512) skal være atomær, så processer kan interagere med hinanden gennem røret på en måde, som almindelige filer (som ikke giver sådanne garantier) ikke kan.
Når du bruger en almindelig fil, kan processen skrive alle sine outputdata til den og sende den til en anden proces. Eller processerne kan handle i en tilstand af hård parallelisering, ved hjælp af en ekstern signalmekanisme (som en semafor) til at informere hinanden om afslutningen af skrivning eller læsning. Rør fritager os for alt dette besvær.
Hvad søger vi?
Lad mig forklare det simpelt, så du lettere kan forestille dig, hvordan et rør kan fungere. Du skal allokere et buffer i hukommelsen og have en tilstand. Funktionen til at tilføje og fjerne data fra bufferen vil være nødvendig. Du vil også have et middel til at kalde funktionerne under operationerne for læsning og skrivning i filbeskrivelserne. Og du vil have låse, så du kan implementere den ovenfor beskrevne specifikke adfærd.
Nu er vi klar til at underkaste kildekoden til kernen den klare belysning for at bekræfte eller afkræfte vores uklare mentale model. Men vær altid forberedt på overraskelser.
Hvor leder vi?
Jeg ved ikke, hvor mit eksemplar af den kendte bog "" med kildekoden til Unix 6 ligger, men takket være kan man online søge i til endnu ældre versioner af Unix.
At vandre gennem TUHS's arkiver er som at besøge et museum. Vi kan se tilbage på vores fælles historie, og jeg føler respekt for de mangeårige bestræbelser på at rekonstruere alt dette materiale bit for bit fra gamle bånd og udskrifter. Og jeg er skarp bevidst om de fragmenter, der stadig mangler.
Efter at have tilfredsstillet min nysgerrighed om den gamle historie af rør, kan vi sammenligne med moderne kerner.
Forresten, pipe er systemopkald nr. 42 i tabellen sysent[]. Sammenfald?
Traditionelle Unix-kerner (1970–1974)
Jeg fandt ingen spor pipe(2) hverken i (januar 1970), hverken i (november 1971),eller i den ufuldstændige kildekode (juni 1972).
TUHS hævder, at (februar 1973) var den første version med rør:
Den tredje udgave af Unix var den sidste version med en kerne skrevet i assembler, men også den første version med rør. I 1973 blev der arbejdet på at forbedre den tredje udgave; kernen blev gen skrevet i C, og den fjerde udgave af Unix blev derved til.
En af læserne fandt et scannet dokument, hvor Doug McIlroy foreslog ideen om 'sammenkobling af programmer efter princippet om en havevandslange'.
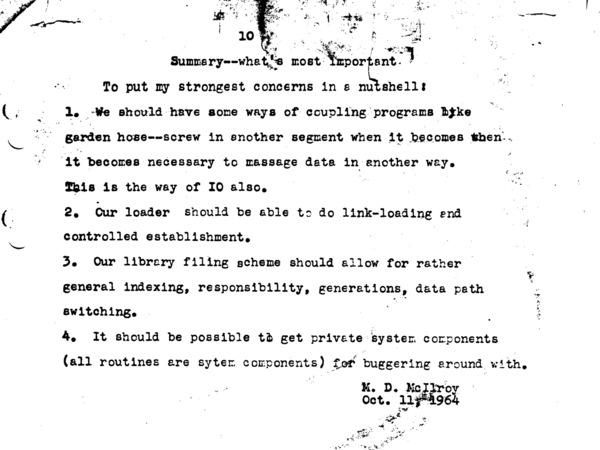
I Brian Kernighans bog "", nævnes dette dokument også i historien om rør: '… det hang på væggen i mit kontor i Bell Labs i 30 år'. Her er , og endnu en historie fra :
Da Unix kom frem, gjorde min fascination af korutiner, at jeg bad forfatteren af OS, Ken Thompson, om at tillade, at data skrevet i en proces kunne gå ikke kun til en enhed, men også til udgangen til en anden proces. Ken mente, at det var muligt. Dog, som minimalisten han var, ønskede han, at hver systemfunktion skulle spille en betydelig rolle. Har en direkte skrivning mellem processer virkelig en stor fordel i forhold til at skrive til en midlertidig fil? Og først da jeg fremlagde et konkret forslag med den fængende titel 'rør' og en beskrivelse af syntaksen for procesinteraktion, udbrød Ken endelig: 'Jeg vil gøre det!'.
Og det gjorde han. En skæbnesvanger aften ændrede Ken kernen og shellen, rettede flere standardprogrammer og standardiserede deres procedure for indtagningsdata (som kunne komme fra røret), og ændrede også filnavnene. Næste dag begyndte rør at blive meget bredt anvendt i applikationer. Ved uges slutning skrev sekretærer dokumenter ud fra tekstbehandlere med hjælp fra dem. Kort efter erstattede Ken den oprindelige API og syntaks for shell-brug af rør med renere aftaler, som har været anvendt siden.
Desværre er kildekoden til kernen af den tredje udgave af Unix gået tabt. Selvom vi har kildekoden til kernen , som blev udgivet i november 1973, blev den udgivet nogle måneder før den officielle release og indeholder ikke implementeringen af rør. Det er en skam, at kildekoden til den legendariske funktion i Unix er gået tabt, måske for altid.
Vi har teksten til dokumentationen for pipe(2) fra begge versioner, så man kan begynde med at søge i dokumentationen (baseret på bestemte ord, fremhævet "manuelt", en linje af litteraler ^H, efterfulgt af et understreg!). Denne proto-pipe(2) er skrevet i assembler og returnerer kun én filbeskriver, men tilbyder allerede den forventede grundlæggende funktionalitet:
Systemopkald pipe opretter en input/output-mekanisme, der kaldes en pipeline. Den returnerede filbeskriver kan bruges til læse- og skriveoperationer. Når der skrives til pipelinen, buffres der op til 504 byte data, hvorefter skriveprocessen pauses. Ved læsning fra pipelinen hentes de buffrede data.
Ved det følgende år var kernen blevet omskrevet i C, og fik sit moderne udseende med prototypen “pipe(fildes)»:
Systemopkald pipe opretter en input/output-mekanisme, der kaldes en pipeline. De returnerede filbeskrivere kan bruges i læse- og skriveoperationer. Når der skrives til pipelinen, bruges den beskrevne filbeskriver, der returneres i r1 (sv. fildes[1]), og der buffres op til 4096 byte data, hvorefter skriveprocessen pauses. Ved læsning fra pipelinen hentes dataene af den filbeskriver, der returneres i r0 (sv. fildes[0]).
Det antages, at efter oprettelsen af pipelinen vil to (eller flere) interagerende processer (oprettet med efterfølgende opkald fork) vil overføre data fra pipelinen ved hjælp af opkald write og write.
I shell'en er der syntaks til at definere en lineær sekvens af processer, der er forbundet via pipeline.
Opkald for at læse fra en tom pipeline (der ikke indeholder buffrede data), som kun har én ende (alle skrivende filbeskrivere er lukkede), returnerer 'end of file'. Opkald til skrivning i en lignende situation ignoreres.
Den tidligste tilhører (juni 1974), men den er næsten identisk med den, der kom i næste udgave. Der blev kun tilføjet kommentarer, så den femte udgave kan springes over.
Sjette udgave af Unix (1975)
Lad os begynde at læse kildekoden til Unix (maj 1975). Meget takket være Lions er det meget lettere at finde den end kildekoden til tidligere versioner:
Mange år er bogen Lions var den eneste dokumentation vedrørende Unix-kernen, der var tilgængelig uden for Bell Labs. Selvom licensen for den sjette udgave tillod undervisere at bruge dens kildekode, udelukkede licensen for den syvende udgave denne mulighed, så bogen blev distribueret i form af ulovlige maskinskrevne kopier.
I dag kan man købe en reproduceret udgave af bogen, hvis omslag viser studerende ved en fotokopimaskine. Og takket være Warren Toomey (som startede TUHS-projektet) kan du downloade . Jeg vil gerne give dig en idé om, hvor meget arbejde der gik ind i at oprette filen:
For mere end 15 år siden skrev jeg en kopi af kildekoden, som præsenteres i Lions, fordi jeg ikke kunne lide kvaliteten af min kopi fra et ukendt antal andre kopier. TUHS eksisterede ikke endnu, og jeg havde ikke adgang til gamle kilder. Men i 1988 fandt jeg et gammelt bånd med 9 spor, som havde en backup fra PDP11-computeren. Det var svært at forstå, om det fungerede, men der var et intakt træ /usr/src/, hvor de fleste filer var mærket 1979, hvilket allerede dengang så antik ud. Det var den syvende udgave eller dens afledte PWB, som jeg troede.
Jeg tog denne opdagelse som grundlag og redigerede kilderne manuelt til tilstanden fra den sjette udgave. Nogle dele af koden forblev uændrede, mens nogle blev let redigeret ved at ændre den moderne token += til den forældede =+. Nogle ting slettede jeg bare, og andre måtte jeg omskrive helt, men ikke særlig mange.
Og i dag kan vi online læse den sjette udgaves kildekode på TUHS fra .
Forresten, ved første øjekast er hovedtræk ved C-koden før Kernighan- og Ritchie-perioden dens korthed. Det er ikke så ofte, jeg kan indsætte kodefragmenter uden omfattende redigering for at få det til at passe ind i et relativt snævert visningsområde på min hjemmeside.
I begyndelsen er der en forklarende kommentar (og ja, der er også ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Bufferstørrelsen har ikke ændret sig siden den fjerde udgave. Men her ser vi uden nogen offentlig dokumentation, at for en gang skyld brugte pipeliner filer som en backup!
Hvad angår LARG-filer, svarer de til , der bruges af 'large address algorithm' til behandling for at støtte større filsystemer. Da Ken sagde, at man bedre ikke skulle bruge dem, er jeg glad for at tage hans ord for gode varer.
Her er et reelt systemopkald pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
I kommentaren er det klart beskrevet, hvad der foregår. Men det er ikke så let at forstå koden, delvist på grund af hvordan med "" og registrene R0 og R1 parametrene for systemopkald og de returnerede værdier overføres.
Lad os prøve med at allokere på disken , og med — at allokere i hukommelsen to . Hvis alt går godt, så sætter vi flagene for at identificere disse filer som de to ender af røret, angiver dem i den samme inode (hvis referencetæller bliver 2) og markerer inode som ændret og i brug. Bemærk henvisningerne til i fejlveje for at reducere referencetælleren i den nye inode.
pipe() skal returnere filbeskrivernumre for læsning og skrivning. R0 og R1 returnerer en pointer til filstrukturen, men "returnerer" også gennem falloc() u.u_ar0[R0] og filbeskriveren. Det vil sige, at koden gemmer i filbeskriveren til læsning og tildeler beskrivelsen til skrivning direkte fra r efter det andet opkald og filbeskriveren. Det vil sige, at koden gemmer i FPIPE falloc().
Flaget , som vi angav ved oprettelsen af røret, styrer funktionenrdwr() i sys2.c Derefter læser funktionen
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
readp() pipe.c i data fra røret. Men det er bedre at følge implementeringen fra writep() . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades.writep(fp) { register *rp, *ip, c;rp = fp; ip = rp->f_inode; c = u.u_count;loop: /* Hvis alt er færdigt, returner. */plock(ip); if(c == 0) { prele(ip); u.u_count = 0; return; }/* * Hvis der ikke er begge læse- og skrivesider aktive i røret, * returner fejl og signalér også. * /if(ip->i_count i_size1 == PIPSIZ) { ip->i_mode |= IWRITE; prele(ip); sleep(ip+1, PPIPE); goto loop; }/* Skriv hvad der er muligt og gå tilbage. */u.u_offset[0] = 0; u.u_offset[1] = ip->i_size1; u.u_count = min(c, PIPSIZ-u.u_offset[1]); c -= u.u_count; writei(ip); prele(ip); if(ip->i_mode & IREAD) { ip->i_mode &= ~IREAD; wakeup(ip+2); } goto loop; }
Ved indgangen til røret vil vi gerne skrive bytes
u.u_count . Først skal vi anmode om at låse indeksbeskriveren (se nedenforplock prele/prøve).
Derefter kontrollerer vi inode-linktælleren. Så længe begge ender af røret forbliver åbne, skal tælleren være lig med 2. Vi holder én reference (fra rp->f_inode), så hvis tælleren er mindre end 2, betyder det, at læseprocessen har lukket sin ende af røret. Med andre ord prøver vi at skrive til et lukket rør, og det er en fejl. Fejlkoden EPIPE og signalet SIGPIPE opstod i den sjette udgave af Unix.
Men selv hvis røret er åbent, kan det være fyldt. I dette tilfælde fjerner vi låsen og går i dvale i håbet om, at en anden proces vil læse fra røret og frigøre tilstrækkelig plads. Når vi vågner, vender vi tilbage til starten, hænger låsen op igen og starter en ny skrivecyklus.
Hvis der er tilstrækkelig fri plads i røret, skriver vi data til det ved hjælp af . Parameter i_size1 for inode (ved et tomt rør kan være lig med 0) angiver slutningen af de data, der allerede er indeholdt der. Hvis der er plads til at skrive, kan vi fylde røret op fra i_size1 op til PIPESIZ. Derefter fjerner vi låsen og forsøger at vække enhver proces, der venter på at læse fra røret. Vi vender tilbage til starten for at se, om vi har været i stand til at skrive så mange bytes, som vi havde brug for. Hvis ikke, starter vi en ny skrivecyklus.
Normalt bruges parameteren i_mode for inode til at gemme tilladelser r, w og x. Men i tilfælde af rør signallerer vi ventetiden for en proces, der skriver eller læser ved hjælp af bitene IREAD og IWRITE henholdsvis. Processen sætter et flag og kalder sleep(), og det forventes, at en anden proces vil kalde wakeup().
Det rigtige magi sker i sleep() og wakeup(). De er implementeret i , kilden til den berømte kommentar 'Du forventes ikke at forstå dette' (You are not expected to understand this). Heldigvis er vi ikke forpligtet til at forstå koden, vi ser bare nogle kommentarer:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Processen, der kalder sleep() for en bestemt kanal, kan senere blive vækket af en anden proces, der kalder wakeup() for den samme kanal. . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades. og pipe.c koordinerer deres handlinger gennem sådanne parrede opkald. Bemærk, at data fra røret. Men det er bedre at følge implementeringen fra altid prioriterer PPIPE ved kald af sleep(), så alle sleep() kan afbrydes af et signal.
Nu har vi alt, hvad vi behøver for at forstå funktionen pipe.c:
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Meget konservativ låsning. */

    plock(ip);

    /*
     * Hvis hovedet (læs) har indhentet
     * halen (skriv), nulstil begge til 0.
     * */

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Hvis der ikke er både læser og
         * skriver aktive, returner uden
         * at opfylde læse.
         * */

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Læs og returner */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Måske er det lettere for dig at læse denne funktion oppefra og ned. Grenen «læs og returner» bruges normalt, når der er nogle data i røret. I dette tilfælde gør vi det ved hjælp af vi læser så mange data, som er tilgængelige fra den nuværende f_offset læsning, og opdaterer derefter værdien af det relevante offset.
Ved efterfølgende læsning vil røret være tomt, hvis offsets læsning har nået værdien i_size1 ved inode'en. Vi nulstiller positionen til 0 og forsøger at vække enhver proces, der ønsker at skrive til røret. Vi ved, at når røret er fyldt, . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades. vil det sove på ip+1. Og nu, når røret er tomt, kan vi vække det, så det kan genoptage sin skrivecyklus.
Hvis der ikke er noget at læse, kan pipe.c måske sætte et flag IREAD og sove på ip+2. Vi ved, at det vil blive vækket, når der skrives data til røret. . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades.Kommentarer til
readi() og writei() u» kan vi håndtere dem som almindelige input-output funktioner, der tager en fil, position, buffer i hukommelsen og tæller antallet af bytes til at læse eller skrive.Hvad angår «den konservative» låsning, så
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
låser inode indtil den er færdig med arbejde eller får et resultat (det vil sige kalder pipe.c og . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades. wakeup plock()). prele() og arbejder simpelthen: ved hjælp af et andet sæt kald giver os mulighed for at vække enhver proces, der har brug for den lås, vi netop har frigivet: sleep og plock() I starten kunne jeg ikke forstå, hvorfor
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
ikke kalder pipe.c prele(ip) før kaldet wakeup(ip+1) . Det første, derkalder i sin løkke, er . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades. plock(ip) , som fører til en deadlock, hvisendnu ikke har frigivet sin blok, så koden skal på en eller anden måde fungere korrekt. Hvis man ser på pipe.c har ikke fjernet sin blok endnu, så koden skal på en eller anden måde fungere korrekt. Hvis man kigger på wakeup(), så bliver det klart, at den kun markerer den sovende proces som klar til udførelse, så den kan bruges fremover. sched() faktisk har startet den. Så pipe.c kalder wakeup(), fjerner blokeringen, sætter IREAD og kalder sleep(ip+2)— alt dette før . Jeg gentager, at koden er blevet mere kompliceret på grund af overenskomsten om overførsel af argumenter, men nogle detaljer kan udelades. genoptager cyklussen.
Hermed slutter beskrivelsen af pipelines i den sjette udgave. Enkel kode, med vidtrækkende konsekvenser.
(januar 1979) var en ny hovedudgave (fire år senere), hvor mange nye applikationer og egenskaber i kernen blev introduceret. Derudover blev der foretaget betydelige ændringer i forbindelse med brugen af typecasting, unioner og typede pointere til strukturer. Men ændrede sig praktisk talt ikke. Vi kan springe denne udgave over.
Xv6, en simpel Unix-lignende kerne
På oprettelsen af kernen blev påvirket af den sjette udgave af Unix, men den er skrevet i moderne C, så den kan køre på x86-processorer. Koden er let at læse, den er forståelig. Desuden, i modsætning til Unix-kilderne hos TUHS, kan du kompilere den, ændre den og køre den på noget andet end PDP 11/70. Derfor er denne kerne udbredt anvendt på universiteter som undervisningsmateriale i operativsystemer. Kilderne .
Koden indeholder en forståelig og gennemarbejdet implementering , støttet af en buffer i hukommelsen i stedet for inode på disken. Her præciserer jeg kun definitionen af 'strukturel pipeline' og funktionen pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() definerer tilstanden i hele den resterende implementering, som inkluderer funktionerne piperead(), pipewrite() og pipeclose(). Den faktiske systemopkald sys_pipe er en wrapper, der er implementeret i . Jeg anbefaler at læse hele dens kode. Kompleksiteten er på niveau med koden fra den sjette udgave, men den er meget lettere og mere behagelig at læse.
Linux 0.01
Du kan finde kildekoden til Linux 0.01. Det vil være lærerigt at studere implementeringen af pipelines i den. fs/data fra røret. Men det er bedre at følge implementeringen fra. Her bruges inode til at repræsentere pipelinen, men selve pipelinen er skrevet i moderne C. Hvis du har kæmpet dig gennem koden fra den sjette udgave, vil du ikke opleve problemer her. Sådan ser funktionen write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1<0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Selv uden at se på strukturedefinitioner kan man forstå, hvordan inode reference-tælleren bruges til at kontrollere, om skriveoperationen fører til SIGPIPE. Udover byte-for-byte arbejde kan denne funktion nemt relateres til de ovenfor beskrevne ideer. Selv logikken sleep_on/wake_up ser ikke så fremmedartet ud.
Moderne kerner som Linux, FreeBSD, NetBSD, OpenBSD
Jeg har hurtigt skummet nogle moderne kerner. Ingen af dem har længere implementeringer, der bruger disk (ikke overraskende). Linux har sin egen implementering. Og selvom de tre moderne BSD-kerner indeholder implementeringer baseret på kode, der blev skrevet af John Dyson, er de i løbet af årene blevet alt for forskellige fra hinanden.
For at læse fs/data fra røret. Men det er bedre at følge implementeringen fra (på Linux) eller sys/kern/sys_pipe.c (på *BSD), kræver det ægte engagement. I dag er ydelse og understøttelse af funktioner som vektoriserede og asynkrone I/O-operationer vigtig. Og detaljerne vedrørende hukommelsestildeling, låsninger og kernekonfigurationen varierer meget. Dette er ikke, hvad universiteter har brug for til et introduktionskursus til operativsystemer.
Under alle omstændigheder var jeg nysgerrig efter at grave nogle gamle mønstre op (for eksempel generering SIGPIPE og retur EPIPE ved skrivning til en lukket pipeline) i alle disse meget forskellige moderne kerner. Jeg vil sandsynligvis aldrig se en PDP-11-computer i live, men der er stadig meget at lære fra koden, der blev skrevet flere år før jeg blev født.
Den artikel skrevet af Divi Kapoor i 2011, "" giver et overblik over, hvordan (stadig) pipelines fungerer i Linux. Og illustrerer pipe-modellen for interaktion, hvis kapaciteter overstiger midlertidige filers; og viser også, hvor langt pipelines er kommet fra den "meget konservative låsning" i Unix kerne version 6.
Kilde: habr.com
