

Jobtitlerne Data Scientist og Data Engineer forveksles ofte. Hver virksomhed har sin egen tilgang til databehandling, forskellige mål for deres analyse og forskellige opfattelser af, hvem der skal lave hvad, så kravene til hver stilling varierer.
Lad os se nærmere på forskellen mellem disse specialister, hvilke forretningsopgaver de løser, hvilke færdigheder de besidder, og hvad de tjener. Materialet er så omfattende, at vi har opdelt det i to publikationer.
I den første artikel fortæller Elena Gerasimova, leder af fakultetet "" i Netology, om forskellen mellem Data Scientist og Data Engineer og hvilke værktøjer de arbejder med.
Hvordan adskiller rollerne sig mellem ingeniører og dataforskere
Dataingeniøren er en specialist, der på den ene side udvikler, tester og vedligeholder infrastrukturen til databehandling: databaser, lagringssystemer og systemer til massebehandling. På den anden side er det den, der renser og 'friser' dataene, så de kan bruges af analytikere og dataforskere, altså skaber data behandlingslinjer.
Data Scientist udvikler og træner forudsigende (og ikke kun) modeller ved hjælp af machine learning-algoritmer og neurale netværk, hvilket hjælper virksomheder med at finde skjulte mønstre, forudsige begivenheder og optimere nøgleforretningsprocesser.
Den væsentligste forskel mellem Data Scientist og Data Engineer er, at de normalt har forskellige mål. Begge arbejder for at sikre, at data er tilgængelige og af høj kvalitet. Men Data Scientist finder svar på sine spørgsmål og tester hypoteser i datakæden (f.eks. på Hadoop), mens Data Engineer skaber en pipeline, der vedligeholder en machine learning-algoritme skrevet af dataforskeren i et Spark-klynge inden for den samme datakæde.
Dataingeniøren skaber værdi for virksomheden ved at arbejde i team. Hans opgave er at fungere som et vigtigt bindeled mellem forskellige interessenter: fra udviklere til forretningsbrugere af rapporter — og øge produktiviteten blandt analytikere — fra marketing og produkt til BI.
Data Scientist deltager derimod aktivt i virksomhedens strategi, skabelsen af indsigter, beslutningstagning og implementering af automatiseringsalgoritmer, modellering og værdiskabelse ud fra data.
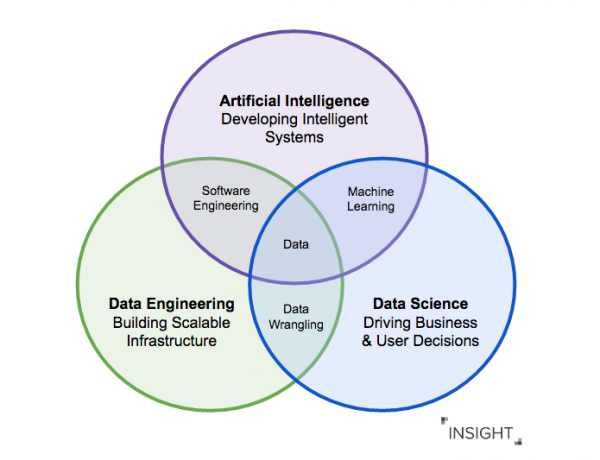
Arbejdet med data følger GIGO-princippet (garbage in — garbage out): hvis analytikere og data scientists arbejder med uforberedte og potentielt ukorrekte data, vil resultaterne, selv med de mest sofistikerede analysealgoritmer, være forkerte.
Dataingeniører løser dette problem ved at opbygge pipelines til behandling, rensning og transformation af data, så data scientists kan arbejde med kvalitetsdata.
Der findes mange værktøjer på markedet til databehandling, der dækker hvert trin: fra dataopståelse til visning på et dashboard for bestyrelsen. Det er vigtigt, at beslutningen om at bruge dem træffes af ingeniøren — ikke fordi det er moderne, men fordi det reelt vil hjælpe de andre involverede i processen.
Kort sagt: hvis virksomheder skal forbinde BI og ETL — dataloading og rapportopdateringer, så er her et typisk legacy-fundament, som Data Engineer vil skulle håndtere (det er godt, hvis der også er en arkitekt i teamet ud over ham).
Data Engineerens opgaver
- Udvikling, opbygning og vedligeholdelse af infrastrukturen til databehandling.
- Fejlhåndtering og oprettelse af pålidelige databehandlingspipelines.
- Omformning af ustrukturerede data fra forskellige dynamiske kilder til den form, der er nødvendig for analytikere.
- Giv anbefalinger til forbedring af konsistens og datakvalitet.
- Sikring og vedligeholdelse af den datarkitektur, der bruges af data scientists og dataanalytikere.
- Behandling og opbevaring af data konsekvent og effektivt i et distribueret cluster bestående af dusinvis eller hundredevis af servere.
- Vurdering af de tekniske kompromiser ved værktøjer for at skabe enkle, men robuste arkitekturer, der kan modstå fejl.
- Kontrol og vedligeholdelse af datastreams og tilhørende systemer (opsætning af overvågning og alarmer).
Der er en anden specialisering inden for Data Engineer-sporet — ML engineer. Kort sagt, disse ingeniører specialiserer sig i at bringe maskinlæringsmodeller til industriel implementering og brug. Ofte er modellen, der kommer fra data scientist, en del af et forskningsprojekt og kan muligvis ikke fungere i produktionsmiljøet.
Data Scientistens opgaver
- Udtræk af funktioner fra data til anvendelse af maskinlæringsalgoritmer.
- Brug af forskellige maskinlæringsværktøjer til forudsigelse og klassificering af mønstre i data.
- Forbedring af ydeevnen og nøjagtigheden af maskinlæringsalgoritmer gennem finjustering og optimering af algoritmer.
- Formulering af 'stærke' hypoteser i overensstemmelse med virksomhedens strategi, som skal testes.
Både Data Engineer og Data Scientist har en markant indflydelse på udviklingen af dataarbejdskultur, som gør det muligt for virksomheden at opnå ekstra indtjening eller reducere omkostninger.
Hvilke sprog og værktøjer arbejder ingeniører og forskere med?
I dag er forventningerne til databehandlingsspecialister ændret. Tidligere indsamlede ingeniører store SQL-forespørgsler, skrev MapReduce manuelt og behandlede data med værktøjer som Informatica ETL, Pentaho ETL, Talend.
I 2020 kan specialist ikke undgå at kende Python og moderne beregningsværktøjer (f.eks. Airflow), samt have forståelse for principperne for cloud-platforme (bruge dem til at spare på 'hardware', samtidig med at man gør sikkerhedsprincipperne gældende).
SAP, Oracle, MySQL, Redis - det er traditionelle værktøjer for dataingeniører i store virksomheder. De er gode, men omkostningerne ved licenser er så høje, at det kun giver mening at lære dem, hvis man arbejder med industrielle projekter. Der er dog et gratis alternativ i form af Postgres - det er gratis og velegnet ikke kun til læring.
Historisk set har der ofte været efterspørgsel efter Java og Scala, selvom disse sprog falder i baggrunden som teknologier og tilgange udvikler sig.
Ikke desto mindre er hardcore Big Data: Hadoop, Spark og resten af dyrenes zoologiske have ikke længere et obligatorisk krav for dataingeniører, men en variant af værktøjer til at løsning af opgaver, der ikke kan løses med traditionelle ETL.
Tendenserne handler om tjenester til brug af værktøjer uden viden om sproget, hvori de er skrevet (f.eks. Hadoop uden viden om Java), samt levering af færdige tjenester til behandling af strømmende data (genkendelse af stemmer eller billeder i video).
Industriløsninger fra SAS og SPSS er populære, mens Tableau, Rapidminer, Stata og Julia også bredt anvendes af dataforskere til lokale opgaver.
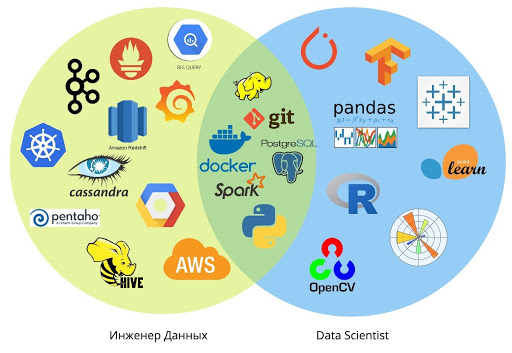
Muligheden for selv at opbygge pipelines blev tilgængelig for analytikere og data scientists for kun et par år siden: for eksempel kan man nu med relativt enkle scripts dirigere data til et lager baseret på PostgreSQL.
Normalt forbliver brugen af pipelines og integrerede datastrukturer under dat ingeniørernes ansvar. Men i dag er trenden med T-formede specialister — med brede kompetencer inden for relaterede områder — stærkere end nogensinde, da værktøjerne konstant forenkles.
Hvorfor Data Engineer og Data Scientist skal arbejde sammen
Ved at samarbejde tæt med ingeniørerne kan Data Scientists fokusere på den forskningsmæssige del, mens de skaber færdige algoritmer til maskinlæring.
Og ingeniørerne kan fokusere på skalerbarhed, genbrug af data og sikre, at data input og output pipelines i hvert enkelt projekt overholder den globale arkitektur.
Denne opdeling af ansvarsområder sikrer, at handlingerne er koordinerede mellem grupper af specialister, der arbejder på forskellige maskinlæringsprojekter.
Samarbejdet hjælper med effektivt at skabe nye produkter. Hastighed og kvalitet opnås gennem en balance mellem at skabe tjenester for alle (globalt lager eller integration af dashboards) og implementeringen af hver specifik behov eller projekt (specialiseret pipeline, tilslutning af eksterne kilder).
Nært samarbejde med data scientists og analytikere hjælper ingeniører med at udvikle analytiske og forskningsmæssige færdigheder til at skrive bedre kode. Videnoverførslen mellem brugere af datalagre og datalakes forbedres, hvilket gør projekterne mere fleksible og sikrer mere bæredygtige langsigtede resultater.
I virksomheder, der har som mål at udvikle en dataarbejdskultur og opbygge forretningsprocesser baseret på data, supplerer Data Scientists og Data Engineers hinanden og skaber et fuldgyldigt datanalyse-system.
I det næste materiale vil vi fortælle om, hvilken uddannelse Data Engineers og Data Scientists bør have, hvilke færdigheder de skal udvikle, og hvordan markedet er indrettet.
Fra redaktionen af Netology
Hvis du overvejer at blive Data Engineer eller Data Scientist, inviterer vi dig til at udforske programmerne for vores kurser:
- Faget “».
- Faget “».
Kilde: habr.com
