

Hej alle sammen, jeg hedder Alexander, og jeg er Data Quality-engineer, der arbejder med at kontrollere data for kvalitet. I denne artikel vil jeg fortælle om, hvordan jeg kom hertil, og hvorfor denne testretning i 2020 blev meget populær.
Global trend
Den moderne verden oplever endnu en teknologisk revolution, hvor et af aspekterne er brugen af de indsamlende data af forskellige virksomheder til at fremme deres salgs- og PR-motor. Det ser ud til, at tilstedeværelsen af gode (kvalitets) data samt dygtige hjerner, der kan udnytte dem til at skabe værdi (behandle dem korrekt, visualisere, bygge maskinlæringsmodeller osv.), er blevet nøglen til succes for mange i dag. For 15-20 år siden var det hovedsageligt større virksomheder, der var beskæftiget med indsamling og monetisering af data, men i dag er det en opgave for næsten alle fornuftige virksomheder.
Som følge heraf blev alle jobportaler verden over for et par år siden oversvømmet med stillingsopslag for Data Scientists, da alle var overbevist om, at ved at ansætte en sådan specialist kunne de bygge en supermodel for maskinlæring, forudsige fremtiden og skabe et "kvantespring" for virksomheden. Med tiden indså folk, at denne tilgang næsten ingen steder fungerer, da langt fra alle data, der når hænderne på denne slags specialister, er egnede til at træne modeller.
Og så kom forespørgslerne fra Data Scientists: "Lad os købe flere data fra disse og de...", "Vi mangler data...", "Vi har brug for lidt flere data, helst af høj kvalitet...". Baseret på disse forespørgsler blev der opbygget mange interaktioner mellem virksomheder, der ejer forskellige datasæt. Naturligvis krævede dette en teknisk organisering af processen - tilslutning til datakilderne, download af dem, kontrol for at sikre, at de blev indlæst i fuldt omfang osv. Antallet af disse processer er steget, og i dag har vi en enorm efterspørgsel efter en anden type specialister - Data Quality-engineerer - dem der overvåger datastreams i systemet (data pipelines), datakvaliteten ved indgang og udgang, og drager konklusioner om deres tilstrækkelighed, integritet og andre egenskaber.
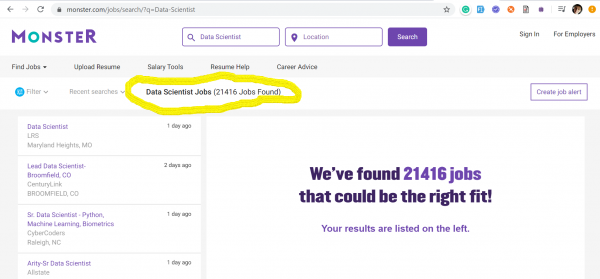
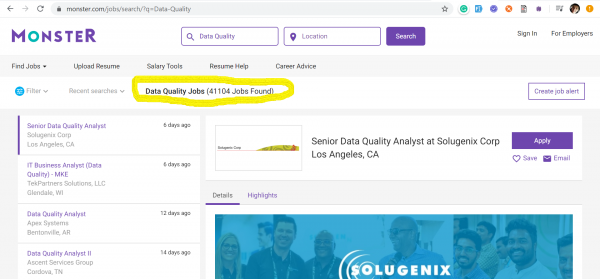
Trenden med Data Quality ingeniører kommer til os fra USA, hvor ingen er klar til at tabe kampen om data i midten af den rasende kapitalisme. Nedenfor har jeg præsenteret skærmbilleder fra to af de mest populære job portals i USA: og — hvor data er vist pr. 17. marts 2020 for antallet af opslåede job med nøgleordene: Data Quality og Data Scientist.
Data Scientists – 21416 job
Data Quality – 41104 job
Data Scientists – 404 job
Data Quality – 2020 job
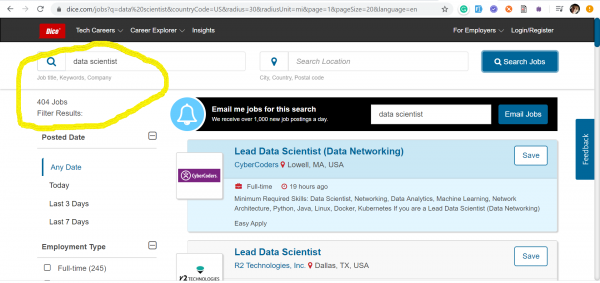
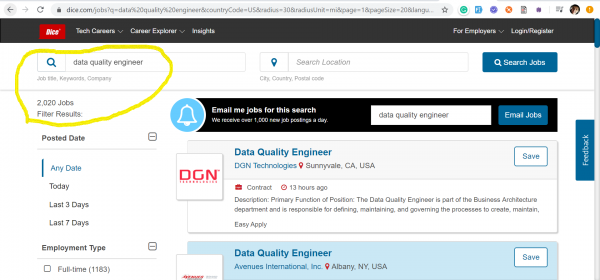
Det er tydeligt, at disse professioner på ingen måde konkurrerer med hinanden. Med skærmbillederne ville jeg blot illustrere den nuværende situation på arbejdsmarkedet i forhold til efterspørgslen på Data Quality ingeniører, som der nu er meget større behov for end Data Scientists.
I juni 2019 etablerede EPAM, som reaktion på behovene på det moderne IT-marked, Data Quality som en separat praksis. Data Quality ingeniører håndterer dagligt data, tester deres opførsel i nye forhold og systemer, samt kontrollerer dataenes relevans, tilstrækkelighed og aktualitet. I praktisk forstand dedikerer Data Quality ingeniører dog faktisk lidt tid til klassisk funktionel testning, MEN det afhænger i høj grad af projektet (jeg vil give et eksempel senere).
Data Quality ingeniørens ansvar begrænser sig ikke kun til rutinemæssige manuelle/automatiske kontroller af "nulls, count og sums" i databaser, men kræver en dyb forståelse af kundens forretningsbehov og evnen til at transformere eksisterende data til brugbar forretningsinformation.
Teori om Data Quality
For at få et fuldt billede af rollen som en sådan ingeniør, lad os undersøge, hvad Data Quality er i teorien.
Data Quality — er et af stadierne i Data Management (en hel verden, som vi lader dig udforske på egen hånd) og omhandler analyse af data ud fra følgende kriterier:
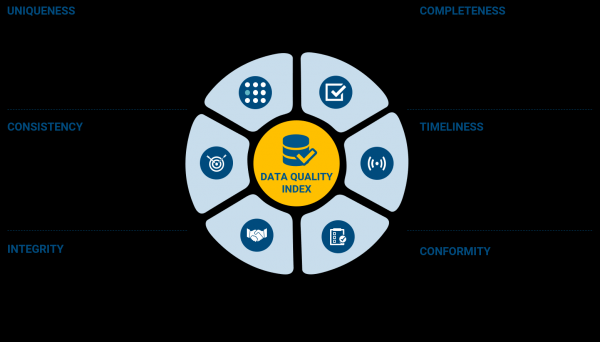
Jeg tror ikke, det er nødvendigt at dechiffrere hvert enkelt punkt (i teorien kaldes de "data dimensions"); de er ganske godt beskrevet på billedet. Men selve testprocessen forudsætter ikke en striks kopi af disse karakteristika i testcases og deres validering. Inden for Data Quality, som i enhver anden type testning, er det primært nødvendigt at basere sig på kravene til datakvalitet, som er aftalt med deltagerne i projektet, der træffer forretningsbeslutninger.
Afhængigt af projektet kan en Data Quality-ingeniør udføre forskellige funktioner: fra en almindelig automatiseringstestere med en overfladisk vurdering af datakvaliteten til en person, der udfører en dybdegående profilering af dem i henhold til de nævnte karakteristika.
Meget detaljeret beskrivelse af processerne inden for Data Management, Data Quality og beslægtede emner er fremragende beskrevet i bogen ved navn «DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition». Jeg anbefaler stærkt denne bog som en introduktion til emnet (linket til den finder du i slutningen af artiklen).
Min historie
I IT-branchen har jeg bevæget mig fra Junior tester i produktvirksomheder til Lead Data Quality Engineer hos EPAM. Efter omkring to års arbejde som tester havde jeg en fast overbevisning om, at jeg havde udført alle former for testning: regression, funktionel, stresstest, stabilitet, sikkerhed, UI osv. — og prøvet et stort antal testværktøjer, mens jeg har arbejdet med tre programmeringssprog: Java, Scala, Python.
Når jeg ser tilbage, forstår jeg, hvorfor mit færdighedssæt har været så forskelligt — jeg har deltaget i projekter, der involverer arbejde med data, både store og små. Det var netop dette, der bragte mig ind i en verden af mange værktøjer og muligheder for vækst.
For at vurdere mangfoldigheden af værktøjer og muligheder for at opnå ny viden og færdigheder er det tilstrækkeligt blot at se på billedet nedenfor, som viser de mest populære af dem i verden af "Data & AI".
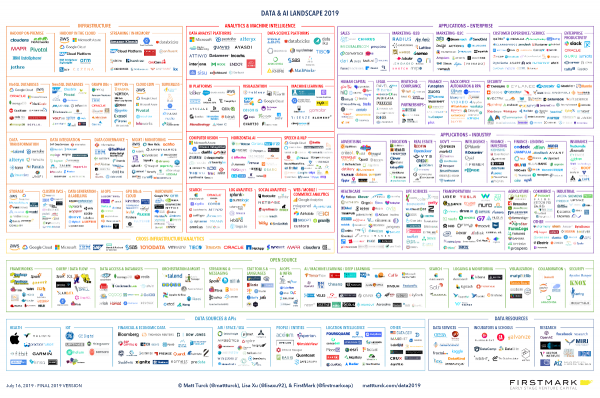
Denne slags illustrationer laves årligt af en kendt venturekapitalist Matt Turck, der kommer fra softwareudvikling. Her er hans blog og , hvor han arbejder som partner.
Jeg udviklede mig især hurtigt, da jeg var den eneste tester på projektet, eller i det mindste i starten af projektet. I sådanne situationer er man ansvarlig for hele testprocessen, og man har ikke mulighed for at trække sig tilbage, kun at gå fremad. I begyndelsen var det skræmmende, men nu ser jeg klart alle fordelene ved denne udfordring:
- Du begynder at kommunikere med hele teamet som aldrig før, da der ikke er nogen mellemledere for kommunikationen: hverken testmanager eller kolleger i testteamet.
- Dykningen ind i projektet bliver utrolig dyb, og du har kendskab til alle komponenter både generelt og i detaljer.
- Udviklerne ser ikke på dig som "den fyr fra testning, som umuligt kan finde ud af, hvad han laver", men snarere som en ligestillet, der giver en enorm værdi til teamet med sine automatiserede tests og evne til at forudse bugs i specifikke dele af produktet.
- Som resultat bliver du mere effektiv, mere kvalificeret, mere eftertragtet.
Efterhånden som projektet voksede, blev jeg i 100% af tilfældene mentor for nyankomne testere, hvor jeg trænede dem og delte den viden, jeg selv havde lært. Afhængigt af projektet modtog jeg dog ikke altid specialister på højeste niveau inden for automatisering fra ledelsen, og der var behov for enten at træne dem i automatisering (for dem, der ønskede det) eller at skabe værktøjer til deres daglige aktiviteter (værktøjer til datagenerering og upload til systemet, værktøj til hurtig belastningstest/stabilitetstest osv.).
Eksempel på et konkret projekt
Desværre kan jeg på grund af fortrolighedsforpligtelser ikke tale i detaljer om de projekter, jeg har arbejdet på, men jeg vil give eksempler på typiske opgaver for en Data Quality Engineer i et af projekterne.
Essensen af projektet var at implementere en platform til forberedelse af data til at træne modeller for maskinlæring. Kunden var et stort farmaceutisk selskab fra USA. Teknisk set var det et cluster , der kører på instanser, med flere mikrotjenester og baseret på et Open Source-projekt fra EPAM — , tilpasset de specifikke behov hos kunden (nu er projektet blevet til ). ETL-processer blev organiseret ved hjælp af og og flyttede data fra kundens system til Buckets. Herefter blev en Docker-billede af en maskinlæringsmodel implementeret på platformen, som blev trænet på friske data og gav forudsigelser via et REST API, der interesserede forretningen og løste specifikke opgaver.
Det så visuelt omtrent sådan ud:
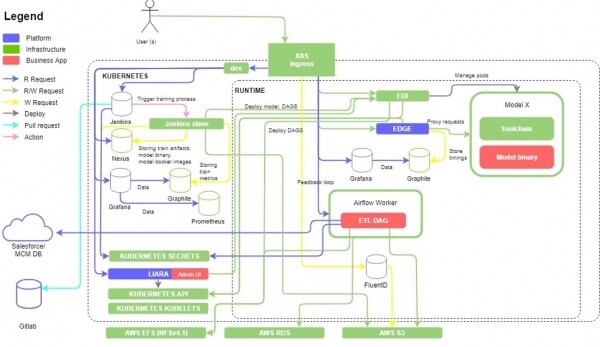
Der var rigeligt med funktionel testning på dette projekt, og i betragtning af hastigheden på udviklingen af nye funktioner og behovet for at opretholde tempoet i udgivelsescyklussen (to-ugers sprints) var det nødvendigt straks at overveje automatisering af testene på de mest kritiske dele af systemet. En stor del af selve platformen, som var baseret på Kubernetes, blev dækket af automatiserede tests, der blev implementeret i + Python, men det var også nødvendigt at vedligeholde og udvide dem. Derudover blev der for kundens bekvemmelighed oprettet et GUI til at styre maskinlæringsmodellerne, der var implementeret på klyngen, samt muligheden for at angive, hvorfra og til hvor data skulle flyttes for at træne modellerne. Denne omfattende tilføjelse førte til en udvidelse af de automatiserede funktionelle kontroller, som hovedsageligt blev udført gennem REST API-opkald og et lille antal end-2-end UI-tests. Omkring midten af hele denne proces sluttede en manuel tester sig til os, som klarede sig fint med accepttest af produktversioner og kommunikation med kunden omkring accepten af den seneste udgivelse. Desuden gjorde den nye specialist det muligt for os at dokumentere vores arbejde og tilføje flere meget vigtige manuelle kontroller, som var svære at automatisere med det samme.
Og endelig, efter at vi har opnået stabilitet fra platformen og GUI-overbygningen over den, begyndte vi at opbygge ETL-pipelines ved hjælp af Apache Airflow DAGs. Den automatiserede datakvalitetskontrol blev udført ved at skrive specielle Airflow DAGs, som kontrollerede data baseret på resultaterne fra ETL-processen. I forbindelse med dette projekt var vi heldige, da kunden gav os adgang til anonymiserede datasæt, som vi testede på. Vi kontrollerede data række for række for at sikre overensstemmelse med typerne, tilstedeværelsen af korrupte data, det samlede antal poster før og efter, samt sammenligningen af de transformationer, der blev foretaget af ETL-processen i forhold til aggregering, ændring af kolonnenavne og andet. Desuden blev disse kontroller skaleret til forskellige datakilder, for eksempel udover SalesForce også MySQL.
Kvalitetskontrollerne af de endelige data blev udført på S3-niveau, hvor de blev opbevaret og var i en ready-to-use tilstand til træning af maskinlæringsmodeller. For at hente data fra den endelige CSV-fil, der lå i S3 Bucket, og validere dem, blev der skrevet kode ved hjælp af .
Der var også et krav fra kunden om at opbevare en del af dataene i én S3 Bucket, og en del i en anden. Dette krævede også, at der blev skrevet ekstra kontroller, der overvågede gyldigheden af denne sortering.
Generel erfaring fra andre projekter
Eksempel på den mest generelle liste over aktiviteter for en Data Quality-ingeniør:
- Forberede testdata (gyldige, ugyldige, store, små) gennem et automatiseret værktøj.
- Laste det forberedte datasæt op i den oprindelige kilde og kontrollere dets klarhed til brug.
- Starte ETL-processerne for at behandle datasættet fra kildeopbevaringen til det endelige eller mellemliggende ved hjælp af et bestemt sæt indstillinger (hvis det er muligt at specificere konfigurerbare parametre for ETL-opgaven).
- Verificere de behandlede data fra ETL-processen med henblik på deres kvalitet og overensstemmelse med forretningskravene.
Her er hovedfokus for kontrollerne ikke kun på, om datastreamen i systemet generelt fungerer og når slutpunkterne (som er en del af funktionalitetstestningen), men primært på kontrol og validering af data for at sikre overensstemmelse med forventede krav, identificering af anomalier og lignende.
Værktøjer
En af teknikkerne til denne dataovervågning kan være etableringen af kæde-kontroller på hver fase af datahåndteringen, såkaldt 'data chain' — kontrol af data fra kilde til det endelige anvendelsespunkt. Denne type kontrol udføres oftest ved at skrive verificerende SQL-forespørgsler. Det er klart, at sådanne forespørgsler skal være så letvægts som muligt og kontrollere bestemte aspekter af datakvaliteten (metadata for tabeller, tomme linjer, NULL'er, syntaksfejl — andre nødvendige kontrolattributter).
I tilfælde af regressionstest, hvor der anvendes allerede eksisterende (uændrede eller lidt ændrede) datasæt, kan der i automattests koden gemmes færdige skabeloner til data validation i forhold til kvalitet (beskrivelser af forventede metadata for tabeller; udvalgte objekter, der kan vælges tilfældigt under testen, og så videre).
Desuden skal der i løbet af testningen skrives test ETL-processer ved hjælp af rammer som Apache Airflow, eller helt black-box cloud værktøjer som , og så videre. Denne situation tvinger testingeniøren til at dykke ned i principperne bag de nævnte værktøjer og desuden mere effektivt udføre funktionalitetstestning (for eksempel af eksisterende ETL-processer i projektet) samt bruge dem til dataverificering. Især for Apache Airflow er der allerede klare operatorer til arbejde med populære analyse-databaser, som for eksempel . Det mest grundlæggende eksempel på dets anvendelse er allerede præsenteret , derfor vil jeg ikke gentage mig selv.
Udover de færdige løsninger forhindrer ingen jer i at implementere jeres egne teknikker og værktøjer. Dette vil ikke kun være en fordel for projektet, men også for selve Data Quality Engineer, som derved vil udvide sit tekniske perspektiv og kodningsfærdigheder.
Hvordan det fungerer i et reelt projekt
En god illustration af de seneste afsnit om „data chain“, ETL og de allestedsnærværende kontrolpunkter er følgende proces fra et af vores reelle projekter:
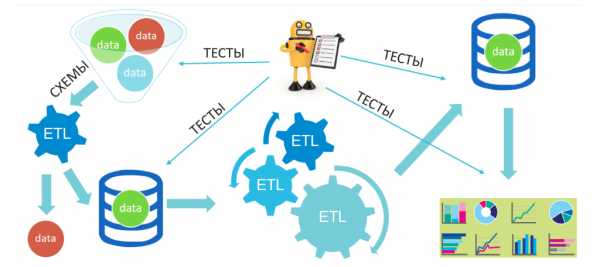
Her kommer forskellige data (naturligvis forberedt af os) ind i indgangs „tratten“ i vores system: gyldige, ugyldige, blandede osv., derefter filtreres de og går ind i et mellemstorage, hvorefter de igen venter på en række transformationer og placeres i den endelige lagring, hvorfra analysen, opbygningen af datavisning og søgning efter forretningsindsigter vil finde sted. I et sådant system fokuserer vi, uden at kontrollere den funktionelle drift af ETL-processerne, på datakvaliteten før og efter transformationerne, samt på udgangen til analytik.
For at opsummere ovenstående, uanset hvor jeg har arbejdet, har jeg været involveret i Data-projekter, der har haft følgende træk:
- Kun gennem automatisering kan man teste nogle cases og opnå en acceptabel release-cyklus for virksomheden.
- Tester i et sådant projekt er et af de mest respekterede medlemmer af teamet, da han/hun bringer stor værdi til alle deltagere (hurtigere testning, gode data til Data Scientist, opdagelse af fejl i de tidlige faser).
- Uanset om du arbejder på dit eget udstyr eller i skyerne — alle ressourcer er abstraheret i et cluster som Hortonworks, Cloudera, Mesos, Kubernetes osv.
- Projekterne er bygget på en mikroservices tilgang, med en overvægt af distribuerede og parallelle beregninger.
Jeg vil bemærke, at når man beskæftiger sig med testning inden for Data Quality, flytter testspecialisten sit professionelle fokus til produktets kode og de anvendte værktøjer.
Karakteristiske træk ved Data Quality testning
Derudover har jeg identificeret følgende (gående ud fra meget generelle og udelukkende subjektive) karakteristika ved testningen i Data (Big Data) projekter (systemer) og andre områder:
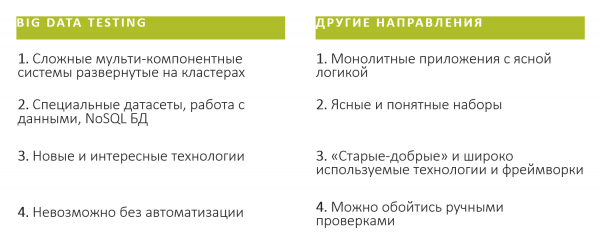
Nyttige links
- Teori: .
- EPAM
- Anbefalede materialer til den kommende Data Quality ingeniør:
- Gratis kursus på Stepik: .
- Kursus på LinkedIn Learning: .
- Artikler:
- ;
- ;
- ;
- Video:
- ;
- ;
Konklusion
Data Quality — dette er en meget ung og lovende retning, og at være en del af den betyder at være en del af en slags startup. Når du træder ind i Data Quality, vil du dykke ned i en mængde moderne og eftertragtede teknologier, men det vigtigste er, at der åbner sig enorme muligheder for at generere og realisere dine idéer. Du kan anvende tilgangen til kontinuerlig forbedring, ikke kun i dit projekt, men også for dig selv, mens du konstant udvikler dig som specialist.
Kilde: habr.com
