

Hello, Habr!
I denne artikel vil vi gerne tale om automatisering af netværksinfrastruktur. Vi vil præsentere et netværksscheme, der fungerer i en lille, men meget stolt virksomhed. Enhver lighed med egentligt netværksudstyr er tilfældig. Vi vil se på et tilfælde, der skete i dette netværk, som kunne have ført til en langvarig driftstop og betydelige økonomiske tab. Løsningen på dette tilfælde passer meget godt ind i konceptet "Automatisering af netværksinfrastruktur". Ved hjælp af automatiseringsværktøjer vil vi vise, hvordan man effektivt kan løse komplekse opgaver inden for korte tidsrammer, og overveje hvorfor det er mere lovende at løse disse opgaver på denne måde, frem for via konsollen.
Ansvarsfraskrivelse
De primære værktøjer til automatisering, vi bruger, er Ansible (som automatiseringsmiddel) og Git (som lager for Ansible playbooks). Jeg vil straks understrege, at dette ikke er en introduktionsartikel, hvor vi taler om logikken bag Ansible eller Git, og forklarer grundlæggende ting (for eksempel hvad der menes med roller, moduler, inventar filer og variable i Ansible, eller hvad der sker, når man indtaster kommandoerne git push eller git commit). Dette er ikke en historie om, hvordan man kan øve sig i Ansible, eller konfigurere NTP eller SMTP på udstyret. Dette handler om, hvordan man hurtigt og helst uden fejl kan løse et netværksproblem. Det er også ønskeligt at have et godt kendskab til, hvordan netværket fungerer, især hvad TCP/IP protokolstakken, OSPF og BGP er. Valget af Ansible og Git vil vi også lade ligge. Hvis du stadig har et valg af konkret løsning, anbefaler vi stærkt at læse bogen "Network Programmability and Automation. Skills for the Next-Generation Network Engineer" af Jason Edelman, Scott S. Lowe og Matt Oswalt.
Nu til sagen.
Problemformulering
Lad os forestille os situationen: Klokken er tre om natten, du sover dybt og drømmer. Telefonen ringer. Den tekniske direktør ringer:
— Ja?
— ###, ####, #####; klyngen af firewall er faldet og kan ikke genstartes!!!
Du tørre dine øjne, forsøger at forstå, hvad der sker, og forestiller dig, hvordan det overhovedet kunne ske. I røret kan man høre, hvordan direktorens hår bliver revet ud, og han beder om at ringe tilbage, fordi han får et opkald fra direktøren på den anden linje.
Efter en halv time har I samlet de første input fra vagtteamet og vækket alle, I kunne vække. I sidste ende løj teknisk direktør ikke, det er sandt, den primære klynge af firewall'er er faldet, og ingen grundlæggende handlinger får den til at vågne op. Alle de tjenester, som virksomheden tilbyder, fungerer ikke.
Vælg et problem efter eget valg, alle vil huske noget forskelligt. For eksempel fungerede alt godt efter natopdateringen i fravær af stor belastning, og alle glade gik i seng. Så kom trafikken, og buffere i grænsefladerne begyndte at overflowe på grund af en fejl i netværksadapterens driver.
Situationen kan godt beskrives af Jackie Chan.
Tak, Jackie.
Det er ikke en særlig behagelig situation, er det?
Lad os sætte vores netværksspecialist og hans triste tanker på pause et øjeblik.
Lad os diskutere, hvordan begivenhederne vil udvikle sig videre.
Vi foreslår følgende rækkefølge af materialepræsentation:
- Lad os se på netværksskemaet og analysere, hvordan det fungerer;
- Vi beskriver, hvordan vi overfører indstillinger fra en router til en anden ved hjælp af Ansible;
- Vi taler om automatiseringen af IT-infrastrukturen generelt.
Netværksskema og dets beskrivelse
Diagram
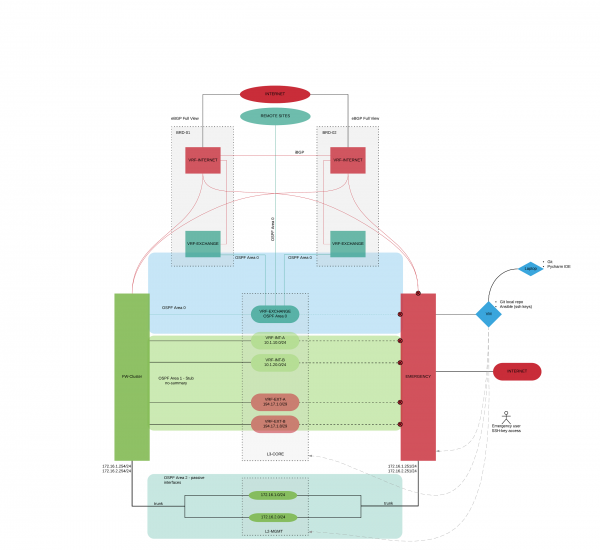
Lad os se på den logiske skitse af vores organisation. Vi vil ikke nævne specifikke producenter af udstyr, da det ikke har betydning inden for rammerne af artiklen. (Den opmærksomme læser vil selv gætte, hvilket udstyr der anvendes.). Dette er en af de gode fordele ved at arbejde med Ansible; under opsætningen er det i det store hele ligegyldigt, hvilket udstyr det er. Bare for at forstå, er det udstyr fra kendte producenter som Cisco, Juniper, Check Point, Fortinet, Palo Alto … du kan indsætte dit eget valg.
Vi har to hovedopgaver i forbindelse med trafikflytning:
- Sikre offentliggørelsen af vores tjenester, som er virksomhedens forretning;
- Sikre forbindelsen til filialer, fjerndatakontorer og tredjepartsorganisationer (partnere og kunder), samt at give filialer adgang til internettet via hovedkontoret.
Lad os starte med de grundlæggende elementer:
- To grænseroutere (BRD-01, BRD-02);
- Klynge af firewall'er (FW-CLUSTER);
- Kerne-switch (L3-CORE);
- Routeren, der vil være redningskransen (i løbet af problemløsningen vil vi overføre netværksindstillingerne fra FW-CLUSTER til EMERGENCY) (EMERGENCY);
- Switches til styring af netværksinfrastrukturen (L2-MGMT);
- En virtuel maskine med Git og Ansible (VM-AUTOMATION);
- Den bærbare computer, som bruges til test og udvikling af playbooks for Ansible (Laptop-Automation).
Der er konfigureret en dynamisk routingprotokol OSPF i netværket med følgende områder:
- Område 0 – området, der inkluderer routere, som håndterer trafikbevægelser i ZONE EXCHANGE;
- Område 1 – området, der inkluderer routere, som støtter virksomhedens tjenester;
- Område 2 – området, der inkluderer routere, som håndterer management-trafik;
- Område N – områderne for filialnetværkene.
Der er oprettet en virtuel router (VRF-INTERNET) på grænserouterne, hvor en eBGP full view er sat op med det tilsvarende tildelte AS. Mellem VRF'erne er der konfigureret iBGP. Virksomheden har et pool af hvide adresser, som er offentliggjort på disse VRF-INTERNET. En del af de hvide adresser routedes direkte til FW-CLUSTER (adresserne, hvor virksomhedens tjenester kører), og en del routedes gennem ZONE EXCHANGE (interne tjenester, der kræver eksterne IP-adresser, og eksterne adresser NAT til kontorerne). Derefter kommer trafikken til de virtuelle routere, der er oprettet på L3-CORE med hvide og grå adresser (sikkerhedszoner).
I management-netværket anvendes dedikerede switches og udgør et fysisk adskilt netværk. Management-netværket er også opdelt i sikkerhedszoner.
Routeren EMERGENCY duplikerer fysisk og logisk FW-CLUSTER. Alle grænseflader er deaktiveret, bortset fra dem, der er forbundet til management-netværket.
Automatisering og dens beskrivelse
Vi har forstået, hvordan netværket fungerer. Nu skal vi trin for trin se, hvad vi vil gøre for at omdirigere trafikken fra FW-CLUSTER til EMERGENCY:
- Deaktiverer grænsefladerne på kerne-switchen (L3-CORE), der forbinder den med FW-CLUSTER;
- Deaktiverer grænsefladerne på L2-MGMT kerne-switch, der forbinder den med FW-CLUSTER;
- Konfigurerer routeren EMERGENCY (som standard er alle grænseflader deaktiveret, bortset fra dem, der er forbundet til L2-MGMT):
- Aktiverer grænsefladerne på EMERGENCY;
- Konfigurerer den eksterne IP-adresse (til NAT), som var på FW-Cluster;
- Genererer gARP-anmodninger, så MAC-adresserne i ARP-tabellerne på L3-CORE ændres fra FW-Cluster til EMERGENCY;
- Definerer en statisk standardrute til BRD-01, BRD-02;
- Opretter NAT-regler;
- Aktiverer OSPF Area 1 på EMERGENCY;
- Aktiverer OSPF Area 2 på EMERGENCY;
- Ændrer omkostningerne for ruter i Area 1 til 10;
- Ændrer omkostningen for standardruten i Area 1 til 10;
- Skift IP-adresser, der er relateret til L2-MGMT (til dem, der var på FW-CLUSTER);
- Vi genererer gARP-anmodninger for at ændre MAC-adresserne fra FW-CLUSTER til EMERGENCY i ARP-tabellerne L2-MGMT.
Lad os vende tilbage til den oprindelige opgave. Klokken er tre om natten, der er stor stress, og en fejl på ethvert trin kan føre til nye problemer. Er I klar til at indtaste kommandoer via CLI? Ja? Okay, så gå lige og vask ansigtet, få en kop kaffe og samle modet.
Bruce, venligst hjælp drengene.
Og vi fortsætter med at udvikle vores automatisering.
Nedenfor er en skitse af, hvordan playbooken fungerer i Ansible-termer. Dette diagram afspejler det, vi lige har beskrevet, blot med en konkret implementation i Ansible.
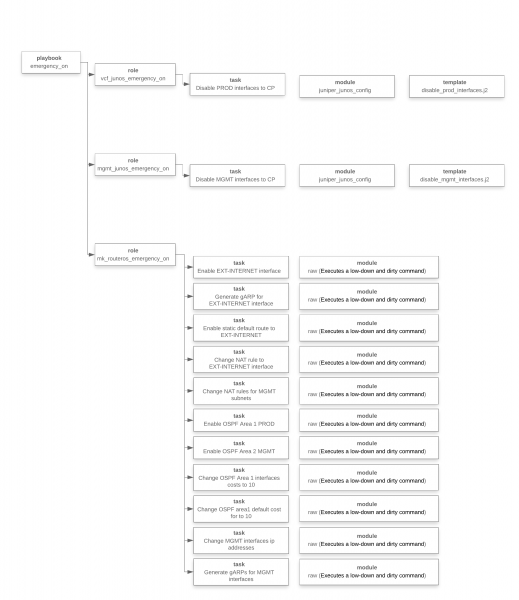
På dette stadium har vi indset, hvad der skal gøres, vi har udviklet playbooken, udført tests, og nu er vi klar til at køre den.
En lille digression. Fortællingens lethed må ikke narre dig. Processen med at skrive playbooks var ikke så enkel og hurtig, som det kan synes. Testningen tog ret lang tid, en virtuel stand blev oprettet, løsningen blev gentagne gange afprøvet, og der blev udført omkring 100 tests.
Vi kører... Der er en følelse af, at alt sker meget langsomt, et eller andet sted er der en fejl, og noget kommer i sidste ende ikke til at fungere. Det føles som at springe med faldskærm, men faldskærmen vil ikke åbne sig med det samme... det er normalt.
Dernæst læser vi resultatet af de udførte operationer fra Ansible-playbooken (IP-adresserne er blevet ændret af hensyn til fortrolighed):
[xxx@emergency ansible]$ ansible-playbook -i /etc/ansible/inventories/prod_inventory.ini /etc/ansible/playbooks/emergency_on.yml

PLAY [------->Nødsituation på VCF] ********************************************************

TASK [vcf_junos_emergency_on : Deaktiver PROD interfaces til FW-CLUSTER] *********************
ændret: [vcf]

PLAY [------->Nødsituation på MGMT-CORE] ************************************************

TASK [mgmt_junos_emergency_on : Deaktiver MGMT interfaces til FW-CLUSTER] ******************
ændret: [m9-03-sw-03-mgmt-core]

PLAY [------->Nødsituation på] ****************************************************

TASK [mk_routeros_emergency_on : Aktiver EXT-INTERNET interface] **************************
ændret: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Generer gARP for EXT-INTERNET interface] ****************
ændret: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Aktiver statisk standardrute til EXT-INTERNET] ****************
ændret: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Ændre NAT regel til EXT-INTERNET interface] ****************
ændret: [m9-04-r-04] => (item=12)
ændret: [m9-04-r-04] => (item=14)
ændret: [m9-04-r-04] => (item=15)
ændret: [m9-04-r-04] => (item=16)
ændret: [m9-04-r-04] => (item=17)

TASK [mk_routeros_emergency_on : Aktiver OSPF Område 1 PROD] ******************************
ændret: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Aktiver OSPF Område 2 MGMT] *****************************
ændret: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Ændre OSPF Område 1 interface omkostninger til 10] *****************
ændret: [m9-04-r-04] => (item=VLAN-1001)
ændret: [m9-04-r-04] => (item=VLAN-1002)
ændret: [m9-04-r-04] => (item=VLAN-1003)
ændret: [m9-04-r-04] => (item=VLAN-1004)
ændret: [m9-04-r-04] => (item=VLAN-1005)
ændret: [m9-04-r-04] => (item=VLAN-1006)
ændret: [m9-04-r-04] => (item=VLAN-1007)
ændret: [m9-04-r-04] => (item=VLAN-1008)
ændret: [m9-04-r-04] => (item=VLAN-1009)
ændret: [m9-04-r-04] => (item=VLAN-1010)
ændret: [m9-04-r-04] => (item=VLAN-1011)
ændret: [m9-04-r-04] => (item=VLAN-1012)
ændret: [m9-04-r-04] => (item=VLAN-1013)
ændret: [m9-04-r-04] => (item=VLAN-1100)

TASK [mk_routeros_emergency_on : Ændre OSPF område1 standardomkostninger til 10] ******************
ændret: [m9-04-r-04]

TASK [mk_routeros_emergency_on : Ændre MGMT interfaces IP-adresser] ********************
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n.254', u'name': u'VLAN-803'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+1.254', u'name': u'VLAN-805'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+2.254', u'name': u'VLAN-807'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+3.254', u'name': u'VLAN-809'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+4.254', u'name': u'VLAN-820'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+5.254', u'name': u'VLAN-822'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+6.254', u'name': u'VLAN-823'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+7.254', u'name': u'VLAN-824'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+8.254', u'name': u'VLAN-850'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+9.254', u'name': u'VLAN-851'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+10.254', u'name': u'VLAN-852'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+11.254', u'name': u'VLAN-853'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+12.254', u'name': u'VLAN-870'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+13.254', u'name': u'VLAN-898'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+14.254', u'name': u'VLAN-899'})

TASK [mk_routeros_emergency_on : Generer gARPs for MGMT interfaces] *********************
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n.254', u'name': u'VLAN-803'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+1.254', u'name': u'VLAN-805'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+2.254', u'name': u'VLAN-807'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+3.254', u'name': u'VLAN-809'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+4.254', u'name': u'VLAN-820'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+5.254', u'name': u'VLAN-822'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+6.254', u'name': u'VLAN-823'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+7.254', u'name': u'VLAN-824'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+8.254', u'name': u'VLAN-850'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+9.254', u'name': u'VLAN-851'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+10.254', u'name': u'VLAN-852'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+11.254', u'name': u'VLAN-853'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+12.254', u'name': u'VLAN-870'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+13.254', u'name': u'VLAN-898'})
ændret: [m9-04-r-04] => (item={u'ip': u'х.х.n+14.254', u'name': u'VLAN-899'})

PLAY RECAP ************************************************************************
Færdig!
Det er faktisk ikke helt klar, lad os ikke glemme konvergensen af dynamiske routingprotokoller og indlæsning af et stort antal ruter i FIB. Dette kan vi ikke påvirke. Vi venter. Det er konvergeret. Nu er det klart.
Og i landsbyen Villabaggio (som ikke ønsker at automatisere netværksopsætningen) fortsætter de med at vaske op. Bruce (faktisk en anden, men lige så cool) prøver at forstå, hvor meget udstyr der stadig skal omkonfigureres manuelt.
Jeg vil gerne også stoppe op ved et vigtigt punkt. Hvordan får vi alt tilbage? Efter en tid vil vi genoplive vores FW-CLUSTER. Dette er den primære hardware, ikke en backup, og netværket skal køre på den.
Kan du mærke, at det begynder at brænde på hos netværksfolkene? Den tekniske direktør vil høre tusind argumenter for, hvorfor dette ikke skal gøres, hvorfor det kan gøres senere. Desværre ender arbejdet i netværket ofte med en masse lapper, stumper og rester af tidligere luksus. Det bliver til et lap- og lappeagtigt tæppe. Vores opgave generelt, ikke i denne specifikke situation, men som it-specialister, er at bringe netværksarbejdets konsistens til det smukke engelske ord 'consistency', hvilket er meget mangesidigt, kan oversættes som: sammenhæng, ikke-modstridighed, logik, harmoni, systematik, sammenlignelighed, kobling. Det handler alt sammen om det. Kun i en sådan tilstand er netværket håndterbart; vi forstår klart, hvad og hvordan det fungerer, vi er bevidste om, hvad der skal ændres, hvis nødvendigt, og vi ved præcis, hvor vi skal se, hvis der opstår problemer. Og kun i et sådant netværk kan der udføres tricks, ligesom dem vi nu har beskrevet.
Egentlig var der også forberedt en anden playbook, der genskabte indstillingerne til deres oprindelige tilstand. Logikken bag dens arbejde er den samme (det er vigtigt at huske, at rækkefølgen af opgaver er meget vigtig); for ikke at forlænge denne allerede ret lange artikel, besluttede vi at undlade at offentliggøre et eksemplar af udførelsen af playbooken. Gennemfører du sådanne øvelser, vil du føle dig meget mere afslappet og sikker på fremtiden, desuden vil enhver klods, du har bygget, straks blive åbenbaret.
Alle interesserede kan skrive til os og få kilden til al den skrevne kode, sammen med alle playbooks. Kontaktoplysninger findes i profilen.
Konklusioner
Vi mener, at de processer, der kan automatiseres, endnu ikke er blevet fuldt udkrystalliseret. Baseret på vores erfaringer og hvad vores kolleger i Vesten diskuterer, er der indtil videre følgende emner synlige:
- Enheds provisionering;
- Dataindsamling;
- Rapportering;
- Fejlfinding;
- Overholdelse.
Hvis der er interesse, kan vi fortsætte diskussionen om et af de nævnte emner.
Vi ønsker også at reflektere lidt over automatisering. Hvordan skal den udformes efter vores forståelse:
- Systemet skal kunne fungere uden menneskelig indblanding, samtidig med at det forbedres af mennesker. Systemet må ikke være afhængigt af mennesker;
- Driften skal være ekspertmæssig. Der mangler en klasse specialister, der udfører rutineopgaver. Der er eksperter, som har automatiseret al rutine og kun løser komplekse opgaver;
- Rutine-standardopgaver udføres automatisk ‘med et klik’, ressourcer spildes ikke. Resultatet af sådanne opgaver er altid forudsigeligt og klart.
Og hvad disse punkter skal føre til:
- Gennemsigtighed i IT-infrastrukturen (mindre risici ved drift, modernisering, implementering. Mindre nedetid om året);
- Mulighed for at planlægge IT-ressourcer (Capacity-planning system — man kan se, hvor meget der forbruges, og hvor mange ressourcer der kræves i et samlet system, ikke kun via e-mails og møder med ledelsen);
- Mulighed for at reducere antallet af IT-personale, der er ansvarlig for vedligeholdelse.
Artiklens forfattere: Alexander Chelyakov (CCIE RS, CCIE SP) og Pavel Kirillov. Vi er interesserede i at diskutere og foreslå løsninger om automatisering af IT-infrastruktur.
Kilde: habr.com
