

Hello, Habr!
Data er virksomhedens mest værdifulde aktiv. Dette hævder næsten enhver virksomhed med en digital orientering. Det er svært at argumentere imod: Uden at diskutere metoderne til håndtering, opbevaring og behandling af data finder der ikke en eneste stor IT-konference sted.
Data kommer til os udefra, men de dannes også internt i virksomheden, og når vi taler om data for telekommunikationsvirksomheder, så er det for de interne medarbejdere en guldmine af informationer om kunderne, deres interesser, vaner og placering. Med korrekt profilering og segmentering bliver reklamebudskaberne mest effektive. Desværre er virkeligheden ikke så lys. De data, som virksomheder opbevarer, kan være håbløst forældede, overflødige, duplikerede, eller ingen udover en snæver kreds af brugere kender til deres eksistens. ¯_(ツ)_/¯
Kort sagt skal data effektivt styres - kun på den måde bliver de et aktiv, der bringer virksomheden reelle fordele og profit. Desværre er der mange udfordringer, der skal overvindes for at løse problemerne med datastyring. Disse er hovedsageligt betinget af både historisk arv i form af "zoopark"-systemer samt manglen på ensartede processer og tilgange til styringen af dem. Men hvad betyder det at "styre data"?
Det er netop dette, vi vil tale om under overskriften, samt hvordan vi blev hjulpet af et open-source stack.
Konceptet for strategisk datastyring Data Governance (DG) er allerede godt kendt på det russiske marked, og de mål, som virksomhederne opnår som følge af dens implementering, er forståelige og klart angivet. Vores virksomhed er ingen undtagelse og har sat sig for at implementere datastyringskonceptet.
Så, hvor begyndte vi? Først og fremmest satte vi os nogle nøglemål:
- Sikre tilgængeligheden af vores data.
- Sikre gennemsigtighed i datalivscyklussen.
- Give virksomhedens brugere konsistente og ikke-modstridende data.
- Give virksomhedens brugere verificerede data.
I dag findes der et dusin værktøjer af typen Data Governance på softwaremarkedet.
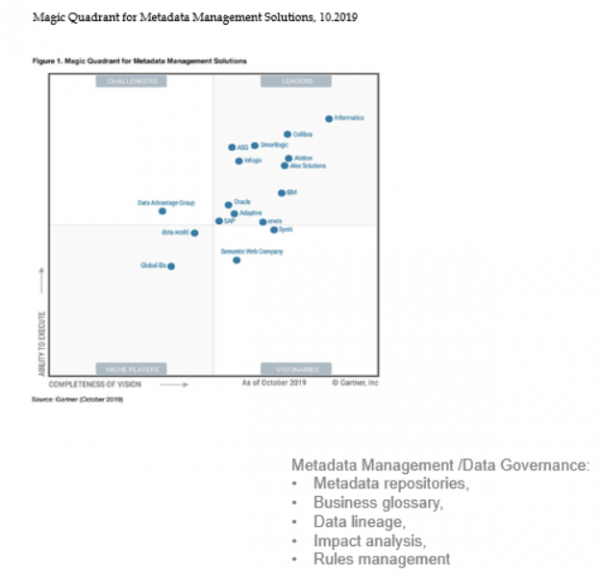
Men efter en grundig analyse og gennemgang af løsningerne har vi noteret os en række kritiske bemærkninger:
- De fleste producenter tilbyder et omfattende sæt løsninger, som er overdrevent for os og duplikerer allerede eksisterende funktionalitet. Derudover kræver integrationen i det nuværende IT-landskab betydelige ressourcer.
- Funktionaliteten og grænsefladen er beregnet til teknikere, ikke slutbrugere i virksomheder.
- Lav overlevelsesrate for produkter og mangel på succesfulde implementeringer på det russiske marked.
- Høj pris for software og videre support.
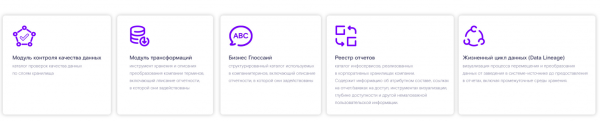
De ovenfor nævnte kriterier og anbefalinger vedrørende importsubstitution af software til russiske virksomheder har overbevist os om at gå i retning af egen udvikling på en open-source stak. Vi har valgt Django som platform – et gratis og open source framework skrevet i Python. På den måde har vi identificeret nøglemoduler, der vil bidrage til de nævnte mål:
- Rapportregister.
- Forretningsglossar.
- Modul til beskrivelse af tekniske transformationer.
- Modul til beskrivelse af datalivscyklussen fra kilde til BI-værktøj.
- Modul til kvalitetskontrol af data.
Rapportregister
Ifølge interne undersøgelser i store virksomheder bruger medarbejdere, der arbejder med data, 40-80% af deres tid på at finde dem. Derfor har vi sat os for at gøre information om eksisterende rapporter, der tidligere kun var tilgængelige for kunderne, åben. På denne måde reducerer vi tiden til at danne nye rapporter og sikrer demokratiseringen af data.
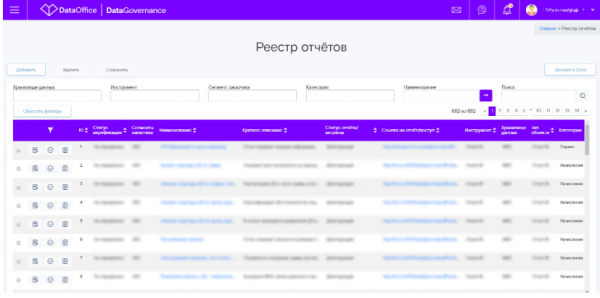
Rapportregisteret er blevet ét samlet rapporteringsvindue for interne brugere fra forskellige regioner, afdelinger og enheder. Det konsoliderer information om infoservices, der er oprettet i flere virksomhedslagre, og der er mange i Rostelecom.
Men registeret er ikke bare en tør liste over udviklede rapporter. For hver rapport giver vi den nødvendige information til brugeren for selvstændigt at blive bekendt med den:
- kort beskrivelse af rapporten;
- dataadgangsniveau;
- kunde-segment;
- visualiseringsværktøj;
- navn på det virksomhedslager;
- forretningsfunktionelle krav;
- link til rapporten;
- link til anmodning om adgang;
- implementeringsstatus.
Rapporterne giver adgang til analyse af brugssituationen, og rapporterne placeres i toppen af listen baseret på loganalytik af antallet af unikke brugere. Og det er ikke alt. Udover de generelle karakteristika har vi også inkluderet en detaljeret beskrivelse af attributsammensætningen af rapporterne med eksempler på værdier og beregningsmetoder. Denne detaljeringsgrad giver straks brugeren svar på, om rapporten er nyttig for dem eller ej.
Udviklingen af denne modul var et vigtigt skridt mod at demokratisere dataene og reducerede betydeligt tiden til at finde den ønskede information. Udover at reducere tiden til at finde information, faldt antallet af henvendelser til supportteamet for rådgivning også. Det er også værd at bemærke et andet nyttigt resultat, som vi opnåede ved at udvikle et samlet register over rapporter – at forhindre udviklingen af dublerede rapporter til forskellige organisatoriske enheder.
Forretningsordbog
Vi ved alle, at selv inden for den samme virksomhed taler man forskellige sprog. Ja, man bruger de samme termer, men forstår helt forskellige ting ved dem. At løse dette problem er målet med forretningsordbogen.
For os er forretningsordbogen ikke bare et opslagsværk med beskrivelser af termer og beregningsmetoder. Det er et fuldt udviklingsmiljø for godkendelse og fastlæggelse af terminologi, samt opbygning af forbindelser mellem termer og andre informationsaktiver i virksomheden. Før en term kan komme ind i forretningsordbogen, skal den gennemgå alle godkendelsesfaser med forretningsbestillere og datakvalitetscentret. Først derefter bliver den tilgængelig for brug.
Som jeg nævnte tidligere, er uniciteten af dette værktøj, at det tillader at skabe forbindelser fra niveauet af forretningsbegrebet til specifikke bruger-rapporter, hvor det anvendes, samt til niveauet af fysiske databaseobjekter.
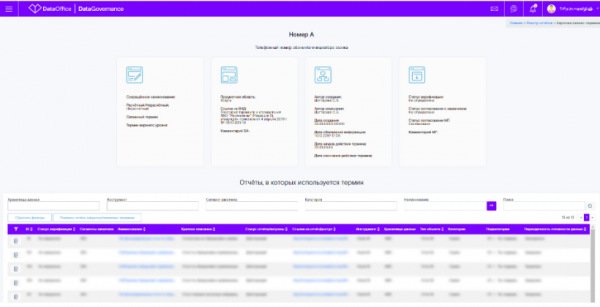
Dette blev muligt ved at bruge identifikatorerne fra ordbogen i den detaljerede beskrivelse af rapporterne fra registre samt beskrivelsen af de fysiske databaseobjekter.
I øjeblikket er der allerede defineret og godkendt over 4000 termer i Glossariet. Dets anvendelse forenkler og fremskynder behandlingen af indkommende forespørgsler om ændringer i virksomhedens informationssystemer. Hvis den ønskede indikator allerede er implementeret i en rapport, vil brugeren straks se en samling af rapporter, hvor denne indikator er anvendt, og kan beslutte om effektiv genanvendelse af eksisterende funktionalitet eller minimal tilpasning, uden at der skal igangsættes nye anmodninger om udvikling af en ny rapport.
Modul til beskrivelse af tekniske transformationer og DataLineage
Du spørger, hvad det er for moduler? Det er ikke nok blot at implementere Rapportregisteret og Glossariet; alle forretningsudtryk skal også tilpasses den fysiske datamodel. På den måde har vi været i stand til at afslutte processen for data livscyklus fra kildesystemer til BI-visualisering gennem alle lag af datalagring. Med andre ord - opbygge DataLineage.
Vi har udviklet et interface, der bygger på det format, der tidligere blev anvendt i virksomheden til beskrivelse af regler og logik for datatransformation. Gennem interfacet indtastes alt den samme information som før, men det er blevet et krav at definere identifikatoren for udtrykket fra forretnings-gengarasiet. Sådan opbygger vi forbindelsen mellem forretningslagene og de fysiske lag.
Hvem har brug for dette? Hvad fungerede ikke med det gamle format, som vi har arbejdet med i flere år? Hvor meget er arbejdsbyrden øget for kravdannelsen? Vi måtte stå over for sådanne spørgsmål under implementeringen af værktøjet. Her er svarene ganske enkle - det er nødvendigt for os alle, dataafdelingen i vores virksomhed og vores brugere.
Det er sandt, at medarbejderne måtte omstille sig; i starten førte det til en mindre stigning i arbejdsomkostningerne til forberedelse af dokumentation, men vi har fået styr på det. Praksis, identificering og optimering af problemområder har gjort deres pligt. Vi har opnået det vigtigste — vi har forbedret kvaliteten af de krav, der udvikles. Obligatoriske felter, standardiserede referencer, inputmasker, indbyggede kontroller – alt dette har betydeligt forbedret kvaliteten af beskrivelsen af transformationer. Vi er gået væk fra praksis med at overlevere scripts som udviklingskrav, og vi har delt viden, der tidligere kun var tilgængelig for udviklingsteamet. Den oprettede metadata-database reducerer betydeligt tiden til at gennemføre regressionstest og muliggør hurtig vurdering af ændringers indflydelse på alle lag i IT-landskabet (rapportvisninger, aggregeringer, kilder).
Og hvad med de almindelige brugere af rapporter, hvilke fordele er der for dem? Takket være muligheden for at opbygge DataLineage får vores brugere, selv dem der er langt fra SQL og andre programmeringssprog, hurtigt oplysninger om de kilder og objekter, der danner grundlaget for en given rapport.
Modul til kontrol af datakvalitet
Alt, hvad vi har talt om ovenfor vedrørende sikring af datatransparens, er ligegyldigt uden forståelse for, at de data, vi leverer til brugerne, er korrekte. Et af de vigtige moduler i vores Data Governance-koncept er modulet til kontrol af datakvalitet.
I øjeblikket er dette et katalog over kontroller for udvalgte enheder. Det nærmeste mål for produktudviklingen er udvidelsen af listen over kontroller og integration med rapportregistret.
Hvad vil det give, og hvem? For slutbrugeren af registret vil der være adgang til oplysninger om planlagte og faktiske datoer for rapportens klarhed, resultaterne fra gennemførte kontroller med dynamik, oplysninger om de kilder, der er indlæst i rapporten.
For os er modulet til datakvalitet, der er integreret i arbejdsgangene, dette:
- Hurtig oprettelse af forventninger fra kunderne.
- Beslutninger om videre brug af data.
- Modtagelse af et foreløbigt sæt problemområder i de indledende faser af arbejdet til udvikling af regelmæssige kontroller af kvaliteten.
Uden tvivl er dette de første skridt i opbygningen af en fuldgyldig datahåndteringsproces. Men vi er sikre på, at kun ved systematisk at arbejde med dette og aktivt implementere DataGovernance-værktøjer i arbejdsprocessen, vil vi sikre, at vores kunder får indsigt, høj tillid til dataene, gennemsigtighed i deres indhentning og øger hastigheden for at lancere ny funktionalitet.
DataOffice-teamet
Kilde: habr.com
