

Bem. overs.: denne lærerige historie fra Omio — en europæisk rejseaggregator — guider læserne fra grundlæggende teorier til spændende praktiske detaljer i konfigurationen af Kubernetes. At blive bekendt med sådanne tilfælde hjælper ikke kun med at udvide horisonten, men også med at forhindre ikke-trivielle problemer.
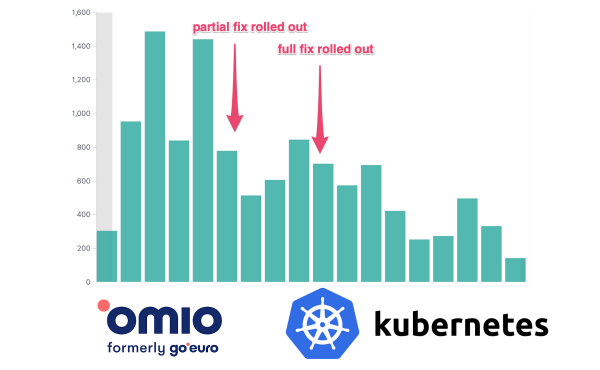
Har du nogensinde oplevet, at en applikation "frosset" på stedet, stoppede med at svare på statusforespørgsler (health checks), og du kunne ikke finde årsagen til denne adfærd? En mulig forklaring er relateret til kvotelimitter for CPU-ressourcer. Det er, hvad denne artikel vil omhandle.
TL;DR:
Vi anbefaler kraftigt at undgå CPU-limiter i Kubernetes (eller deaktivere CFS-kvoter i Kubelet), hvis der bruges en Linux-kernel med en fejl i CFS-kvoter. I kernen er der en alvorlig og fejl, der fører til overdreven throttling og latenser..
I Omio administreres hele infrastrukturen af Kubernetes.Alle vores stateful- og stateless-belastninger kører udelukkende på Kubernetes (vi bruger Google Kubernetes Engine). I de sidste seks måneder har vi observeret tilfældige forsinkelsesproblemer. Applikationerne fryser eller stopper med at svare på health checks, mister netværksforbindelse osv. En sådan adfærd satte os fast i lang tid, og til sidst besluttede vi os for at tage fat på problemet grundigt.
Artikeloversigt:
- Nogle ord om containere og Kubernetes;
- Hvordan CPU-forespørgsler og -limitter fungerer;
- Hvordan CPU-limitter fungerer i multi-core-miljøer;
- Hvordan man overvåger CPU-throttling;
- Løsningen på problemet og nuancer.
Nogle ord om containere og Kubernetes
Kubernetes er i essensen den moderne standard inden for infrastruktur. Dets hovedopgave er orkestrering af containere.
Containere
Tidligere måtte vi oprette artefakter som Java JAR’er/WAR’er, Python Egg’s eller eksekverbare filer til efterfølgende kørsel på serverne. Men for at få dem til at fungere, var vi nødt til at udføre ekstra arbejde: installere runtime-miljøet (Java/Python), placere de nødvendige filer de rette steder, sikre kompatibilitet med en bestemt version af operativsystemet osv. Med andre ord, vi var nødt til at give stor opmærksomhed til konfigurationsstyring (hvilket ofte førte til konflikte mellem udviklere og systemadministratorer).
Containere har ændret alt. Nu er artefakten en containerbillede. Det kan forstås som en slags udvidet eksekverbil, der indeholder ikke bare programmet, men også et fuldgyldigt udførelsesmiljø (Java/Python/…) samt de nødvendige filer/pakker, der er forudinstalleret og klar til brug. Containere kan implementeres og køre på forskellige servere uden yderligere handlinger.
Desuden fungerer containere i deres eget sandkassemiljø. De har deres egen virtuelle netværksadapter, deres eget filsystem med begrænset adgang, deres egen proceshierarki, deres egne begrænsninger for CPU og hukommelse osv. Alt dette er muligt takket være en særlig subsystem i Linux-kernen — namespaces (navnerum).
Kubernetes
Som nævnt tidligere er Kubernetes en orkestrator for containere. Det fungerer således: Du giver det en pulje af maskiner og siger derefter: „Hej, Kubernetes, kør ti instanser af min container med 2 processorer og 3 GB hukommelse hver, og hold dem kørende!“ Kubernetes tager sig af resten. Det finder ledige ressourcer, starter containere og genstarter dem om nødvendigt, udsender opdateringer ved versionændringer osv. I bund og grund giver Kubernetes dig mulighed for at abstrahere fra hardwarekomponenten og gør al den forskellige software anvendelig til implementering og kørsel af applikationer.
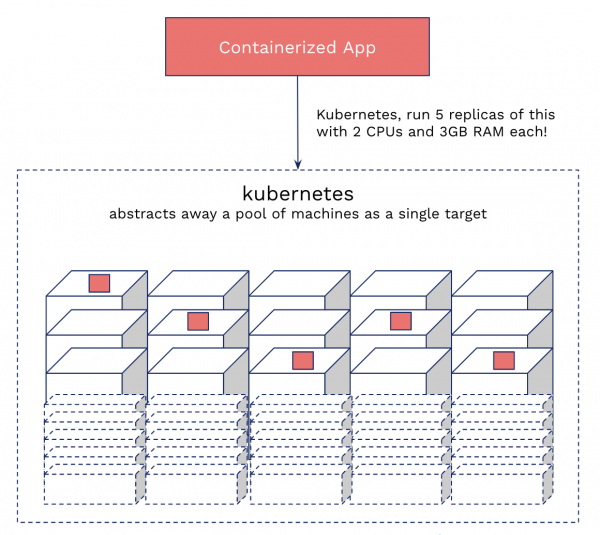
Kubernetes set fra en almindelig persons synspunkt
Hvad er requests og limits i Kubernetes
Okay, vi har forstået containere og Kubernetes. Vi ved også, at flere containere kan være på én maskine.
Man kan lave en analogi med en fælles lejlighed. Man tager et stort rum (maskiner/noder) og lejer det ud til flere lejere (containere). Kubernetes fungerer som ejendomsmægler. Spørgsmålet opstår, hvordan kan man forhindre lejerne i at komme i konflikt med hinanden? Hvad hvis en af dem beslutter at tage badeværelset i en halv dag?
Her kommer requests og limits ind i billedet. CPU Request er kun nødvendig til planlægning. Det er noget, der ligner en „ønskeliste“ for containeren, som bruges til at finde den mest passende node. Samtidig kan CPU Grænse sammenlignes med en lejekontrakt — så snart vi har fundet en node til containeren, kan den ikke overskride de fastsatte grænser. Og her opstår problemet...
Hvordan er request' og limit' implementeret i Kubernetes
Kubernetes bruger en indbygget kerne-mekanisme til throttling (cyklus-spring) til at implementere CPU-limiter. Hvis en applikation overskrider grænsen, aktiveres throttling (dvs. den modtager færre CPU-cyklusser). Requests og limiter for hukommelse er organiseret anderledes, så det er lettere at opdage. Det er tilstrækkeligt at kontrollere den seneste status for genstart af pod'en: er den ikke "OOMKilled". Med CPU-throttling er alt ikke så enkelt, da K8s kun gør metrikker om brug tilgængelige, ikke fra cgroups.
CPU Request
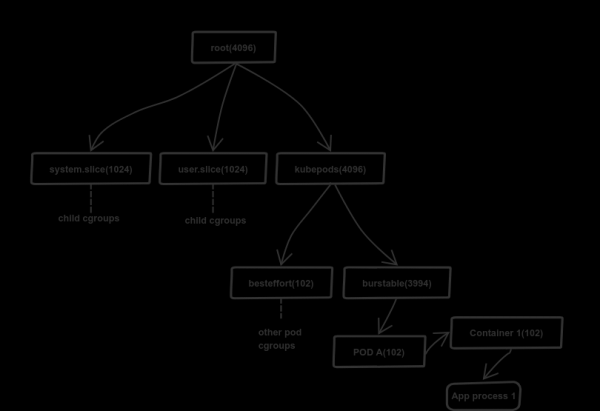
Hvordan er CPU-request implementeret
For enkelhedens skyld lad os overveje processen med eksemplet på en maskine med 4-kerne CPU.
K8s bruger kontrolgrupper (cgroups) til at styre fordelingen af ressourcer (hukommelse og CPU). Der er en hierarkisk model tilgængelig: et barn arver limit'ene fra den overordnede gruppe. Detaljerne omkring distributionen gemmes i det virtuelle filsystem (/sys/fs/cgroup). I tilfældet med CPU er dette /sys/fs/cgroup/cpu,cpuacct/*.
K8s bruger filen cpu.share til at fordele CPU-ressourcer. I vores tilfælde modtager den rodkontrolgruppe 4096 andele af CPU-ressourcer— 100% af den tilgængelige CPU-kraft (1 kerne = 1024; dette er en fast værdi). Den rodgruppe fordeler ressourcerne proportionalt afhængigt af andelene for børnene angivet i cpu.share, og de omvendt håndterer deres børn på samme måde, osv. I en typisk Kubernetes-node har rodkontrolgruppen tre børn: system.slice, user.slice og kubepods. De første to undergrupper anvendes til at fordele ressourcer mellem kritiske systembelastninger og brugerprogrammer uden for K8s. Den sidste— kubepods —oprettes af Kubernetes for at fordele ressourcer mellem pod'ene.
På diagrammet ovenfor kan vi se, at den første og anden undergruppe har modtaget hver 1024 andel, mens undergruppen kubepod er tildelt 4096 andele. Hvordan er det muligt: for rodgruppen er der kun tilgængelige 4096 andele, mens summen af andelene for dens børn langt overstiger dette tal (6144)? Det faktum, at værdien har logisk mening, er grunden til, at Linux-planlæggeren (CFS) bruger dette til proportional fordeling af CPU-ressourcer. I vores tilfælde modtager de første to grupper hver 680 reelle andele (16,6% af 4096), mens kubepod får de resterende 2736 andele. I tilfælde af stilstand vil de første to grupper ikke bruge de tildelte ressourcer.
Heldigvis har planlæggeren en mekanisme, der forhindrer tab af ubrugte CPU-ressourcer. Den overfører "inaktive" ressourcer til en global pulje, hvorfra de fordeles til grupper, der har brug for ekstra processorkraft (overførslen sker i partier for at undgå tab fra afrunding). En lignende metode anvendes også for alle efterkommere.
Denne mekanisme sikrer en retfærdig fordeling af processorkraft og sørger for, at ingen proces "stjæler" ressourcer fra andre.
CPU Limit
Selvom konfigurationerne af grænser og anmodninger i K8s ligner hinanden, er deres implementering radikalt forskellig: det er den mest forvirrende og mindst dokumenterede del.
K8s anvender til at implementere grænser. Deres indstillinger angives i filerne cfs_period_us og cfs_quota_us i cgroup-mappen (den samme mappe, hvor filen befinder sig) cpu.share).
I modsætning til cpu.share, er kvoten baseret på tidsperioden, ikke på den tilgængelige processorkraft. cfs_period_us definerer varigheden af perioden (epoch) — dette er altid 100000 µs (100 ms). K8s har mulighed for at ændre denne værdi, men den er i øjeblikket kun tilgængelig i alpha-versionen. Planlæggeren bruger epoch til at genstarte de brugte kvoter. Den anden fil, cfs_quota_us, angiver den tilgængelige tid (kvote) i hver epoch. Bemærk, at den også angives i mikrosekunder. Kvoten kan overstige perioden; med andre ord kan den være mere end 100 ms.
Lad os overveje to scenarier på 16-kernede maskiner (den mest almindelige type computere hos os i Omio):
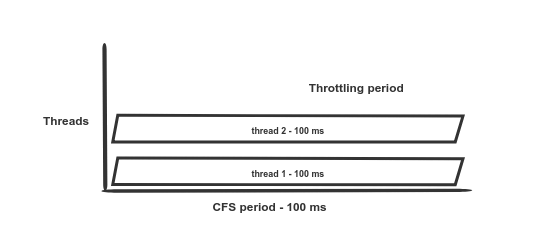
Scenarie 1: 2 tråde og en grænse på 200 ms. Uden throttling
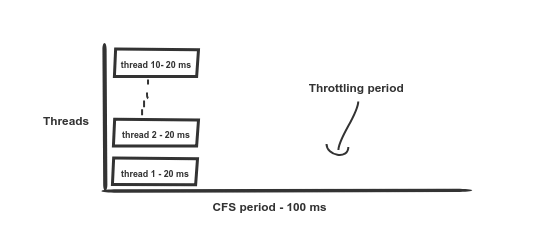
Scenarie 2: 10 tråde og en grænse på 200 ms. Throttling begynder efter 20 ms, adgangen til CPU-ressourcerne genoptages efter yderligere 80 ms
Antag, at du har indstillet CPU-grænsen til 2 kerner; Kubernetes konverterer denne værdi til 200 ms. Det betyder, at containeren kan maksimalt bruge 200 ms CPU-tid uden throttling.
Og her begynder det interessante. Som nævnt ovenfor er den tilgængelige kvote 200 ms. Hvis du kører parallelt ti tråde på en 12-kernet maskine (se illustrationen til scenarie 2), vil kvoten blive udtømt allerede efter 20 ms (fordi 10 * 20 ms = 200 ms), og alle tråde i denne pod vil "hænge" (throttle) i de næste 80 ms. Det forværrer allerede den nævnte situation , som medfører overdreven throttling, og containeren kan ikke engang opfylde sin tildelte kvote.
Hvordan vurderer man throttling i pods?
Bare log ind i pod'en og udfør cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— det samlede antal planlægningsperioder; -
nr_throttled— antallet af throttled-perioder ud afnr_periods; -
throttled_time— det samlede throttled-tid i nanosekunder.
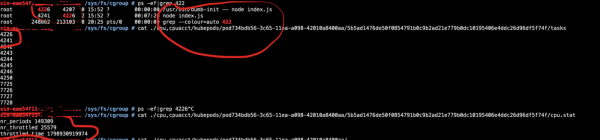
Hvad sker der egentlig?
Resultatet er høj throttling i alle applikationer. Nogle gange er det 1,5 gange stærkere end forventet!
Dette fører til forskellige fejl — fejl ved beredskabscheck (readiness), hængende containere, netværksafbrydelser, timeout i servicekald. I sidste ende resulterer det i øget forsinkelse og flere fejl.
Løsning og konsekvenser
Her er det simpelt. Vi har opgivet CPU-limits og arbejdet på at opgradere OS-kernen i klyngerne til den nyeste version, hvor fejlen blev rettet. Antallet af fejl (HTTP 5xx) i vores tjenester faldt straks betydeligt:
HTTP 5xx-fejl
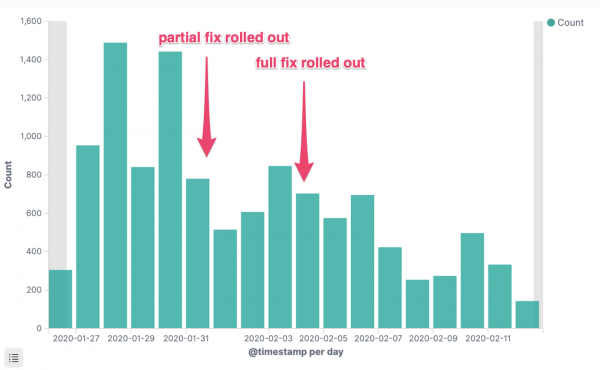
HTTP 5xx-fejl for en kritisk service
p95 svartid
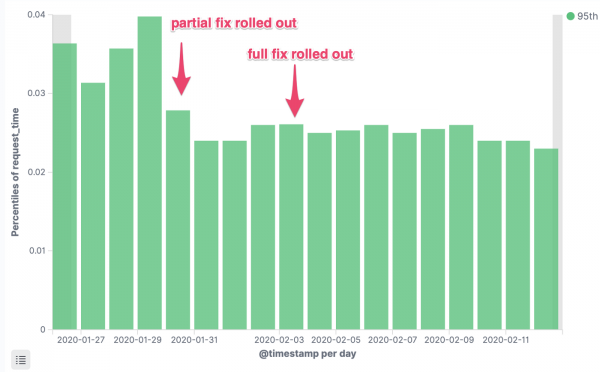
Forsinkelse af anmodninger til en kritisk service, 95. percentil
Driftsomkostninger
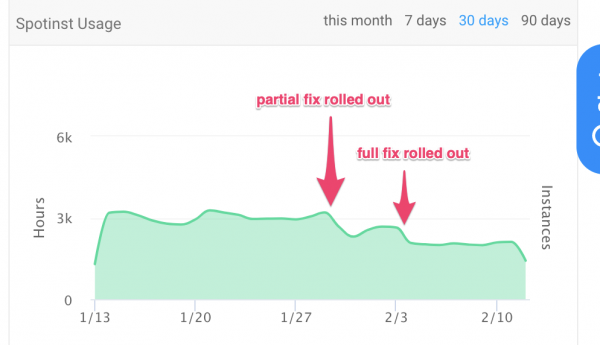
Antallet af forbrugt eksemplartimer
Hvor ligger finten?
Som nævnt i begyndelsen af artiklen:
Man kan lave en analogi med en fælles lejlighed… Kubernetes fungerer som en udlejer. Men hvordan kan man holde lejerne fra at skabe konflikter med hinanden? Hvad hvis en af dem, lad os sige, beslutter at tage badeværelset i et halvt døgn?
Her er finten. En uansvarlig container kan overtage alle tilgængelige CPU-ressourcer på maskinen. Hvis du har en solid stack af applikationer (for eksempel korrekt konfigurerede JVM, Go, Node VM), så er det ikke et problem: man kan arbejde under sådanne forhold i lang tid. Men hvis applikationerne er dårligt optimeret eller slet ikke optimeret (FROM java:latest), kan situationen komme ud af kontrol. Hos Omio har vi automatiserede grundlæggende Dockerfiles med passende standardindstillinger til de primære sprog, så vi har ikke oplevet dette problem.
Vi anbefaler at overvåge metrikker (brug, mætning og fejl), API-forsinkelser og fejlrate. Sørg for, at resultaterne lever op til forventningerne.
Links
Sådan er vores historie. De følgende materialer har været til stor hjælp til at forstå, hvad der foregår:
- ;
- ;
- ;
- ;
- — søg efter «cpu throttling».
Kubernetes-fejlrapporter:
- ;
- ;
- .
Har du oplevet lignende problemer i din praksis, eller har du erfaring med throttling i containeriserede produktionsmiljøer? Del din historie i kommentarfeltet!
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
