

Lige præcis sådan nogle klager hørte jeg fra vores udviklere. Det mest interessante er, at det viste sig at være sandt og førte til en langvarig undersøgelse. Det drejer sig om SQL-servere, der kører på vores VMware.
At få en produktionsserver til at tilbageholde sig betydeligt i forhold til en laptop er faktisk let. Udfør (ikke på tempdb og ikke på databasen med aktiveret forsinket holdbarhed) koden:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Hvilket langsommeligt væsen!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
På min desktop kører det på 5 sekunder, mens på produktionsserveren tager det 28 sekunder. Fordi SQL skal vente på den fysiske afslutning af skrivningen til transaktionsloggen, mens vi laver meget korte transaktioner. Groft sagt har vi presset en stor, kraftfuld lastbil ind i bytrafikken og ser, hvordan pizza-leveringsmænd på scootere overhaler den — her er throughput ikke vigtigt, kun latency. Og ingen netværkslagring, uanset hvor mange nuller der måtte være i prisen, kan vinde på latency mod en lokal SSD.
(i kommentarerne viste det sig, at jeg løg — jeg havde forsinket holdbarhed på begge steder. Uden forsinket holdbarhed får vi:
Desktop — 39 sekunder, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 sekunder, 1600 tr/sec, 0.6ms
Jeg burde have bemærket, at det var alt for hurtigt)
I dette tilfælde har vi dog at gøre med trivielle nuller af Riemann-funktionen med et trivielt eksempel. I det eksempel, som udviklerne bragte til mig, var der noget andet. Jeg sikrede mig, at de havde ret, og begyndte at rense deres eksempel for alt, hvad der havde med forretningslogik at gøre. På et tidspunkt indså jeg, at jeg kunne smide hele deres kode væk og skrive min egen — som demonstrerer det samme problem — på produktionsserveren kører den 3-4 gange langsommere:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- tjekker ulige op til sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Hvis alt er i orden, vil primtalskontrollen tage 6-7-8 sekunder. Sådan var det i en række servere. Men på nogle tog den 25-40 sekunder. Interessant nok var der ikke servere, hvor udførelsen tog for eksempel 14 sekunder — koden kørte enten meget hurtigt eller meget langsomt, hvilket betød, at problemet var, så at sige, sort-hvidt.
Hvad gjorde jeg? Jeg gik ind i VMware-metrikkerne. Det var alt sammen i orden - ressourcerne var rigelige, Ready time = 0, alt var tilstrækkeligt, under testen og på både hurtige og langsomme servere var CPU=100 på én vCPU. Jeg tog en test for beregning af Pi - testen viste de samme resultater på alle servere. Det begyndte stærkere at lugte af sort magi.
Da jeg kom ud til DEV-farmen, begyndte jeg at lege med serverne. Det viste sig, at vMotion fra vært til vært kunne "helbrede" serveren, men det kunne også omvendt gøre en "hurtig" server til en "langsom". Det virker som om, det er her - nogle værter har problemer... men... nej. En eller anden virtuel maskine var langsom på vært A, men kørte hurtigt på vært B. Og en anden virtuel maskine kørte omvendt, hurtigt på A og langsom på B! På værten var både "hurtige" og "langsomme" maskiner ofte i drift!
Fra dette øjeblik lugtede det tydeligt af svovl i luften. For problemet kunne ikke tilskrives den virtuelle maskine (Windows-opdateringer, for eksempel) - for den blev "hurtig" ved vMotion. Men problemet kunne heller ikke tilskrives værten - for på den kunne der være både "hurtige" og "langsomme" maskiner. Det var heller ikke relateret til belastningen - jeg kunne få en "langsom" maskine på en vært, hvor der slet ikke var noget andet.
Fra fortvivlelse startede jeg Process Explorer fra Sysinternals og så på SQL-stakken. På de langsomme maskiner bemærkede jeg straks linjen:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… springet over
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Det var allerede noget. Et program blev skrevet:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Dette program viste en endnu mere markant nedbremsning — på 'hurtige' maskiner registrerer det 16-18 millioner cykler i sekundet, mens det på langsomme blot er halvanden million, ja, endda 700.000. Det betyder, at forskellen er 10-20 gange (!!!). Det var allerede en lille sejr: i hvert fald var der ikke risiko for at blive fanget mellem Microsoft og VMware support, så de kunne kaste skylden på hinanden.
Derefter stoppede fremskridtene — ferie, vigtige forretninger, virus hysteri og pludselig stigning i belastningen. Jeg nævnte ofte det magiske problem for mine kolleger, men nogle gange føltes det, som om de slet ikke troede mig — erklæringen om, at VMware nedsætter koden 10-20 gange var alt for grotesk.
Jeg forsøgte selv at finde ud af, hvad der bremser. Nogle gange føltes det som om, jeg havde fundet løsningen — at tænde og slukke for Hot plugs, ændre hukommelsesvolumen eller antallet af processorer gjorde ofte maskinen 'hurtig'. Men ikke for evigt. Det, der viste sig at være sandt, var, at det var tilstrækkeligt at gå ud og banke på hjulet — det vil sige ændre enhver konfigurationen af den virtuelle maskine
Endelig fandt mine amerikanske kolleger pludselig roden til problemet.
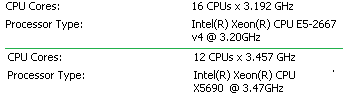
Værterne havde forskellig frekvens!
- Som regel er det ikke så skræmmende. Men: ved at flytte fra den 'oprindelige' vært til en vært med 'anden' frekvens, skal VMware justere resultatet af GetTimePrecise.
- Som regel er det ikke skræmmende, medmindre der viser sig at være applikationer, der anmoder om præcise tider millioner af gange i sekundet, som SQL server.
- Men det er heller ikke skræmmende, da SQL server ikke gør dette særlig ofte (se Konklusion)
Men der er tilfælde, hvor disse fælder slår hårdt. Og ja, ved at banke på hjulet (ændre noget i VM-indstillingerne) fik jeg VMware til at 'genberegne' konfigurationen, og den nuværende værtsfrekvens blev den 'oprindelige' frekvens for maskinen.
Løsning
Når du deaktiverer virtualisering af TSC, returnerer læsningen af TSC fra den virtuelle maskine den fysiske maskines TSC-værdi, og skrivningen af TSC fra den virtuelle maskine har ingen effekt. At migrere den virtuelle maskine til en anden vært, genoptage den fra en suspenderet tilstand eller vende tilbage til et snapshot medfører, at TSC springer ukontrolleret. Nogle gæsteoperativsystemer kan ikke starte eller viser andre tidsregistreringsproblemer, når TSC-virtualisering er deaktiveret. Tidligere er denne funktion nogle gange blevet anbefalet for at forbedre ydeevnen af applikationer, der ofte læser TSC., men ydeevnen af den virtuelle TSC er blevet betydeligt forbedret i nuværende produkter. Funktionen er også blevet anbefalet til brug ved udførelse af målinger, der kræver en præcis kilde til realtid i den virtuelle maskine.
Kort sagt, skal parameteren tilføjes
monitor_control.virtual_rdtsc = FALSE
Konklusion
Du har sikkert spurgt dig selv: hvorfor kalde GetTimePrecise i SQL så ofte?
Jeg har ikke koden til SQL-serveren, men logikken siger følgende. SQL er næsten som et operativsystem med cooperativ concurrency, hvor hver tråd skal give lidt plads fra tid til anden. Og hvor er det bedst at gøre det? Der, hvor der er naturlig ventetid — lock eller IO. Nå godt, hvad nu hvis vi kører beregningssløjfer? Så er det åbenlyst og næsten det eneste sted — i interpreteret (det er ikke helt en interpreter), efter udførelsen af den næste operation.
Som regel bruges SQL-server ikke til at drive ren beregning, og det er ikke et problem. Men sløjfer, der arbejder med forskellige midlertidige tabeller (som straks caches), forvandler koden til en sekvens af meget hurtigt udførte operationer.
Forresten, hvis man indkapsler funktionen i NATIVELY COMPILED, opfører den sig ikke længere som om den skal anmode om tid, og dens hastighed øges ti gange. Hvad med cooperative multitasking? Jamen, det var netop derfor, at der i SQL blev lavet PREEMPTIVE MULTITASKING for natively compiled code.
Kilde: habr.com
