

Udgivelsen af et nyt projekt i produktion kræver en omhyggelig balance mellem hastigheden af implementeringen og løsningens pålidelighed. Hos Slack værdsætter man hurtige iterationer, korte feedback-cyklusser og en hurtig reaktion på brugerhenvendelser. Desuden har virksomheden hundrede af programmører, der stræber efter maksimal produktivitet.
Forfatterne af det materiale, vi i dag offentliggør oversættelsen af, siger, at en virksomhed, der ønsker at opretholde sådanne værdier og samtidig vokse, konstant bør forbedre sit system til implementering af projekter. Virksomheden skal investere kræfter i gennemsigtighed og pålidelighed i arbejdsprocesserne, så disse processer svarer til projektets omfang. Her vil vi fokusere på de arbejdsgange, der er etableret i Slack, samt nogle løsninger, der har ført virksomheden til at anvende det nuværende system til implementering af projekter.
Hvordan projekternes implementeringsprocesser fungerer i dag
Hver PR (pull request) i Slack skal nødvendigvis gennemgå en koderevision og skal bestå alle tests. Først efter at disse betingelser er opfyldt, kan programmøren udføre sammenlægningen af sin kode med master-grenen af projektet. Implementeringen af denne kode udføres dog kun i arbejdstimer efter nordamerikansk tid. Som resultat er vi, da vores ansatte er på arbejdspladsen, fuldstændig klare til at håndtere enhver uventet problemstilling.
Hver dag udfører vi omkring 12 planlagte implementeringer. I forbindelse med hver implementering er programmøren, der er udpeget som ansvarlig for implementeringen, ansvarlig for at bringe den nye bygning i produktion. Det er en flertrinsproces, der sikrer en glat overførsel af bygningen til driftsstatus. Takket være denne tilgang kan vi opdage fejl, før de rammer alle vores brugere. Hvis der viser sig at være for mange fejl, kan implementeringen af bygningen rulles tilbage. Hvis en bestemt problemstilling opdages efter udgivelsen, kan der nemt udsendes en rettelse til den.
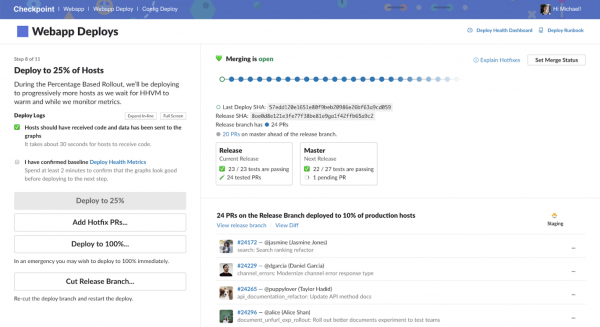
Brugerfladen i Checkpoint-systemet, som bruges i Slack til implementering af projekter
Processen for implementering af en ny udgivelse i produktion kan opdeles i fire trin.
▍1. Oprettelse af en releasegren
Hver release begynder med en ny releasegren fra det punkt i vores Git-historik. Dette muliggør at tildele tags til releasen og giver et sted, hvor man kan foretage hurtige rettelser for fejl, der findes under forberedelsen af releasen til produktion.
▍2. Deployment til staging-miljø
Næste trin i arbejdet er at implementere bygningen på staging-servere og køre automatiserede tests for den overordnede funktionalitet af projektet (smoke test). Staging-miljøet er et produktionsmiljø, der ikke modtager ekstern trafik. I dette miljø udfører vi yderligere manuel testning. Dette giver os ekstra sikkerhed for, at det ændrede projekt fungerer korrekt. Automatiserede tests alene er ikke tilstrækkelige for at opnå en sådan sikkerhed.
▍3. Deployment til dogfood- og canary-miljøer
Deployment i produktion starter med dogfood-miljøet, som består af en række værter, der betjener vores interne arbejdsrum i Slack. Da vi er meget aktive brugere af Slack, har denne tilgang hjulpet os med at opdage mange fejl tidligt i deploymentsprocessen. Efter at vi har bekræftet, at systemets grundlæggende funktionalitet ikke er blevet påvirket, udføres deployment af bygningen i canary-miljøet. Dette er systemer, der håndterer cirka 2% af produktions-trafikken.
▍4. Gradvis udrulning til produktion
Hvis overvågningsdataene for den nye release er stabile, og hvis vi ikke har modtaget klager efter deployment i canary-miljøet, fortsætter vi med den gradvise overførsel af produktionsservere til den nye release. Udrulningsprocessen er opdelt i følgende trin: 10%, 25%, 50%, 75% og 100%. Dette giver os mulighed for langsomt at lede produktions-trafikken til den nye release af systemet. På den måde har vi tid til at undersøge situationen, hvis der opdages anomalier.
▍Hvad skal man gøre, hvis noget går galt under udrulning?
At ændre i koden er altid en risiko. Men vi håndterer det takket være vores veluddannede 'deploy-chefer', der leder processen med at bringe en ny version i produktion, overvåger overvågningsmålinger og koordinerer arbejdet med programmører, der udsender koden.
Hvis noget så virkelig gik galt, forsøger vi at opdage problemet så tidligt som muligt. Vi undersøger problemet, finder PR'en, der forårsager fejlene, ruller den tilbage, analyserer grundigt og skaber en ny build. Nogle gange viser det sig dog, at problemet ikke opdages, før projektet er i produktion. I sådan en situation er det vigtigste at genoprette tjenestens funktion. Derfor ruller vi umiddelbart tilbage til den tidligere fungerende build, inden vi påbegynder problemforskningen.
Byggeblokke i deploymentsystemet
Lad os se på teknologierne bag vores projektdistributionssystem.
▍Hurtige udrulninger
Den beskrevne arbejdsproces kan fremstå som noget helt indlysende i retrospektiv. Men vores distributionssystem blev ikke til på et øjeblik.
Da virksomheden var betydeligt mindre, kunne hele vores applikation køre på 10 Amazon EC2-instanser. Udrulning af projektet i denne situation betød at bruge rsync til hurtig synkronisering af alle servere. Tidligere var der kun ét skridt, der adskilte den nye kode fra produktionen, repræsenteret ved et mellemstadie. Builds blev skabt og verificeret i et sådant miljø, og derefter gik de direkte til produktion. At finde rundt i et sådant system var meget enkelt; det gjorde det muligt for enhver programmør at deploye sin kode når som helst.
Men efterhånden som antallet af vores kunder voksede, voksede også størrelsen på den infrastruktur, der var nødvendig for at sikre drift af projektet. Snart, i takt med den vedvarende vækst af systemet, kunne vores distributionsmodel, der var baseret på at sende ny kode til serverne, ikke længere klare opgaven. Hver nye server betød øget tid til udførelse af udrulningen. Selv strategier, der er baseret på parallelrsync, har visse begrænsninger.
Som følge af dette har vi løst problemet ved at overgå til et fuldt parallelt system til implementering, som er opbygget anderledes end det gamle system. Det vil sige, at vi nu ikke sendte koden til serverne ved hjælp af et synkroniseringsscript. Nu downloader hver server selv den nye version, idet den får besked om, at dette skal gøres ved at overvåge ændringer i Consul-nøglen. Serverne henter koden parallelt. Dette har gjort det muligt for os at opretholde en høj implementeringshastighed, selv i en situation med konstant vækst i systemet.
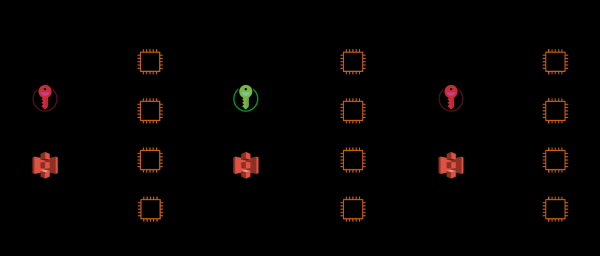
1. Produktionsserverne overvåger Consul-nøgle. 2. Nøglen ændres, hvilket informerer serverne om, at de skal begynde at downloade ny kode. 3. Serverne downloader tarball-filer med applikationskoden.
▍Atomiske implementeringer
En anden løsning, der hjalp os med at nå frem til et multilags implementeringssystem, var atomisk implementering.
Før brugen af atomiske implementeringer kunne hver implementering føre til en lang række fejlmeddelelser. Det skyldes, at processen med at kopiere nye filer til produktionsserverne ikke var atomisk. Dette førte til eksisteringen af et kort tidsvindue, hvor koden, der kaldte nye funktioner, blev tilgængelig, før selve funktionerne blev tilgængelige. Når sådan kode blev kaldt, medførte det, at der blev returneret interne fejl. Dette kom til udtryk i mislykkede API-anmodninger og "knuste" web-sider.
Holdet, der arbejdede med dette problem, løste det ved at indføre begreberne "varme" (hot) og "kolde" (cold) mapper. Koden i den "varme" mappe håndterer produktions-trafikken. I de "kolde" mapper forberedes koden til brug, mens systemet kører. Under implementeringen kopieres den nye kode til en ubenyttet "kold" mappe. Derefter, når der ikke er aktive processer på serveren, sker der et øjeblikkeligt skift mellem mapperne.
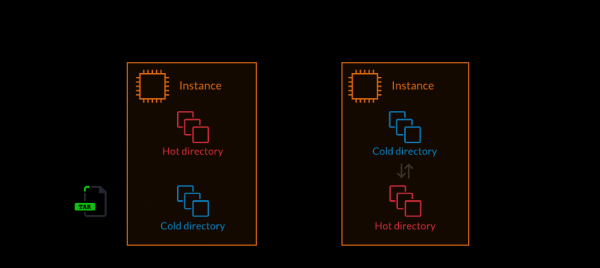
1. Udpakning af applikationskoden til den "kolde" mappe. 2. Skift af systemet til den "kolde" mappe, som bliver "varm" (atomisk operation).
Konklusioner: Fokus på pålidelighed
I 2018 voksede projektet til en størrelse, hvor meget hurtig implementering begyndte at skade stabiliteten af produktet. Vi havde et ganske avanceret implementeringssystem, som vi havde investeret meget tid og kræfter i. Vi skulle bare omstrukturere og forbedre processerne omkring implementeringen. Vi var blevet en ret stor virksomhed, hvis udviklinger blev brugt over hele verden til at sikre uafbrudt kommunikation og til at løse vigtige opgaver. Derfor blev pålidelighed vores hovedfokus.
Vi skulle gøre processen med at implementere nye versioner af Slack mere sikker. Denne nødvendighed førte til forbedringen af vores implementeringssystem. Faktisk har vi talt om det forbedrede system ovenfor. Inden i systemet fortsætter vi med at bruge teknologier til hurtig og atomar implementering. Det, der har ændret sig, er, hvordan implementeringen faktisk udføres. Vores nye system er designet til gradvist at implementere ny kode på forskellige niveauer og i forskellige miljøer. Nu bruger vi mere avancerede hjælpeværktøjer og systemovervågningsmidler end før. Dette giver os mulighed for at fange og rette fejl længe før, de når den endelige bruger.
Men vi har ikke tænkt os at stoppe her. Vi forbedrer konstant dette system ved at anvende mere avancerede hjælpeværktøjer og automatiseringsmidler.
Kære læsere! Hvordan er processen med at implementere nye versioner af projekterne, hvor du arbejder?
Kilde: habr.com
