

Rapporten præsenterer nogle tilgange, der gør det muligt at overvåge ydeevnen af SQL-forespørgsler, når der er millioner dagligt, og kontrollerede PostgreSQL-servere – hundreder.
Hvilke tekniske løsninger gør det muligt for os at håndtere så store datamængder effektivt, og hvordan letter det livet for den almindelige udvikler.
Hvem er interesseret i at analysere specifikke problemer og forskellige optimeringsteknikker af SQL-forespørgsler og løsning af typiske DBA-opgaver i PostgreSQL – man kan også om dette emne.
Mit navn er Kirill Borovikov, jeg repræsenterer . Specifikt specialiserer jeg mig i at arbejde med databaser i vores virksomhed.
I dag vil jeg fortælle, hvordan vi arbejder med optimering af forespørgsler, når du skal løse ikke kun én specifik forespørgsel, men en masse samtidig. Når der er millioner af forespørgsler, og du skal finde nogle tilgange til løsningen af dette store problem.
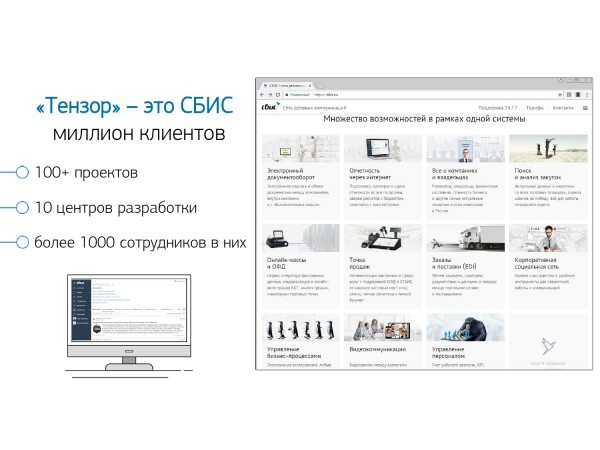
Generelt er «Tenzor» for vores million kunder : et corporate social network, løsninger til videokommunikation, til intern og ekstern dokumenthåndtering, regnskabssystemer og lagersystemer,… Så det er sådan en "mega-sammensætning" til kompleks forretningsstyring, der har mere end 100 forskellige interne projekter.
For at alle fungerer ordentligt og udvikler sig – har vi 10 udviklingscentre rundt omkring i landet, og der er mere end 1000 udviklere.
Vi har arbejdet med PostgreSQL siden 2008 og har opsamlet en stor mængde af det, vi behandler – det er kundeoplysninger, statistikker, analyser, data fra eksterne informationssystemer – mere end 400TB. Kun i "production" er der omkring 250 servere, og samlet set er der omkring 1000 DB-servere, som vi overvåger.
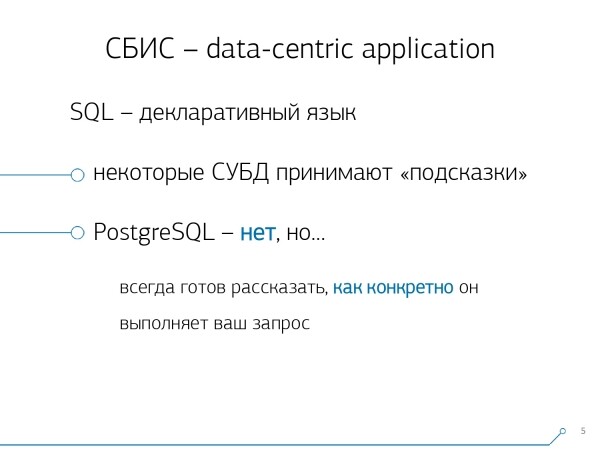
SQL er et deklarativt sprog. Du beskriver ikke "hvordan" noget skal fungere, men "hvad" du ønsker at opnå. SSQL-serveren ved bedre, hvordan man laver JOIN – hvordan man forbinder dine tabeller, hvilke betingelser der skal anvendes, hvad der går gennem indekset, hvad der ikke gør…
Nogle SQL-servere accepterer hints: "Nej, forbind de her to tabeller i en bestemt rækkefølge", men PostgreSQL kan ikke det. Dette er en bevidst holdning fra de ledende udviklere: "Vi vil hellere forbedre forespørgselsoptimereren end at lade udviklerne bruge hints."
Men selvom PostgreSQL ikke tillader at blive kontrolleret udefra, giver det fremragende mulighed for at se, hvad der sker indeni, når du udfører din forespørgsel, og hvor problemerne opstår.
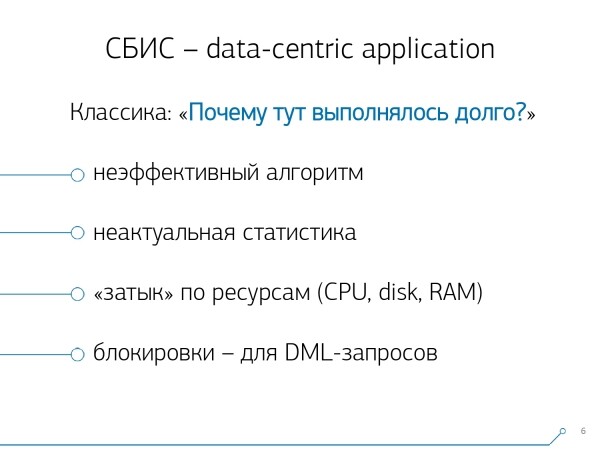
Generelt, hvilke klassiske problemer støder udvikleren [til DBA] normalt på? "Vi har udført en forespørgsel, og vi oplever langsomhed,det hele hænger, der sker et eller andet... Hvad er der galt!"
Årsagerne er næsten altid de samme:
- ineffektive forespørgselsalgoritmer
Udvikler: "Jeg laver nu en SQL-forespørgsel med 10 tabeller via JOIN..." - og forventer, at betingelserne på mirakuløs vis vil blive effektivt "løst", så han kan få alt hurtigt. Men mirakler sker ikke, og ethvert system med sådan en variation (10 tabeller i én FROM) vil altid give en eller anden form for unøjagtighed. [] - forældet statistik
Dette øjeblik er især aktuelt for PostgreSQL, når du har "indlæst" et stort datasæt på serveren, du laver en forespørgsel - men nu "seksskanner" det hele. Fordi der i går lå 10 poster i den, og i dag er det 10 millioner, men PostgreSQL er ikke klar over det endnu, og du skal fortælle det til det. [] - «flaskehals» af ressourcer
Du har sat en stor og tungt belastet database på en svag server, som ikke har nok diskplads, hukommelse, eller processorens kapacitet. Og det hele... Der er et performance-loft et sted, som du ikke kan overskride. - låsninger
Et kompliceret øjeblik, men de er mest relevante for forskellige modificerende forespørgsler (INSERT, UPDATE, DELETE) - det er et emne, der kræver en dybdegående behandling.
Modtagelse af plan
… Og for alt andet har vi brug for en plan! Vi skal kunne se, hvad der sker inde i serveren.
Forespørgselsplanen for PostgreSQL er et træ, der repræsenterer algoritmen til udførelse af forespørgslen i tekstformat. Dette er netop den algoritme, som blev anerkendt som den mest effektive efter planlæggerens analyse.
Hvert knudepunkt i træet er en operation: udrækning af data fra en tabel eller indeks, opbygning af en bitmask, sammenkobling af to tabeller, union, intersection eller udelukkelse af udvalgte data. Udførelsen af forespørgslen er en gennemgang af noderne i dette træ.
For at få forespørgselsplanen er den enkleste måde at udføre operatoren EXPLAIN. For at få det med alle de reelle attributter, det vil sige for faktisk at udføre forespørgslen på databasen - EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Dårligt tidspunkt: når du udfører det, sker det „her og nu“, så det er kun velegnet til lokal fejlfinding. Hvis du derimod arbejder med en server med høj belastning, der oplever en stærk strøm af ændringsdata, og ser: „Åh! Her er der en langsom udførelse af anmodningen.Det sagde. har Halv time, en time siden – mens du løb for at finde denne anmodning i logfilerne, og tog den tilbage til serveren, er hele dit datasæt og statistik ændret. Du udfører den for at fejlfinde – og den udføres hurtigt! Og du kan ikke forstå, hvorfor, hvorfor
det er langsomt. modulet auto_explain
. Det findes i næsten alle de mest almindelige distributioner af PostgreSQL, og kan nemt aktiveres i konfigurationsfilen. Hvis det opdager, at en eller anden anmodning tager længere tid end den grænse, du har angivet, tager det.
et ‚snapshot‘ af planen for denne anmodning og skriver det sammen i loggen.
Det ser ud til, at alt er godt nu, vi går ind i loggen og ser der… [tekstblok]. Men vi kan ikke sige noget om det, bortset fra det faktum, at det er en fremragende plan, fordi det blev udført på 11 ms.
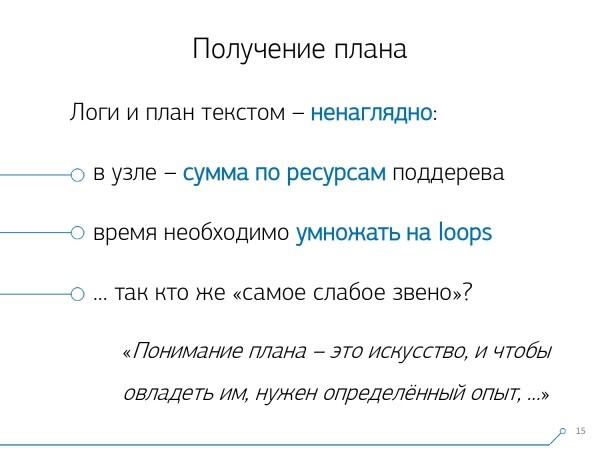
Det ser ud til, at alt er godt – men intet er klart, hvad der faktisk skete. Udover den samlede tid ser vi ikke meget. For det er overhovedet ikke befordrende at se på sådan en ‚klods‘ af almindelig tekst.
- Men selvom det ikke er befordrende, selvom det er besværligt, er der mere grundlæggende problemer: Knuden angiver summen af ressourcerne i hele undertræet
- under den. Så det er ikke muligt blot at finde ud af, hvor meget tid der konkret er brugt på denne Index Scan – hvis der under den er et indlejret betingelse. Vi skal dynamisk se, om der er „børn“ og betingede variabler, CTE – og trække alt dette ud „i hovedet“. Det andet punkt: den tid, der angives på knuden, ertiden for en enkelt udførelse af knuden. Hvis denne knude udførtes som resultat af for eksempel en løkke over posteringer i tabellen, flere gange, øges antallet af loops – cykler for denne knude. Men selve tiden for atomær udførelse forbliver den samme i planen. Så for at forstå, hvor længe denne knude hele tiden har været i drift, skal man multiplicere det ene med det andet – igen „i hovedet“.
Under these circumstances, understanding "Who is the weakest link?" is practically impossible. Therefore, even the developers themselves write in the "manual" that "Understanding the plan is an art that one must learn, experience…".
But we have 1000 developers, and you can't transfer this experience to each of them. I, you, he — know, but someone over there — does not yet. Maybe he will learn, maybe not, but he needs to work right now — and where is he supposed to get this experience from?
Visualization of the plan
So we realized — to deal with these problems, we need a good visualization of the plan.
We first went "to the market" — let's search the internet to see what exists.
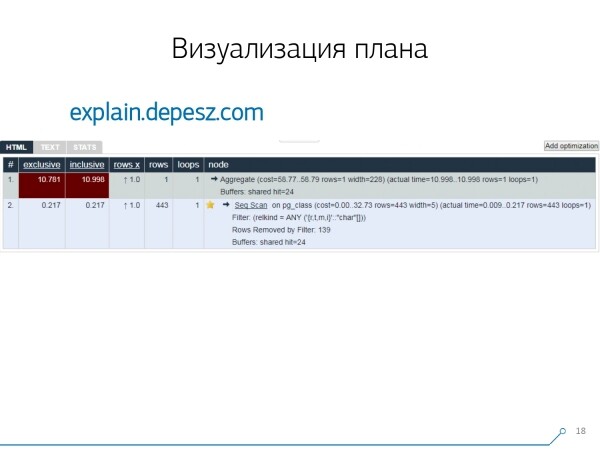
But it turned out that there are very few relatively "live" solutions that are more or less developing — literally just one: by Hubert Lubaczewski. You input a textual representation of the plan, and it shows you a table with analyzed data:
- the actual execution time of the node
- the total time for the entire subtree
- the number of records that were extracted, and what was statistically expected
- the body of the node itself
This service also has the ability to share an archive of links. You throw your plan there and say: "Hey, Vasya, here’s a link, something is wrong there."
But there are also a few small problems.
Firstly, a huge amount of "copy-pasting". You take a piece of log, stuff it in there, and again, and again.
For det andet, there is no analysis of the amount of data read — the buffers that are outputted by EXPLAIN (ANALYZE, BUFFERS), here we do not see. It simply cannot analyze, understand, and work with them. When you read a lot of data and realize that you might be incorrectly "laid out" on the disk and cache in memory, this information is very important.
The third negative point — very weak development of this project. Commits are very minor, well, if once every six months, and the code is in Perl.
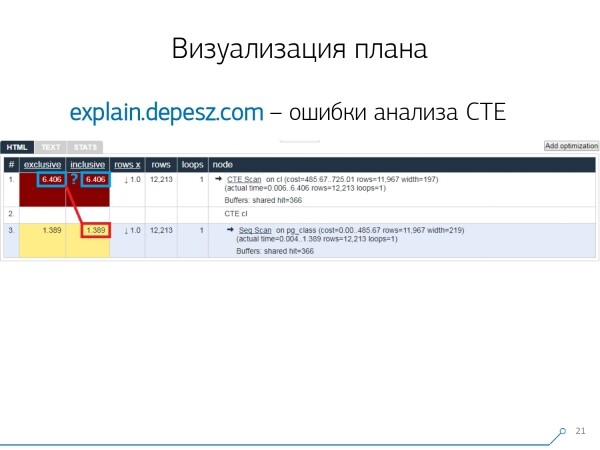
But that’s all "lyric", it could have been somehow lived with, but there is one thing that strongly turned us away from this service. It's the errors in analyzing Common Table Expressions (CTE) and various dynamic nodes such as InitPlan/SubPlan.
If you believe this picture, the total execution time of each separate node is greater than the total execution time of the entire query. It's simple — the CTE Scan node did not deduct the time of generating this CTESå derfor ved vi ikke længere det rigtige svar på, hvor lang tid selve CTE-scanningen tog.
Her indså vi, at det var på tide at skrive vores eget – hurra! Hver udvikler siger: „Nu skriver vi vores eget, det bliver super nemt!“
Vi tog en typisk webtjenestetekstack: kernen på Node.js + Express, tilføjede Bootstrap og til de flotte diagrammer – D3.js. Og vores forventninger blev fuldt ud indfriet – den første prototype fik vi lavet på 2 uger:
- vores egen planparser
Det vil sige, at vi nu kan analysere enhver plan, som PostgreSQL genererer. - korrekt analyse af dynamiske noder – CTE Scan, InitPlan, SubPlan
- analyse af bufferfordeling – hvor datablade læses fra hukommelsen, hvor fra lokal cache, hvor fra disk
- vi opnåede visualisering
For ikke at skulle lede efter alt det her i loggen, men for at se „det svageste led“ straks på billedet.
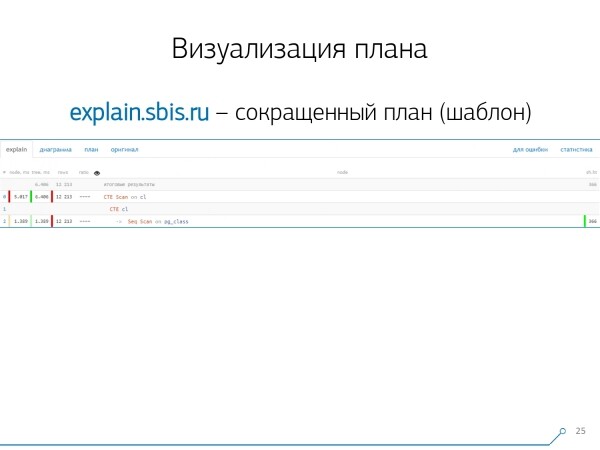
Vi fik et billede, der så nogenlunde sådan ud – straks med syntaksmarkering. Men normalt arbejder vores udviklere ikke med den fulde plan, men med en forkortet version. Vi har nemlig selv parseret alle tal og smidt dem til venstre og højre, mens vi kun lod den første linje være tilbage, som handler om hvilken node det er: CTE Scan, generering af CTE eller Seq Scan over et tabell.
Dette forkortede præsentaion kalder vi planens skabelon.
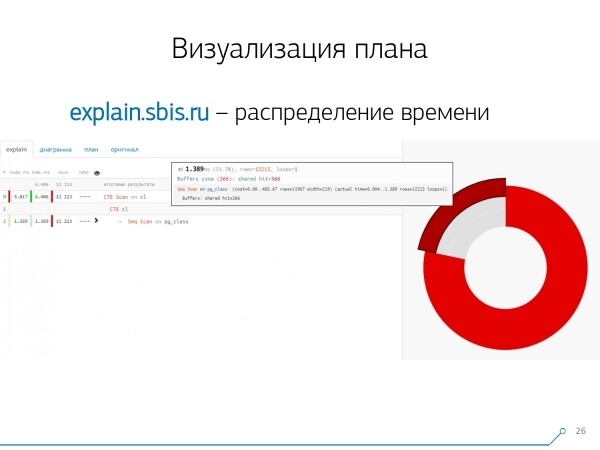
Hvad ville være praktisk? Det ville være praktisk at se, hvilken del af den samlede tid der fordeles på hvilken node – og vi „klistrede“ det bare på siden pie chart.
Vi holder musen over noden og ser – det viser sig, at vores Seq Scan tog mindre end en fjerdedel af al den tid, mens de andre 3/4 blev brugt på CTE Scan. Frygteligt! Dette lille bemærkning om „hastigheden“ af CTE Scan, hvis du bruger dem aktivt i dine forespørgsler. De er ikke særlig hurtige – de er langsommere end almindelige tabelscanninger.
Men normalt er sådanne diagrammer mere interessante og komplekse, når vi holder musen over et segment, og ser for eksempel, at mere end halvdelen af al tiden blev „spist“ af en Seq Scan. Og der var også et eller andet Filter inde i, masser af poster blev kasseret… Man kan sende dette billede direkte til udvikleren og sige: „Vasya, du har virkelig et problem her! Undersøg det, der er noget galt!“
Naturligvis kom der ikke nogen „faldgruber“ uden om.
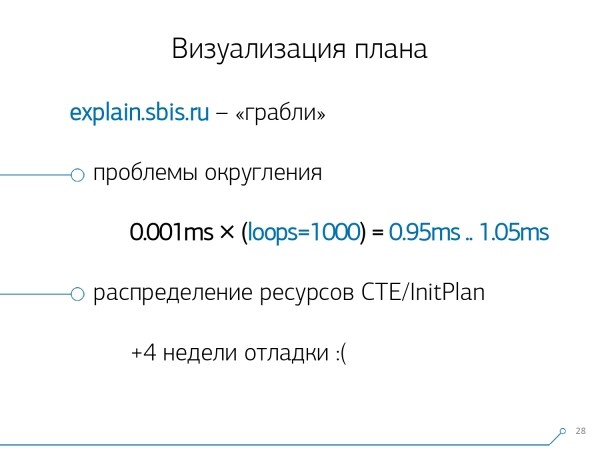
Det første, vi "støder på", er rundingsproblemet. Tiden for hver enkelt node i planen angives med en præcision på 1 μs. Og når antallet af cyklusser for node overskrider f.eks. 1000 — efter at PostgreSQL har udført "med den angivne præcision", får vi ved tilbageberegning den samlede tid "et sted mellem 0,95 ms og 1,05 ms". Når hver mikrosekund tæller, er det ikke så slemt, men når vi allerede taler om [millisekunder] — må vi tage hensyn til denne information, når vi "afvikler" ressourcerne per nodesplan "hvem har forbrugt hvad".
Det andet punkt, mere komplekst, er fordelingen af ressourcer (de såkaldte buffers) mellem de dynamiske noder. Det kostede os yderligere 4 uger i starten af de første 2 uger med prototypen.
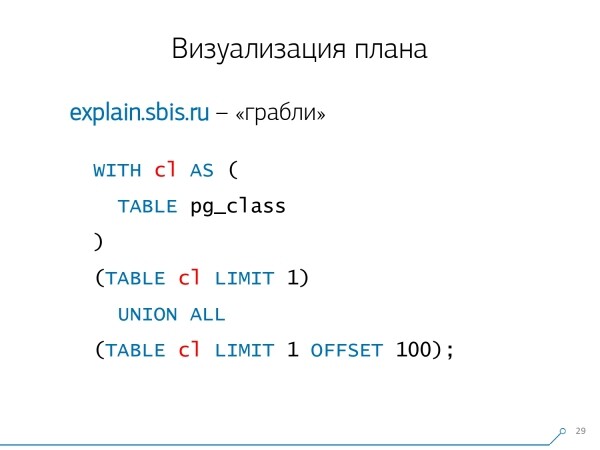
Det er ret nemt at få et sådant problem — vi laver en CTE og forsøger at læse noget i den. Faktisk er PostgreSQL "smart" og vil ikke læse noget direkte der. Senere tager vi den første post fra den, og til den — den hundrede første fra den samme CTE.
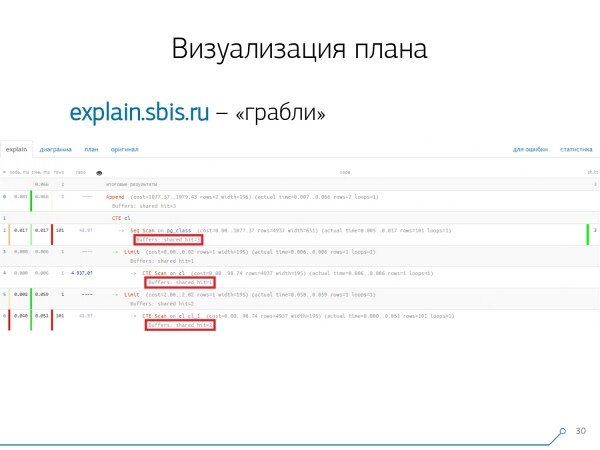
Vi ser på planen og forstår — underligt, vi havde 3 buffers (datasyner) "forbrugt" i Seq Scan, endnu 1 i CTE Scan, og yderligere 2 i den anden CTE Scan. Det vil sige, hvis vi blot summerer, får vi 6, men vi læste kun 3 fra tabellen! CTE Scan læser jo ikke noget fra noget sted, men arbejder direkte med processens hukommelse. Så her er der tydeligvis noget galt!
I virkeligheden viser det sig, at de 3 datasyner, der blev anmodet om i Seq Scan, først blev anmodet af den 1. CTE Scan, og derefter den 2., der læste yderligere 2. Så i alt blev 3 datasyner læst, ikke 6.
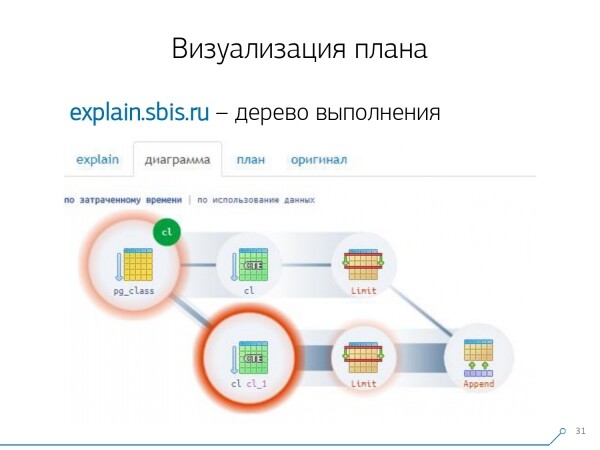
Og dette billede førte os til forståelsen af, at udførelsen af planen ikke længere er et træ, men blot en slags acyklisk graf. Og vi fik en omtrent sådan diagram, så vi kunne forstå "hvad-der-kom-fra-hvor". Det vil sige, her skabte vi CTE fra pg_class og bad om den to gange, og næsten al vores tid blev brugt på den gren, da vi bad om den 2. gang. Det er klart, at det er meget dyrere at læse den 101. post — end bare den 1. fra tabellen.

Vi tog et øjebliks indånding. Vi sagde: "Nu, Neo, du kender kung fu! Nu er vores erfaring lige på din skærm. Nu kan du bruge den."
Konsolidering af logs
Vorefter har vores 1000 udviklere lettet trukket vejret. Men vi forstod, at vi kun havde hundrede 'aktive' servere, og at hele dette 'copy-paste' fra udviklernes side var slet ikke praktisk. Vi indså, at vi selv måtte samle det.
Der findes faktisk en indbygget modul, der kan samle statistik, men det skal også aktiveres i konfigurationen — det er . Men det var ikke tilfredsstillende for os.
For det første tildeler det forskellige QueryId for de samme forespørgsler på forskellige skemaer inden for én database. forskellige QueryId. Det vil sige, at hvis man først udfører SET search_path = '01'; SELECT * FROM user LIMIT 1;, og derefter SET search_path = '02'; og en tilsvarende forespørgsel, så vil der være forskellige poster i statistikken fra dette modul, og jeg vil ikke kunne samle samlet statistik for netop denne forespørgselsprofil uden hensyntagen til skemaerne.
Det andet problem, der forhindrede os i at bruge det, er manglen på planer. Det vil sige, der er ikke et plan — kun forespørgslen selv. Vi kan se, hvad der gik langsomt, men ikke hvorfor. Og her kommer vi tilbage til problemet med det hurtigt ændrende datasæt.
Og endelig er der et sidste punkt — manglen på 'fakta'. Det vil sige, at man ikke kan henvise til en specifik eksekvering af forespørgslen — den findes ikke, der er kun aggregeret statistik. Det kan man arbejde med, men det er bare meget svært.
Derfor besluttede vi at bekæmpe 'copy-paste' og begyndte at skrive indsamleren.
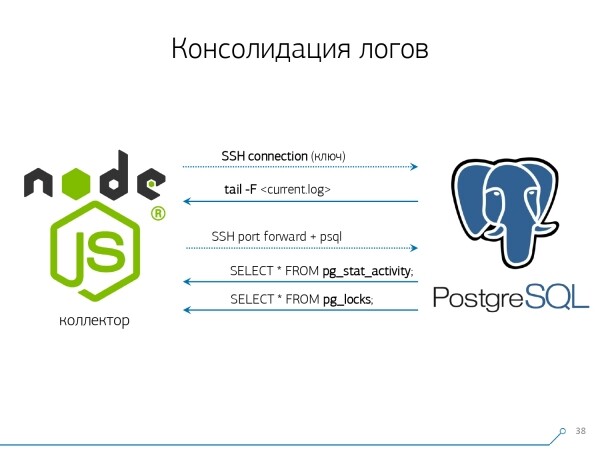
Indsamleren tilslutter sig via SSH, etablerer en sikker forbindelse til serveren med databasen ved hjælp af et certifikat og tail -F tilslutter sig logfilen. På denne måde får vi et fuldt 'spejl' af hele logfilen , som serveren genererer. Belastningen på selve serveren er minimal, da vi ikke parser noget, vi spejler bare trafikken.Da vi allerede var begyndt at skrive grænsefladen på Node.js, fortsatte vi med at skrive indsamleren der. Og denne teknologi har vist sig at være en god beslutning, fordi det er meget bekvemt at arbejde med svagt formaterede tekstdata, som loggen er, ved hjælp af JavaScript. Og selve infrastrukturen i Node.js som en backend-platform gør det let og bekvemt at arbejde med netværksforbindelser og generelt med datastreams.
Da vi allerede var begyndt at skrive grænsefladen i Node.js, fortsatte vi også med at skrive indsamleren i det. Denne teknologi har vist sig at være effektiv, fordi JavaScript er meget praktisk til at arbejde med svagt strukturerede tekstdata, som logfiler er. Selve infrastruktur Node.js som backend-platform gør det nemt og bekvemt at arbejde med netværksforbindelser og generelt med datastreams.
Derfor "trækker" vi to forbindelser: den første for at "lytte" til selve loggen og hente den, og den anden for jævnligt at spørge databasen. "Men i loggen kom der en besked om, at tabellen med oid 123 er blokeret", men det siger ikke udvikleren noget, og det ville være godt at spørge databasen "Hvad er OID = 123 egentlig?" Og så spørger vi periodisk databasen om det, som vi endnu ikke ved.
"Du har kun ikke overvejet en ting, der findes en slags elefantlignende bier!.." Vi begyndte at udvikle dette system, da vi ønskede at overvåge 10 servere. De mest kritiske i vores forståelse, hvor der opstod problemer, som var svære at løse. Men inden for den første kvartal fik vi hundrede til overvågning — fordi systemet "fungerede", alle ville have det, det var praktisk for alle.
Alt dette skal samles, dataflowet er stort og aktivt. Egentlig hvad vi overvåger og hvad vi kan håndtere — det bruger vi. Vi bruger også PostgreSQL som datalager. Og der er ikke noget hurtigere til at "hælde" data ind i det, end operatøren COPY der er endnu ikke.
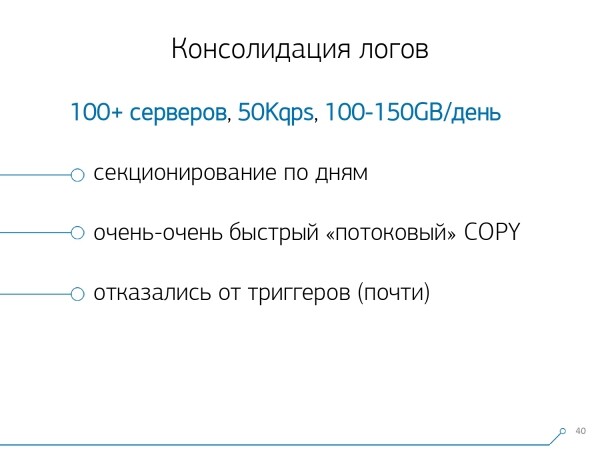
Men bare at "hælde" data ind er ikke helt vores teknologi. Fordi hvis du har hundrede servere, der genererer cirka 50k forespørgsler i sekundet, så genererer det 100-150GB logs om dagen. Derfor måtte vi forsigtigt "pille" databasen.
For det første lavede vi partitionering efter dage, fordi stort set ingen er interesseret i korrelationen mellem dagene. Hvad gør det nogen forskel, hvad der skete i går, når du natten over har rullet en ny version af applikationen ud — og der allerede er en ny statistik.
For det andet lærte vi (vi var nødt til at) skrive meget meget hurtigt ved hjælp af COPY. Det vil sige ikke blot COPY, fordi det er hurtigere end INSERT, men endnu hurtigere.
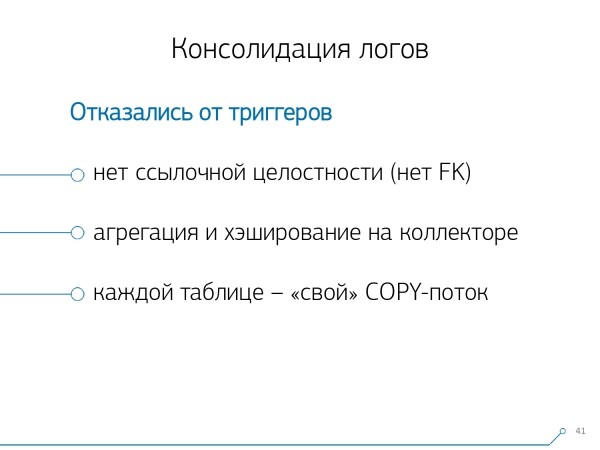
Tredje punkt — vi måtte give afkald på triggere og derfor også på Foreign Keys. Det vil sige, at vi slet ikke har referentiel integritet. Fordi hvis du har en tabel, hvor der er et par FK, og du siger i database-strukturen, at "her refererer en post fra loggen til en gruppe af poster", så har PostgreSQL ikke andet at gøre end ærligt at udføre SELECT 1 FROM master_fk1_table WHERE ... med den identifikator, du forsøger at indsætte — bare for at kontrollere, at denne post er der, så du ikke "ødelægger" denne Foreign Key med din indsættelse.
Vi får i stedet for en række i den målrettede tabel og dens indekser også læsning fra alle de tabeller, den refererer til. Og det har vi slet ikke brug for – vores opgave er at skrive så meget som muligt og så hurtigt som muligt med den mindste belastning. Så FK – væk med det!
Det næste punkt – aggregering og hashing. Oprindeligt var de implementeret i databasen – for det er jo praktisk, når en post ankommer, at gøre noget i en tabel. “plus én” direkte i triggeren. Godt, praktisk, men dårligt i samme åndedrag – du indsætter én post, men er nødt til at læse og skrive noget fra en anden tabel. Og ikke kun at læse og skrive – men også gøre det hver gang.
Og nu forestil dig, at du har en tabel, hvor du blot tæller antallet af forespørgsler, der er gået igennem en specifik vært: +1, +1, +1, ..., +1. Og det har du egentlig ikke brug for – alt dette kan summere i hukommelsen på indsamleren og sende til databasen på én gang. +10.
Ja, hvis der opstår nogle problemer, kan den logiske integritet "kollapse", men det er praktisk talt et usandsynligt scenarie – fordi du har en normal server, der har et batteri i controlleren, et transaktionslog, et log på filsystemet… Generelt set er det ikke værd det. Den tabte ydeevne, du får fra triggerne/FK, er ikke umagen værd.
Det samme gælder for hashing. En eller anden forespørgsel kommer til dig, du beregner et eller andet id i databasen, skriver det til databasen og fortæller alle om det. Det fungerer fint, indtil der i det øjeblik er en anden, der ønsker at skrive den samme – og du vil så opleve en blokering, og det er ikke godt. Så hvis du kan flytte genereringen af nogle ID’er til klienten (relativt til databasen), er det bedre at gøre det.
Det passede os perfekt at bruge MD5 fra teksten – forespørgslen, planen, skabelonen,… Vi beregner det på indsamlerens side, og "hældes" ind i databasen som allerede et klart ID. Længden af MD5 og daglig partitionering gør, at vi ikke behøver at bekymre os om mulige kollisioner.
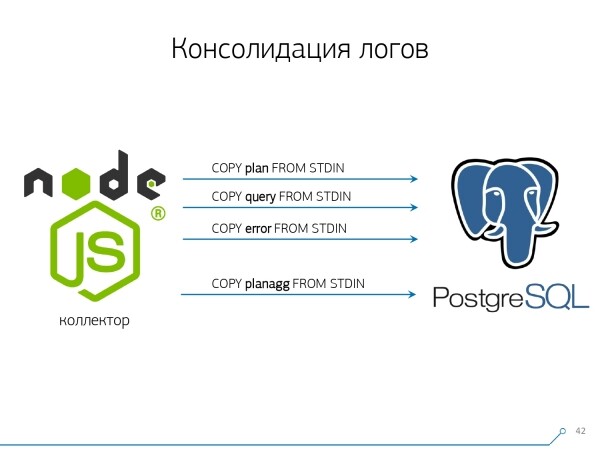
Men for at skrive alt dette hurtigt, måtte vi modificere selve skriveproceduren.
Hvordan skriver man typisk data? Vi har et datasæt, som vi fordeler i flere tabeller, og derefter COPY — først ind i den første, så den anden, den tredje… Det er upraktisk, fordi vi tilsyneladende skriver én datastream i tre trin sekventielt. Det er frustrerende. Kan vi gøre det hurtigere? Ja!
For at gøre dette er det tilstrækkeligt at fordele disse streams parallelt med hinanden. Det betyder, at fejl, forespørgsler, skabeloner, blokeringer,... flyder i separate streams — og vi skriver alt dette parallelt. For dette er det nok at holde en COPY-kanal konstant åben for hver enkelt mål tabel..
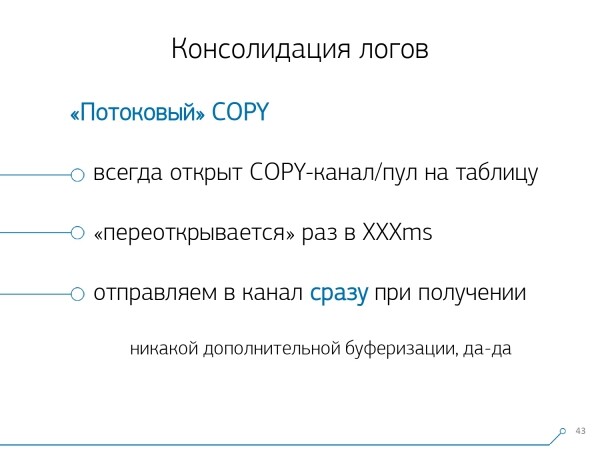
Det vil sige, at samleren altid har en stream, hvor jeg kan skrive de data, jeg har brug for. Men for at databasen kan se disse data, og at ingen hænger i blokeringer og venter på, at dataene bliver skrevet, skal COPY afbrydes med visse intervaller. For os har den mest effektive periode været omkring 100 ms — vi lukker og åbner straks igen for den samme tabel. Hvis vi ikke har nok streams ved nogle spidser, så laver vi polling op til et bestemt niveau.
Derudover har vi fundet ud af, at for denne type belastningsprofil er enhver aggregering, når poster samles i pakker — en skadelig praksis. Den klassiske skade er INSERT ... VALUES og derefter 1000 poster. Fordi på dette tidspunkt oplever du et peak i skrivningen til mediet, og alle andre, der forsøger at skrive noget til disken, vil vente.
For at slippe af med sådanne anomalier, bør du simpelthen ikke aggregere noget, ikke buffer overhovedet. Og hvis der trods alt opstår buffering på disken (heldigvis gør Stream API i Node.js det muligt at finde ud af) — så skub forbindelsen til side. Når du modtager en hændelse om, at den igen er ledig — skriv til den fra den opsamlede kø. Indtil da — tag den næste, ledige fra puljen og skriv til den.
Før vi implementerede denne tilgang til at skrive data, havde vi omkring 4K skriveoperationer, og ved hjælp af denne metode reducerede vi belastningen med en faktor 4. Nu er det steget yderligere 6 gange på grund af de nye observerbare databaser — op til 100 MB/s. Og nu opbevarer vi logfiler for de sidste 3 måneder i et omfang på cirka 10-15 TB, i håbet om at enhver udvikler kan løse ethvert problem inden for tre måneder.
Vi forstår problemerne.
Men det er bare at samle alle disse data - godt, nyttigt, relevant, men utilstrækkeligt - de skal forstås. For det handler om millioner af forskellige planer pr. dag.
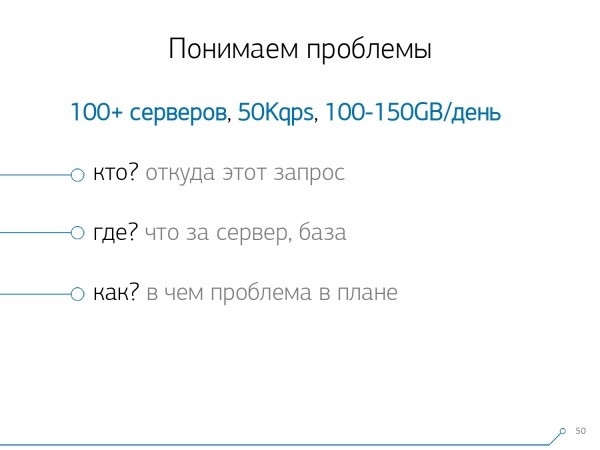
Men millioner er uoverskueligt, vi skal først gøre det "mindre". Og først og fremmest skal vi beslutte, hvordan dette "mindre" skal organiseres.
Vi har fremhævet tre nøglepunkter:
- hvem denne forespørgsel blev sendt af
Det vil sige, fra hvilken applikation den "kom": webinterface, backend, betalingssystem eller noget andet. - hvor det skete
På hvilken specifik server. For ifølge, hvis du har flere servere under én applikation, og pludselig én "fryser" (fordi "disken er gået i stykker", "hukommelsen er lækket", en anden form for skade), så er det nødvendigt at præcist henvise til serveren. - hvordan problemet viste sig i den eller den specifikke plan
For at forstå "hvem" der sendte os forespørgslen, bruger vi et standardværktøj - opsætning af en sessionsvariabel: SET application_name = '{bl-host}:{bl-method}'; — vi registrerer navnet på værten for forretningslogik, som forespørgslen kommer fra, og navnet på metoden eller applikationen, der initierede det.
Efter vi har videregivet "ejeren" af forespørgslen, skal den logges - derfor konfigurerer vi variablen log_line_prefix = ' %m [%p:%v] [%d] %r %a'. For dem, der er interesserede, kan , hvad det hele betyder. Det viser sig, at vi i loggen ser:
- tidsstempel
- proces- og transaktions-id'er
- databasens navn
- IP-adressen på den, der sendte denne forespørgsel
- og navnet på metoden
Dernæst indså vi, at det ikke er særlig interessant at se korrelationen for én forespørgsel mellem forskellige servere. Det sker sjældent, at ét program fejler på begge steder. Men selv hvis det er ens - se på en af disse servere.
Så, det snit "én server - én dag" var tilstrækkeligt til enhver analyse.
Det første analytiske snit - det såkaldte "skabelon" — en forkortet repræsentation af planen, renset for alle numeriske indikatorer. Det andet snit - applikationen eller metoden, og det tredje - den specifikke node i planen, der forårsagede os problemer.
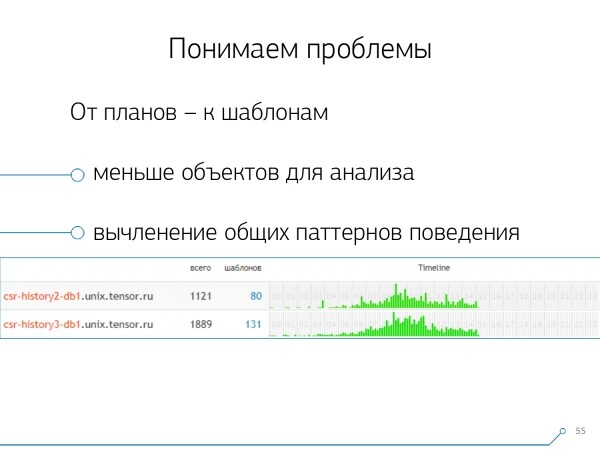
Da vi gik fra konkrete instanser til skabeloner, fik vi straks to fordele:
- en betydelig reduktion i antallet af objekter til analyse
Man behøver ikke at analysere problemet ud fra tusindvis af forespørgsler eller planer, men kun ud fra dusinvis af skabeloner. - tidslinje
Det vil sige, at ved at opsummere "fakta" inden for en given dimension kan man vise deres tilstedeværelse i løbet af dagen. Her kan du forstå, at hvis du har et mønster, der fx sker hver time, men burde ske dagligt, er det værd at overveje, hvad der er gået galt – hvem og hvorfor har det været udløst, måske skal det slet ikke være her. Dette er endnu en ikke-numerisk, rent visuel måde at analysere på.
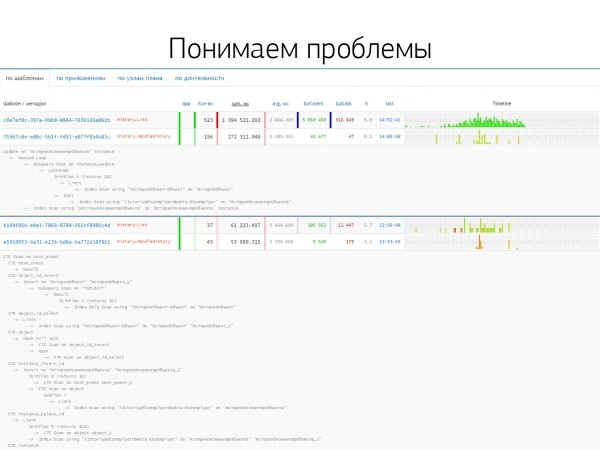
De andre metoder er baseret på de indikatorer, vi trækker fra planen: hvor mange gange har dette mønster fundet sted, den samlede og gennemsnitlige tid, hvor mange data, der er læst fra disken, og hvor mange fra hukommelsen…
Fordi du fx kommer til analyse-siden for hosten og ser – der bliver læst for meget fra disken. Disken på serveren klarer det ikke – men hvem læser fra den?
Og du kan sortere efter hvilken som helst kolonne og bestemme, hvad du vil tackle lige nu – er det belastningen på CPU'en eller disken, eller det samlede antal forespørgsler… Sorteret, set på de "top-scoring", repareret – ny version af applikationen er udgivet.
Og straks kan du se forskellige applikationer, der bruger det samme mønster fra forespørgselstypen SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, behandling… Og du begynder at overveje, hvorfor behandlingen læser brugeren, hvis der ikke er nogen interaktion.
Den omvendte metode er at se, hvad applikationen gør. For eksempel, frontend – det, det, dette, og nemlig dette en gang i timen (som lige præcis en tidslinje hjælper med). Og der opstår straks spørgsmålet – det virker ikke som frontend's opgave at gøre noget en gang i timen…
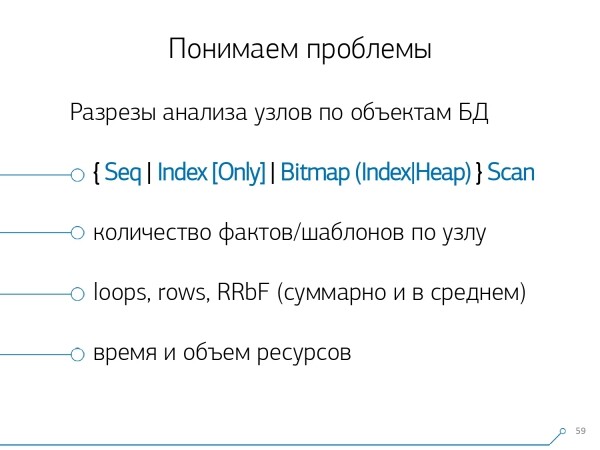
Efter noget tid indså vi, at vi manglede aggregeret statistik i forhold til planens noder. Vi udtrækkede kun de noder fra planerne, der faktisk arbejder med dataene fra tabellerne (læser/skriver dem efter indeks eller ej). I virkeligheden tilføjes kun én aspekt til det forrige billede — hvor mange poster denne node bragte til os, og hvor mange den kasserede (Rows Removed by Filter).
Du har ikke det rigtige indeks på tabellen, du laver en forespørgsel til det, den flyver forbi indekset, falder i Seq Scan… alle poster, bortset fra én, er blevet filtreret. Og hvorfor have 100M filtrerede poster på en dag, er det ikke bedre at anvende et indeks?
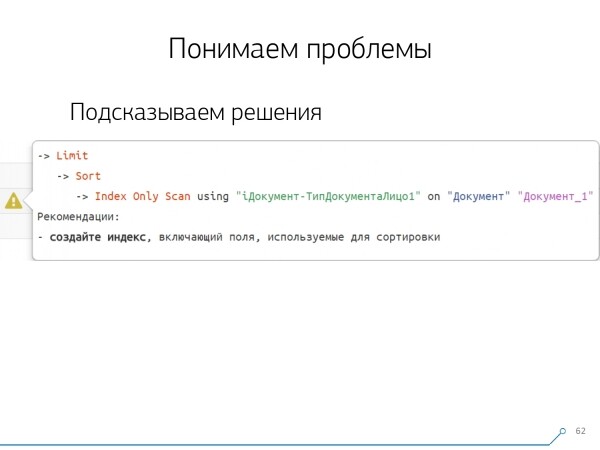
Efter at have gennemgået alle planerne for noderne, indså vi, at der er nogle typiske strukturer i planerne, der med stor sandsynlighed ser mistænkelige ud. Det ville ikke være en dårlig idé at hæve et flag til udvikleren: "Ven, her skal du først læse efter indeks, derefter sortere, og så skære", for der er typisk kun én post der.
Alle, der har skrevet forespørgsler med denne slags mønster, har helt sikkert oplevet: "Giv mig den seneste ordre for Vasa, hans dato". Og hvis du ikke har et indeks på datoen, eller hvis den anvendte indeks ikke indeholder datoen, vil du netop træde på sådanne "skovle".
Men vi ved jo, at dette er "skovle" - så hvorfor ikke straks give udvikleren et hint om, hvad han bør gøre. Derfor ser vores udvikler, når han åbner planen, straks et smukt billede med tips, hvor det straks siges: "Du har problemer her og her, og de løses sådan og sådan."
Som et resultat er det volumen af den erfaring, som var nødvendig for at løse problemerne i starten og nu, faldet drastisk. Sådan et værktøj har vi fået.
Kilde: habr.com
