

Når vi ser på de moderne Huawei Enterprise-løsninger, der blev præsenteret i 2020, går vi videre til mere specifikke og detaljerede fortællinger om enkelte idéer og produkter, som kan danne grundlaget for digital transformation af både store virksomheder og offentlige institutioner. I dag handler det om de koncepter og teknologier, som Huawei tilbyder til opbygning af datacentre.
I en æra af den 'forbundne verden' kræver opbevaring og behandling af data nye tilgange på alle trin i livscyklussen for datacentre. De skal samtidig blive både enklere og 'klogere' for at kunne håndtere den centrale rolle, de spiller i den globale digitale økonomis infrastruktur.
I 2018 opbevarede menneskeheden 33 zettabyte information, men allerede i 2025 forventes den samlede mængde at vokse mere end fem gange. Tre årtiers erfaring med udvikling af IKT-infrastruktur har gjort det muligt for Huawei at forberede sig godt på den voksende 'databølge' og tilbyde sine partnere og kunder et koncept for et intelligent datacenter, der dækker alle faser af dets byggeri, drift og vedligeholdelse. Elementerne i dette koncept er samlet under navnet HiDC.
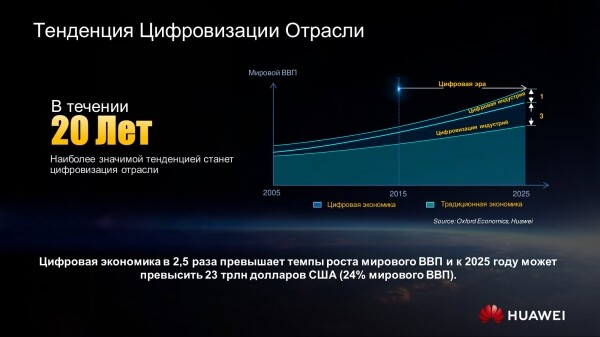
Digitaliser dette
Der går et nyt vittighed på nettet: Hvem har mest fremskyndet digital transformation i din virksomhed - CEO, CTO, bestyrelsen? Coronapandemien! Kun de dovne holder ikke webinarer, skriver artikler eller fortæller, hvordan og hvad man skal gøre. Men alt dette er reaktive handlinger. Nogle havde forberedt sig på forhånd.
Ikke for at prale - men af objektive årsager vil vi tage vores virksomhed som eksempel, hvor digital transformation blev skubbet i gang i stor skala for flere år siden. I øjeblikket kan vi praktisk talt overføre alle medarbejdere til arbejde hjemmefra uden tab af effektivitet. Historien om hospitalet, der blev bygget i Wuhan på ti dage, er sigende. Her blev digital transformation vist ved, at alle IT-systemer blev implementeret på tre dage. Så digital transformation handler ikke om 'hvornår' og 'hvorfor', men om 'hvordan'.
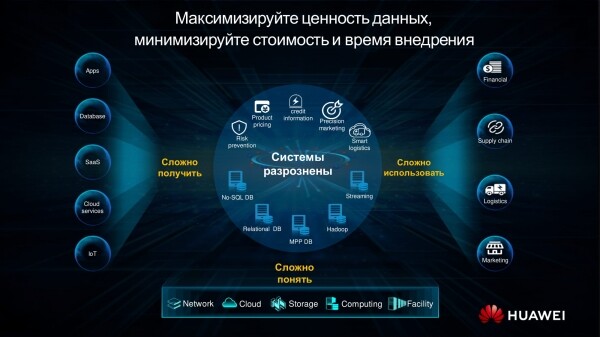
Arkitektonisk tilgang i stedet for kaotisk udvikling
Hvilke grundlæggende problemer står vi overfor, når vi begynder at opbygge et system? Indtil nu arbejder alle vores kunder i en tilstand af at kombinere forretningsopgaver med anvendelsesservices og IT-løsninger. Det er ret svært at få et samlet overblik over, hvordan et sådant kompleks fungerer, hvis det er blevet skabt blot ved at tilføje forskellige blokke. For at opbygge et system som en enhed er det først og fremmest nødvendigt med en arkitektonisk tilgang. Denne tilgang har vi indarbejdet i ideologien for vores løsning HiDC.
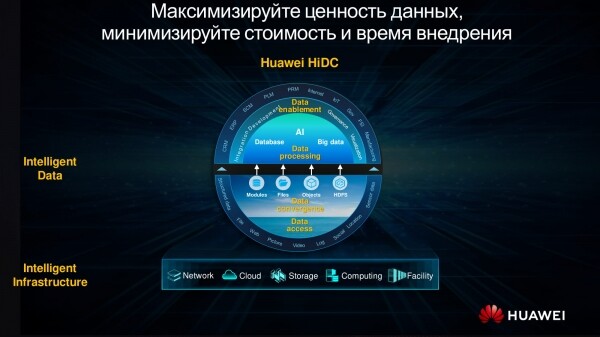
Maksimal værdi og minimal omkostning
Hele strukturen i HiDC består af to hovedskiver. Den første repræsenterer det, du er vant til at se hos Huawei – klassisk infrastruktur. Elementerne i den anden skive er nemmest at samle under termen "intelligent data".
Hvorfor er det nødvendigt? I dag opsamler mange virksomheder enorme mængder information, ofte spredt eller tilgængelig gennem forskellige "mellemmænd". Tænk bare på almindelige databaser. Spørg dine databaseadministratorer, hvor godt disse databaser er integreret med hinanden, og hvordan oplysninger fra dem kan anvendes i BI-systemer til at træffe forretningsbeslutninger. Det er bemærkelsesværdigt, at databaser ofte er meget svagt forbundet med hinanden og fungerer som separate "øer". Derfor har vi i første omgang overvejet, hvilke arkitektoniske tilgange der kunne løse dette problem.
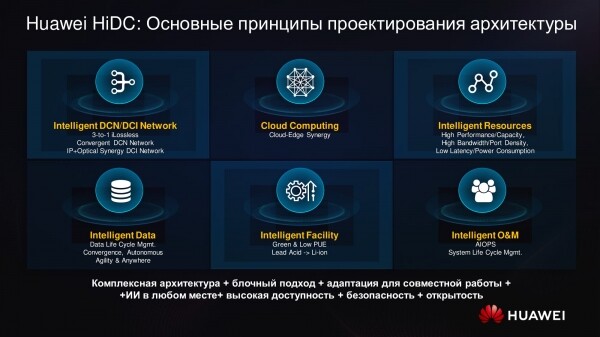
Principper for design af HiDC-arkitekturen
Lad os se på de grundlæggende designprincipper for HiDC. Dette vil først og fremmest være nyttigt for dem, der ikke er specialister inden for et bestemt område, men for løsningens arkitekter, der kan få et overblik over hele panoramaet.
De mest almindelige er blokken af konvergerende netværk og datastyringsblokken. Her opstår allerede begrebet, som løsningens arkitekter sjældent tænker på – håndtering af dataens livscyklus. Det er blevet overført fra klassiske databaser til mange andre systemer, herunder cloud- og edge-beregninger.
Antallet af grænseberegninger stiger. Det mest illustrative eksempel på deres anvendelse er en bil med autopilot, som helst skal styres fra en samlet platform. Derudover er der en klar trend mod 'grønne' teknologier - mere energieffektive, som forårsager minimal skade på miljøet. Begge dele kan opnås ved at skifte til intelligente ressourcer (mere om dette senere).
Det er fantastisk, når vi har alle seks blokke i HiDC-strukturen til rådighed. Desværre arbejder kunderne ofte i et tidligere oprettet miljø. Men brugen af selv én blokk fra skemaet ovenfor kan bære frugt. Hvis man tilføjer den anden, tredje osv., vil synergieffekten begynde at vise sig. Bare kombinationen af netværk og distribueret datalagring vil give højere ydeevne og lavere latens. Den modulære tilgang giver os mulighed for at udvikle os ikke kaotisk, som ofte sker i industrien, men bruge en holistisk arkitektonisk tilgang. Åbenheden af selve blokken giver frihed til at vælge den mest optimale løsning.
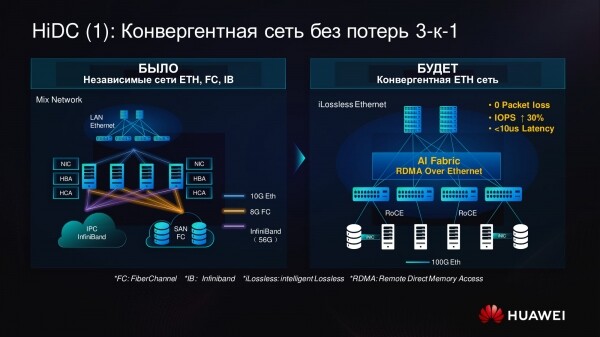
Tiden for konvergerende netværk
På det globale og det russiske marked promoverer vi i stigende grad konceptet med konvergerende netværk. Allerede i dag bruger vores kunder konvergerende løsninger baseret på RoCEv2 (RDMA over Converged Ethernet v2) til at opbygge distribuerede softwaredefinerede lagersystemer. Den største fordel ved denne tilgang er dens åbenhed og fraværet af behovet for at skabe et ubestemt antal adskilte netværk.
Hvorfor blev det ikke gjort før? Husk, at Ethernet-standarden blev udviklet i 1969. Gennem et halvt århundrede har der været opbygget mange problemer, men hos Huawei har vi lært at løse dem. Nu, takket være en række yderligere foranstaltninger, kan vi bruge Ethernet til kritiske applikationer, højt belastede løsninger osv.
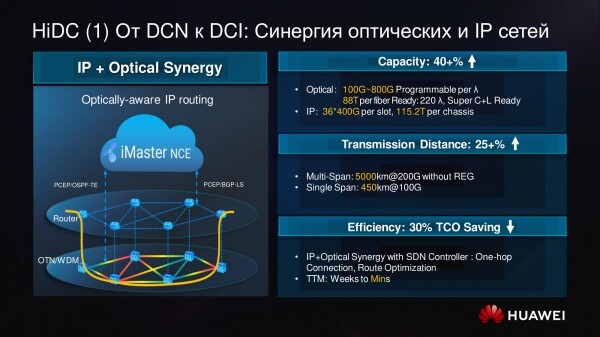
Fra DCN til DCI
Den næste vigtige trend er den synergi, der opstår ved implementeringen af DCI (Data Center Interconnect). I Rusland, i modsætning til Kina, findes der endnu ikke noget tilsvarende hos telekommunikationsoperatører. Når kunderne overvejer netværksløsninger til datacentre, lægger de normalt ikke tilstrækkelig vægt på dyb integration af optiske netværk og klassiske IP-løsninger inden for samme tilstedeværelsespunkt. De bruger de velkendte løsninger, der fungerer på IP-laget, hvilket er tilstrækkeligt for dem.
Hvad er så formålet med DCI? Forestil dig, at administratoren af DWDM-noden og netværksadministratoren handler uafhængigt. På et tidspunkt kan et problem hos en af dem seriøst sænke din fejltolerance. Men hvis vi anvender synergiprincippet, udføres IP-routing med hensyn til, hvad der sker på det optiske netværk. Anvendelsen af en sådan intelligent service øger tydeligt antallet af nultal i systemets tilgængelighed.
En anden væsentlig fordel ved vores DCI er den store kapacitet. Ved at summere potentialet fra C- og L-båndene kan man opnå omkring 220 bølger. Denne kapacitet vil næppe hurtigt blive udtømt, selv af store virksomhedskunder, især når man tager højde for, at vores nuværende løsning tillader transmission af op til 400 Gbit/s pr. bølge. Senere vil det samme udstyr kunne nå op på 800 Gbit/s.
Yderligere bekvemmelighed opnås gennem den samlede styring, som vi tilbyder via klassiske åbne grænseflader. Gennem NETCONF styres ikke kun switchene, men også enhederne til optisk komprimering, hvilket gør det muligt at nå konvergens på alle niveauer og opfatte systemet som en intellektuel ressource, snarere end som et "sæt kasser".
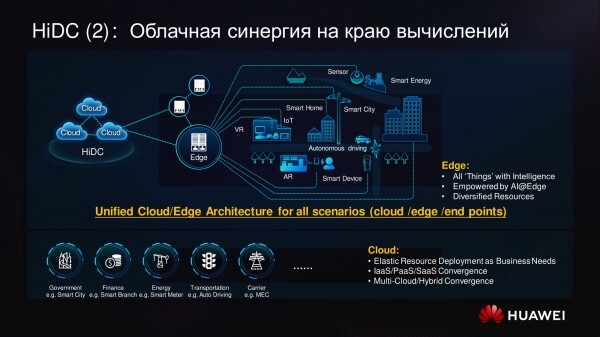
Edge computing bliver stadig vigtigere
Mange har hørt om Edge Computing. Og dem, der arbejder med cloud- og klassiske datacentre, skal være opmærksomme på, at vi for nylig har set et alvorligt skift mod edge computing.
Hvad er årsagen til dette? Lad os se på de generelle implementeringsmønstre. Der er i øjeblikket meget snak om "smarte byer", "smarte hjem" osv. Dette koncept giver bygherren mulighed for at skabe merværdi og øge prisen på ejendommen. Et "smart hjem" genkender sin beboer, lukker dem ind og ud, samt tilbyder forskellige tjenester. Ifølge statistikker tilføjer sådanne tjenester cirka 10-15% til prisen på lejligheder og kan generelt fremme udviklingen af nye forretningsmodeller. Det er også tidligere blevet nævnt, at der arbejdes med konceptet af selvkørende biler. Snart vil udviklingen af 5G- og Wi-Fi 6-teknologier muliggøre ekstremt lav forsinkelse ved dataoverførsel mellem de "smarte" hjem, biler og hoveddatacentre. Det betyder, at det vil være muligt at udføre mange flere operationer relateret til seriøs dataindsamling. For sådanne opgaver kan man især bruge neurale processorer, som allerede er blevet leveret til Rusland.
Udsigten til den netop beskrevne trend er uden tvivl lovende. Forestil dig for eksempel et intelligent system til styring af bytransport, der kan skifte trafiklys, regulere trafikbelastningen på bestemte gader eller endda træffe passende foranstaltninger under nødsituationer.
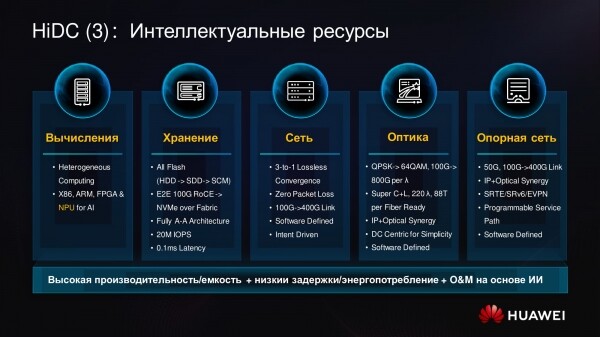
Lad os nu se på de ressourcer, vi anvender til at realisere HiDC-konceptet.
Beregninger
Når vi skal implementere et standard computing system, er det selvfølgelig processorer med x86-arkitektur, der anvendes. Men så snart behovet for tilpasning opstår, er det tid til at overveje mere varierede løsninger.
For eksempel er ARM-processorer på grund af det store antal kerner særdeles velegnede til applikationer med høj grad af parallelisme. Multitrådet behandling giver en præstationsgevinst på omkring 30%.
Hvis vi har kritisk behov for lav forsinkelse, ryger programmerbare logiske kredsløb (FPGA) i forgrunden.
Neurale processorer er først og fremmest nødvendige, når man arbejder med maskinlæring. Hvis vi har brug for 16 racks med 8 servere i hver, fyldt med neurale processorer, ville en tilsvarende løsning baseret på x86-arkitektur kræve (!) cirka 128 racks. Som du kan se, tvinger det store udvalg af beregningstyper os til nøje at vælge hardwareplatforme.
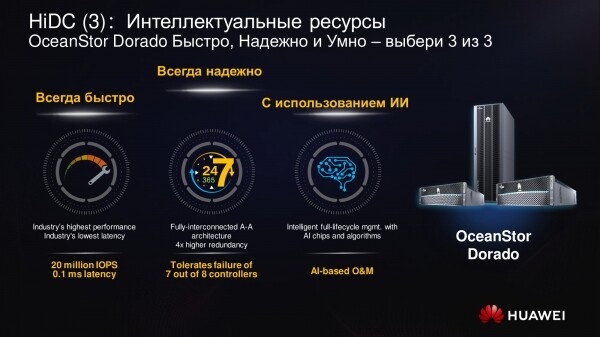
Dataopbevaring
I andet år påfører Huawei partnere, kunder og branchekolleger at opdage datalagringssystemer i henhold til principperne for Flash Only. Og de fleste af vores kunder bruger mekaniske spindle-disk drev kun i gamle løsninger eller til sjældent anvendte arkivdata.
Flash-systemer udvikler sig også. På markedet dukker der systemer af typen Storage Class Memory (SCM) op, såsom Intel Optane. Interesante udviklinger vises af kinesiske og japanske producenter. På nuværende tidspunkt overgår SCM i behandlingsklasse alle andre løsninger. Indtil videre tillader den høje pris dem ikke at blive brugt bredt.
Samtidig ser vi, at kvaliteten af lagersystemer skal forbedres, ikke kun i den betingede backend, men også i frontend. I de fleste nye implementeringer tilbyder og bruger vi i øjeblikket mekanismer til direkte adgang til hukommelsen via Ethernet, men vi ser efterspørgsel fra kunderne, og derfor vil vi begynde oftere at bruge NVMe over Fabrics tættere på årets slutning. Desuden end-to-end, for at sikre en samlet arkitektur, som selvfølgelig skal være højtydende og robust over for controllerfejl.
Datallagringssystemet OceanStor Dorado er et af vores flagskibsprodukter. Interne tests har vist, at det leverer ydeevne på niveauet 20 millioner IOPS, mens det stadig fungerer, selv når syv ud af otte controllere bryder ned.
Hvorfor en sådan kraft? Lad os se på en aktuel situation. I flere måneder har indbyggerne i Kina tilbragt betydeligt mere tid hjemme på grund af isolationsreglerne. Internettrafikken er i denne periode steget med gennemsnitligt 30%, og i nogle provinser er den endda fordoblet. Forbruget af forskellige netværkstjenester er steget. Og på et tidspunkt har de samme banker begyndt at opleve en alvorlig ekstra belastning, som deres lagersystemer ikke var forberedt på.
Det er klart, at 20 millioner IOPS ikke er nødvendige for alle lige nu. Men hvad med i morgen? Vores intelligente systemer udnytter neurale processorer maksimalt for at sikre kompakt trafik, deduplikation, optimering og hurtig datagendannelse.
Støttende netværk
Året 2020, som vi nævnte i det tidligere materiale, vil blive året for vores grundlæggende netværk. Mange kunder, især applikationsserviceudbydere (ASP) og banker, overvejer allerede, hvordan deres applikationer vil fungere i forhold til forbindelsen til datacentre og mellem datacentre. Her kommer det nye grundlæggende netværk os til hjælp. Som eksempel kan vi nævne de største kinesiske banker, som er gået over til forenklede grundlæggende systemer, der til forbindelse mellem datacentre ikke bruger ti forskellige protokoller, men, i princippet, et par - OSPF og SRv6. Samtidig får organisationen det samme sæt tjenester.
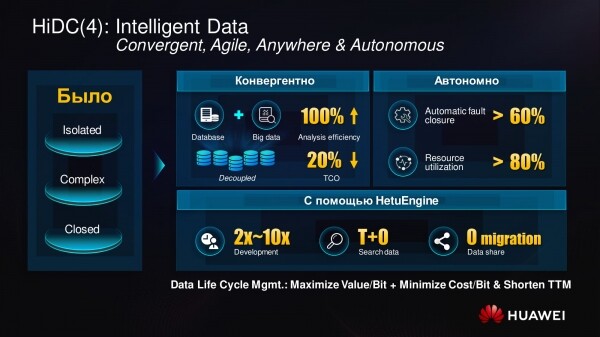
Intelligente ressourcer
Hvordan bruger man data? Indtil for nylig var der et fragmenteret system med forskellige databaser: Microsoft SQL, MySQL, Oracle osv. Der blev brugt løsninger fra big data-området, der kunne samle disse data, hente dem og arbejde med dem. Alt dette skabte en høj belastning på ressourcerne.
Derudover manglede der en mekanisme til udførelse af operationer med data ved opståen af en bestemt hændelse. Løsningen blev udviklingen af principper for datalivscyklusstyring (DLM).
Alle har hørt om data lakes. Med overgangen fra datastyring til datastyring er de "digitale søer" blevet hurtigere "intelligent". Herunder takket være Huawei-løsninger. I de næste materialer vil vi helt sikkert fortælle om hele stakken af de softwareteknologier, vi har anvendt. Det er nu vigtigt at bemærke, at det netop er anvendelsen af "intelligent" datalivscyklusstyring, der har gjort det muligt for os at forenkle brugen af vores netværk og servere samt lære at bygge sammenhængende arkitekturer for bedre at forstå principperne for arbejdet med data.
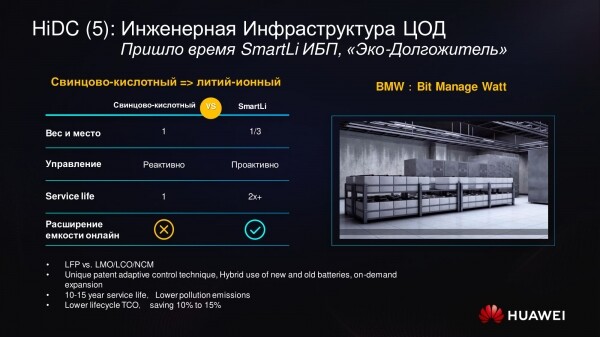
Ingeniørinfrastruktur til datacenteret
Vi vil offentliggøre separate materialer dedikeret til ingeniørinfrastrukturen, men i konteksten af dagens emne vil vi gerne nævne de ændringer, der vedrører HiDC-konceptet.
I lang tid var brugen af lithiumbatterier i nød- og backup-systemer (UPS) i datacentre forbudt på grund af deres høje brandfare. Enhver mekanisk skade eller brud på batteriets integritet kunne føre til, at det brændte op, hvilket kunne få uforudsigelige konsekvenser. Som følge heraf blev UPS udstyret med moralsk forældede syrebatterier, som havde en lav energitæthed i forhold til deres vægt.
I de nye nød- og backup-systemer fra Huawei anvendes sikre lithium-jern-phosphatbatterier (LFP) med intelligent proaktiv styring. Med samme kapacitet optager de tre gange mindre plads sammenlignet med syrebatterier. Deres livscyklus er 10–15 år, hvilket også mindsker deres belastning på miljøet. Det patenterede styringssystem i SmartLi-økosystemet tillader brugen af hybrid systemer bestående af både gamle og nye batteriarrangementer, og skiftesystemet muliggør 'hot' ændringer i UPS-strukturen, mens reservestyringsfunktionen fortsættes.
Intelligent drift
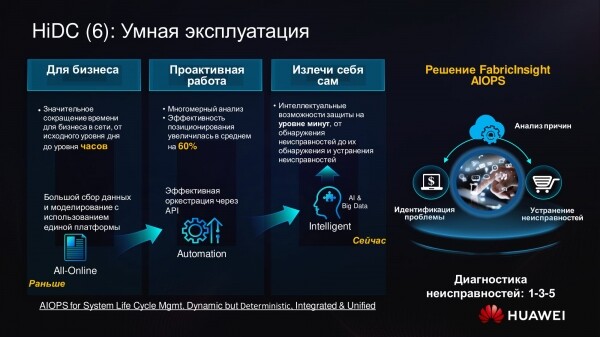
En vigtig del af driftsprincipperne for HiDC-infrastruktur er ideologien om smart selvhelbredelse. I en af vores tidligere publikationer nævnte vi den intelligente O&M 1-3-5-platform, som ikke kun kan opdage og analysere uønskede hændelser i systemet, men også foreslå flere muligheder for fuldt automatiserede løsninger på problemet til administratoren.
Selvanalysen gør det muligt at opdage fejl på cirka et minut. Der går tre minutter med analysen, og inden for fem minutter præsenteres forslag til ændring af systemets tilstand.
Antag, at en fejl fra operatøren førte til dannelsen af en lukket løkke af processer, der reducerede virtualiseringsfarmens ydeevne fra 100 til 77%. Data Center-administratoren modtager et relevant meddelelse på sit dashboard, som indeholder en fuld visualisering af problemet, inklusive netværksdiagrammet for de ressourcer, der er berørt af den uønskede proces. Derefter kan administratoren vælge at rette op på situationen manuelt eller benytte sig af en af de flere automatiserede genopretningsscenarier, der er foreslået ham.

Systemet kender omkring 75 scenarier, der kan implementeres på mindre end ti minutter. Desuden dækker de 90 % af de problemer, der opstår i datacentre. I mellemtiden kan teknikeren roligt besvare opkald fra bekymrede kunder og være sikker på, at servicen vil blive gendannet i løbet af få minutter.
Nye nøgleprodukter i HiDC
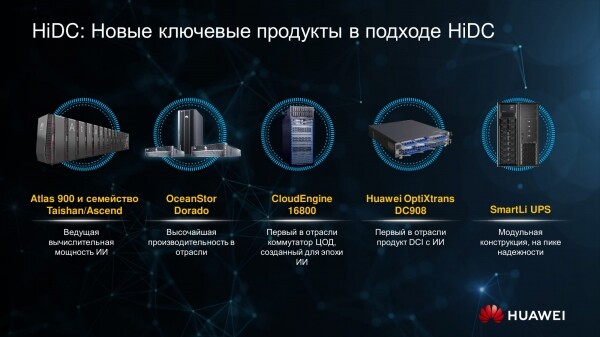
Udover softwareprodukter bør nøgleløsninger, der fungerer på infrastruktur niveau, også nævnes. Først og fremmest skal vi nævne neurale processorer, der anvendes i vores AI-klynger af Atlas-familien, samt servere baseret på NPU og GPU.
Desuden må vi ikke glemme Dorado og dens rekordstore ydeevne i sin klasse, som vil være tilstrækkelig i mange år fremover. Dette er især relevant i det post-sovjetiske rum, hvor det sjældent er normen at opdatere noget, medmindre det helt stopper med at fungere. Dette forklarer levetiden for visse lagringssystemer, der når op på ti år. Dorado kræver enorm ydeevne for at opretholde en høj kvalitet af de ydelser, der tilbydes, selv efter ti år.
Innovation i hvert element
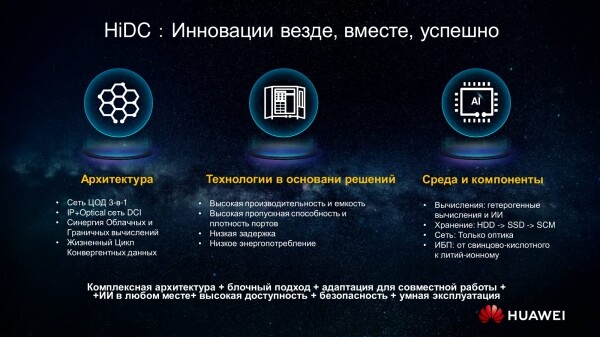
Når man vælger specifikke infrastrukturløsninger, er det vigtigt ikke at glemme arkitekturen og scenarierne for dens fremtidige udvikling. Adskilte produkter fra forskellige producenter garanterer ikke den forventede synergistiske effekt, som løsninger allerede optimeret til fælles brug kan give.
Den rigtige teknologi skal ligge til grund for infrastrukturen. "Rigtige" omfatter blandt andet åbne, der sikrer høj båndbredde og fungerer stabilt under høje belastninger. I relation til datacentre er det for eksempel vigtigt at have et godt forhold mellem det totale energiforbrug og IT-belastningen. For at nå de nævnte mål skal miljøet og komponenterne vælges korrekt. Under moderne forhold betyder det desuden en stadig større anvendelse af kunstig intelligens.
Ifølge vores observationer er der blandt strategiske kunder hos Huawei stadig færre, der ikke bruger maskinlæringssystemer. Uden ML vil det simpelthen ikke være muligt at maksimere monetariseringen af de indsamlede data.
Monetarisering kan være forskellig: for banker - tilbud om nye målrettede produkter, for telekommunikationsoperatører - levering af individuelle tjenester og sikring af loyalitet, for offentlige kunder - kvalitetsstyring af datalivscyklus og et højt niveau af interaktion med andre organisationer. For det er datastyringsmodeller længe ikke kun begrænset til opsætning af firewall og sikring af netværksynlighed for deres databaser.
Fra idé til operativ datacenter
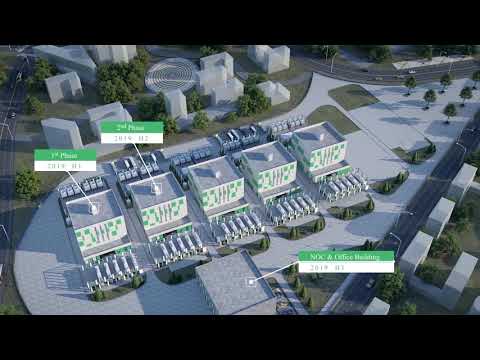
Opførelsen af et standard datacenter tager i bedste fald fra et år til halvandet. Vores produktionscyklus gør det muligt at gøre dette meget hurtigere ved hjælp af en gruppe løsninger samlet under det fælles navn FusionDC 2.0. Design, udvikling af høj-niveau design og samling af alle IT-lastelementer udføres direkte på fabrikken. På kort tid transporteres udstyret med skibskontainere fra Kina til Rusland. Som resultat kan et datacenter "nøglefærdigt" skabes bogstaveligt talt på fire til fem måneder.
Idéen om et præfabrikeret cloud datacenter er også interessant, fordi datacenteret kan udvikles trinvis ved at tilføje de nødvendige funktionelle blokke. Denne tilgang er indbygget i selve konceptet HiDC.
For ikke at omdanne det overordnede materiale til et datasheet, tilbyder vi at sende flere oplysninger om HiDC . Her finder du beskrivelser og eksempler på implementering af de tilgange, produkter og løsninger, vi har nævnt. Jo højere dit adgangsniveau til hjemmesiden er, jo flere materialer vil der være. Hvis du har status som "partner", kan du downloade HiDC-køreplaner, tekniske præsentationer og videoer.
Lad os antage, at de fleste læsere af denne artikel har kompetencer som netværksarkitekter. De vil uden tvivl finde det interessant at besøge vores . Her forklarer vi detaljeret, hvordan man bygger netværksinfrastruktur i henhold til Huawei Validated Design (HVD) reglerne. De tilgængelige guideline til download vil hjælpe med at forstå, hvordan virksomhedens løsninger fungerer. Husk blot, at du vil have adgang til færre materialer uden autorisation.
***
Du kan orientere dig ved hjælp af de mange webinars, der afholdes ikke kun på det russisktalende marked, men også internationalt. Her deler vi både information om vores produkter og vores forretningspraksis. Vi fortæller blandt andet, hvordan Huawei fortsætter med at levere sine produkter til forskellige lande trods opsplitningen af mange servicekæder. For nylig var der for eksempel et tilfælde, hvor nyt produceret udstyr til datacentre nåede en kunde i Moskva på blot tre uger.
Listen over webinars for april er tilgængelig .
Kilde: habr.com
