

Jeg vil gerne præsentere transskriptionen af Georgiy Rylovs rapport fra begyndelsen af 2020, "WAL-G: nye muligheder og fællesskabsudvidelse".
Open-source vedligeholdere står over for mange problemer, når deres projekter vokser. Hvordan kan vi skrive flere krævede funktioner, reparere flere issues og samtidig holde styr på flere pull requests? Ved hjælp af eksemplet WAL-G (backup-tool til PostgreSQL) vil jeg fortælle om, hvordan vi løste disse problemer ved at starte et kursus i Open-source udvikling på universitetet, hvad vi har opnået og hvor vi vil bevæge os hen fremover.
Hej alle sammen! Jeg er udvikler hos Yandex fra Jekaterinburg. I dag vil jeg fortælle om WAL-G.
I titlen på rapporten stod der ikke noget om, at det handlede om backups. Er der nogen, der ikke ved, hvad WAL-G er? Eller ved alle det? Ræk hånden op, hvis du ikke ved det. Wow, du kom til et foredrag og ved ikke, hvad det handler om.
Lad mig fortælle, hvad vi skal gøre i dag. Det har vist sig, at vores team har arbejdet med backups i lang tid. Og dette er endnu et foredrag i en serie, hvor vi forklarer, hvordan vi opbevarer data sikkert, pålideligt, bekvemt og effektivt.
I de tidligere serier har der været mange foredrag fra Andrei Borodin og Vladimir Leskov. Vi har været mange. Og vi har alle talt om WAL-G i mange år.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Dette foredrag vil adskille sig en smule fra de andre, idet det tidligere har været mere teknisk fokuseret, mens jeg her vil tale om, hvordan vi har håndteret problemer relateret til væksten af fællesskabet. Og hvordan vi kom på en lille idé, der hjælper os med at håndtere det.
For flere år siden var WAL-G et ret lille projekt, som vi fik fra Citus Data. Vi tog det over. Og det blev udviklet af én person.
Og kun i WAL-G manglede:
- Backup fra replika.
- Der var ikke inkrementelle backups.
- Der var ingen WAL-Delta backups.
- Og der manglede en masse andet.
I løbet af de sidste par år er WAL-G vokset betydeligt.
Og ved udgangen af 2020 var alt det ovenstående det allerede blevet. Oven i det har vi nu:
- Over 1.000 stjerner på GitHub.
- 150 forks.
- Omkring 15 åbne PR.
- Og mange bidragydere.
- Og konstant åbne issues. Og det er på trods af, at vi bogstaveligt talt logger ind hver dag for at arbejde med det.
Og vi er kommet frem til, at dette projekt kræver mere vores opmærksomhed, selv når vi ikke skal implementere noget for vores Managed Databases service i Yandex.
Og et sted i efteråret 2018 fik vi en idé. Normalt har et team flere måder at udvikle funktioner og rette fejl på, hvis man ikke har nok hænder. For eksempel kan man ansætte endnu en udvikler og betale vedkommende. Eller man kan tage en praktikant i en periode og også betale dem en løn. Men der er også en ret stor gruppe mennesker, hvoraf nogle faktisk kan skrive kode. Man ved bare ikke altid, hvilken kvalitet denne kode har.
Vi tænkte over det og besluttede at forsøge at inddrage studerende. Men de studerende vil ikke deltage i alt. De vil kun lave en del af arbejdet. De vil for eksempel skrive tests, rette fejl, implementere funktioner, der ikke berører kernefunktionaliteten. Den primære funktionalitet – er at oprette backups og genskabe backups. Hvis der opstår en fejl i oprettelsen af en backup, vil vi miste data. Og det vil ingen selvfølgelig have. Alle ønsker, at det hele er meget pålideligt. Derfor vil vi selvfølgelig ikke lade kode, som vi har mindre tillid til end vores eget, slippe igennem. Altså, enhver ikke-kritisk kode – det er noget, vi gerne vil have fra vores ekstra hænder.
Under hvilke betingelser accepteres en PR fra en studerende
- De er forpligtet til at dække deres kode med tests. Alt skal gå igennem CI.
- Og vi har også 2 reviews. Én fra Andrey Borodin og én fra mig.
- Og derudover, for at sikre, at det ikke ødelægger noget i vores service, uploader jeg separat en build med denne commit. Og vi kontrollerer i end-to-end tests, at der ikke falder noget ud.
Specialkursus i Open Source
Lidt om hvorfor dette er nødvendigt, og hvorfor jeg synes, det er en sej idé.
For os er fordelen åbenlys:
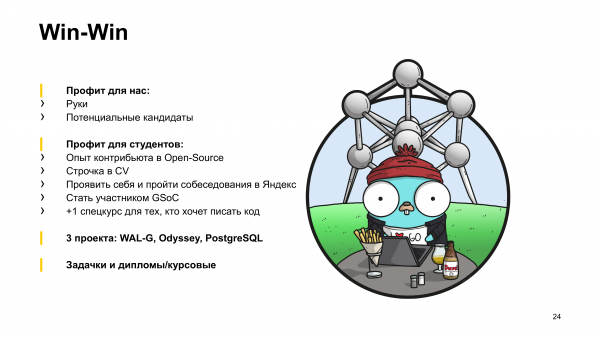
- Vi får ekstra hænder.
- Og vi leder efter kandidater til teamet blandt dygtige studerende, der skriver god kode.
Hvilken fordel er der for studerende?
De kan være mindre oplagte, fordi studerende i det mindste ikke får penge for den kode, de skriver, men kun får karakterer til deres eksamensbevis.
Jeg spurgte dem om dette. Og ifølge dem:
- Erfaring som contributor i Open Source.
- At få en linje på CV'et.
- At vise sig frem og komme til samtale i Yandex.
- At blive deltager i GSoC.
- +1 specialkursus for dem, der ønsker at skrive kode.
Jeg vil ikke fortælle om, hvordan kurset var struktureret. Jeg vil blot sige, at WAL-G var hovedprojektet. Vi inkluderede også projekter som Odyssey, PostgreSQL og ClickHouse i dette kursus.
Og der blev givet opgaver ikke kun på dette kursus, men også diplomer og projekter.
Og hvad med fordelene for brugerne?
Lad os nu gå videre til den del, der interesserer jer. Hvilken nytte har I af det? Nytte i den forstand, at studerende har rettet mange fejl og lavet feature-anmodninger, som I har bedt os om.
Lad mig fortælle om ting, som I længe har ønsket, og som nu er blevet implementeret.
Understøttelse af tablespaces. Tablespaces i WAL-G har været ventet siden WAL-G's udgivelse, fordi WAL-G er efterfølgeren til et andet backupværktøj, WAL-E, der understøttede databasebackups med tablespaces.
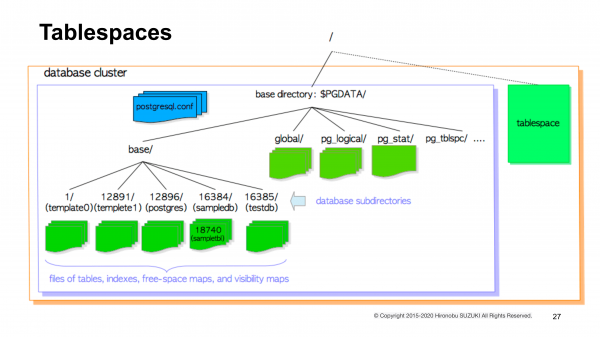
Lad mig kort minde om, hvad det er, og hvorfor det er nødvendigt. Som regel optager alle Postgres-data en enkelt mappe på filsystemet, kaldet basismappen. Denne mappe indeholder allerede alle de filer og undermapper, der er nødvendige for Postgres.
Tablespaces er mapper, hvor Postgres-data opbevares, men de ligger ikke uden for basismappen. På diapositivets billede kan man se, at tablespaces findes uden for basismappen.
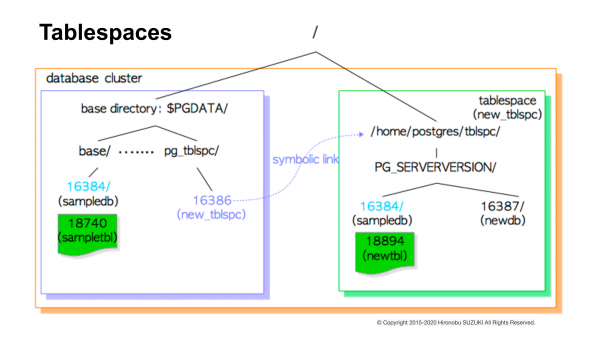
Hvordan ser det ud for selve Postgres? I basismappen findes der en særskilt undermappe pg_tblspc. Og i den ligger der symboliske links til de mapper, hvor Postgres-data faktisk opbevares uden for basismappen.
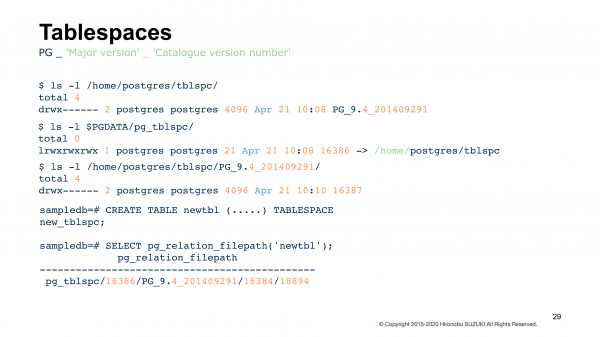
Når I bruger alt dette, kan disse kommandoer se sådan ud for jer. Det vil sige, at I opretter en tabel i en angiven tablespace og ser, hvor den nu er placeret. De sidste to linjer, de sidste kaldte kommandoer. Og her kan man se, at der er en eller anden sti. Men i virkeligheden er det ikke den rigtige sti. Det er en sti med præfiks fra basismappen til tablespace. Og derfra er det matchet med et symbolsk link, der fører til jeres reelle data.
Vi bruger ikke dette i vores team, men mange andre brugere af WAL-E, der har skrevet til os, har ønsket at skifte til WAL-G, men dette har hindret dem. Nu understøttes det.
En anden funktion, som vores specialkursus bragte, er catchup. Om catchup ved folk, der sandsynligvis har arbejdet mere med Oracle end med Postgres.
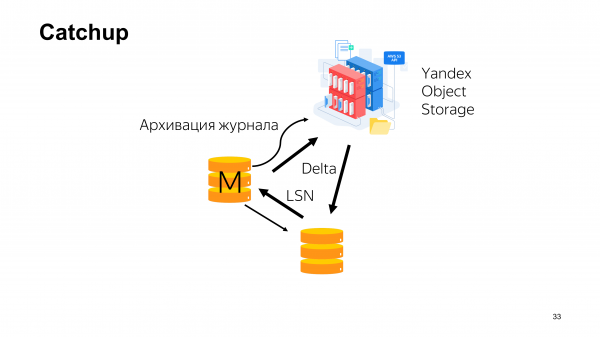
Kort fortalt, hvad det handler om. Sådan kan en typisk klynge-topologi se ud i vores tjeneste. Vi har en master. Der er en replika, der streamer fra den skrive-forhåndslog. Og replikaen fortæller masteren, hvilken LSN den aktuelt befinder sig på. Og samtidig kan loggen arkiveres. Ud over arkivering af loggen sendes der også backups til skyen. Og delta-backups sendes.
Hvad kan der være et problem? Når du har en ret stor database, kan det ske, at din replika begynder at hænge meget efter masteren. Og den hænger så meget efter, at den aldrig kan indhente den. Dette problem skal normalt løses på en eller anden måde.
Og den enkleste løsning er at fjerne replikationen og geninstallere den, fordi den aldrig vil indhente, og problemet skal løses. Men det er ret langvarigt, da det tager utrolig lang tid at gendanne en hel backup af en database på 10 TB. Og vi ønsker at gøre dette så hurtigt som muligt, hvis sådanne problemer opstår. Og det er netop derfor, catchup findes.
Catchup gør det muligt at bruge delta-backups, der opbevares i skyen på denne måde. Du angiver, hvilken LSN den hængende replika aktuelt befinder sig på, og angiver den i kommandoen catchup for at oprette en delta-backup mellem den LSN og den LSN, som din klynge aktuelt er på. Herefter gendannes denne backup på den replika, der hang efter.
Andre databaser
Desuden bragte vores studerende med det samme mange funktioner. Da vi hos Yandex ikke kun arbejder med Postgres, men også har MySQL, MongoDB, Redis, ClickHouse, blev vi på et tidspunkt nødt til at kunne lave backups med point-in-time recovery for MySQL og have muligheden for at uploade dem til skyen.
Og vi ønskede at gøre det på en måde, der ligner, hvad WAL-G gør. Så vi besluttede at eksperimentere og se, hvordan det hele ville se ud.
I begyndelsen skrev vi koden i et fork uden at adskille denne logik. Vi så, at vi havde en eller anden fungerende model, og dette kunne fungere. Derefter tænkte vi på, at vores primære samfund er postgres-brugere, der bruger WAL-G. Derfor skal vi på en eller anden måde adskille disse dele. Det vil sige, når koden til Postgres rettes, skal vi ikke ødelægge MySQL, og når vi retter MySQL, må vi ikke ødelægge Postgres.
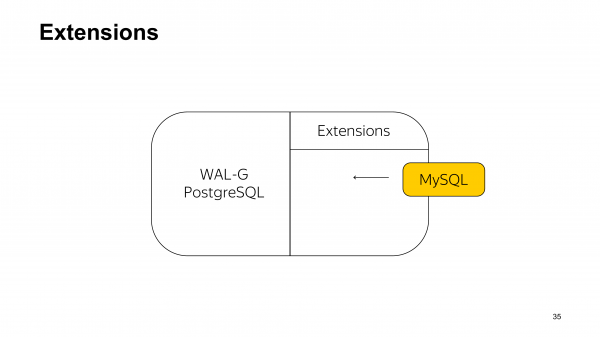
Den første ide om, hvordan man skulle opdele det, var at bruge den samme tilgang, som anvendes i PostgreSQL-udvidelser. For at lave en backup af MySQL skulle du i princippet installere et eller andet dynamisk bibliotek.
Men her kan man straks se asymmetrien i denne tilgang. Når du tager backup af Postgres, installerer du en normal backup-løsning til Postgres, og alt fungerer fint. Men for MySQL viser det sig, at du installerer backup-løsningen til Postgres og desuden et dynamisk bibliotek til MySQL. Det lyder lidt underligt. Vi tænkte også sådan, og besluttede, at dette ikke var den løsning, vi havde brug for.
Forskellige løsninger til Postgres, MySQL, MongoDB, Redis
Men det tillod os, som vi ser det, at finde den rigtige løsning – at adskille forskellige løsninger til forskellige databaser. Dette gjorde det muligt at isolere logikken relateret til backups af forskellige databaser, som ville interagere med et fælles API, som WAL-G implementerer.
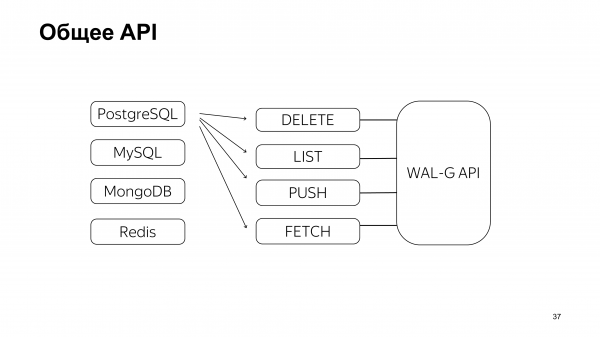
Dette er den del, vi selv har skrevet – før vi gav opgaver til de studerende. Det vil sige, dette er netop den del, hvor de kunne finde på at lave noget forkert, derfor besluttede vi, at det var bedre, at vi lavede noget rigtigt, så alt ville være fint.
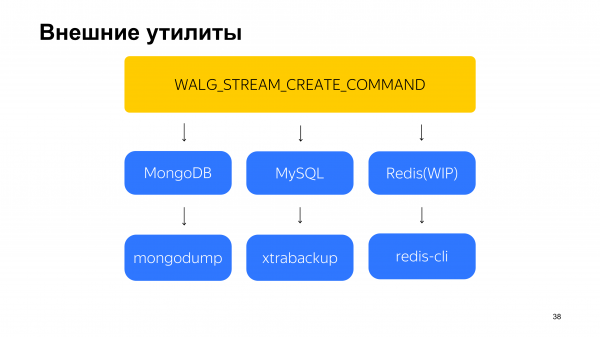
Derefter gav vi dem opgaver. De blev straks taget. De studerende skulle understøtte tre databaser.
Det er MySQL, som vi har taget backup af med WAL-G på denne måde i over et år.
Og nu nærmer MongoDB sig produktion, der bliver finjusteret. I princippet har vi skrevet rammerne for dette. Derefter skrev de studerende nogle fungerende løsninger. Og så fik vi dem til en tilstand, som vi kan acceptere i produktion.
Disse opgaver så ikke ud til, at de studerende skulle skrive komplette backup-værktøjer til hver af disse databaser. Det var ikke et problem for os. Vores problem var, at vi ønskede point-in-time recovery, og vi ønskede at tage backup til skyen. Vi bad de studerende om at skrive noget kode, der ville løse dette. De studerende brugte allerede eksisterende backup-værktøjer, der tog backups på en eller anden måde, og derefter samlede de alt dette med WAL-G, som sendte det hele til skyen. De tilføjede også point-in-time recovery til dette.
Hvad bragte studerende ellers? De bragte støtte til Libsodium-kryptering til WAL-G.
Vi har også fået politikker for opbevaring af backups. Nu kan backups mærkes som permanente. Det er også lettere at automatisere opbevaringsprocessen for din tjeneste.
Hvad blev resultatet af dette eksperiment?
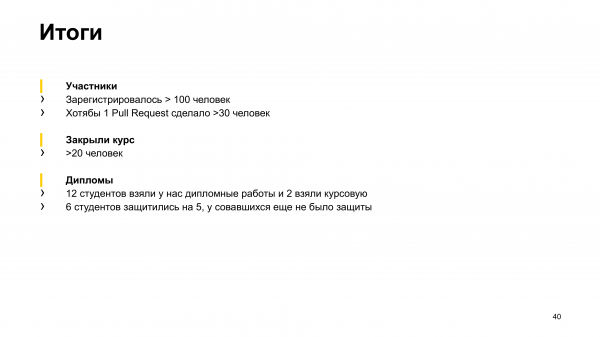
Over 100 personer tilmeldte sig kurset i starten. Jeg nævnte ikke i begyndelsen, at universitetet i Jekaterinburg er Ural Federal University. Her annoncerede vi alt. 100 personer tilmeldte sig. Faktisk begyndte kun cirka 30 personer at arbejde på det.
Endnu færre afsluttede kurset, fordi de skulle skrive tests til de allerede eksisterende koder. Derudover skulle de rette nogle fejl eller lave nogle funktioner. En del studerende afsluttede dog kurset.
Indtil nu har de studerende på dette kursus rettet omkring 14 issues og lavet 10 funktioner af forskellige størrelser. Og, som jeg ser det, er det en fuldgyldig erstatning for en til to udviklere.
Derudover uddelte vi eksamensbeviser og projekter. 12 fik eksamensbeviser. 6 af dem er allerede blevet godkendt med '5'. De andre har endnu ikke været til eksamen, men jeg tror, at det også vil gå dem godt.
Fremtidige planer
Hvad er vores planer for fremtiden?
I det mindste de funktioner, vi allerede har hørt fra brugerne, som vi gerne vil lave. Dette inkluderer:
- Overvågning af korrektheden af tidslinjen i arkivet for HA-klyngens backups. Dette kan gøres ved hjælp af WAL-G. Og jeg tror, at vi kan finde studerende, der kan tage sig af dette.
- Vi har allerede en ansvarlig person for overførsel af backups og WAL mellem skyerne.
- Vi offentliggjorde for nylig en idé om, at vi kan accelerere WAL-G endnu mere ved at udpakke inkrementelle backups uden at overskrive siderne og optimere de arkiver, vi sender derhen.
Du kan dele dem her
Hvad var formålet med denne præsentation? At sige, at nu, udover os fire personer, der understøtter dette projekt, har vi flere ekstra hænder, hvilket er ret mange. Især hvis de skriver til os privat. Og hvis du laver backups af dine data og gør det ved hjælp af WAL-G eller gerne vil skifte til WAL-G, kan vi nemt tage højde for dine ønsker.
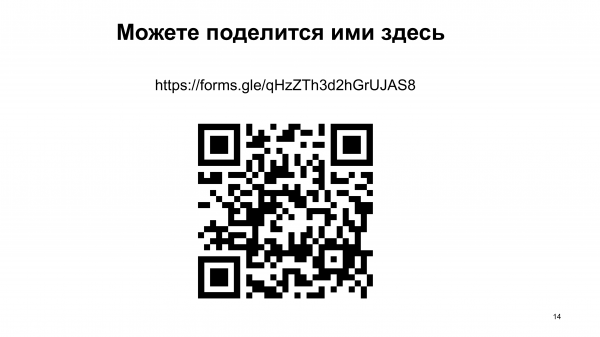
Dette er QR-koden og linket. Du kan bruge dem til at kontakte os og skrive alle dine ønsker. For eksempel, hvis vi ikke retter en bestemt fejl, eller hvis du virkelig ønsker en funktion, der endnu ikke er i nogen backup, inklusive vores. Sørg for at nævne det.
Spørgsmål
Hej! Tak for præsentationen! Et spørgsmål om WAL-G, men ikke om Postgres. WAL-G tager backup af MySQL og kalder en ekstra backup. Med moderne installationer på CentOS, hvis du kører yum install MySQL, vil MariaDB blive installeret. Fra version 10.3 understøttes ekstra backup ikke; der understøttes MariaDB-backup. Hvordan står det til med dette for jer?
På nuværende tidspunkt har vi ikke forsøgt at tage backup af MariaDB. Vi har haft forespørgsler om support til FoundationDB, men generelt, hvis der er en sådan forespørgsel, kan vi finde folk, der kan gøre det. Det er ikke så tidskrævende og ikke så vanskeligt, som jeg synes.
Goddag! Tak for præsentationen! Et spørgsmål om potentielt nye funktioner. Er I klar til at få WAL-G til at fungere med bånd, så vi kan tage backup til bånd?
Backup til båndlageret, mener du?
Ja.
Der er Andrey Borodin, som kan svare bedre på det spørgsmål end mig.
(Andrey) Ja, tak for spørgsmålet! Vi har haft en forespørgsel på at flytte backup til bånd fra cloud-lagring. Og for dette flytning mellem cloud. For flytning mellem cloud er det en slags generel version af at flytte til bånd. Desuden har vi en udvidelig arkitektur med hensyn til lagring. Forresten er mange lagre skrevet af studerende. Og hvis du skriver et lager til bånd, vil det selvfølgelig blive understøttet. Vi er klar til at overveje pull requests. Det handler om at skrive en fil, læse en fil. Hvis disse ting gøres i Go, tager det typisk 50 linjer kode. Og så vil bånd blive understøttet i WAL-G.
Tak for præsentationen! En interessant udviklingsproces. Backup er en vigtig del af funktionaliteten, der skal være dækket godt af tests. Da I implementerede funktionaliteten for de nye databaser, blev testsene også skrevet af studerende, eller skrev I selv testsene og gav derefter implementeringen til studerende?
Testsene blev også skrevet af studerende. Men studerende skrev mere til funktioner som nye databaser. De skrev integrationstests. Og de skrev unit-tests. Hvis integrationstestsene går igennem, dvs. på nuværende tidspunkt – er det et scenarie, som I kører manuelt, eller gør cron det for jer, for eksempel. Dvs. scenariet er rimelig klart.
Studerende har ikke meget erfaring. Hvor lang tid tager det at lave anmeldelser?
Ja, det tager ret lang tid at gennemgå anmeldelser. Det vil sige, normalt, når flere bidragsydere kommer ind og siger, at jeg har gjort dette, jeg har gjort hint, så skal man tænke og afsætte omkring en halv dag til at finde ud af, hvad de har skrevet. Fordi koden skal læses nøje. De har ikke været til samtale. Vi kender dem ikke særlig godt, så det tager en betydelig tid.
Tak for din præsentation! Tidligere har Andrei Borodin sagt, at archive_command i WAL-G skal kaldes direkte. Men i tilfælde af en patroncluster, har vi brug for ekstra logik til at bestemme noden, som vi skal sende valgene fra. Hvordan løser I dette problem?
Hvad er det, du har problemer med her? Har du for eksempel en synkron replika, som du tager backup fra? Eller hvad?
(Andrei) Problemet er, at WAL-G faktisk er designet til at blive brugt uden shell-scripts. Hvis noget mangler, så lad os skrive den logik, som skal være inde i WAL-G. Hvad angår, hvor arkiveringen skal komme fra, mener vi, at arkiveringen skal være fra den nuværende master i clustret. Arkivering fra en replika er en dårlig idé. Der kan opstå forskellige scenarier med problemer. Især problemer med arkivering af tidslinjer og anden ekstra information. Tak for spørgsmålet!
(Præcisering: Vi er blevet fri for shell-script bindinger )
God aften! Tak for din præsentation! Jeg blev interesseret i funktionen catchup, som du nævnte. Jeg har oplevet en situation, hvor en replika var bagud og ikke kunne indhente. Og jeg fandt ikke beskrivelsen af denne funktion i WAL-G's dokumentation.
Catchup kom frem omkring 20. januar 2020. Måske skal dokumentationen forbedres. Vi skriver den selv, og ikke på en super god måde. Og måske bør vi begynde at kræve, at studerende også skriver den.
Er den allerede i udgivelse?
Pull request'en er allerede merged, det vil sige, jeg har tjekket den. Jeg har prøvet det på en testcluster. Indtil videre har vi ikke haft en situation, hvor vi kunne teste det i praksis.
Hvornår skal vi forvente det?
Jeg ved det ikke. Vent en måned, så tjekker vi det.
Kilde: habr.com
