

Mikroservicesarkitektur, ligesom alt andet i verden, har sine fordele og ulemper. Nogle processer bliver enklere, mens andre bliver mere komplicerede. I jagten på hastighed og bedre skalerbarhed må vi ofre noget. En af disse ofre er kompleksiteten i analysen. I en monolit kan al operationel analyse reduceres til SQL-forespørgsler til en analytisk replik, men i en multiservearkitektur har hver service sin egen database, og det virker som om, at vi ikke kan klare os med én forespørgsel (eller kan vi?). For dem, der er interesserede i, hvordan vi løste problemet med operationel analyse i vores virksomhed og hvordan vi har lært at leve med denne løsning - velkommen.
Mit navn er Pavel Sivaš, og jeg arbejder i DomKlik i det team, der står for vedligeholdelsen af det analytiske datalager. Vores arbejde kan groft sagt klassificeres som data engineering, men i virkeligheden er opgavespektret meget bredere. Der er standard opgaver inden for data engineering som ETL/ELT, støtte og tilpasning af værktøjer til dataanalyse samt udvikling af egne værktøjer. Specifikt til operationel rapportering besluttede vi at 'lade som om' vi har en monolit og give analytikerne én database, hvor alle de nødvendige data vil være til stede.
Generelt set har vi overvejet forskellige muligheder. Vi kunne have bygget et fuldt lager — vi prøvede endda, men ærligt talt lykkedes det ikke at få de hyppige ændringer i logikken til at stemme overens med den ret langsomme proces med at bygge lageret og foretage ændringer i det (hvis nogen har lykkes, så skriv i kommentarerne hvordan). Man kunne have sagt til analytikerne: "Drenge, lær python og brug analytiske replikaer", men det ville have været et ekstra krav til rekruttering, og det så vi helst ville undgå, hvis det var muligt. Vi besluttede at prøve teknologien FDW (Foreign Data Wrapper): grundlæggende er det en standard dblink, der er en del af SQL-standarden, men med et langt mere brugervenligt interface. Baseret på det skabte vi en løsning, som endte med at slå rod, og det var den, vi landede på. Dens detaljer er et emne for en enkelt artikel, eller måske flere, da der er meget at fortælle: fra synkronisering af database-skemaer til adgangsstyring og anonymisering af persondata. Det skal også nævnes, at denne løsning ikke er en erstatning for reelle analytiske databaser og lagre, men kun løser en specifik opgave.
På et overordnet niveau ser det sådan ud:
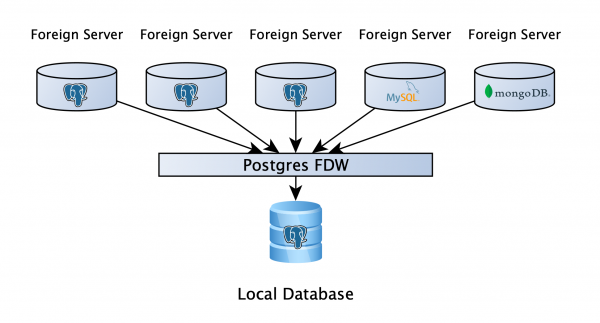
Der er en PostgreSQL-database, hvor brugerne kan opbevare deres arbejdsdata, og det vigtigste er, at denne database er forbundet til analytiske replikaer af alle tjenester via FDW. Det giver mulighed for at skrive en forespørgsel til flere databaser, uanset om det er: PostgreSQL, MySQL, MongoDB eller noget andet (en fil, API, hvis der ikke er en passende wrapper, kan man skrive sin egen). Nå, det lyder godt, skal vi gå hjem?
Hvis alt sluttede så hurtigt og enkelt, ville der nok ikke være nogen artikler.
Det er vigtigt klart at forstå, hvordan PostgreSQL behandler forespørgsler til fjerne servere. Det virker logisk, men ofte ignoreres det: PostgreSQL opdeler forespørgslen i dele, der udføres på de fjerne servere uafhængigt, samler disse data og udfører de endelige beregninger selv, så hastigheden af forespørgslen vil afhænge stærkt af, hvordan den er skrevet. Det skal også bemærkes: når data kommer fra en fjern server, har de ikke længere indekser, der er intet, som kan hjælpe planlæggeren, derfor er det kun os, der kan give hjælp og rådgivning. Og netop det vil jeg gerne fortælle mere om.
Simpel forespørgsel og planen med den
For at vise, hvordan PostgreSQL udfører en forespørgsel til en tabel med 6 millioner rækker på en ekstern serveren, lad os se på en simpel plan.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Brug af instruktionen VERBOSE giver os mulighed for at se den forespørgsel, der sendes til den eksterne server, og resultaterne, som vi får til videre behandling (linje RemoteSQL).
Lad os gå lidt videre og tilføje nogle filtre til vores forespørgsel: et efter boolean felt, et efter forekomst timestamp i intervallet og et efter jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Netop her ligger det punkt, som man skal være opmærksom på, når man skriver forespørgsler. Filtrene blev ikke sendt til den eksterne server, hvilket betyder, at PostgreSQL trækker alle 6 millioner rækker, for først derefter at filtrere lokalt (linje Filter) og udføre aggregationen. Hemmeligheden til succes er at skrive forespørgslen, så filtrene sendes til den eksterne maskine, og vi får kun de relevante rækker til aggregationen.
Det er noget booleanlort
Med boolean felter er det hele enkelt. Problemet i den oprindelige forespørgsel opstod på grund af operatoren is. Hvis vi erstatter den med =, får vi følgende resultat:
forklar analysér detaljeret
VÆLG count(1)
FRA fdw_schema.tabel
HVOR is_active = Sand
OG created_dt Mellem NUVÆRENDE_DATO - INTERVAL '7 måned'
OG NUVÆRENDE_DATO - INTERVAL '6 måned'
OG meta->>'source' = 'test';

Aggregat (omkostning=508010.14..508010.15 rækker=1 bredde=8) (faktisk tid=19064.314..19064.314 rækker=1 løkker=1)
  Output: count(1)
  -> Fremmed Scanning på fdw_schema."tabel" (omkostning=100.00..507988.44 rækker=8679 bredde=0) (faktisk tid=33.035..18951.278 rækker=1360025 løkker=1)
        Output: "tabel".id, "tabel".is_active, "tabel".meta, "tabel".created_dt
        Filter: ((("tabel".meta ->> 'source'::tekst) = 'test'::tekst) OG ("tabel".created_dt >= (('nu'::cstring)::dato - '7 måneder'::interval)) OG ("tabel".created_dt <= ((('nu'::cstring)::dato)::tidsstempel med tidszone - '6 måneder'::interval)))
        Rækker fjernet af filter: 3567989
        Fjern SQL: VÆLG created_dt, meta FRA fdw_schema.tabel HVOR (is_active)
Planlægningstid: 0.834 ms
Udførelsestid: 19064.534 ms
Som du kan se, fløj filteret til den fjerne server, og udførelsestiden faldt fra 27 til 19 sekunder.
Det er vigtigt at bemærke, at operatoren is adskiller sig fra operatoren = ved at den kan håndtere Null-værdier. Det betyder, at is not True i filteret vil efterlade værdierne False og Null, mens != True kun vil efterlade værdierne False. Derfor, når man erstatter operatoren is not skal der gives to betingelser i filteret med operatoren OR, for eksempel, HVOR (col != True) ELLER (col er null).
Nu har vi styr på boolean, lad os komme videre. Men lad os først sætte filteret for boolske værdier tilbage til sin oprindelige tilstand, så vi uafhængigt kan se effekten af de andre ændringer.
timestamptz? hz
Generelt må man ofte eksperimentere med, hvordan man korrekt skriver en forespørgsel, der involverer fjerne servere, og så bagefter søge efter forklaringer på, hvorfor det sker på den bestemte måde. Der er meget lidt information om dette at finde på Internettet. I eksperimenter har vi opdaget, at filteret for en fast dato fløj nemt til den fjerne server, men når vi ønskede at angive datoen dynamisk, som for eksempel now() eller CURRENT_DATE, skete det ikke. I vores eksempel tilføjede vi et sådant filter, så kolonnen created_at indeholdt data præcist fra 1 måned tilbage (MELLEM NUVÆRENDE_DATO - INTERVAL '7 måned' OG NUVÆRENDE_DATO - INTERVAL '6 måned'). Hvad gjorde vi i denne sag?
forklar analyser detaljeret
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 måneder')
AND created_dt >'source' = 'test';

Aggregator (omkostninger=306875.17..306875.18 rækker=1 bredde=8) (aktuel tid=4789.114..4789.115 rækker=1 loops=1)
  Output: count(1)
  InitPlan 1 (returnerer $0)
    ->  Resultat (omkostninger=0.00..0.02 rækker=1 bredde=8) (aktuel tid=0.007..0.008 rækker=1 loops=1)
          Output: ((('nu'::cstring)::date)::timestamp med tidszone - '7 måneder'::interval)
  InitPlan 2 (returnerer $1)
    ->  Resultat (omkostninger=0.00..0.02 rækker=1 bredde=8) (aktuel tid=0.002..0.002 rækker=1 loops=1)
          Output: ((('nu'::cstring)::date)::timestamp med tidszone - '6 måneder'::interval)
  ->  Udenlandsk scanning på fdw_schema."table" (omkostninger=100.02..306874.86 rækker=105 bredde=0) (aktuel tid=23.475..4681.419 rækker=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Rækker fjernet af filter: 76934
        Fjern SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp med tidszone)) AND ((created_dt < $2::timestamp med tidszone))
Planlægnings tid: 0.703 ms
Udførelse tid: 4789.379 ms
Vi bad planlæggeren om at beregne datoen på forhånd i underforespørgslen og sende den færdige variabel i filteret. Og denne indikation gav os et glimrende resultat, forespørgslen blev næsten 6 gange hurtigere!
Igen er det vigtigt at være opmærksom på: datatypen i underforespørgslen skal være den samme som feltet vi filtrerer på, ellers vil planlæggeren konkludere, at da typerne er forskellige, skal alle data først hentes, og så filtreres lokalt.
Lad os gå tilbage til filteret for datoen til dens oprindelige værdi.
Freddy vs. Jsonb
Generelt har boolean felter og datoer allerede betydeligt forbedret vores forespørgsel, men der var stadig én datatype tilbage. Kampen med filtreringen på dette felt er ærligt talt stadig ikke afsluttet, selvom der også her er fremskridt. Sådan lykkedes det os at overføre filteret på jsonb feltet til den fjerne server.
forklar analyser detaljeret
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt MELLEM CURRENT_DATE - INTERVAL '7 måneder'
AND CURRENT_DATE - INTERVAL '6 måneder'
AND meta @> '{"source":"test"}'::jsonb;

Aggregator (omkostninger=245463.60..245463.61 rækker=1 bredde=8) (aktuel tid=6727.589..6727.590 rækker=1 loops=1)
  Output: count(1)
  ->  Udenlandsk scanning på fdw_schema."table" (omkostninger=1100.00..245459.90 rækker=1478 bredde=0) (aktuel tid=16.213..6634.794 rækker=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('nu'::cstring)::date - '7 måneder'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planlægnings tid: 0.747 ms
Udførelsestid: 6727.815 ms
I stedet for filtreringsoperatorer skal en tilstedeværelseoperator anvendes jsonb i en anden. 7 sekunder i stedet for de oprindelige 29. Indtil videre er dette den eneste vellykkede metode til at overføre filtre ved jsonb til en fjernserver, men her er det vigtigt at tage hensyn til én begrænsning: vi bruger version 9.6 af databasen, men vi planlægger at afslutte de sidste tests og migrere til version 12 inden udgangen af april. Når vi er opdateret, skriver vi hvordan det har påvirket, da der er mange ændringer, vi har store forhåbninger til: json_path, den nye adfærd af CTE, push down (som eksisterer fra version 10). Vi glæder os til at prøve det hurtigt.
Finish him
Vi har undersøgt, hvordan hver ændring påvirker forespørgsels hastigheden hver for sig. Lad os nu se, hvad der sker, når de tre filtre er korrekt skrevet.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Ja, forespørgslen ser mere kompleks ud, det er en tvungen omkostning, men udførelseshastigheden er 2 sekunder, hvilket er mere end 10 gange hurtigere! Og dette taler vi om en simpel forespørgsel på et relativt lille datasæt. I reelle forespørgsler opnåede vi gevinster på op til flere hundrede gange.
Lad os opsummere: hvis du bruger PostgreSQL med FDW, skal du altid tjekke, at alle filtre sendes til den fjernserver, så vil du være lykkelig... I det mindste indtil du når til joins mellem tabeller fra forskellige servere. Men det er allerede en historie for en anden artikel.
Tak for din opmærksomhed! Jeg ser frem til at høre spørgsmål, kommentarer, samt historier om din erfaring i kommentarerne.
Kilde: habr.com
