

Effekten af bloat i tabeller og indekser er velkendt og findes ikke kun i Postgres. Der er måder at bekæmpe det “out of the box”, såsom VACUUM FULL eller CLUSTER, men de blokerer tabellerne under brug, og derfor kan de ikke altid anvendes.
I denne artikel vil der være lidt teori om, hvordan bloat opstår, hvordan man kan bekæmpe det, om deferred constraints og de problemer, de bringer med sig i brugen af udvidelsen pg_repack.
Denne artikel er baseret på på PgConf.Russia 2020.
Hvorfor bloat opstår
Postgres er baseret på en fler-version model (). Essensen er, at hver række i tabellen kan have flere versioner, og transaktioner ser kun én af disse versioner, men nødvendigvis ikke den samme. Dette muliggør, at flere transaktioner kan køre samtidig og næsten ikke påvirker hinanden.
Det er åbenlyst, at alle disse versioner skal opbevares. Postgres arbejder med hukommelsen side for side, og en side er den mindste datamængde, der kan læses fra disken eller skrives. Lad os overveje et lille eksempel for at forstå, hvordan dette foregår.
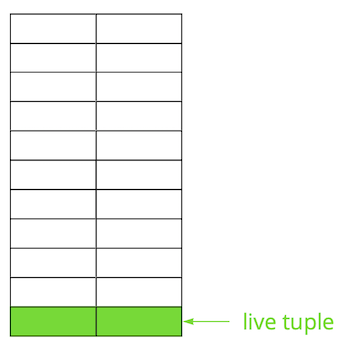
Antag, at vi har en tabel, hvor vi har tilføjet nogle poster. På den første side af filen, hvor tabellen gemmes, optrådte nye data. Dette er levende versioner af rækkerne, som er tilgængelige for andre transaktioner efter commit (for enkelheds skyld antager vi, at isolationsniveauet er Read Committed).
Derefter opdaterede vi en af posterne og markerede dermed den gamle version som forældet.
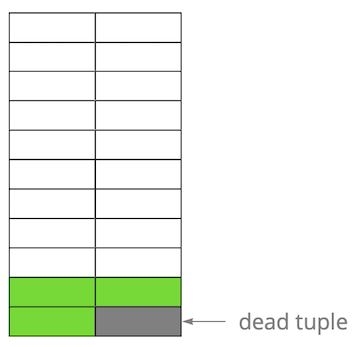
Skridt for skridt, ved at opdatere og slette versioner af rækkerne, fik vi en side, hvor cirka halvdelen af dataene er “skrald”. Disse data er ikke synlige for nogen transaktion.
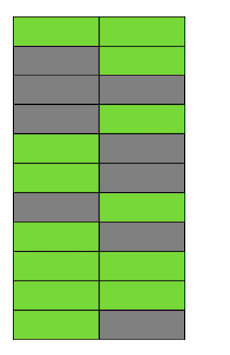
I Postgres findes der en mekanisme , der renser forældede versioner og frigiver plads til nye data. Men hvis den ikke er indstillet aggressivt nok eller er optaget af arbejde med andre tabeller, forbliver “skralddataene”, og vi er nødt til at bruge ekstra sider til nye data.
Så i vores eksempel vil tabellen på et tidspunkt bestå af fire sider, men der vil kun være levende data på halvdelen. Som et resultat vil vi, når vi tilgår tabellen, læse meget mere data, end nødvendigt.
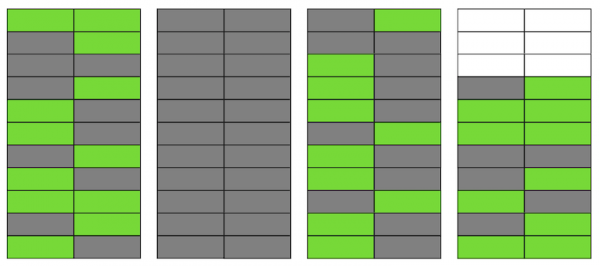
Selv hvis VACUUM i øjeblikket fjerner alle irrelevante versioner af rækker, vil situationen ikke forbedres markant. Vi vil få ledig plads på siderne eller endda hele sider til nye rækker, men vi vil stadig læse flere data, end nødvendigt.
Forresten, hvis en helt tom side (den anden i vores eksempel) lå i slutningen af filen, kunne VACUUM skære den væk. Men nu ligger den i midten, så vi kan ikke gøre noget ved den.
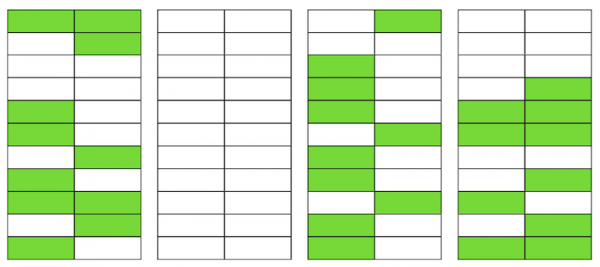
Når antallet af sådanne tomme eller stærkt udtyndede sider bliver stort, hvilket kaldes bloat, begynder det at påvirke ydeevnen.
Det ovenfor beskrevne er mekanismen bag opståen af bloat i tabeller. I indekser sker det på omtrent samme måde.
Har jeg bloat?
Der er flere måder at afgøre, om du har bloat. Ideen med den første metode er at bruge Postgres interne statistik, som indeholder omtrentlige oplysninger om antallet af rækker i tabellerne, antallet af "levende" rækker osv. Du kan finde mange varianter af færdige scripts på internettet. Vi har baseret os på fra PostgreSQL Experts, der kan vurdere bloat i tabeller sammen med toast og bloat btree-indekser. Efter vores erfaring er fejlmarginen 10-20%.
En anden metode er at bruge udvidelsen , som giver mulighed for at kigge ind i siderne og få både et vurderings- og et præcist bloat-værdi. Men i det andet tilfælde skal hele tabellen scannes.
En lille bloat-værdi, op til 20%, betragtes som acceptabel. Den kan ses som et svarende til fillfactor for og . Ved 50% eller derover kan der opstå problemer med ydeevnen.
Metoder til at bekæmpe bloat
I Postgres er der flere måder at bekæmpe bloat "ud af boksen", men de passer ikke altid til alle.
Konfigurer AUTOVACUUM, så bloat ikke opstår. Og for at være mere præcis, sådan at den forbliver på et acceptabelt niveau for dig. Det lyder måske som et 'leder'-råd, men i realiteten er det ikke altid nemt at opnå. For eksempel, hvis du har aktiv udvikling med regelmæssige ændringer i datastrukturen eller hvis der finder en data-migrering sted. Som et resultat kan din belastningsprofil ofte ændre sig, og som regel er den forskellig for forskellige tabeller. Det betyder, at du skal arbejde lidt på forkant og justere AUTOVACUUM til den skiftende profil for hver tabel. Men det er åbenlyst, at det ikke er en simpel opgave.
En anden almindelig årsag til, at AUTOVACUUM ikke når at behandle tabellerne, er tilstedeværelsen af langvarige transaktioner, som forhindrer det i at rydde data, da de er tilgængelige for disse transaktioner. Anbefalingen her er også åbenlys – slip af med 'hængende' transaktioner og minimere tiden for aktive transaktioner. Men hvis belastningen på din applikation er en hybrid af OLAP og OLTP, så kan du samtidig have både mange hyppige opdateringer og korte forespørgsler samt langvarige operationer – for eksempel opbygningen af en rapport. I sådan en situation er det værd at overveje at sprede belastningen over forskellige databaser, hvilket vil tillade en mere finjusteret indstilling af hver enkelt.
Endnu et eksempel – selv hvis profilen er ensartet, men databasen er under meget høj belastning, så kan selv det mest aggressive AUTOVACUUM ikke klare det, og bloat vil opstå. Skalering (vertikalt eller horisontalt) er den eneste løsning.
Hvordan kan man tackle situationen, når man har konfigureret AUTOVACUUM, men bloat fortsætter med at vokse.
Kommandoen VACUUM FULL genopbygger indholdet af tabeller og indekser og efterlader kun aktuelle data i dem. For at eliminere bloat fungerer det perfekt, men under dens udførelse opnås en eksklusiv lås på tabellen (AccessExclusiveLock), hvilket forhindrer, at forespørgsler til denne tabel kan udføres, selv selects. Hvis du har råd til at stoppe din service eller en del af den i et stykke tid (fra dusinvis af minutter til flere timer afhængigt af databassens størrelse og dit udstyr), så er denne mulighed den bedste. Desværre har vi ikke tid til at køre VACUUM FULL inden for den planlagte vedligeholdelse, så denne metode er ikke passende for os.
Kommandoen CLUSTER den ombygger også indholdet af tabeller som VACUUM FULL, men giver mulighed for at angive et indeks, som data vil blive fysisk sorteret efter på disken (men fremover er rækkefølgen ikke garanteret for nye rækker). I visse situationer er dette en god optimering for en række forespørgsler – med læsning af flere poster gennem indekset. Ulempen ved kommandoen er den samme som for VACUUM FULL – den blokerer tabellen under arbejdet.
Kommandoen REINDEX ligner de to forrige, men udfører ombygning af et specifikt indeks eller alle indekser i tabellen. Låserne er lidt svagere: ShareLock på tabellen (forhindrer ændringer, men tillader select) og AccessExclusiveLock på det ombyggede indeks (låser forespørgsler, der bruger dette indeks). Men i version 12 af Postgres blev parameteren introduceret , som tillader at ombygge indekset uden at blokere parallel tilføjelse, ændring eller sletning af poster.
I tidligere versioner af Postgres kan man opnå et resultat, der er sammenligneligt med REINDEX CONCURRENTLY, ved hjælp af . Det tillader at oprette et indeks uden strenge låsninger (ShareUpdateExclusiveLock, som ikke forstyrrer parallelle forespørgsler), derefter erstatte det gamle indeks med det nye og slette det gamle indeks. Dette gør det muligt at eliminere bloat i indekserne uden at forstyrre dit programs drift. Det er vigtigt at tage højde for, at der vil være en ekstra belastning på det diskbaserede system under ombygningen af indekserne.
Således, hvis der er metoder til at eliminere bloat for indekser "on-the-fly", så er der ingen for tabeller. Her træder forskellige eksterne udvidelser ind: (tidligere pg_reorg), , og andre. I denne artikel vil jeg ikke sammenligne dem, men kun tale om pg_repack, som vi bruger efter lidt tilpasning.
Hvordan fungerer pg_repack
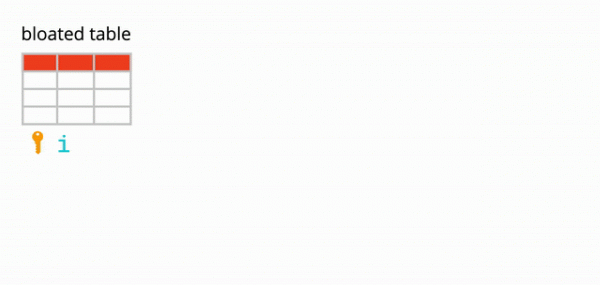
Lad os sige, at vi har en helt almindelig tabel – med indekser, begrænsninger og, desværre, bloat. Det første skridt pg_repack tager, er at oprette en logtabel til at gemme data om alle ændringer under arbejdet. En trigger vil replikere disse ændringer ved hver insert, update og delete. Derefter oprettes en tabel, der er strukturelt identisk med den oprindelige, men uden indekser og begrænsninger, for ikke at bremse dataindsættelsesprocessen.
Derefter flytter pg_repack data fra den gamle tabel til den nye tabel og filtrerer automatisk alle irrelevante rækker, hvorefter den opretter indekser for den nye tabel. Under udførelsen af alle disse operationer akkumuleres ændringerne i log-tabellen.
Næste skridt er at overføre ændringerne til den nye tabel. Overførslen udføres i flere iterationer, og når der er færre end 20 optegnelser i log-tabellen, tager pg_repack en streng lås, overfører de sidste data og erstatter den gamle tabel med den nye i de systemmæssige tabeller Postgres. Det er det eneste og meget korte øjeblik, hvor du ikke kan arbejde med tabellen. Herefter slettes den gamle tabel og log-tabellen, og plads frigives i filsystemet. Processen er afsluttet.
I teorien ser alt godt ud, men hvordan er det i praksis? Vi testede pg_repack uden belastning og under belastning, og kontrollerede dens funktion i tilfælde af en for tidlig stop (kort sagt, ved at trykke på Ctrl+C). Alle tests var positive.
Vi gik live - og her begyndte alt at gå galt i forhold til vores forventninger.
Den første udfordring i produktionen
På den første klynge fik vi en fejl vedrørende overtrædelse af det unikke begrænsning:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Denne begrænsning havde et automatisk genereret navn index_16508 - det blev oprettet af pg_repack. Gennem de relevante attributter kunne vi identificere "vores" begrænsning, der svarer til den. Problemet viste sig at være, at det ikke er en almindelig begrænsning, men en udsat (), hvilket betyder, at kontrollen af den udføres senere end SQL-kommandoen, hvilket fører til uventede konsekvenser.
Udsatte begrænsninger: hvorfor er de nødvendige, og hvordan fungerer de
Lidt teori om udsatte begrænsninger.
Lad os overveje et simpelt eksempel: Vi har en bil-oversigtstabel med to attributter - navnet og rækkefølge af bilen i oversigtstabellen.
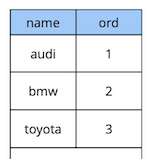
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Antag, at vi har brug for at bytte den første og den anden bil om. En direkte løsning ville være at opdatere den første værdi til den anden og den anden til den første:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Men når vi udfører denne kode, forventer vi som forventet at få en begrænsningsovertrædelse, fordi rækkefølgen af værdierne i tabellen er unik:
[23305] FEJL: duplikatnøgleværdi overtræder den unikke begrænsning “uk_cars”
Detalje: Nøgle (ord)=(2) findes allerede.
Hvordan kan det gøres anderledes? Første mulighed: tilføje en ekstra erstatning for en værdi, som garanteret ikke findes i tabellen, for eksempel “-1”. Inden for programmering kaldes det “bytte af værdier mellem to variabler gennem en tredje”. Den eneste ulempe ved denne metode er en ekstra opdatering.
Anden mulighed: omdesigne tabellen for at bruge en datatype med flydende decimal for ordensværdien i stedet for heltal. Når værdien opdateres fra 1 til for eksempel 2.5, vil den første post automatisk “placeres” mellem den anden og tredje. Denne løsning virker, men har to begrænsninger. For det første er den ikke egnet, hvis værdien bruges et eller andet sted i grænsefladen. For det andet, afhængigt af datatypens præcision, vil du have et begrænset antal mulige indskud, før du skal genberegne værdierne for alle poster.
Tredje mulighed: gøre begrænsningen udsat, så den kun tjekkes på tidspunktet for commit:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Da logikken i vores oprindelige forespørgsel garanterer, at alle værdier er unikke på tidspunktet for commit, vil den blive udført med succes.
Det ovenfor omtalte eksempel er naturligvis meget syntetisk, men det afslører ideen. I vores applikation bruger vi udsatte begrænsninger til at implementere logik, der håndterer konflikter, når brugere samtidig arbejder med fælles objekter-widgets på tavlen. Brug af sådanne begrænsninger gør vores applikationskode en smule enklere.
Generelt, afhængigt af typen af begrænsning i Postgres, er der tre niveauer af granularitet for deres kontrol: række-, transaktions- og udtryk.
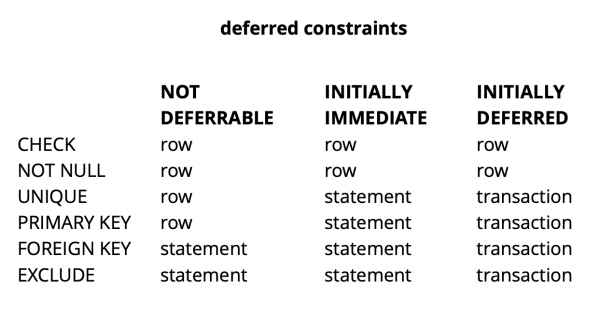
Kilde:
CHECK og NOT NULL kontrolleres altid på rækkeniveau, mens de andre begrænsninger, som det ses i tabellen, har forskellige muligheder. Du kan læse mere om det. .
Kort sagt giver udsatte begrænsninger i nogle situationer en mere læsbar kode og færre kommandoer. Men prisen for dette er en mere kompliceret debug-proces, da tidspunktet for opståen af en fejl og tidspunktet, hvor du bliver opmærksom på den, er adskilt tidsmæssigt. Endvidere kan en mulig udfordring være, at planlæggeren ikke altid kan udarbejde en optimal plan, hvis der i forespørgslen indgår en udsat begrænsning.
Forbedring af pg_repack
Vi har undersøgt, hvad udsatte begrænsninger er, men hvordan hænger de sammen med vores problem? Lad os huske fejlen, vi tidligere fik:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Den opstår i øjeblikket, hvor data kopieres fra log-tabellen til den nye tabel. Dette virker mærkeligt, da dataene i log-tabellen bliver committet sammen med dataene i den oprindelige tabel. Hvis de opfylder begrænsningerne i den oprindelige tabel, hvordan kan de så overtræde de samme begrænsninger i den nye?
Som det viser sig, ligger problemet i det forrige trin af arbejdet i pg_repack, hvor der kun oprettes indekser, men ikke begrænsninger: i den gamle tabel var der en unik begrænsning, men i den nye blev der i stedet oprettet et unikt indeks.
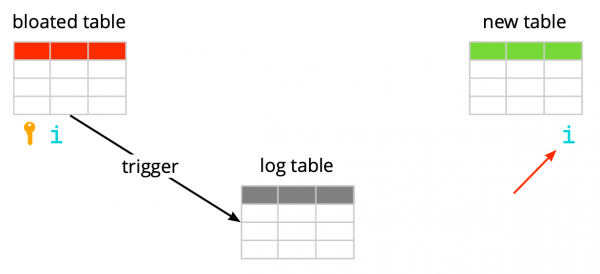
Her er det vigtigt at bemærke, at hvis begrænsningen er almindelig og ikke udsat, så svarer det unikke indeks, der er oprettet i stedet, til denne begrænsning, da unikke begrænsninger i Postgres realiseres ved at oprette et unikt indeks. Men i tilfælde af en udsat begrænsning er adfærden ikke den samme, fordi indekset ikke kan være udsat og altid kontrolleres i øjeblikket for udførelsen af sql-kommandoen.
Derfor er essensen af problemet "udskydelsen" af kontrollen: i den oprindelige tabel sker den på tidspunktet for commit, mens den i den nye tabel sker i øjeblikket for udførelsen af sql-kommandoen. Det betyder, at vi skal sørge for, at kontrollerne udføres ens i begge tilfælde: enten altid udsat eller altid straks.
Så hvad var vores ideer.
Opret et indeks, der svarer til deferred
Den første idé er at udføre begge kontroller i øjeblikkelig tilstand. Dette kan forårsage nogle falske positive udløb af begrænsningen, men hvis antallet er begrænset, bør det ikke påvirke brugernes oplevelse, da sådanne konflikter er normale for dem. De opstår for eksempel, når to brugere begynder at redigere den samme widget samtidig, og klienten for den anden bruger ikke når at modtage information om, at widgeten allerede er låst til redigering af den første bruger. I sådan en situation svarer serveren til den anden bruger med et afslag, og hans klient ruller ændringerne tilbage og låser widgeten. Kort tid efter, når den første bruger er færdig med at redigere, vil den anden modtage information om, at widgeten ikke længere er låst, og han kan gentage sin handling.
For at sikre, at kontrollerne altid er i en nødtilstand, har vi oprettet et nyt indeks, der ligner det oprindelige udsatte begrænsning:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- kør pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
I testmiljøet har vi kun fået et par forventede fejl. Succes! Vi kørte pg_repack igen på produktionen og fik 5 fejl på det første cluster i løbet af en times drift. Dette er et acceptabelt resultat. Men allerede på det andet cluster voksede antallet af fejl mange gange, og vi måtte stoppe pg_repack.
Hvorfor skete det? Sandsynligheden for fejl afhænger af, hvor mange brugere der arbejder samtidig med de samme widgets. Tilsyneladende var der på det tidspunkt betydeligt færre konkurrerende ændringer med dataene på det første cluster sammenlignet med de andre, så vi havde bare 'held'.
Idéen virkede ikke. På det tidspunkt så vi to andre mulige løsninger: omprogrammering af vores applikationskode for at undgå udsatte begrænsninger, eller at 'lære' pg_repack at arbejde med dem. Vi valgte den anden mulighed.
Erstat indekserne i den nye tabel med de udsatte begrænsninger fra den oprindelige tabel.
Målet med forbedringen var klart – hvis den oprindelige tabel har en udsat begrænsning, skal der oprettes en sådan begrænsning for den nye tabel og ikke et indeks.
For at kontrollere vores ændringer skrev vi en simpel test:
- tabel med en udsat begrænsning og én post;
- indsætter data i en løkke, der konfliterer med den eksisterende post;
- vi udfører en opdatering – dataene konflikter ikke længere;
- vi kommitterer ændringerne.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Den oprindelige version af pg_repack fejlede altid på den første indlæsning, den forbedrede version fungerede uden fejl. Fantastisk.
Vi går i produktion og får igen en fejl i den samme fase af dataoverførsel fra log-tabellen til den nye:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Klassisk situation: alt fungerer i testmiljøerne, men i produktionen – gør det ikke?!
APPLY_COUNT og grænsen mellem to batcher
Vi begyndte at analysere koden linje for linje og opdagede et vigtigt punkt: dataoverførslen fra log-tabellen til den nye sker i batcher; konstanten APPLY_COUNT angav batchstørrelsen:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* der kan stadig være nogle tuples, gentag. */
...
}
Problemet er, at dataene fra den oprindelige transaktion, hvor flere operationer potentielt kan overtræde begrænsningen, under overførslen kan havne på grænsen mellem to batcher – halvdelen af kommandoerne vil blive kommitteret i den første batch, og den anden halvdel i den anden. Og her afhænger det af tilfældet: hvis kommandoerne i den første batch ikke overtræder noget, er alt godt, men hvis de gør, sker der en fejl.
APPLY_COUNT er lig med 1000 poster, hvilket forklarer, hvorfor vores test var vellykkede – de dækkede ikke tilfældet "grænsen mellem batcher". Vi brugte to kommandoer – indlæsning og opdatering, så præcis 500 transaktioner med to kommandoer blev altid placeret i en batch, og vi oplevede ikke problemer. Efter at have tilføjet en anden opdatering stoppede vores løsning med at fungere:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- endnu en opdatering
    COMMIT;
  END;
END LOOP;
Så den næste opgave – at sikre, at dataene fra den oprindelige tabel, som ændres i én transaktion, også placeres i den nye tabel inden for én transaktion.
Afvisning af batch
Og vi havde igen to løsningsmuligheder. Den første: lad os helt undgå at opdele i batches og i stedet gøre dataoverførslen i én transaktion. Fordelen ved denne løsning var dens enkelhed – de nødvendige kodeændringer var minimale (for resten arbejdede pg_reorg i de ældre versioner netop på den måde). Men der er et problem – vi skaber en langvarig transaktion, og som tidligere nævnt, er det en trussel mod opståelsen af ny bloat.
Den anden løsning – mere kompleks, men sandsynligvis mere korrekt: opret i log-tabellen en kolonne med identifikatoren for den transaktion, der tilføjede data til tabellen. Så når vi kopierer data, kan vi gruppere dem efter dette attribut og sikre, at relaterede ændringer overføres sammen. Et batch vil bestå af flere transaktioner (eller én stor), og størrelsen vil variere afhængigt af, hvor meget data der blev ændret i disse transaktioner. Det er vigtigt at bemærke, at da data fra forskellige transaktioner kommer ind i log-tabellen i vilkårlig rækkefølge, vil det ikke længere være muligt at læse den sekventielt, som før. Seqscan ved hver forespørgsel med filtrering efter tx_id – det er for dyrt, vi har brug for en indeks, men den vil også sænke metodens ydeevne på grund af overhead til opdatering. Som altid, skal vi ofre noget.
Så vi besluttede at starte med den første mulighed, da den var mere enkel. Først skulle vi forstå, om den langvarige transaktion ville være et reelt problem. Da den primære dataoverførsel fra den gamle tabel til den nye også sker i en langvarig transaktion, blev spørgsmålet omdannet til "hvor meget øger vi denne transaktion?" Varigheden af den første transaktion afhænger primært af størrelsen på tabellen. Varigheden af den nye afhænger af, hvor mange ændringer der ophobes i tabellen i løbet af dataoverførslen, altså af belastningens intensitet. Kørsel af pg_repack skete under minimal belastning på tjenesten, og omfanget af ændringer var uforholdsmæssigt lille sammenlignet med den oprindelige tabelstørrelse. Vi besluttede, at vi kunne se bort fra varigheden af den nye transaktion (til sammenligning er det i gennemsnit 1 time og 2-3 minutter).
Eksperimenterne var positive. Udrulningen på produktion også. For tydelighedens skyld – et billede med størrelsen på en af databaserne efter kørslen:
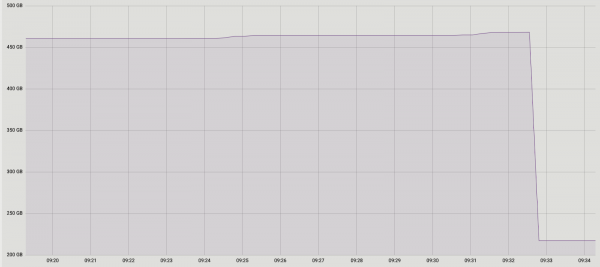
Da dette løsningen fungerede for os, besluttede vi ikke at prøve at implementere en anden, men vi overvejer muligheden for at diskutere det med udviklerne af udvidelsen. Vores nuværende forbedring er desværre stadig ikke klar til offentliggørelse, da vi kun har løst problemet med unikke udsatte begrænsninger, og for at lave en fuld opdatering er det også nødvendigt at understøtte andre typer. Vi håber at kunne gøre dette i fremtiden.
Måske har du spurgt dig selv, hvorfor vi overhovedet gik ind i denne historie med forbedringen af pg_repack i stedet for at bruge dets alternativer? På et tidspunkt overvejede vi også dette, men den positive erfaring med at bruge det tidligere, på tabeller uden udsatte begrænsninger, motiverede os til at forsøge at forstå problemet og rette det. Derudover kræver brugen af andre løsninger også tid til test, så vi besluttede, at vi først ville prøve at løse problemet i det, og hvis vi fandt ud af, at vi ikke kunne gøre det indenfor rimelig tid, ville vi begynde at overveje alternativer.
Konklusioner
Hvad vi kan anbefale baseret på vores egen erfaring:
- Overvåg dit bloat. Baseret på overvågningsdata kan du forstå, hvor godt autovacuum er konfigureret.
- Konfigurer AUTOVACUUM for at holde bloat på et acceptabelt niveau.
- Hvis bloat trods alt vokser, og du ikke kan bekæmpe det med de „indbyggede“ værktøjer, skal du ikke være bange for at bruge eksterne udvidelser. Det vigtigste er at teste grundigt.
- Vær ikke bange for at tilpasse eksterne løsninger til dine behov – nogle gange kan dette være mere effektivt og endda lettere end at ændre din egen kode.
Kilde: habr.com
