

I dag vil jeg fortælle dig en historie. Historien om udviklingen af informations teknologi og fremkomsten af fjernarbejdspladser fra tidernes morgen til i dag.
Udviklingen af IT
Det vigtigste, man kan lære af IT-historien, er…
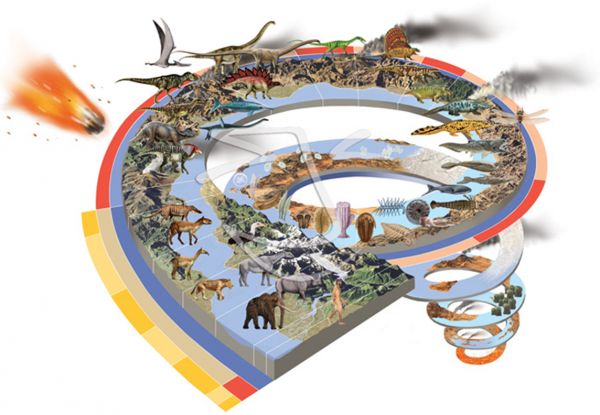
Selvfølgelig udvikler IT sig i spiraler. De samme løsninger og koncepter, som blev forkastet for årtier siden, får ny betydning og begynder at fungere i nye betingelser, med nye opgaver og nye kapaciteter. På dette område adskiller IT sig ikke fra nogen anden gren af menneskelig viden eller Jordens historie generelt.
For længe siden, da computere var store
“Jeg tror, at der i verden er marked for omkring fem computere”, sagde IBM's Thomas Watson i 1943.
Tidlige computere var store. Nej, det er forkert, de tidlige maskiner var monstrøse, cyklopiske. En fuldt udstyret computer optog et område svarende til en sports-hal, og kostede helt absurde beløb. Et eksempel på komponenter kunne være en hukommelsesmodul med ferritringe (1964).
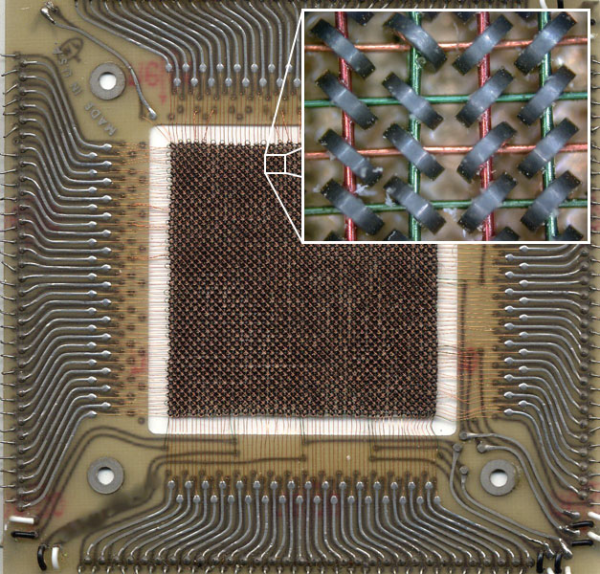
Dette modul måler 11 cm * 11 cm og har en kapacitet på 512 bytes (4096 bits). Et rack, der er helt fyldt med disse moduler, havde næppe den kapacitet, som en allerede forældet 3,5” diskette (1.44 MB = 2950 moduler) kunne rumme, samtidig med at det forbrugte en betydelig mængde strøm og blev varmt som et lokomotiv.
Det er netop de enorme størrelser, der har givet det engelske udtryk debugging sin oprindelse. En af de første programmører i historien, Grace Hopper (ja, ja, en kvinde), en officer i den maritime styrke, gjorde i 1945 et indlæg i sin logbog efter at have undersøgt en fejl i et program.
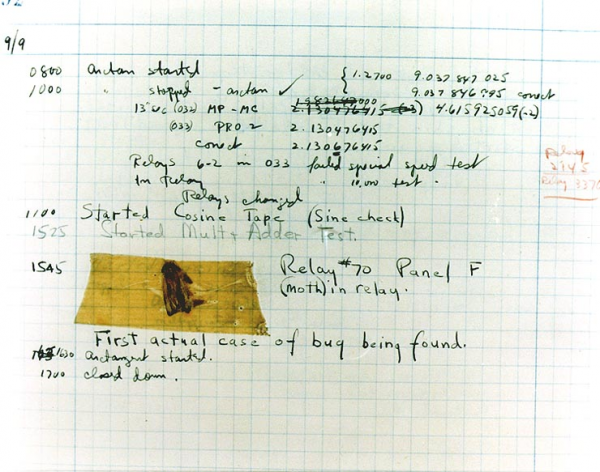
Da moth (møl) generelt er synonymt med bug (insekt), rapporterede personalet alle følgende problemer og løsninger til ledelsen som debugging (bogstaveligt talt ‘afmugler’), så programmets svigt og fejl i koden fik fastlåst navnet bug, og debugging blev til debuggin.
I takt med elektronik og især halvlederteknologiens udvikling blev maskinernes fysiske størrelser mindre, mens den beregningsmæssige kraft derimod voksede. Men selv i dette tilfælde kunne man ikke give hver enkelt person sin egen computer.
“Der er ingen årsager til, at nogen skulle ønske at have en computer derhjemme” — Ken Olsen, grundlægger af DEC, 1977.
I 70'erne opstod termen mini-computer. Jeg husker, da jeg første gang læste dette begreb for mange år siden, at jeg forestillede mig noget i stil med en netbook, næsten en håndholdt enhed. Jeg kunne ikke være længere fra sandheden.
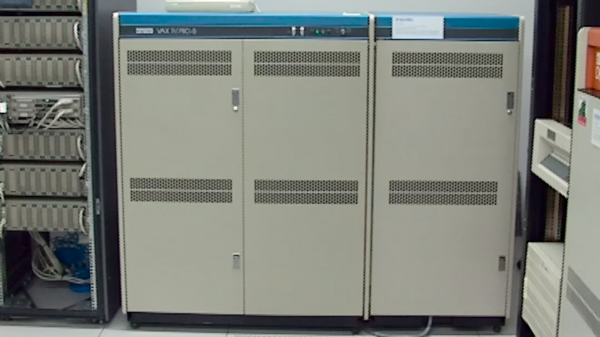
Mini – det er kun i forhold til de enorme maskinhaller, men det er stadig flere skabe med udstyr til hundrede tusind og millioner dollars. Men den beregningsmæssige kapacitet var allerede steget så meget, at den ikke altid var belastet til 100 %, og samtidig blev computere tilgængelige for studerende og undervisere på universiteter.
Og så kom HAN!
Få overvejer de latinske rødder i det engelske sprog, men det er netop det, der har bragt os fjernadgang, som vi kender det i dag. Terminus (latin) – slutning, grænse, mål. Målene for Terminator T800 var at afslutte livet for John Connor. Vi ved også, at transportstationer, hvor passagerer stiger på og af, eller hvor varer lastes og losses, kaldes terminaler – de endelige mål for ruter.
Derfor opstod konceptet med terminaladgang, og du kan se den mest kendte terminal i verden, som stadig lever i vores hjerter.
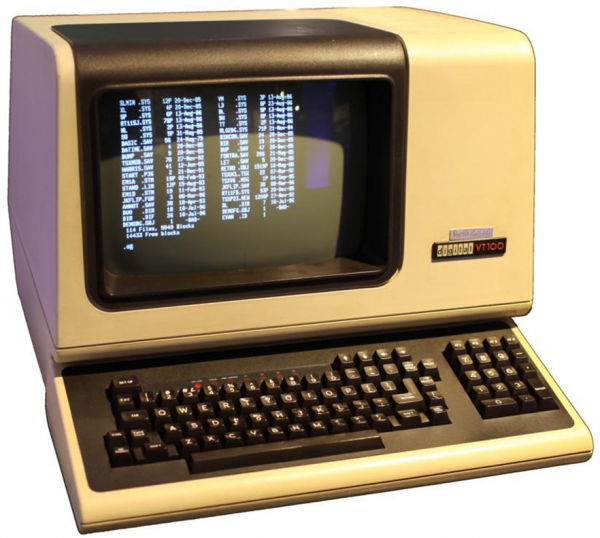
DEC VT100 kaldes en terminal, fordi den afslutter informationslinjen. Den har faktisk nul beregningskraft, og dens eneste opgave er at vise den modtagne information fra en stor maskine og videregive input fra tastaturet til maskinen. Selvom VT100 fysisk er døde for længe siden, bruger vi dem stadig fuldt ud.
Vore dage
“Vore dage” ville jeg begynde at tælle fra begyndelsen af 80'erne, fra det tidspunkt hvor de første tilgængelige processorer med en eller anden form for betydelig beregningskraft dukkede op. Det betragtes traditionelt, at den vigtigste processor fra denne æra var Intel 8088 (x86-familien) som grundlæggeren af den vindende arkitektur. Hvad er den principielle forskel fra konceptet i 70'erne?
Der for første gang er der en tendens til at flytte informationsbehandling fra centrum til periferien. Langt fra alle opgaver kræver de vanvittige (i forhold til den svage x86) kapaciteter fra mainframe eller endda mini-computere. Intel står ikke stille; i 90'erne lancerer de Pentium-familien, som er blevet den første masseproducerede hjemmecomputer i Rusland. Disse processorer er allerede i stand til meget, ikke kun at skrive et brev — men også at håndtere multimedie og arbejde med små databaser. Faktisk opstår fuldstændig behovet for servere for små virksomheder — alt kan udføres på periferien, på klientmaskinerne. Hvert år bliver processorene mere kraftfulde, og forskellen mellem servere og personlige computere bliver mindre og mindre med hensyn til beregningskraft, ofte kun tilbageholdende i strømreservior, understøttelse af hot-swap og særlige kabinetter til montage i racks.
Når man sammenligner moderne klientprocessorer med den 'lavede' for administratorer af tunge servere i 90'erne fra Intel med supercomputere fra fortiden, bliver man lidt utilpas.
Lad os tage et kig på en gammel klassiker, der praktisk talt er på min alder. Cray X-MP/24 fra 1984.
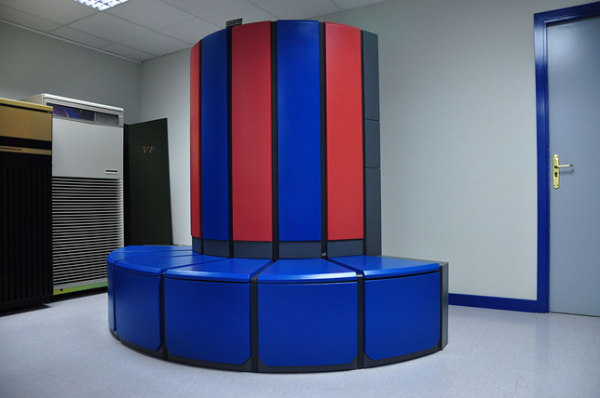
Denne maskine var blandt de bedste supercomputere i 1984, med 2 processorer på 105 MHz og en spidsberegningskapacitet på 400 MFlops (millioner flydende punkt-operationer). Den specifikke maskine, der er vist på billedet, stod i kryptografilaboratoriet hos den amerikanske NSA og blev brugt til at bryde koder. Hvis man konverterer 15 millioner dollars fra 1984 til dollars fra 2020, ville prisen være 37,4 millioner, eller 93.500 dollars/MFlops.
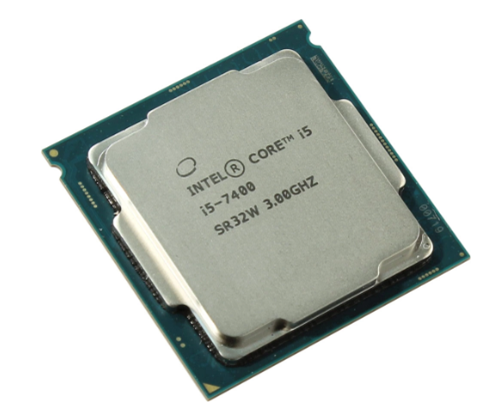
I den maskine, hvor jeg skriver disse linjer, sidder en Core i5-7400 processor fra 2017, som bestemt ikke er ny, og selv i året for sin udgivelse var den den yngste 4-kernede af alle desktop-processorer i mellemklassen. 4 kerner med en basisfrekvens på 3.0 GHz (3.5 med Turbo Boost) og fordobling af tråde via HyperThreading giver fra 19 til 47 GFlops kapacitet på forskellige tests til en pris på 16.000 rubler for processoren. Hvis man samlet set bygger maskinen, kan dens pris anslås til 750 dollars (baseret på priserne og valutakursen den 1. marts 2020).
I sidste ende får vi en overlegenhed af en ganske gennemsnitlig desktop-processor fra vores dage på 50-120 gange over supercomputeren fra top 10 fra en overskuelig fortid, mens faldet i den specifikke pris per MFlops bliver helt uhørt 93.500/25 = 3.700 gange.
Hvorfor har vi stadig brug for servere og centralisering af beregninger, når der er så store ressourcer til rådighed på kanten - det er fuldstændig ubegribeligt!
Tilbagevenden - spiralens sving
Diskfrie stationer
Det første tegn på, at flytningen af beregninger til kanten ikke vil være endelig, var fremkomsten af teknologien til diskfrie arbejdsstationer. Når arbejdsstationer er betydeligt fordelt over virksomheden, og især i forurenede omgivelser, opstår der et presserende behov for styring og vedligeholdelse af disse stationer.
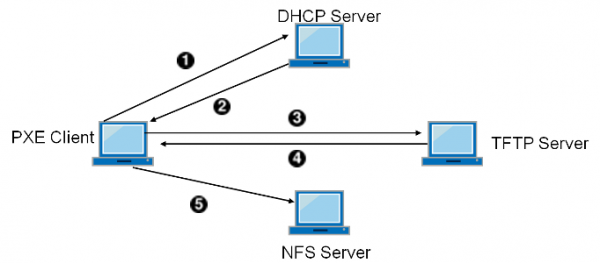
Begrebet “korridor tid” opstår - den procentdel af tiden, som supportmedarbejderen er i korridoren, på vej til medarbejderen med problemet. Denne tid er betalt, men fuldstændig uproduktiv. Ikke mindst i forurenede omgivelser har nedbrud af harddiske spillet en stor rolle. Lad os fjerne disken fra arbejdsstationen, og gøre alt andet via netværket, inklusive opstart. Netværksadapteren modtager udover adressen fra DHCP-serveren også yderligere oplysninger - adresser på TFTP-serveren (et forenklet filsystem) og navnet på boot-imaget, downloader det til RAM og starter maskinen.
Ud over færre nedbrud og mindre korridor tid, kan maskinen nu ikke blot justeres på stedet, men simpelthen erstattes med en ny, mens den gamle tages til diagnosticering på en udstyret arbejdsplads. Men det er endnu ikke alt!
Den diskfrie station bliver betydeligt mere sikker - hvis nogen pludselig bryder ind i lokalet og stjæler alle computerne, er det kun tab af udstyr. Der gemmes ingen data på diskfrie stationer.
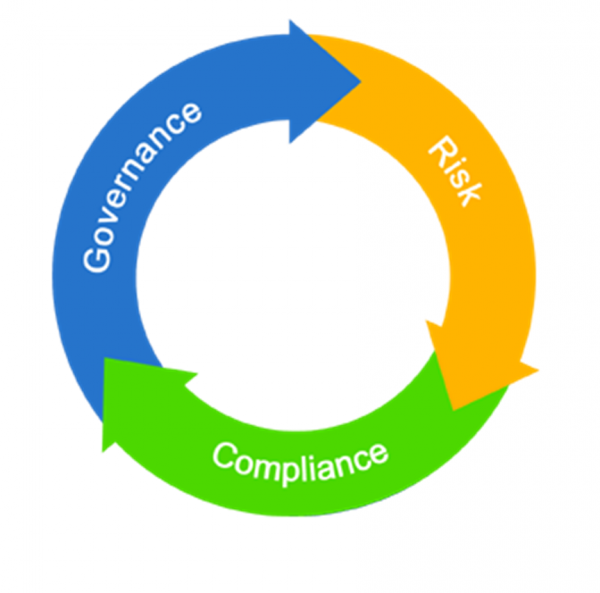
Lad os huske dette øjeblik; informationssikkerhed begynder at spille en stigende rolle efter den “ubekymrede barndom” af informations teknologi. Og i IT bliver de skræmmende og vigtige 3 bogstaver - GRC (Governance, Risk, Compliance), eller på dansk 'Styring, Risiko, Overholdelse'.
Terminalservere
Den udbredte anvendelse af stadig kraftigere personlige computere på kanten har betydeligt overhalet udviklingen af offentlige netværk. Klassiske klient-server applikationer fra 90'erne og tidligt 00'ere fungerede ikke særligt godt over tynde forbindelser, hvis datatransmissionen var nogenlunde betydelig. Dette var især udfordrende for fjerntliggende kontorer, der tilsluttede sig via modem og telefonlinje, som desuden periodisk frøs eller blev afbrudt. Og...
Spiralen har taget en runde og er blevet tilbage til terminaltilstand med konceptet for terminalservere.
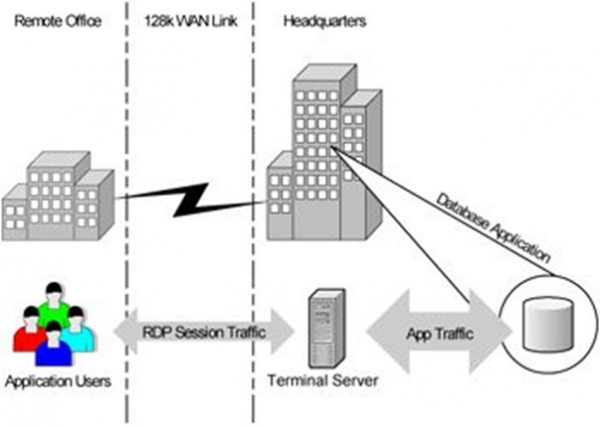
Faktisk er vi tilbage til 70'erne med deres nulklienter og centralisering af regnekraft. Det blev hurtigt klart, at udover rent økonomiske grunde, giver terminaladgang enorme muligheder for at organisere sikker adgang udefra, herunder hjemmearbejde for ansatte, eller ekstremt begrænset og kontrolleret adgang for kontraktarbejdere fra usikre netværk og ukontrollerede enheder.
Men terminalservere, på trods af deres fordele og fremskridt, havde også en række ulemper – lav fleksibilitet, problemet med den støjende nabo, strengt serverbaseret Windows osv.
Fødsel af proto VDI
Reelt set, i begyndelsen og midten af 00'erne, kom industriel virtualisering af x86-platformen for alvor på banen. Og nogen luftede simpelthen den idé, der svømmede i luften: hvad nu hvis vi i stedet for at centralisere alle klienter på server-farmene, gav hver enkelt sin egen personlige VM med klient-Windows og endda administratoradgang?
Afvikling af tykke klienter
Samtidig med virtualisering af sessioner og operativsystemer udviklede en tilgang, der fokuserede på at lette klientfunktionen på applikationsniveau.
Logikken bag dette var ret enkel, for personlige laptops var stadig langt fra at være tilgængelige for alle, internettet var ikke tilgængeligt for alle, og mange kunne kun tilslutte sig fra internetcafeer med meget begrænsede, mildest talt, rettigheder. Faktisk var alt, hvad man kunne køre — en browser. Browseren blev en uundgåelig del af operativsystemet, og internettet kom solidt ind i vores liv.
Med andre ord, der kørte samtidig en tendens til at flytte logikken fra klienten til centret i form af web-applikationer, som krævede det enkleste klient, internet og browser for adgang.
Og vi befandt os ikke bare samme sted, som vi startede – med nul kunder og centrale servere. Vi kom dertil ad flere uafhængige veje.
Virtuel Desktop Infrastruktur
Broker
I 2007 udsendte markedets leder inden for industriel virtualisering, VMware, den første version af deres produkt VDM (Virtual Desktop Manager), som blev det faktiske første på det blot spirende marked for virtuelle desktops. Naturligvis tog det ikke lang tid at få svar fra lederne inden for terminalservere, Citrix, og i 2008, med opkøbet af XenSource, dukkede XenDesktop op. Der var selvfølgelig også andre leverandører med deres tilbud, men lad os ikke gå for dybt ind i historien, da vi bevæger os væk fra konceptet.
Og konceptet er stadig intakt. Den nøglekomponent i VDI er brokerens forbindelser.
Det er netop dette, der er hjertet i infrastrukturen for virtuelle desktops.
Brokerens ansvar dækker over de vigtigste processer i VDI:
- Bestemmer de ressourcer (maskiner/sessioner), der er tilgængelige for den tilsluttede klient;
- Balancerer klienter efter behov mellem puljer af maskiner/sessioner;
- Dirigerer klienten til den valgte ressource.
I dag kan en klient (terminal) til VDI faktisk være alt med en skærm – bærbar computer, smartphone, tablet, kiosk, tynd eller nul-klient. Og den svarende del, som udfører den produktive belastning – terminalserverens session, en fysisk maskine, en virtuel maskine. Moderne, modne VDI-produkter er tæt integreret med den virtuelle infrastruktur og styrer den automatisk ved at implementere eller, omvendt, fjerne unødvendige virtuelle maskiner.
Lidt til siden, men for nogle kunder er det ekstremt vigtigt for VDI-teknologien at have support til hardwareaccelereret 3D-grafik, som er essentiel for ingeniører eller designere.
Protokol
En anden ekstremt vigtig del af et modent VDI-løsning er protokollen til adgang til virtuelle ressourcer. Hvis vi taler om arbejde inden for et virksomheds lokalt netværk med en fremragende pålidelig netværkshastighed på 1 Gbps til arbejdspladsen og en forsinkelse på 1 ms, kan man i princippet vælge enhver protokol og slet ikke tænke mere over det.
Man skal tænke, når forbindelsen går gennem et ukontrolleret netværk, hvor kvaliteten af dette netværk kan variere fra hastigheder på ti kilobit til uforudsigelige forsinkelser. Det er netop til at organisere ægte fjernarbejde fra sommerhuse, fra hjemmet, fra lufthavne og caféer.
Terminalservere vs. klient-VM'er
Da VDI dukkede op, syntes det, at det var tid til at tage afsked med terminalservere. Hvorfor have dem, hvis alle har deres egen personlige VM?
Men set fra et rent økonomisk synspunkt viste det sig, at for typiske, ensartede arbejdspladser, der er ens til at overdrive — er der indtil videre ikke noget mere effektivt end terminalservere med hensyn til pris/session. På trods af alle deres fordele forbruger tilgangen “1 bruger = 1 VM” betydeligt flere ressourcer til virtuel hardware og et fuldt operativsystem, hvilket forringer økonomien for de standardiserede arbejdspladser.
I tilfælde af topchefer, skræddersyede og belastede arbejdspladser, hvor der er behov for at have høje rettigheder (helt op til administrator), har den dedikerede VM per bruger fordelen. Inden for denne VM kan man allokere ressourcer individuelt, tildele rettigheder på alle niveauer og balancere VM'er mellem virtualiseringsværter under høj belastning.
VDI og økonomi
I årevis har jeg hørt det samme spørgsmål — hvordan kan det være, at VDI er billigere end blot at udlevere bærbare til alle? Og i årevis har jeg været nødt til at svare helt det samme: i tilfældet med almindelige kontormedarbejdere er VDI ikke billigere, når man ser på de rene omkostninger ved at sikre udstyr. Uanset hvad, bliver bærbare billigere, mens servere, SAN og systemsoftware koster betydelige penge. Hvis tiden er kommet til at opgradere parken, og du håber at spare penge med VDI — nej, du vil ikke spare.
Jeg nævnte tidligere de frygtelige tre bogstaver GRC — så VDI handler om GRC. Det handler om risikostyring, om sikkerhed og bekvemmeligheden ved kontrolleret adgang til data. Og det hele koster normalt en del penge at implementere på en masse varierende enheder. Med VDI bliver kontrol lettere, sikkerheden øges, og håret bliver blødt og silkeagtigt.
HPE-løsninger til fjernarbejde
Fjern- og cloudstyring
iLO
HPE er bestemt ikke en ny aktør inden for fjernstyring af serverinfrastruktur; det er ingen joke – i marts fyldte det legendariske iLO (Integrated Lights Out) 18 år. Når jeg mindes mine administrativtider i 00'erne, kunne jeg ikke få nok. Den primære installation i rackene og tilslutning af kabler – det var alt, hvad der skulle gøres i det støjende og kolde datacenter. Alt andet konfiguration, inklusive installation af OS, kunne gøres fra arbejdspladsen med to skærme og en kop varm kaffe. Og det var for 13 år siden!
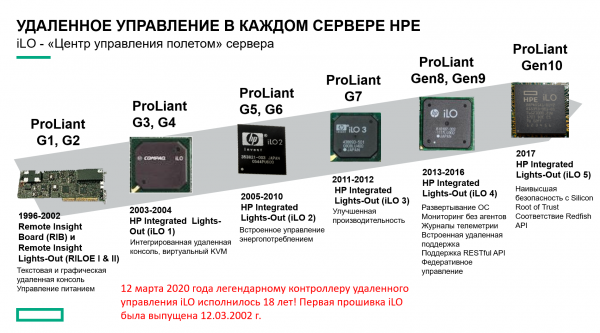
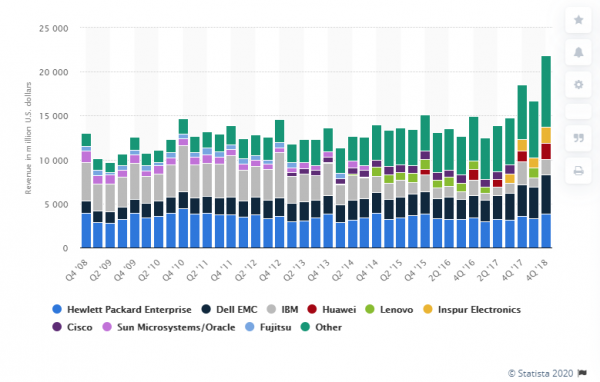
I dag er HPE-servere med god grund en uomtvistelig standard for kvalitet over flere år – og den gyldne standard for fjernstyringssystemet, iLO, spiller en betydelig rolle i dette.
Det er værd at bemærke HPE's indsats for at holde menneskeheden under kontrol i forbindelse med coronavirus. , at licensen til iLO Advanced vil være gratis tilgængelig for alle indtil udgangen af 2020 (i det mindste).
Infosight
Hvis du har mere end 10 servere i din infrastruktur, og administratoren ikke keder sig ihjel, så vil HPE Infosight, en cloud-baseret AI-løsning, være et fremragende supplement til de standard overvågningsværktøjer. Systemet overvåger ikke blot tilstanden og opretter diagrammer, men anbefaler også selvstændigt videre handlinger baseret på den aktuelle situation og tendenser.
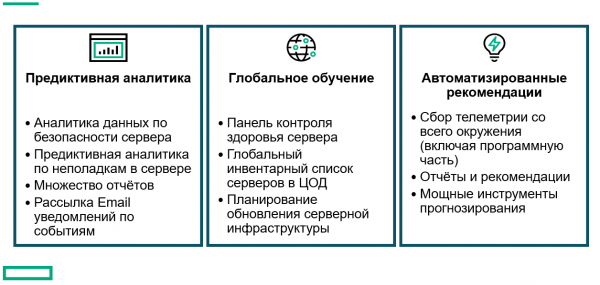
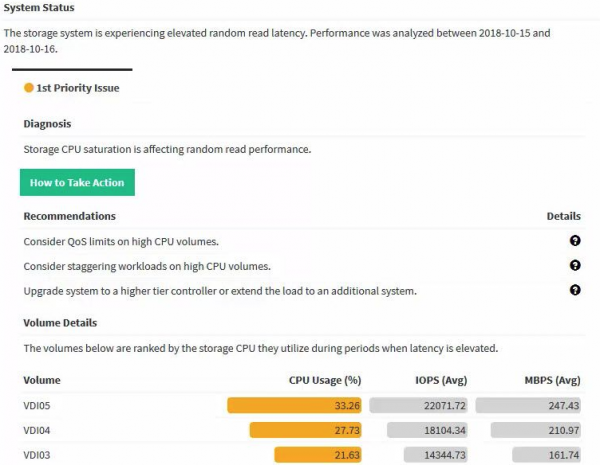
Vær smart, , prøv Infosight!
OneView
Sidst, men ikke mindst, vil jeg nævne HPE OneView – en hel produktportefølje med enorme muligheder for overvågning og styring af hele infrastrukturen. Og alt dette uden at rejse sig fra skrivebordet, som måske i øjeblikket endda befinder sig på et sommerhus.
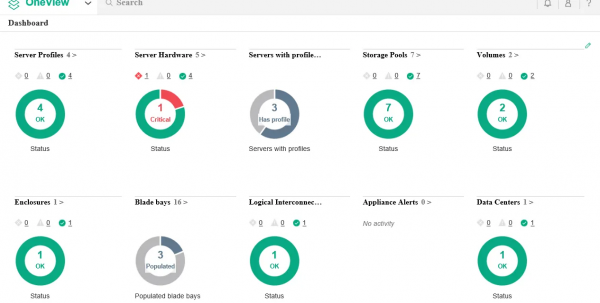
Lagringssystemerne er også ikke til at spøge med!
Selvfølgelig styres og overvåges alle lagringssystemer på afstand – det har været sådan i mange år. Derfor vil jeg i dag tale om noget andet, nemlig metro-klynger.
Metro-klynger er bestemt ikke en nyhed på markedet, men netop derfor er de stadig ikke særlig populære – indlæringskurven og de første indtryk spiller ind. Selvfølgelig eksisterede de allerede for 10 år siden, men de kostede som en jernbro. Årene, der er gået siden de første metro-klynger, har ændret industrien og tilgængeligheden af teknologien for den brede offentlighed.
Jeg husker projekter, hvor dele af SAN blev opdelt — separat til hyperkritiske tjenester i metroklusteret, separat til synkron replikation (til en langt lavere pris).
Reelt set koster metroklusteret dig ingenting i 2020, hvis du kan organisere to steder og forbindelser. Og forbindelserne til synkron replikation er lige præcis de samme som til metroklustre. Licensering af software foregår allerede i pakker — og synkron replikation følger med metroklusteret, og det eneste, der stadig holder liv i ensrettet replikation, er behovet for at organisere et udstrakt L2-netværk. Og selv det, L2 over L3, breder sig hurtigt i landet.
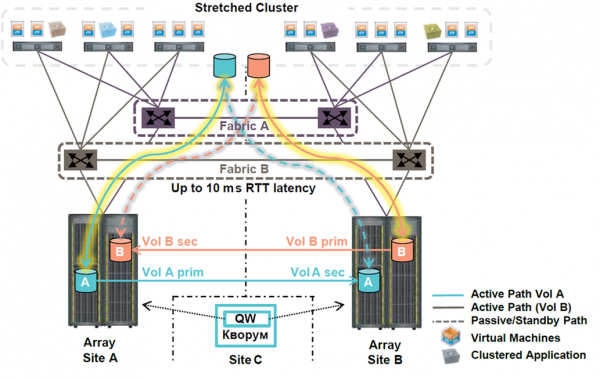
Så hvad er den grundlæggende forskel mellem synkron replikation og metroklusteret set fra remote arbejdssynspunkt?
Det er meget simpelt. Metroklusteret fungerer af sig selv, automatisk, altid, næsten øjeblikkeligt.
Hvordan ser processen for at skifte belastning ved synkron replikation ud på en infrastruktur med mindst et par hundrede VMer?
- Der modtages et signal om en fejl.
- Vagtholdet analyserer situationen — man kan roligt afsætte 10 til 30 minutter blot til at modtage signalet og træffe en beslutning.
- I tilfælde af at de vagthavende ingeniører ikke har myndighed til selvstændigt at igangsætte skiftet — yderligere 30 minutter til at få kontakt med en person, der har myndighed, og formelt bekræfte starten af skiftet.
- Tryk på den Store Røde Knap.
- 10-15 minutter til timeouts og remounting af volumener, genregistrering af VMer.
- 30 minutter til at ændre IP-adressering — det er en optimistisk vurdering.
- Og endelig start af VM og lancering af produktive tjenester.
I alt kan RTO (tid til genopretning af forretningsprocesser) vurderes til cirka 4 timer.
Sammenlignet med situationen i metroklusteret.
- SAN forstår, at forbindelsen til metroklusteret er tabt — 15-30 sekunder.
- Virtualiseringsværterne forstår, at det første datacenter er tabt — 15-30 sekunder (samtidigt med punkt 1).
- Automatisk genstart af halvdelen til en tredjedel af VM'erne i det andet datacenter — 10-15 minutter indtil tjenesterne er online.
- Omtrent på dette tidspunkt forstår vagtholdet, hvad der er sket.
Således: RTO = 0 for individuelle tjenester, 10-15 minutter i almindelighed.
Hvorfor genstart kun for halvdelen til en tredjedel af VM'erne? Se hvad der er galt:
- I kan alle gøre det smart, og aktivere automatisk balance mellem VM'er. Resultatet er, at der i gennemsnit kun køres halvdelen af VM'erne i en af datacentrerne. Essensen af metroklusteret ligger i at minimere nedetid, og derfor er det i jeres interesse at minimere antallet af VM'er, der er i fare.
- Nogle tjenester kan klusteres på applikationsniveau, fordelt på forskellige VM'er. Disse parrede VM'er kan så fastgøres med søm, eller bindes med snor til forskellige datacentre, så tjenesten ikke overhovedet skal vente på genstart af VM'en i tilfælde af en fejl.
Med en velstruktureret infrastruktur med strakte metroklustre arbejder forretningsbrugere med minimale forsinkelser fra enhver placering, selv i tilfælde af en fejl på datacenter-niveau. I værste fald vil forsinkelsen svare til tiden for en kop kaffe.
Og selvfølgelig fungerer metroklustre fremragende både med de ældre HPE 3Par, der bevæger sig mod Valinor, og med de spritnye Primera!
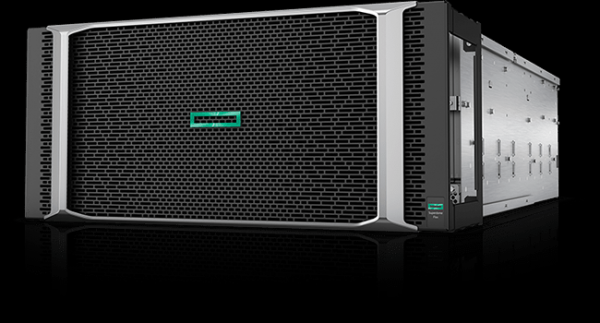
Infrastruktur for fjernarbejdspladser
Terminalservere
For terminalservere er der ikke brug for at finde på noget nyt, HPE har i mange år leveret nogle af de bedste servere i verden til dem. Den tidløse klassiker - DL360 (1U) eller DL380 (2U) eller for AMD-entusiaster - DL385. Selvfølgelig findes der også blade-servere, både de klassiske C7000 og den nye modulære platform Synergy.
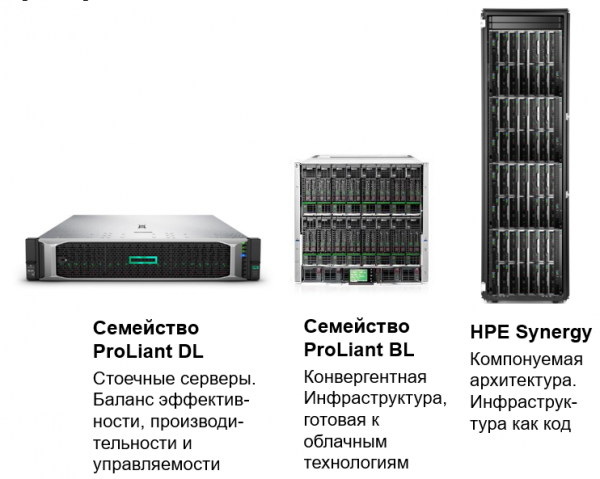
Til enhver smag, i enhver farve, maksimal sessioner pr. server!
“Klassisk” VDI + HPE Simplivity
Når jeg taler om “klassisk VDI”, mener jeg konceptet 1 bruger = 1 VM med desktop Windows. Og selvfølgelig er der ikke noget, der er tættere og mere relateret til VDI-belastninger for hyperkonvergerede systemer, især med deduplikation og komprimering.
Her kan HPE tilbyde både sin egen hyperkonvergerede platform Simplivity og servere / certificerede noder til partnerløsninger, som for eksempel VSAN Ready Nodes til at bygge VDI på VMware VSAN-infrastruktur.
Lad os tale lidt mere om vores eget Simplivity-løsning. I centrum, som navnet blødt antyder, er enkelhed (engelsk simple - enkelt). Enkelheden i implementeringen, enkelheden i styringen, enkelheden i skaleringen.
Hyperkonvergerede systemer er i dag et af de hotteste emner inden for IT, og antallet af leverandører på forskellige niveauer ligger omkring 40. Ifølge Gartners magiske kvadrat er HPE blandt de fem bedste globalt og indgår i ledernes kvadrat — de forstår, hvilken retning industrien bevæger sig, og er i stand til at omsætte denne forståelse til hardware.
Architekturen i Simplivity er et klassisk hyperkonvergeret system med controller-virtuelle maskiner, hvilket betyder, at det kan understøtte forskellige hypervisorer, i modsætning til integrerede systemer. Og faktisk, pr. april 2020, understøttes VMware vSphere og Microsoft Hyper-V, og der er planer om at understøtte KVM. Den vigtigste funktion ved Simplivity siden dens introduktion på markedet har været hardwareaccelerationen af komprimering og deduplikerings ved hjælp af et specielt acceleratorkort.
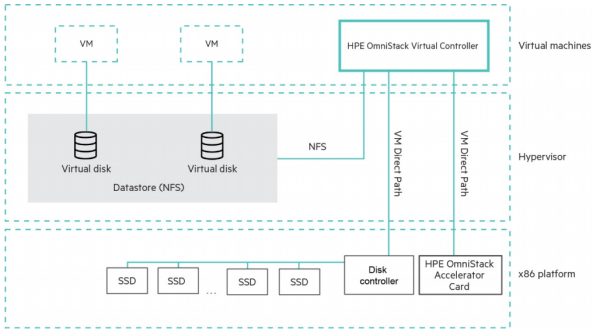
Det skal bemærkes, at komprimering med deduplikerings er globale og konstant aktiverede funktioner, hvilket betyder, at det ikke er en valgfri funktion, men en arkitektonisk del af løsningen.
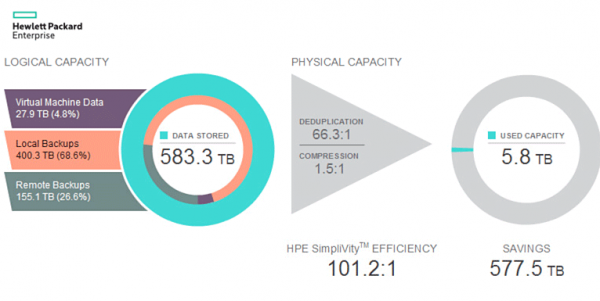
HPE overdriver selvfølgelig lidt, når de hævder en effektivitet på 100:1 baseret på en speciel metode, men effektiviteten af pladsudnyttelse er virkelig meget høj. Tallet 100:1 er ganske enkelt meget tiltalende. Lad os se nærmere på, hvordan Simplivity er teknisk implementeret for at vise sådan nogle tal.
Snapshot. Snapshots (øjebliksbilleder) er 100% korrekt implementeret som RoW (Redirect-on-Write), hvilket betyder, at de sker øjeblikkeligt og ikke medfører nogen præstationsstraffe. I modsætning til hvad der ses i nogle andre systemer. Hvorfor har vi brug for lokale snapshots uden straffe? Det er ret simpelt, for at reducere RPO fra 24 timer (gennemsnitlig RPO for backup) til tiere eller endda få minutter.
Backup. Et snapshot adskiller sig fra en backup kun i måden, hvorpå det opfattes af systemet til administration af virtuelle maskiner. Hvis sletning af en maskine også fjerner alt andet — så var det et snapshot. Hvis noget er tilbage — så er det en backup. På den måde kan ethvert snapshot betragtes som en fuld backup, hvis det mærkes i systemet og ikke slettes.
Selvfølgelig vil mange indvende — hvad er en backup, hvis den opbevares på det samme system? Og her er svaret meget simpelt i form af et spørgsmål: har du en formel trusselmodel, der fastsætter reglerne for backup-opbevaring? Det er en absolut valid backup mod sletning af filer inde i VM'en, det er en backup mod sletning af selve VM'en. I tilfælde af behov for at opbevare en backup udelukkende på et separat system, kan du vælge: replikation af dette snapshot til en anden Simplivity-klynge eller til HPE StoreOnce.
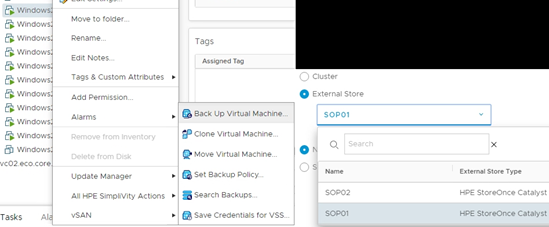
Og netop her viser det sig, at en sådan arkitektur passer perfekt til enhver form for VDI. For VDI er det hundredvis eller endda tusinder af ekstremt ens maskiner med det samme OS og de samme applikationer. Global deduplikation kan bearbejde det hele og komprimere det endda bedre end 100:1. At deployere 1000 VM'er fra en skabelon? Slet ingen problem, disse maskiner vil tage længere tid at registrere i vCenter, end at klone.
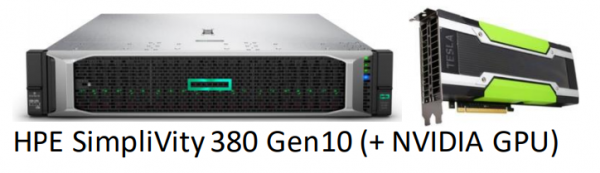
Specielt for brugere med særlige præstationskrav, og for dem, der har brug for 3D-acceleratorer, er serien Simplivity G blevet udviklet.
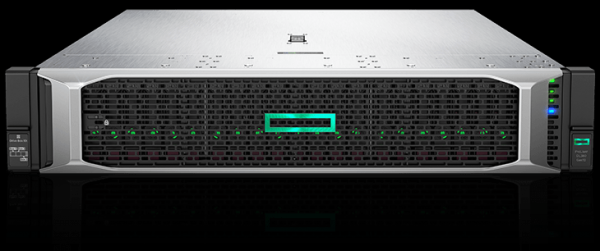
I denne serie anvendes der ikke hardware-acceleratorer til deduplikation, og derfor er antallet af diske pr. node reduceret, så controlleren kan håndtere det softwaremæssigt. Dette frigør PCIe-slots til andre acceleratorer. Derudover er mængden af tilgængelig hukommelse pr. node fordoblet til 3 TB for de mest krævende belastninger.
Simplivity er ideel til at organisere geografisk distribuerede VDI-infrastrukturer med datareplication til det centrale datacenter.
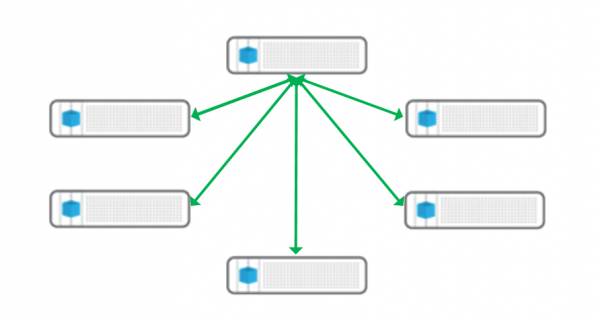
En sådan VDI-arkitektur (og ikke kun VDI) er særligt interessant i lyset af de russiske forhold — enorme afstande (og derved forsinkelser) og langt fra ideelle kanaler. Der oprettes regionale centre (eller endda blot 1-2 Simplivity-noder i et meget fjernt kontor), hvor lokale brugere connectes via hurtige kanaler, og der opretholdes fuld kontrol og styring fra centret, mens der kun replikeres et begrænset antal værdifulde data, ikke affaldsdata, til centret.
Selvfølgelig kan Simplivity fuldt integreres med OneView og InfoSight.
Tynde og nulklienter
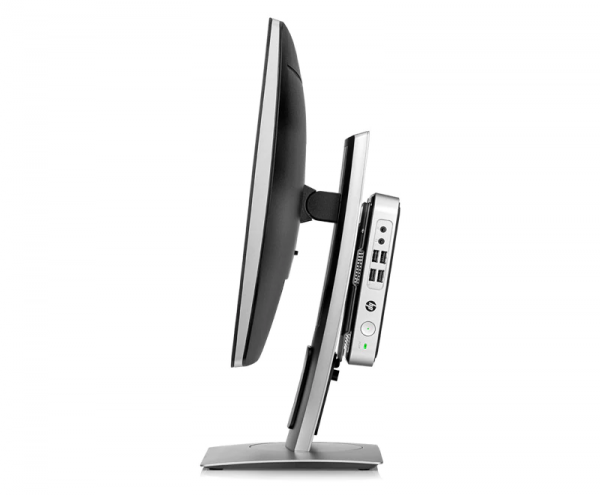
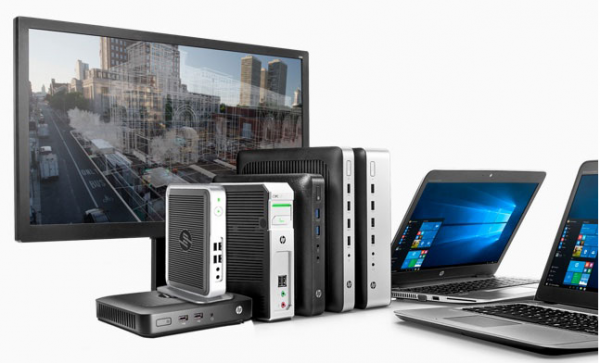
Tynde klienter er specialiserede løsninger designet udelukkende til at fungere som terminaler. Da der praktisk talt ikke er nogen belastning på klienten udover at opretholde kanalen og dekode video, er der næsten altid installeret en passivt kølet processor samt en lille opstartsdisk, kun nødvendig for at starte et specialiseret indlejret styresystem, og egentlig ikke meget mere. Der er meget lidt, der kan gå i stykker, og det giver ingen mening at stjæle fra dem. Prisen er lav, og der gemmes i princippet ingen data.
Der findes en særlig kategori af tynde klienter, såkaldte nulklienter. Deres primære forskel fra tynde klienter er, at de ikke engang har et generelt indlejret styresystem, og arbejder udelukkende med en mikrochip med firmware. Ofte er der installeret specialiserede hardwareacceleratorer til dekodning af videostrømme i terminalprotokoller som PCoIP eller HDX.
På trods af opdelingen af det store 'Hewlett Packard' i separate HPE og HP, kan man ikke undgå at nævne tynde klienter produceret af HP.
Udvalget er bredt, til enhver smag og behov - lige fra arbejdspladser med flere skærme til hardwareaccelereret videostrøm.
HPE-tjenester til dit fjernarbejde
Og sidst men ikke mindst vil jeg nævne HPE-tjenesten. Det ville være for lang tid at opliste alle niveauer af HPE-service og dets muligheder, men der er i det mindste et ekstremt vigtigt tilbud i forhold til fjernarbejde. Nemlig, en serviceingeniør fra HPE/et autoriseret servicecenter. Du fortsætter med at arbejde hjemmefra, fra dit elskede sommerhus, mens du lytter til bierne, mens serviceingeniøren fra HPE ankommer til datacentret for at udskifte diske eller en defekt strømforsyning i dine servere.
HPE CallHome
I nutidens verden, med begrænsninger i bevægelse, er Call Home-funktionen mere relevant end nogensinde. Enhver HPE-system med denne funktion kan automatisk rapportere hardware- eller softwarefejl til HPE supportcenteret. Og det er meget sandsynligt, at en erstatningsdel og/eller en serviceingeniør vil ankomme til dig længe før du opdager problemerne og fejlene med de produktive tjenester.
Jeg anbefaler stærkt at aktivere denne funktion.
Kilde: habr.com
