

Goddag alle!
Mit navn er Nikita, jeg er teamleder for ingeniørteamet hos Cian. En af mine opgaver i virksomheden er at reducere antallet af hændelser relateret til infrastrukturen i produktionen til nul.
Det, vi vil tale om nedenfor, har forårsaget os meget smerte, og formålet med denne artikel er at forhindre andre i at gentage vores fejl eller i hvert fald minimere deres indflydelse.
Præambel
For længe siden, da Cian bestod af monolitter, og der slet ikke var nogen tegn på mikrotjenester, målte vi tilgængeligheden af ressourcen ved at tjekke 3–5 sider.
Hvis de svarede — alt var godt, hvis de ikke svarede i lang tid — alert. Hvor lang tid de skulle være nede for at blive betragtet som en hændelse, blev besluttet af folk på møder. Ingeniørteamet deltager altid i efterforskningen af hændelsen. Når undersøgelsen er afsluttet, skrives en postmortem — en slags rapport på e-mail i formatet: hvad der skete, hvor længe det varede, hvad vi gjorde i øjeblikket, hvad vi vil gøre i fremtiden.
Hovedsiderne på hjemmesiden eller hvordan vi ved, at vi har ramt bunden
For at kunne forstå prioriteten af fejlen, har vi fremhævet de mest kritiske sider for forretningsfunktionen. Ud fra dem tæller vi antallet af succesfulde/ikke-succesfulde anmodninger og timeouts. På den måde måler vi uptime.
Lad os sige, at vi har fastslået, at der er en række supervigtige sektioner af hjemmesiden, der er ansvarlige for den primære service — søgning og indsendelse af annoncer. Hvis antallet af anmodninger, der afsluttes med en fejl, overstiger 1%, er det en kritisk hændelse. Hvis procentdelen af fejl under primetime overstiger 0,1% i løbet af 15 minutter, betragtes dette også som en kritisk hændelse. Disse kriterier dækker størstedelen af hændelserne, øvrige falder uden for denne artikel.
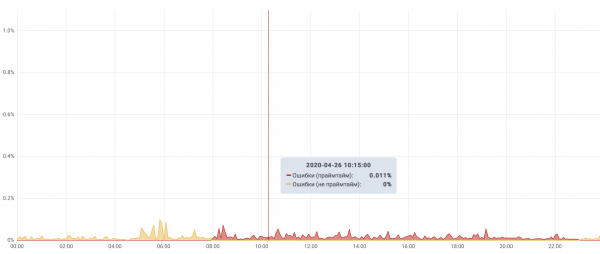
Top bedste hændelser fra Cian
Så vi har helt sikkert lært at bestemme, hvornår en hændelse er sket.
Nu er hver hændelse detaljeret beskrevet og reflekteret i en epik i Jira. For at sige det sådan: vi har startet et separat projekt, kaldte det FAIL — her kan man kun oprette epikker.
Hvis vi samler alle fejlene fra de seneste år, er de dominerende:
- hændelser relateret til mssql;
- hændelser forårsaget af eksterne faktorer;
- administratorfejl.
Lad os se nærmere på administratorfejl samt nogle andre interessante fiaskoer.
Femte plads — "Vi organiserer DNS"
Det var en grå tirsdag. Vi besluttede at organisere DNS-klyngen.
Vi ønskede at migrere interne dns-servere fra bind til powerdns, ved at dedikere fuldstændig separate servere, hvor der ikke er andet end dns.
Vi placerede en dns-server i hver af vores datacenters lokationer, og nu var tiden kommet til at migrere zoner fra bind til powerdns og skifte infrastrukturen til de nye servere.
I den mest hektiske periode af migreringen var der kun én tilbage servere, som var angivet i de lokale cache-bind på alle servere, og den var i datacentret i Sankt Petersborg. Dette datacenter var oprindeligt blevet deklareret som ikke-kritisk for os, men blev pludselig et single point of failure.
Lige i denne migrationsperiode gik forbindelsen mellem Moskva og Sankt Petersborg ned. Vi var faktisk uden DNS i fem minutter og kom op igen, da hoster fejlen blev rettet.
Konklusioner:
Tidligere havde vi overset eksterne faktorer under forberedelserne til arbejdet, men nu medtager vi dem også på listen over, hvad vi forbereder os på. Og nu stræber vi efter, at alle komponenter er reserveret til n-2, og at vi under arbejdet kan sænke dette niveau til n-1.
- Når du laver handlingsplanen, skal du notere punkter, hvor tjenesten kan falde, og tænke på scenarier, hvor alt går "værre end værst", på forhånd.
- Fordel interne dns-servere på forskellige geolokationer/datacentre/rack/switches/indgange.
- Installer en lokal cache dns-server på hver server, som omdirigerer forespørgsler til de primære dns-servere, og i tilfælde af utilgængelighed vil svare fra cachen.
Fjerde plads — "Vi organiserer Nginx"
En skøn dag besluttede vores team, at "nu er det nok", og processen med at refaktorere nginx-konfigurationerne blev iværksat. Hovedmålet er at give konfigurationerne en intuitiv struktur. Tidligere var alt "historisk opstået" og havde ingen logik i sig. Nu har vi flyttet hver server_name til en tilsvarende fil og kategoriseret alle konfigurationer i mapper. For at sige det mildt — konfigurationen indeholder 253949 linjer eller 7836520 tegn og fylder næsten 7 megabyte. Øverste niveau af strukturen:
Nginx-struktur
├── adgang
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Det blev markant bedre, men under omdøbning og fordeling af konfigurationer havde nogle af dem forkerte filendelser og kom ikke ind i direktivet include *.conf. Som følge heraf blev nogle hosts utilgængelige og returnerede 301 til forsiden. Fordi svarkoden ikke var 5xx/4xx, blev det ikke opdaget med det samme, men først tidligt om morgenen. Derefter begyndte vi at skrive tests til kontrol af infrastrukturkomponenterne.
Konklusioner:
- Strukturer konfigurationerne korrekt (ikke kun nginx) og overvej strukturen tidligt i projektet. Det vil gøre dem mere forståelige for teamet, hvilket i sin tur vil reducere TTM.
- Skriv tests for nogle infrastrukturkomponenter. For eksempel: kontrol, at alle nøgle server_name returnerer den korrekte status, + svarindholdet. Det er tilstrækkeligt at have bare et par scripts, der kontrollerer de grundlæggende funktioner af komponenten, så man ikke nervøst skal huske, hvad man ellers skal tjekke klokken 3 om natten.
Tredje plads — "Pludselig var der ikke mere plads i Cassandra"
Dataene voksede støt, og alt var fint, indtil klustret Cassandra begyndte at fejle ved reparation af store keyspaces, fordi det ikke kunne gennemføre compaction.
På en dyster dag næsten forvandlede klustret sig til et græskar, nemlig:
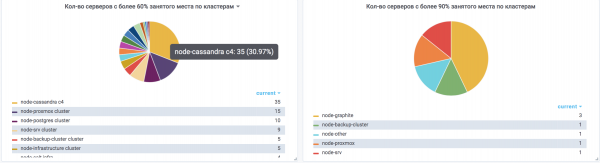
- der var ca. 20% plads tilbage i hele klustret;
- det var ikke muligt at tilføje noder ordentligt, fordi cleanup ikke kunne gennemføres efter tilføjelsen af en node på grund af pladsmangel på partitionerne;
- ydelsen falder lidt, fordi compaction ikke virker;
- klustret kører i nødtilstand.
Udgangen — vi har tilføjet fem ekstra noder uden cleanup, hvorefter vi begyndte systematisk at fjerne dem fra klyngen og genindsætte dem som tomme noder, hvor der ikke var plads tilbage. Tiden brugt hertil har været betydeligt mere, end vi ønskede. Der var en risiko for delvis eller total utilgængelighed af klyngen.
Konklusioner:
- På alle servere må cassandra ikke have mere end 60% af pladsen optaget i hver partition.
- De må ikke være mere end 50% belastet på CPU.
- Man bør ikke overse kapacitetsplanlægning, og det skal overvejes for hver komponent ud fra dens specifikation.
- Jo flere noder i klyngen, desto bedre. Servere med små datamængder genopretter hurtigere, og en sådan klynge er lettere at genoplive.
Andet sted — «Data forsvandt fra consul key-value storage»
Til service discovery bruger vi, ligesom mange, consul. Men vi bruger også dens key-value til blue-green deployment af monoliten. Her opbevares oplysninger om aktive og inaktive upstreams, som udskiftes under deployment. Der blev skrevet en deploy-service, som interagerede med KV. På et tidspunkt forsvandt dataene fra KV. Vi genskabte det fra hukommelsen, men med en række fejl. Som følge heraf blev belastningen på upstreams ikke fordelt jævnt under deployment, og vi fik mange 502-fejl på grund af overbelastning af backendene på CPU. I sidste ende flyttede vi fra consul KV til postgres, hvorfra det ikke er så nemt at slette dem.
Konklusioner:
- Tjenester uden nogen form for autentifikation må ikke indeholde kritiske data, der er nødvendige for webstedets funktion. For eksempel, hvis du ikke har autentifikation i ES — er det bedst at forhindre adgang på netværksniveau fra alle steder, hvor det ikke er nødvendigt, kun lade de nødvendige være, samt at gøre action.destructive_requires_name: true.
- Arbejd med mekanismen for backup og genopretning på forhånd. For eksempel, lav et script (for eksempel på python), der kan både tage backup og genoprette.
Første sted — «Kaptajn åbenbarhed»
På et tidspunkt bemærkede vi en ujævn fordeling af belastningen på nginx upstreams, når der var 10+ servere i backend. Da round-robin dirigerede anmodninger fra den første til den sidste upstream i rækkefølge, og hver genstart af nginx startede forfra, fik de første upstreams altid flere anmodninger end de andre. Som følge heraf arbejdede de langsommere, hvilket påvirkede hele hjemmesiden. Dette blev stadig mere tydeligt i takt med, at trafikmængden steg. At opdatere nginx for at inkludere random løste ikke problemet — vi skulle genarbejde en masse lua-kode, der ikke fungerede på version 1.15 (på det tidspunkt). Vi endte med at patch vores nginx 1.14.2 og indføre understøttelse af random. Dette løste problemet. Denne fejl vinder prisen for 'kaptejn uvidenhed'.
Konklusioner:
Det var meget interessant og spændende at undersøge denne fejl).
- Organiser overvågningen, så den hurtigt hjælper med at finde sådanne flingeringer. For eksempel kan man bruge ELK til at overvåge rps på hver backend af hver upstream og følge deres svartider set fra nginx. I dette tilfælde hjalp det os med at identificere problemet.
De fleste fejl kunne være undgået med en mere omhyggelig tilgang til det, man laver. Man skal altid huske på Murphys lov: Anything that can go wrong will go wrong, og bygge komponenterne med det i mente.
Kilde: habr.com
