

I denne artikel vil jeg fortælle om en situation, der for nylig opstod med en af vores VPS-servere, som satte mig på prøve i flere timer. Jeg har arbejdet med konfiguration og fejlretning af Linux-servere i cirka 15 år, men denne situation passede slet ikke ind i min erfaring — jeg lavede nogle fejlagtige antagelser og blev en smule fortvivlet, før jeg korrekt kunne identificere årsagen til problemet og løse det.
Præambel
Vi driver et mellemstort cloud-miljø, som vi bygger på standardservere med følgende konfiguration — 32 kerner, 256 GB RAM og en PCI-E NVMe Intel P4500 med en kapacitet på 4TB. Vi er meget begejstrede for denne konfiguration, da den gør, at vi ikke behøver at tænke på IO-mangel, samtidig med at den sikrer korrekt begrænsning på niveauet for VM-instans typer. Da NVMe Intel har imponerende ydeevne, kan vi samtidig sikre, at både fuld IOPS-udlevering er tilgængelig for maskinerne og backup af lageret på backupserveren med nul IOWAIT.
Vi er blandt de traditionelle serverfolk, der ikke bruger hyperkonvergeret SDN og andre moderne, trendy ting til opbevaring af VM-volumener, idet vi mener, at jo enklere systemet er, desto nemmere er det at fejlfinde i situationer, hvor "den store guru er taget til bjergene". Derfor opbevarer vi VM-volumener i QCOW2-format på XFS eller EXT4, der er implementeret oven på LVM2.
Brugen af QCOW2 påtvinges os også af det produkt, vi bruger til orkestrering — Apache CloudStack.
For at udføre backup tager vi et fuldt billede af volumen som et LVM2-snapshot (ja, vi ved, at LVM2-snapshots kan være langsomme, men Intel P4500 redder os her). Vi laver lvmcreate -s .. og sender backupen til en fjernserver med ZFS-lager. Her er vi dog en smule progressive — ZFS kan stadig opbevare data i komprimeret form, og vi kan hurtigt gendanne dem ved hjælp af dd eller hente individuelle VM-volumener med DD mount -o loop ... Man kan selvfølgelig tage et ikke-fuldt billede af LVM2-volumenet og montere filsystemet i.
RO
ROog kopierer selve QCOW2-billederne, men vi har oplevet, at XFS dermed blev problematisk, ikke straks, men uforudsigeligt. Vi bryder os virkelig ikke om, når hypervisor-hosts pludselig "hænger" i weekenden, om natten eller på helligdage på grund af fejl, der kan opstå på ubestemte tidspunkter. Derfor bruger vi ikke snapshotsmontering i XFS-modus,ROfor at trække volumener, men kopierer blot hele LVM2-volumenet.
Hastigheden for sikkerhedskopiering til backupserveren bestemmes i vores tilfælde af backupserverens ydeevne, som ligger omkring 600-800 MB/s for usorterede data, den næste begrænsning er 10Gbit/s-kanalen, som backupserveren er tilsluttet klyngen med.
På én gang uploader backupserveren samtidig sikkerhedskopier fra 8 servere hypervisorer. Derved forhindrer serverens disk- og netværkssystemer, som er langsommere, at overbelaste diskunderstøttelsen på hypervisor-hosts, da de simpelthen ikke kan håndtere, lad os sige, 8 GB/s, som hypervisor-hosts ubesværet kan afgive.
Den ovenfor beskrevne kopieringsproces er meget vigtig for den videre fortælling, inklusive detaljer - brug af den hurtige Intel P4500-lager, brug af NFS og sandsynligvis brug af ZFS.
Historien om sikkerhedskopiering
På hver hypervisor-node har vi en lille SWAP-partition på 8 GB, og selve hypervisor-noden "rulles ud" med hjælp af DD den referencebillede. Til systemvolumen på serverne bruger vi 2xSATA SSD RAID1 eller 2xSAS HDD RAID1 på en hardwarekontroller fra LSI eller HP. Generelt er det os helt ligegyldigt, hvad der er indeni, da systemvolumenet arbejder i "næsten readonly"-tilstand, bortset fra SWAP. Og da vi har meget RAM på serveren, som er 30-40% ubenyttet, tænker vi ikke på SWAP.
Processen med at oprette en sikkerhedskopi. Denne opgave ser cirka sådan ud:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Bemærk venligst ionice -c3, i virkeligheden er denne ting helt ubrugelig for NVMe-enheder, da IO-planlæggeren for dem er indstillet til:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Men vi har en række legacy-noder med almindelige SSD RAID, for dem er det relevant, så det flyttes AS IS. Generelt er det bare et interessant stykke kode, der forklarer nytteløsheden af ionice i tilfælde af en sådan konfiguration.
Vær opmærksom på flaget iflag=direct for DDVi bruger direct IO direkte uden buffer cache for at undgå unødvendige buffer udskiftninger ved læsning. Men, oflag=direct vi gør ikke det, da vi har oplevet præstationsproblemer med ZFS ved brug af dette.
Denne metode har vi med succes anvendt i flere år uden problemer.
Og så begyndte det… Vi fandt ud af, at backupen for en af noderne ikke længere kørte, mens den forrige kørte med monstrøse IOWAIT på næsten 50%. Da vi forsøgte at forstå, hvorfor backupen ikke fungerede, stødte vi på fænomenet:
Volume group "images" not foundVi begyndte at tænke over "end of the line for Intel P4500", men før vi kunne slukke serveren for at erstatte disken, var det nødvendigt at udføre backupen alligevel. Vi reparerede LVM2 ved at genoprette metadataene fra LVM2 backup:
vgcfgrestore imagesVi startede backupen og så denne rædsel:
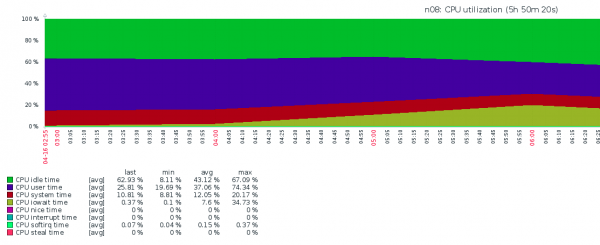
Vi blev igen meget triste - det var klart, at sådan kan vi ikke fortsætte, da alle VPS'er ville lide, og det betød, at vi ville lide. Hvad der skete, var helt uforståeligt - iostat viste ynkelige IOPS og ekstremt højt IOWAIT. Ideer, bortset fra "lad os erstatte NVMe", var ikke til stede, men der kom lige i tide en indsigt.
Analyse af situationen trin for trin
Historisk log. Et par dage før krævede denne server at oprette en stor VPS med 128 GB RAM. Det så ud til, at der var nok hukommelse, men for en sikkerheds skyld tildelte vi yderligere 32 GB til swap-partitionen. VPS'en blev oprettet, løste sin opgave med succes, og hændelsen blev glemt, mens SWAP-partitionen forblev.
Konfigurationsspecifikationer. For alle cloud-servere var parameteren vm.swappiness satt til standardværdien 60. Og SWAP blev oprettet på SAS HDD RAID1.
Hvad der skete (ifølge redaktionen). Ved backupen DD gik der mange data til skrivning, som blev placeret i RAM-buffere, før de blev skrevet til NFS. Systemets kerne, guidet af politikken swappiness, flyttede mange hukommelsessider fra VPS til swapområdet, der var på den langsomme HDD RAID1-volumen. Dette førte til, at IOWAIT voksede kraftigt, men ikke på grund af IO fra NVMe, men på grund af IO fra HDD RAID1.
Hvordan problemet blev løst. Swap-partitionen på 32GB blev deaktiveret. Det tog 16 timer, og om hvordan og hvorfor SWAP deaktiveres så langsomt, kan du læse separat. Der blev ændret parametre swappiness til en værdi lig med 5 i hele skyen.
Hvordan kunne dette skeFor det første, hvis SWAP havde været på SSD RAID eller NVMe-enhed, og for det andet, hvis der ikke havde været en NVMe-enhed, men en langsommere enhed, der ikke kunne levere så meget data — ironisk nok opstod problemet, fordi NVMe var for hurtigt.
Efter dette fungerede alt som før — med nul IOWAIT.
Kilde: habr.com
