

Hej alle sammen. Vi udvikler et produkt til analyse af offline-trafik. I projektet er der en opgave, der relaterer til statistisk analyse af besøgendes bevægelser mellem områder.
I denne opgave kan brugerne stille systemet forespørgsler som følgende:
- hvor mange besøgende er gået fra område "A" til område "B";
- hvor mange besøgende er gået fra område "A" til område "B" gennem område "C" og derefter gennem område "D";
- hvor lang tid det tog for en bestemt type besøgende at bevæge sig fra område "A" til område "B".
og en række lignende analytiske forespørgsler.
Bevægelsen af besøgende mellem områder udgør en rettet graf. Efter at have læst på internettet, fandt jeg ud af, at grafdatabaser også bruges til analytiske rapporter. Jeg fik lyst til at se, hvordan sådanne forespørgsler ville blive håndteret af grafdatabaser (TL;DR; dårligt).
Jeg valgte at bruge databasen , som en fremtrædende repræsentant for grafbaserede open-source databaser, der bygger på et stak af modne teknologier, som (efter min mening) burde give den decent driftspræstation:
- backend-lageret BerkeleyDB, Apache Cassandra, Scylla;
- komplekse indekser kan opbevares i Lucene, Elasticsearch, Solr.
Forfatterne af JanusGraph skriver, at den er velegnet til både OLTP og OLAP.
Jeg har arbejdet med BerkeleyDB, Apache Cassandra, Scylla og ES, desuden bruges disse produkter ofte i vores systemer, så jeg så optimistisk frem til at teste denne grafdatabase. Jeg fandt valget af BerkeleyDB, frem for RocksDB, mærkeligt, men det skyldes sandsynligvis transaktionskravene. Under alle omstændigheder anbefales det at bruge backend på Cassandra eller Scylla til skalerbar, produktiv anvendelse.
Jeg overvejede ikke Neo4j, da clusterings kræver en kommerciel version, hvilket betyder, at produktet ikke er åbent.
Grafdatabaser siger: "Hvis noget ser ud som en graf - så behandler det som en graf!" – smukt!
Først lavede jeg en graf, som virkelig var lavet efter grafdatabasernes kanoner:
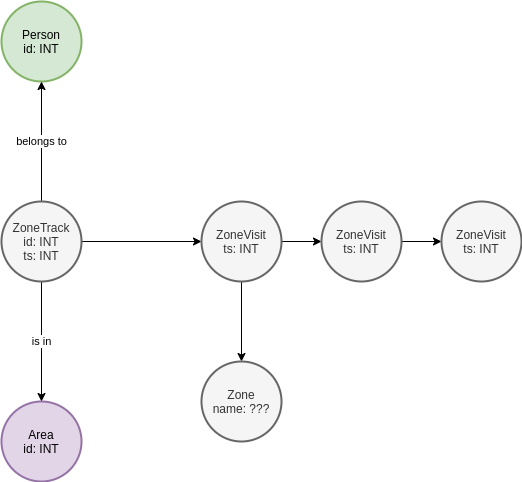
Der er en entitet Zone, som står for området. Hvis ZoneStep tilhører denne Zone, så henviser den til den. Om entiteten Area, ZoneTrack, Person skal du ikke lægge mærke til, de tilhører domænet og betragtes ikke i testen. Samlet set ville en forespørgsel til denne grafstruktur se ud som:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Oversat til dansk: find Zone med ID=0, tag alle de noder, som har en kant (ZoneStep) til hende, fortsæt videre uden at vende tilbage, indtil du finder sådanne ZoneStep, som har en kant til Zone med ID=19, og tæl antallet af sådanne kæder.
Jeg påstår ikke at vide alle nuancerne ved at søge i grafer, men denne forespørgsel blev genereret ud fra denne bog ().
Jeg har indlæst 50.000 tracks, der varierer fra 3 til 20 punkter i en grafdatabase JanusGraph, der bruger BerkeleyDB som backend, og jeg har oprettet indekser i henhold til .
Script til indlæsning på Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Der blev anvendt en VM med 4 kerner og 16 GB RAM på SSD. JanusGraph blev implementeret med denne kommando:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestI dette tilfælde opbevares dataene og indekserne, der bruges til at søge efter en nøjagtig match, i BerkeleyDB. Ved at udføre den tidligere nævnte forespørgsel fik jeg en tid svarende til flere titalls sekunder.
Ved at køre de 4 ovennævnte scripts parallelt, lykkedes det mig at forvandle databasen til et græskar med en sjov strøm af Java-stakspor (og vi elsker alle at læse Java-stakspor) i Docker-loggene.
Efter at have tænkt over det, besluttede jeg at forenkle grafens struktur til følgende:
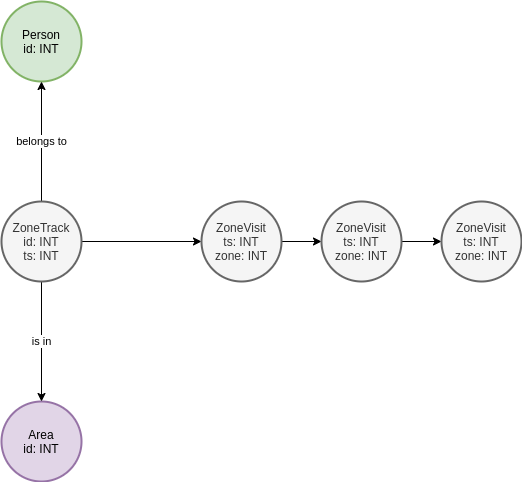
Da jeg besluttede, at søgning efter enhedens attributter ville være hurtigere end at søge efter kanter. I sidste ende blev min forespørgsel til følgende:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Oversat til dansk: find ZoneStep med ID=0, fortsæt uden at vende tilbage, indtil du finder ZoneStep med ID=19, og tæll antallet af sådanne kæder.
Jeg har også forenklet indlæsningsscriptet ovenfor for ikke at oprette unødvendige forbindelser, kun ved at begrænse mig til attributterne.
Forespørgslen tog stadig flere sekunder, hvilket var helt uacceptabelt for vores opgave, da det slet ikke var egnet til formålene for AdHoc forespørgsler af vilkårlig art.
Jeg prøvede at implementere JanusGraph ved hjælp af Scylla, som er den hurtigste implementering af Cassandra, men det førte heller ikke til nogen væsentlige ændringer i ydeevnen.
Så selvom "det ser ud som et graf", lykkedes det ikke mig at få den grafbaserede database til at behandle dette hurtigt. Jeg formoder, at jeg ikke kender til noget, og man kan få JanusGraph til at udføre denne forespørgsel på brøkdele af et sekund, men det lykkedes mig ikke.
Da opgaven stadig skulle løses, begyndte jeg at tænke på JOINs og pivot-tabeller, hvilket ikke gav optimisme med hensyn til elegance, men det kunne sagtens være en praktisk løsning.
I vores projekt bruger vi allerede Apache ClickHouse, så jeg besluttede at teste mine undersøgelser på denne analytiske database.
Jeg implementerede ClickHouse med en simpel opskrift:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Jeg oprettede en database og en tabel som følger:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Jeg fyldte den med data ved hjælp af følgende script:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Da indsættelserne foregår i batches, var udfyldningen meget hurtigere end med JanusGraph.
Jeg konstruerede to forespørgsler med JOIN. For at gå fra punkt A til punkt B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
For at gå gennem 3 punkter:
VÆLG s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FRA
  (VÆLG s1.person SOM person,
          s1.zone SOM s1z,
          s1.when SOM s1w,
          s2.zone SOM s2z,
          s2.when SOM s2w
   FRA
     (VÆLG *
      FRA steps
      HVOR (område = 0)
        OG (zone = 0)) SOM s1 HVER ANY INNER JOIN
     (VÆLG *
      FRA steps SOM s2
      HVOR (område = 0)
        OG (zone = 3)) SOM s2 BRUGER person
   HVOR s1.when <= s2.when) p HVER ANY INNER JOIN
  (VÆLG *
   FRA steps
   HVOR (område = 0)
     OG (zone = 19)) SOM s3 BRUGER person
HVOR p.s2w <= s3.when
Forespørgsler ser naturligvis ret skræmmende ud, og til reel brug kræves der en programmeringsindpakning-generator. Dog fungerer de, og de fungerer hurtigt. Både den første og anden forespørgsel udføres på mindre end 0,1 sek. Her er et eksempel på udførelsestid for forespørgslen for count(*) over 3 punkter:
VÆLG count(*)
FRA
(
    VÆLG
        s1.person SOM person,
        s1.zone SOM s1z,
        s1.when SOM s1w,
        s2.zone SOM s2z,
        s2.when SOM s2w
    FRA
    (
        VÆLG *
        FRA steps
        HVOR (område = 0) OG (zone = 0)
    ) SOM s1
    HVER ANY INNER JOIN
    (
        VÆLG *
        FRA steps SOM s2
        HVOR (område = 0) OG (zone = 3)
    ) SOM s2 BRUGER (person)
    HVOR s1.when <= s2.when
) SOM p
HVER ANY INNER JOIN
(
    VÆLG *
    FRA steps
    HVOR (område = 0) OG (zone = 19)
) SOM s3 BRUGER (person)
HVOR p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 række i sættet. Forløbet: 0.068 sek. Behandlede 250.03 tusind rækker, 8.00 MB (3.69 millioner rækker/s., 117.98 MB/s.)Bemærkning om IOPS. Under udfyldning af data genererede JanusGraph et ret højt antal IOPS (1000-1300 for fire datafyldningsstrømme), mens IOWAIT var ret høj. Samtidig genererede ClickHouse minimal belastning på diskunderstøttelsen.
Konklusion
Vi valgte at bruge ClickHouse til at håndtere forespørgsler af denne slags. Vi kan altid optimere forespørgslerne yderligere ved hjælp af materialiserede visninger og parallelisering, og ved at udføre forbehandling af begivenhedsstrømmen ved hjælp af Apache Flink, før vi indlæser dem i ClickHouse.
Ydelsen er så god, at vi sandsynligvis ikke engang behøver at tænke på at lave pivot-tabeller programmatisk. Tidligere var vi nødt til at lave pivoter af data, som blev udtrukket fra Vertica via eksport til Apache Parquet.
Desværre blev endnu et forsøg på at bruge en grafdatabase ikke en succes. Jeg fandt ikke, at JanusGraph havde et brugervenligt økosystem, som gør det muligt hurtigt at sætte sig ind i produktet. Desuden anvendes den traditionelle Java-way til konfiguration af serveren, hvilket vil få folk uden Java-kendskab til at græde blodtårer:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary er her for at erstatte Gryo og Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo og Graphson, seneste versioner
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Ældre serialiseringsversioner for bagudkompatibilitet:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Jeg fik ved et tilfælde "lagt" BerkeleyDB versionen af JanusGraph.
Dokumentationen er ret mangelfuldt med hensyn til indekser, da administration af indekser kræver ret mærkelige besværgelser i Groovy. For eksempel skal oprettelsen af en indeks udføres ved at skrive kode i Gremlin-konsollen (som i øvrigt ikke virker ud af boksen). Fra den officielle JanusGraph-dokumentation:
graph.tx().rollback()
// Afsættes aldrig nye indekser, mens en transaktion er aktiv
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

// Vent på, at indeksen bliver tilgængelig
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
// Genindekser eksisterende data
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Efterord
På en måde er det eksperiment ovenfor en sammenligning mellem æbler og pærer. Overvejer man det, udfører en grafdatabase andre operationer for at opnå de samme resultater. Men i løbet af testene udførte jeg også et eksperiment med en forespørgsel af typen:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
, som afspejler trinadgang. Men selv på sådanne data viste grafdatabasen også resultater, der oversteg nogle sekunder... Dette, selvfølgelig, skyldes, at der var stier af typen 0 -> X -> Y ... -> 1, som grafmotoren også kontrollerede.
Selv for en forespørgsel af typen:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()kunne jeg ikke få et effektivt svar med en behandlingstid under et sekund.
Moralen i historien er, at en smuk idé og paradigmatisk modellering ikke fører til det ønskede resultat, som med betydeligt højere effektivitet demonstreres på eksemplet ClickHouse. Den anvendelse, der nævnes i denne artikel, er et klart antipattern for grafdatabaser, selvom det ser ud til at være passende til modellering i deres paradigme.
Kilde: habr.com
