

Lad mig straks forklare titlen på artiklen. Det blev oprindeligt planlagt at give et godt, pålideligt råd om, hvordan man kan accelerere brugen af refleksion med et simpelt, men realistisk eksempel, men under benchmarkingen viste det sig, at refleksion ikke fungerede så langsomt, som jeg troede, mens LINQ var langsommere, end jeg kunne drømme om i mareridt. Og til sidst viste det sig, at jeg også havde begået en fejl i målingerne... Detaljerne om denne livshistorie ligger under indlægget og i kommentarerne. Da eksemplet er ret almindeligt og udført som det plejer at blive i enterprise, synes jeg, det er en interessant demonstration af livets realiteter: indflydelsen på hastigheden af det centrale emne for artiklen var ikke bemærkelsesværdig på grund af den eksterne logik: Moq, Autofac, EF Core og anden "omkringlæggende" kode.
Jeg begyndte arbejdet under indtryk af denne artikel:
Som det fremgår, foreslår forfatteren at bruge kompilere delegerede i stedet for direkte at få adgang til metode i refleksionstyperne som en fremragende måde at accelerere applikationen betydeligt. Der er også IL-udsendelse der, men jeg ville helst undgå den, da det er den mest ressourcekrævende måde at løse opgaven på, og det er forbundet med fejl.
Da jeg altid har haft en lignende mening om refleksionshastigheden, havde jeg ikke til hensigt at stille spørgsmålstegn ved forfatterens konklusioner.
Jeg møder ofte naiv brug af refleksion i enterprise. En type tages. Der tages information om en egenskab. Metoden SetValue kaldes, og alle er glade. Værdien kommer ind i det tilsigtede felt, og alle er tilfredse. Folk er ikke dumme – seniorer og teamledere – de skriver deres udvidelser til objektet, baseret på en sådan naiv implementering af "universelle" mapper fra én type til en anden. Essensen er normalt: vi tager alle felter, vi tager alle egenskaber, itererer over dem: ved match af medlemmenes navne udfører vi SetValue. Periodisk fanger vi undtagelser på samme steder, hvor vi ikke fandt en egenskab i en af typerne, men der er også en løsning her, der kompensere for ydeevnen. Try/catch.
Jeg har set folk genskabe parsere og mapper uden at have fuld forståelse for, hvordan de tidligere opfundne cykler fungerer. Jeg har set folk skjule deres naive implementeringer bag strategier, interfaces og injektioner, som om dette ville tilgive den efterfølgende kaos. Jeg har vendt ansigtet bort fra sådanne implementeringer. Faktisk har jeg ikke målt den reelle ydeevne, og når jeg havde mulighed for det, ændrede jeg bare implementeringen til en mere 'optimal', hvis jeg fik tid. Så de første målinger, som diskuteres nedenfor, overraskede mig alvorligt.
Jeg tror, mange af jer, når I læser Richter eller andre ideologer, er stødt på den retfærdige påstand, at refleksion i koden er et fænomen, der har en yderst negativ indvirkning på applikationens performance.
Kaldet til refleksion tvinger CLR til at gennemgå assembly’er for at finde den ønskede, trække deres metadata, parse dem osv. Derudover fører refleksion under iteration af sekvenser til tildeling af store mængder hukommelse. Når vi bruger hukommelse, aktiverer CLR GC, og herefter får vi ryk. Dette burde være mærkbart langsomt, tro mig. Store mængder hukommelse på moderne produktionsservere eller cloudmaskiner redder ikke fra høje forsinkelser i behandlingen. Faktisk, jo mere hukommelse, jo større sandsynlighed for, at du LÆGGER MÆRKE TIL, hvordan GC arbejder. Refleksion er i teorien en unødvendig rød klud for det.
Alligevel bruger vi alle IoC-containere og datamappere, hvis arbejdsprincip også er baseret på refleksion, men der er som regel ikke spørgsmål ved deres ydeevne. Nej, ikke fordi afhængighedsinjektion og abstraktion fra modeller i en begrænset ekstern kontekst er så nødvendige, at vi er nødt til at ofre performance i enhver situation. Det er simpelthen lettere – det har ikke den store indvirkning på ydeevnen.
Sagen er den, at de mest udbredte rammer, der er baseret på refleksionsteknologi, bruger forskellige tricks til at arbejde mere optimalt med den. Normalt er det caching. Ofte er det Expressions og delegerede, der er compilere fra et udtrykstræ. Den samme automapper har et concurrent dictionary, der knytter typer til funktioner, der kan konvertere hinanden uden at kalde refleksion.
Hvordan opnås dette? I bund og grund adskiller det sig ikke fra den logik, som platformen selv bruger til at generere JIT-kode. Ved den første kald af metoden bliver den kompileret (og ja, denne proces er ikke hurtig), mens kontrol ved efterfølgende kald overføres til den allerede kompilerede metode, og her vil der ikke være nogen væsentlige fald i ydelsen.
I vores tilfælde kan vi også benytte JIT-kompilering og derefter bruge den kompilerede adfærd med samme ydelse som dens AOTÆkvivalenter. I denne forbindelse vil udtryk være til hjælp for os.
Kort sagt kan princippet, vi taler om, opsummeres som følger:
Det anbefales at cache det endelige resultat af refleksionens arbejde i form af en delegat, der indeholder den kompilerede funktion. Alle nødvendige objekter med oplysninger om typer bør også caches i felterne uden for objekterne af din type – arbejder.
Der er logik i det. Sund fornuft siger os, at hvis noget kan kompileres og caches, så bør det gøres.
For at se fremad skal det siges, at cache i arbejdet med refleksion har sine fordele, selv når man ikke bruger den foreslåede metode til at kompilere udtryk. Egentlig vil jeg her gentage forfatterens pointer fra artiklen, jeg henviser til ovenfor.
Nu til koden. Lad os se på et eksempel, der er baseret på min nylige udfordring, jeg stod overfor i en seriøs produktion for en stor kreditinstitution. Alle enheder er opdigtede for at undgå genkendelse.
Der er en bestemt enhed. Lad os kalde den Contact. Der er e-mails med et standardiseret indhold, som parseren og hydratoren skaber disse kontakter fra. En e-mail ankommer, vi læser den, opdeler den i nøgle-værdi-par, opretter en kontakt og gemmer den i databasen.
Det er enkelt. Antag, at kontakten har egenskaberne Navn, Alder og kontakttelefon. Disse data overføres i e-mailen. Derudover ønsker virksomheden, at supportmedarbejdere hurtigt kan tilføje nye nøgler til at mappe egenskaberne fra enheden til par i e-mailens indhold. I tilfælde af at nogen har lavet en tastefejl i skabelonen, eller hvis mappens format fra en ny partner skal startes hastigt inden lancering, kan vi tilføje den nye mappningskorrelation som en billig datasetningsreparation. Det vil sige, et livsbevidst eksempel.
Vi implementerer og opretter tests. Det fungerer.
Jeg vil ikke medbringe koden: der blev mange kilder, og de er tilgængelige på GitHub via linket i slutningen af artiklen. Du kan downloade dem, ændre dem uigenkendeligt og måle, hvordan det vil påvirke din situation. Jeg vil kun præsentere koden for to skabelonmetoder, som adskiller hydratøreren, der skulle være hurtig fra hydratøreren, der skulle være langsom.
Logikken er som følger: skabelonmetoden modtager par, der er dannet af den grundlæggende logik i parseren. Niveauet for LINQ er parseren og den grundlæggende logik for hydratøren, der foretager en forespørgsel til databasen og matcher nøglerne med par fra parseren (til disse funktioner findes der kode uden LINQ til sammenligning). Derefter overføres parrene til den primære hydrationsmetode, og værdierne for hver indstilling sættes til de tilsvarende egenskaber i enheden.
„Hurtig“ (Præfix Fast i benchmarks):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Som vi kan se, anvendes en statisk samling med property-settere – compilerede lambdas, der kalder setter for enheden. De skabes med følgende kode:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Det er generelt forståeligt. Vi gennemgår egenskaberne, opretter delegationer, der kalder setterne, og gemmer dem. Derefter kalder vi dem, når det er nødvendigt.
„Langsom“ (Præfix Slow i benchmarks):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Her går vi straks gennem egenskaberne og kalder direkte SetValue.
For clarity and as an example, I implemented a naive method that directly writes correlation pair values into the entity fields. Prefix - Manual.
Now let's take BenchmarkDotNet and investigate the performance. And suddenly... (spoiler - this is not the correct result, details below)
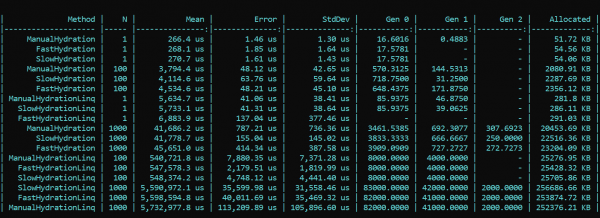
What do we see here? Methods proudly bearing the Fast prefix are almost always slower than methods with the Slow prefix in nearly all runs. This is true for both allocation and execution speed. On the other hand, the beautiful and elegant mapping implementation using LINQ methods wherever possible significantly affects performance. The difference is substantial. The trend does not change with different pass counts. The only variation is in scale. With LINQ it's 4 to 200 times slower, producing roughly the same amount of garbage.
UPDATED
I couldn't believe my eyes, but more importantly, neither could our colleague — . Upon rechecking my solution, he brilliantly identified and pointed out an error that I missed due to several changes in implementation from start to finish. After fixing the identified bug in the Moq setup, all results fell into place. In the retest, the main trend remains unchanged — LINQ still significantly impacts performance more than reflection. However, it's nice to see that working with Expression compilation is not in vain, and the result is evident both in allocation and execution time. The first run, when static fields are initialized, is naturally slower with the 'fast' method, but the situation changes thereafter.
Here are the retest results:
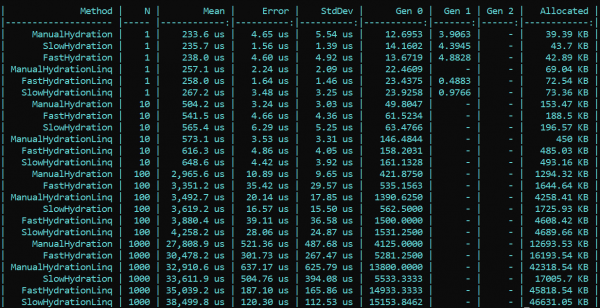
Conclusion: when using reflection in enterprise, there is no special need for tricks — LINQ will devour performance more. Nevertheless, in high-load methods requiring optimization, reflection can be retained in the form of initializers and delegate compilers that will then provide 'fast' logic. This way, you can maintain both the flexibility of reflection and the application's speed.
The code with the benchmark is available here. Anyone interested can verify my words:
PS: Koden i testene bruger IoC, mens benchmarks anvender en ekspllicit struktur. Problemet er, at jeg i den endelige implementering har fjernet alle faktorer, der kan påvirke ydeevnen og støje resultaterne.
PPS: Tak til brugeren for at opdage min fejl i opsætningen af Moq, som påvirkede de første målinger. Hvis nogen af læserne har nok karma, så giv ham venligst et like. Manden stoppede op, læste det grundigt, tjekkede det igen og pegede på fejlen. Jeg mener, det er værd at respektere og sætte pris på.
PPPS: Tak til den grundige læser, der kritiserede stilen og formateringen. Jeg går ind for ensartethed og brugervenlighed. Den diplomatiske formidling kan forbedres, men jeg har taget kritikken til efterretning. Lad os komme til sagen.
Kilde: habr.com
