

Jeg vil gerne præsentere en gennemgang af rapporten fra slutningen af 2019 af Alexander Valyalkin "Go-optimeringer i VictoriaMetrics"
— en hurtig og skalerbar DBMS til opbevaring og behandling af data i form af tidsserier (en optagelse består af tid og et sæt værdier svarende til denne tid, f.eks. opnået gennem periodisk polling af sensorstatus eller indsamling af metrics).
Her er et link til videoen af denne rapport —
Lad mig fortælle lidt om mig selv. Jeg er Alexander Valyalkin. Her er . Jeg har en passion for Go og performanceoptimering. Jeg har skrevet mange forskellige nyttige og mindre nyttige biblioteker. De starter enten med fast, eller med quick præfikset.
I øjeblikket arbejder jeg på VictoriaMetrics. Hvad er det, og hvad laver jeg der? Dette vil jeg forklare i denne præsentation.
Planen for rapporten er som følger:
- Først vil jeg fortælle jer, hvad VictoriaMetrics er.
- Derefter vil jeg forklare, hvad tidsserier er.
- Så vil jeg fortælle, hvordan en tidsseriedatabase fungerer.
- Dernæst vil jeg tale om databasedesignen: hvad den består af.
- Og så går vi videre til optimeringerne i VictoriaMetrics. Dette inkluderer optimering af den inverterede indeks og bitset-implementering på Go.
Ved nogen i publikum, hvad VictoriaMetrics er? Wow, mange mennesker ved allerede det. Det er en god nyhed. For dem der ikke ved det – det er en database til tidsserier. Den er baseret på ClickHouse-arkitekturen og visse detaljer i implementeringen af ClickHouse. For eksempel: MergeTree, parallel beregning på alle tilgængelige kerner af processoren og optimering af ydeevne med fokus på datablokke, som gemmes i processorens cache.
VictoriaMetrics tilbyder den bedste datakomprimering sammenlignet med andre databaser designet til tidsserier.
Den skalerer vertikalt — dvs. du kan tilføje flere processorer, mere RAM på én maskine. VictoriaMetrics vil effektivt udnytte disse tilgængelige ressourcer og forbedre den lineære ydeevne.
Desuden skalerer VictoriaMetrics horisontalt — dvs. du kan tilføje flere noder til VictoriaMetrics-klyngen, og dens ydeevne vil vokse næsten lineært.
Som du måske har gættet, er VictoriaMetrics en hurtig database, fordi jeg ikke kan skrive om andre. Og den er skrevet i Go, så det er derfor, jeg taler om den på dette meetup.
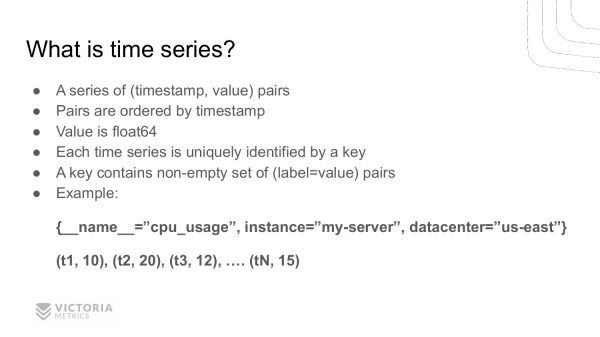
Hvem ved, hvad en tidsserie er? Mange mennesker ved det også. En tidsserie er en række par (timestamp, værdi), hvor disse par er sorteret efter tid. Værdien er et flydende tal – float64.
Hver tidsserie er unikt identificeret ved en nøgle. Hvad består denne nøgle af? Den består af et ikke-tomt sæt nøgle-værdi-par.
Her er et eksempel på en tidsserie. Nøglen til denne serie er en liste af par: __name__="cpu_usage" – dette er navnet på metrikken, instance="my-server" – dette er computeren, hvor denne metrik er indsamlet, datacenter="us-east" – dette er datacenteret, hvor denne computer står.
Vi har fået navnet på tidsserien, som består af tre nøgle-værdi-par. Denne nøgle svarer til listen af par (timestamp, værdi). t1, t3, t3, ..., tN – dette er timestamps, 10, 20, 12, ..., 15 – de tilsvarende værdier. Dette er cpu-brug på det nuværende tidspunkt for den pågældende serie.
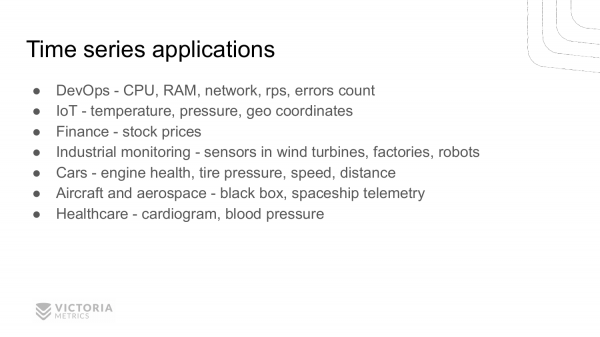
Hvor kan tidsserier anvendes? Er der nogen idéer?
- I DevOps kan man måle CPU-belastning, RAM, netværk, rps, antal fejl osv.
- IoT – vi kan måle temperatur, tryk, geografiske koordinater og mere.
- Også i finans – vi kan overvåge priser på aktier og valutaer.
- Derudover kan tidsserier bruges til overvågning af produktionsprocesser på fabrikker. Vi har brugere, der bruger VictoriaMetrics til at overvåge vindmøller, til robotter.
- Tidsserier er også nyttige til at indsamle oplysninger fra sensorer på forskellige enheder. For eksempel, til motoren; til måling af dæktryk; til måling af hastighed, afstand; til måling af brændstofforbrug osv.
- Tidsserier kan også anvendes til overvågning af fly. Hver flyvning har en sort boks, der indsamler tidsserier om forskellige parametre for flyets sundhed. Tidsserier anvendes også i luftfartsindustrien.
- Sundhedspleje – det er blodtryk, puls osv.
Måske er der andre anvendelser, som jeg har glemt, men jeg håber, at I forstår, at tidsserier aktivt anvendes i den moderne verden. Og omfanget af deres anvendelse vokser hvert år.
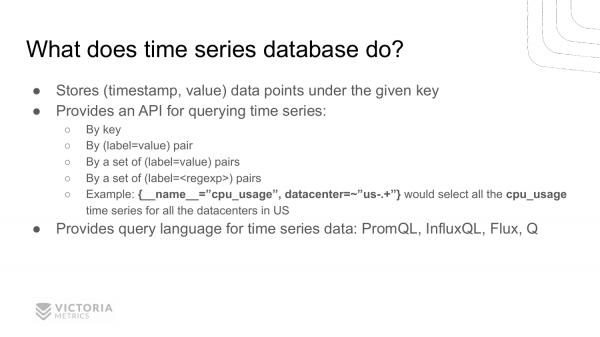
Hvad er behovet for en database til tidsserier? Hvorfor kan man ikke bruge en almindelig relationsdatabase til at opbevare tidsserier?
Fordi tidsserier normalt har et stort volumen af information, der er svært at gemme og behandle i almindelige databaser. Derfor er der opstået specialiserede databaser til tidsserier. Disse databaser gemmer effektivt datapunkter (timestamp, værdi) med en given nøgle. De tilbyder et API til at læse de gemte data baseret på nøglen, én nøgle-værdi-par ad gangen, eller flere sådanne par, eller ved hjælp af regexp. For eksempel, hvis du ønsker at finde CPU-belastningen for alle dine tjenester i datacenteret i Amerika, skal du bruge en sådan pseudo-forespørgsel.
Normalt præsenterer databaser til tidsserier specialiserede forespørgselsprog, fordi SQL ikke er særlig godt tilpasset til tidsserier. Selvom der findes databaser, der understøtter SQL, er det ikke særlig godt tilpasset. Mere passende forespørgselsprog er , , , . Jeg håber, at nogen har hørt om mindst ét af disse sprog. Om PromQL har mange sikkert hørt.
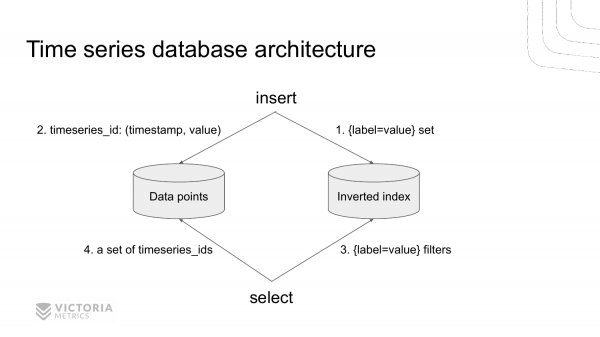
Her er, hvordan arkitekturen af en moderne database til tidsserier ser ud, med VictoriaMetrics som eksempel.
Den består af to dele. Det er et lager til den inverterede indeks og et lager til tidsserieværdierne. Disse lagre er adskilt.
Når der kommer en ny post i databasen, kontakter vi først den inverterede indeks for at finde identifikatoren for tidsserien baseret på det angivne sæt label=value for denne måling. Vi finder denne identifikator og gemmer værdien i datalageret.
Når der kommer en forespørgsel om at hente data fra TSDB, kigger vi først i den inverterede indeks. Vi henter alle timeseries_ids poster, der svarer til det angivne sæt. label=valueOg derefter henter vi alle nødvendige data fra datalageret, som er indekseret efter timeseries_ids.
Lad os overveje et eksempel på, hvordan en database til tidsserier behandler en indgående select-forespørgsel.
- Først henter den alle
timeseries_idsfra den inverterede indeks, der indeholder de angivne parlabel=value, eller som opfylder det angivne regulære udtryk. - Så henter den alle data points fra datalageret for det angivne tidsinterval for de fundne
timeseries_ids. - Derefter udfører databasen nogle beregninger på disse data points i henhold til brugerens forespørgsel. Og derefter returnerer den svaret.
I denne præsentation vil jeg fortælle dig om den første del. Det er søgning. timeseries_ids efter det inverterede indeks. Du kan senere kigge på del to og del tre. , eller vent, mens jeg forbereder andre præsentationer 🙂
Lad os begynde med det inverterede indeks. Mange vil måske synes, at det er enkelt. Hvem ved, hvad et inverteret indeks er, og hvordan det fungerer? Åh, allerede ikke så mange mennesker. Lad os forsøge at forstå, hvad det går ud på.
Det er faktisk ret simpelt. Dette er bare et ordbog, der kortlægger nøgle til værdi. Hvad er en nøgle? Dette par label=value, hvor label og value – er strenge. Og værdierne er et sæt timeseries_ids, som indeholder det angivne par label=value.
Det inverterede indeks gør det muligt hurtigt at finde alle timeseries_ids, der har angivne label=value.
Det gør det også muligt hurtigt at finde timeseries_ids tidsserier for flere par label=value, eller for par label=regexp. Hvordan sker det? Ved at finde skæringspunktet for mængden timeseries_ids for hvert par label=value.
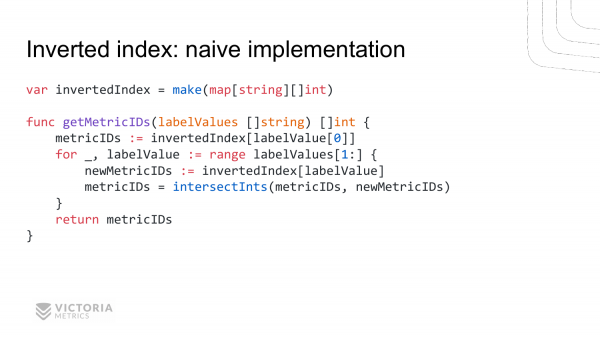
Lad os se på forskellige implementeringer af det inverterede indeks. Vi starter med den mest enkle naive implementering. Den ser sådan ud.
Funktion getMetricIDs får en liste af strenge. Hver streng indeholder label=value. Denne funktion returnerer en liste metricIDs.
Hvordan fungerer det? Her har vi en global variabel kaldet invertedIndex. Dette er et almindeligt ordbog (kortlægning), der kortlægger en streng til en slice af ints. Strengen indeholder label=value.
Implementeringen af funktionen: henter metricIDs for den første label=value, derefter gennemgår vi alle de andre label=value, henter metricIDs for dem. Og kalder funktionen intersectInts, som vil blive beskrevet senere. Og denne funktion returnerer skæringspunktet for disse lister.
Som du kan se, er implementeringen af det inverterede indeks ikke særlig kompliceret. Men det er en naiv implementering. Hvad er dens ulemper? Den største ulempe ved den naive implementering er, at et sådant inverteret indeks opbevares i RAM. Efter genstart af applikationen mister vi dette indeks. Der er ingen gemning af dette indeks på disk. Til en database vil et sådant inverteret indeks næppe være passende.
Den anden ulempe er også relateret til hukommelse. Det inverterede indeks skal være i RAM. Hvis det overstiger størrelsen af RAM, får vi åbenbart – out of memory error. Og programmet fungerer ikke.
Dette problem kan løses med hjælp fra færdige løsninger såsom , eller .
Kort sagt, vi har brug for en database, der hurtigt kan udføre tre operationer.
- Den første operation er at skrive
nøgle-værditil denne database. Det gør den meget hurtigt, hvornøgle-værdi– er vilkårlige strenge. - Den anden operation er hurtig søgning efter værdien baseret på en given nøgle.
- Og den tredje operation er hurtig søgning efter alle værdier baseret på et givet præfiks.
LevelDB og RocksDB – disse databaser er udviklet af Google og Facebook. Først kom LevelDB. Så tog folkene fra Facebook LevelDB og begyndte at forbedre den, hvilket resulterede i RocksDB. I dag kører næsten alle interne databaser hos Facebook på RocksDB, inklusive at de har overført MySQL til RocksDB. De kaldte det .
Et inverteret indeks kan implementeres ved hjælp af LevelDB. Hvordan gør vi det? Vi gemmer som nøgle label=value. Og som værdi – tidsserie-identifikatoren, hvor parret optræder label=value.
Hvis vi har mange tidsserier med dette par label=value, så vil der være mange rækker i denne database med den samme nøgle og forskellige timeseries_ids. For at få listen over alle timeseries_ids, der starter med det angivne label=prefix, foretager vi en range scan, som denne database er optimeret til. Dvs. vi vælger alle rækker, der starter med label=prefix og får de nødvendige timeseries_ids.
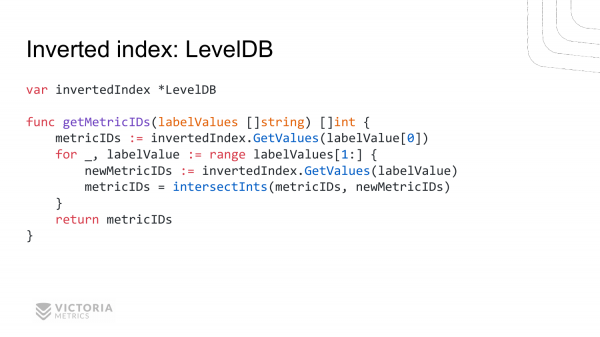
Her er en omtrentlig implementering af, hvordan det ville se ud i Go. Vi har et inverteret indeks. Det er LevelDB.
Funktionen er den samme som for den naive implementering. Den gentager næsten linje for linje den naive implementering. Den eneste forskel er, at vi i stedet for at henvise til kortlægning henvender os til det inverterede indeks. Vi henter alle værdierne for den første label=value. Så går vi igennem alle de resterende par label=value og henter de relevante sæt af metricIDs for dem. Derefter finder vi skæringspunktet.
Det virker alt sammen godt, men der er ulemper ved denne løsning. VictoriaMetrics implementerede oprindeligt et inverteret indeks baseret på LevelDB. Men i sidste ende måtte de opgive det.
Hvorfor? Fordi LevelDB er langsommere end den naive implementering. I den naive implementering henter vi med det samme hele slice baseret på den givne nøgle metricIDs. Denne operation er meget hurtig – hele slice er klar til brug.
I LevelDB skal man derimod ved hvert kald af funktionen GetValues gennemgå alle rækker, der starter med label=value. Og for hver række hente værdien timeseries_ids. Fra disse timeseries_ids samle et slice af disse timeseries_ids. Det er åbenlyst, at dette er meget langsommere end blot at henvise til et almindeligt kort efter nøgle.
Den anden ulempe er, at LevelDB er skrevet i C. Adgangen til C-funktioner fra Go er ikke særlig hurtig. Det tager hundrede nanosekunder. Det er ikke hurtigt, fordi det sammenlignet med et almindeligt funktionsopkald, der er skrevet i Go, som tager 1-5 nanosekunder, betyder, at der er en forskel i ydeevne på mange gange. For VictoriaMetrics var dette en fatal ulempe 🙂
Derfor har jeg skrevet min egen implementering af et inverteret indeks. Jeg kaldte det .
Mergeset er baseret på datalayoutet MergeTree. Denne datastruktur er lånt fra ClickHouse. Det er klart, at mergeset skal optimeres til hurtig søgning timeseries_ids efter en given nøgle. Mergeset er skrevet helt i Go. Du kan se på . Implementeringen af mergeset ligger i mappen . Du kan prøve at finde ud af, hvad der sker der.
API'et for mergeset ligner meget LevelDB og RocksDB. Dvs. det giver mulighed for hurtigt at gemme nye poster der og hurtigt vælge poster efter en given præfiks.
Vi vil tale om ulemperne ved mergeset senere. Nu vil vi tale om, hvilke problemer der opstod med VictoriaMetrics i produktion ved implementeringen af det inverterede indeks.
Hvorfor opstod de?
Den første årsag er den høje churn rate. På dansk betyder det hyppig skift af tidsserier. Det er, når en tidsserie slutter, og en ny tidsserie starter, eller mange nye tidsserier begynder. Og det sker ofte.
Den anden årsag er det store antal tidsserier. I starten, da overvågning blev populært, var antallet af tidsserier lille. For eksempel skal du overvåge CPU, hukommelse, netværk og disk for hver computer. 4 tidsserier pr. computer. Hvis du har 100 computere, er der 400 tidsserier. Det er meget lidt.
Over tid opfandt folk, at man kunne måle mere detaljeret information. For eksempel at måle belastningen på ikke hele CPU'en, men hver enkelt CPU-kerne. Hvis du har 40 CPU-kerner, har du derfor 40 gange flere tidsserier til at måle CPU-belastningen.
Men det er ikke alt. Hver processorkerne kan have flere tilstande, såsom idle, når den ikke bruges. Derudover er der betjening i brugerrum, betjening i kernerum og andre tilstande. Hver af disse tilstande kan også måles som en separat tidsserie. Dette øger antallet af rækker med 7-8 gange.
Fra én metrik fik vi 40 x 8 = 320 metrikker kun for én computer. Ganget med 100 får vi 32.000 i stedet for 400.
Derefter kom Kubernetes. Og det forværrede situationen yderligere, fordi mange forskellige tjenester kan være hostet i Kubernetes. Hver tjeneste i Kubernetes består af mange pods. Alt dette skal overvåges. Derudover har vi en konstant implementering af nye versioner af dine tjenester. For hver ny version skal der oprettes nye tidsserier. Resultatet er, at antallet af tidsserier vokser eksponentielt, og vi står over for problemet med det store antal tidsserier, der kaldes high-cardinality. VictoriaMetrics håndterer dette effektivt i forhold til andre tidsserie-databaser.
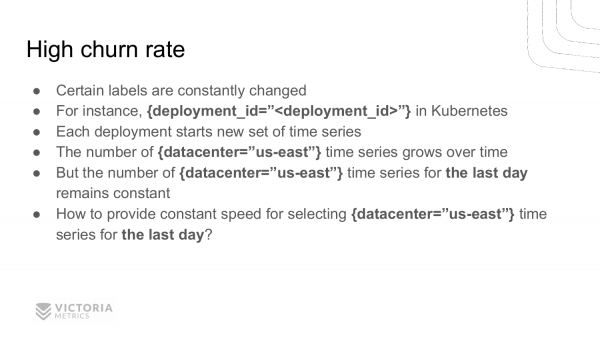
Lad os se nærmere på high churn rate. Hvad forårsager high churn rate i produktion? Fordi nogle værdier af labels og tags konstant ændres.
For eksempel, lad os tage Kubernetes, som har begrebet deployment, dvs. når en ny version af din applikation rulles ud. Udviklerne af Kubernetes har af en eller anden grund besluttet at tilføje en deployment-id til label.
Hvad førte dette til? At med hver ny deployment bliver alle de gamle tidsserier afbrudt, og i stedet begynder nye tidsserier med en ny labelværdi deployment_id. Der kan være hundrede tusinde og endda millioner af sådanne rækker.
En vigtig egenskab ved det hele er, at det samlede antal tidsserier vokser, men antallet af tidsserier, der i øjeblikket er aktive og modtager data, forbliver konstant. Denne tilstand kaldes high churn rate.
Det primære problem med high churn rate er at sikre en konstant søgehastighed for alle tidsserier baseret på et givet sæt labels over et bestemt tidsinterval. Dette interval er normalt det sidste time eller den sidste dag.
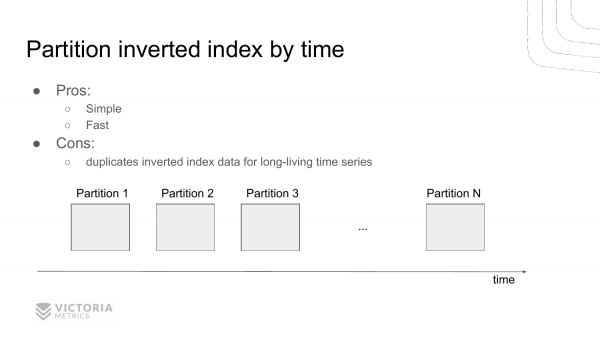
Hvordan løser vi dette problem? Her er det første forslag. Det er at opdele den inverterede indeks i uafhængige dele baseret på tid. Det vil sige, når en periode er gået, stopper vi med at arbejde med den nuværende inverterede indeks og opretter en ny inverteret indeks. Når endnu en periode er gået, opretter vi endnu en og endnu en.
Og når vi henter fra disse inverterede indekser, finder vi et sæt inverterede indekser, der falder inden for det angivne interval. Og derfra vælger vi id'erne for de tidsserier.
Dette sparer ressourcer, fordi vi ikke behøver at gennemgå dele, der ikke falder inden for det angivne interval. Det vil sige, at hvis vi normalt vælger data for den seneste time, springer vi forespørgsler over for de tidligere tidsintervaller.
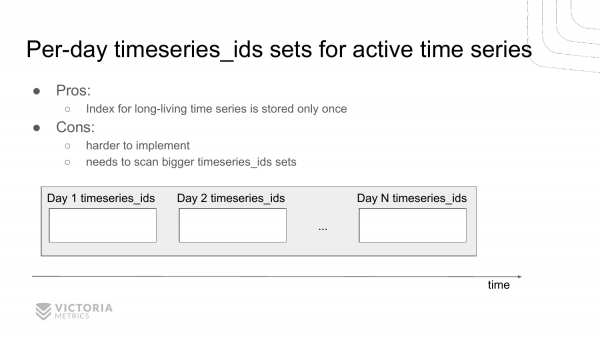
Der er endnu en løsning på dette problem. Det er at gemme en separat liste over id'er for tidsserier, der optrådte for hver dag.
Fordelen ved denne løsning i forhold til den tidligere løsning er, at vi ikke duplikerer informationen om tidsserier, der ikke forsvinder over tid. De er konstant til stede og ændrer sig ikke.
Ulempen er, at denne løsning er sværere at implementere og sværere at fejlfinde. Og VictoriaMetrics har valgt denne løsning. Det skete historisk. Denne løsning præsterer også godt i forhold til den tidligere, fordi den ikke blev implementeret på grund af behovet for at duplikere data i hver partition for tidsserier, der ikke ændres, det vil sige de, der ikke forsvinder over tid. VictoriaMetrics var først og fremmest optimeret til diskforbrug, og den tidligere implementering forværrede diskforbruget. Men denne implementering passer bedre til at minimere diskforbruget, så den blev valgt.
Vi måtte kæmpe med dette. Kampen bestod i, at man i denne implementering stadig skal vælge et væsentligt større antal timeseries_ids for data end når den inverterede indeks er opdelt efter tid.
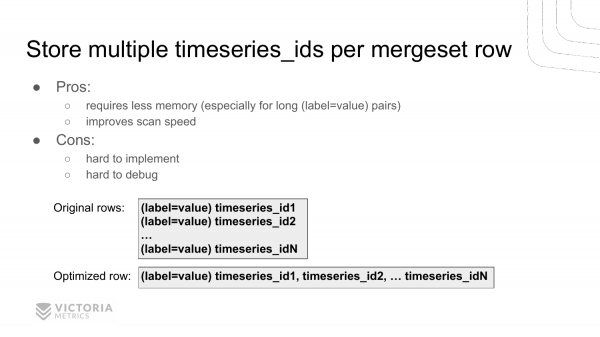
Hvordan løste vi dette problem? Vi løste det på en original måde – ved at gemme flere identifikatorer for tidsserier i hver post af den inverterede indeks i stedet for én identifikator. Det vil sige, vi har en nøgle label=value, som findes i hver tidsrække. Og nu gemmer vi flere timeseries_ids i én optagelse.
Her er et eksempel. Tidligere havde vi N optagelser, men nu har vi én optagelse, hvis præfiks er det samme som for alle de andre. Den tidligere optagelse indeholdt alle ID’erne fra tidsrækkerne.
Dette har øget hastigheden for scanning af en sådan inverteret indeks op til 10 gange. Og det har reduceret hukommelsesforbruget til cachen, fordi vi nu gemmer strengen label=value kun én gang i cachen sammen med N gange. Og denne streng kan være stor, hvis du har lange strenge gemt i tags og labels, som Kubernetes elsker at stoppe der.
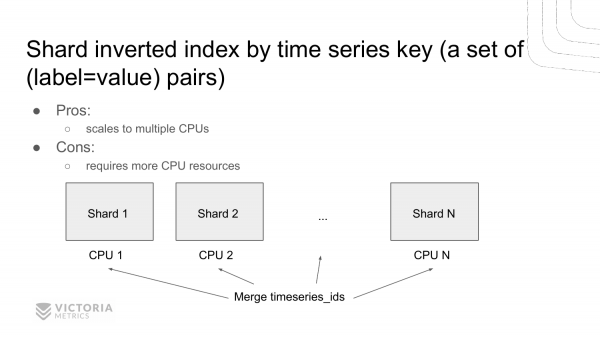
En anden metode til at accelerere søgningen i det inverterede indeks er sharding. Ved at oprette flere inverterede indekser i stedet for én og shard dataene mellem dem baseret på en nøgle. Dette er et sæt nøgle=værdi par. Det vil sige, at vi får flere uafhængige inverterede indekser, som vi kan forespørge parallelt på flere processorer. Tidligere implementeringer tillod kun at fungere i en-processor-tilstand, det vil sige, at dataene kun kunne scannes på én kerne. Denne løsning gør det muligt at scanne data på flere kerner på én gang, som ClickHouse gerne gør. Det planlægger vi at implementere.
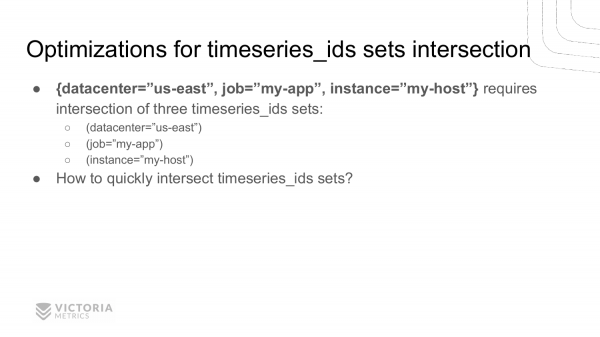
Og nu lad os vende tilbage til sagen – til intersections-funktionen timeseries_ids. Lad os overveje, hvad der kan være af implementeringer. Denne funktion gør det muligt at finde timeseries_ids for et givet sæt label=value.
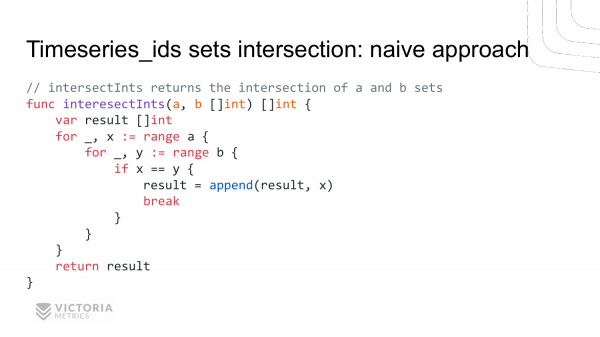
Den første mulighed er en naiv implementering. To indlejrede løkker. Her får vi som input til funktionen intersectInts to slices — en og b. Som output skal den returnere os intersection af disse slices.
Den naive implementering ser sådan ud. Vi går igennem alle værdierne fra slice en, inden i denne løkke bruger vi alle værdierne fra slice b. Og vi sammenligner dem. Hvis de matcher, har vi fundet intersection. Og vi gemmer det i resultat.
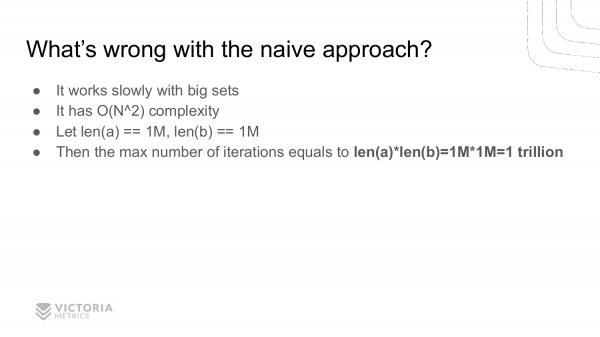
Hvilke ulemper er der? Den kvadratiske kompleksitet — det er dens hovedulempen. For eksempel, hvis du har størrelserne på slices en og b på en million, så vil denne funktion aldrig returnere et svar. Fordi den skal lave en trillion iterationer, hvilket er meget selv for moderne computere.
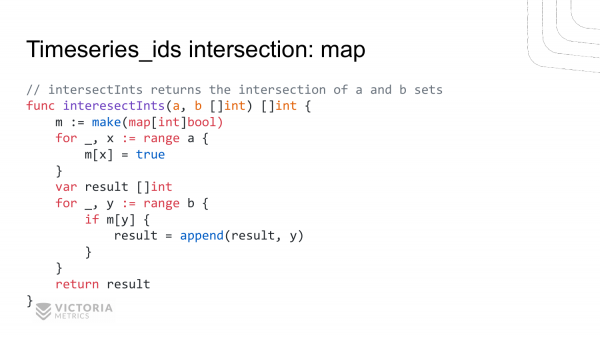
Den anden implementering er baseret på map. Vi opretter en map. Sætter alle værdierne fra slice en. Derefter løber vi gennem slice b. Og vi tjekker – er der denne værdi fra slice b i map. Hvis den findes, tilføjer vi den til resultatet.
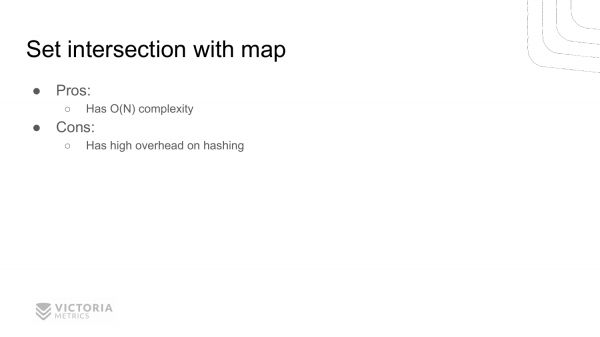
Hvilke fordele er der? Fordelen er, at der kun er lineær kompleksitet. Det vil sige, at funktionen udføres meget hurtigere for store størrelser af slices. For en slice med en million elementer vil denne funktion udføres på 2 millioner iterationer, i modsætning til en billion iterationer som i den forrige funktion.
En ulempe er, at denne funktion kræver mere hukommelse for at oprette denne map.
Den anden ulempe er den store overhead ved hashing. Denne ulempe er ikke så åbenlys. Og for os var den heller ikke særlig åbenlys, derfor blev intersection-implementeringen i VictoriaMetrics oprindeligt lavet via map. Men profilering viste, at den største del af CPU-tiden gik til at skrive i map og kontrollere tilstedeværelsen af værdier i denne map.
Hvorfor tager disse steder CPU-tid? Fordi Go i disse linjer udfører en hash-operation. Det vil sige, at den beregner hash for nøglen, for derefter at få adgang til den angivne indeks i HashMap. Operationen med at beregne hash udføres på tiendedel af nanosekunder. Det er langsomt for VictoriaMetrics.
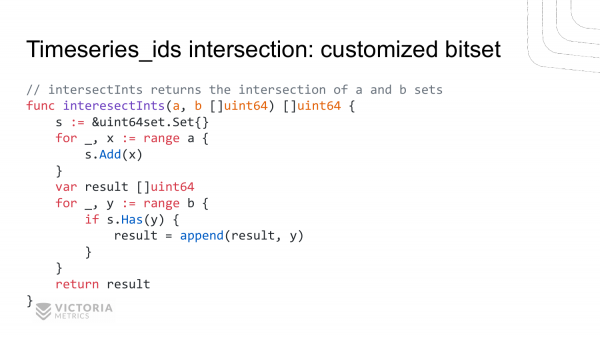
Jeg besluttede at implementere en bitset, der er specielt optimeret til dette tilfælde. Sådan ser intersection af to slices nu ud. Her opretter vi en bitset. Vi tilføjer elementer fra den første slice. Derefter kontrollerer vi om disse elementer findes i den anden slice. Og vi tilføjer dem til resultatet. Det vil sige, at det næsten ikke adskiller sig fra det forrige eksempel. Det eneste, vi har ændret, er at erstatte adgangen til map med brugerdefinerede funktioner. add og has.
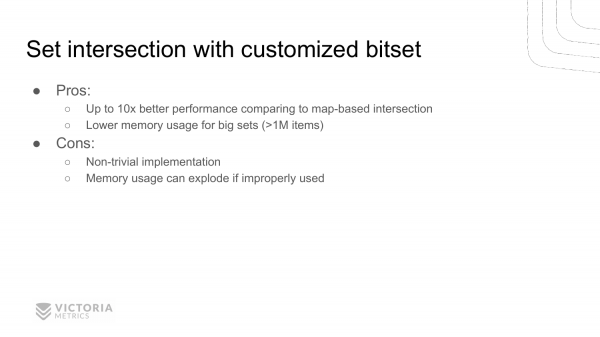
Ved første øjekast ser det ud til, at dette skulle være langsommere, hvis der tidligere blev brugt en standard map, og nu kaldes der også nogle funktioner, men profileringen viser, at denne metode fungerer ti gange hurtigere end standard map i forbindelse med VictoriaMetrics.
Derudover bruger den meget mindre hukommelse sammenlignet med implementeringen på map. Fordi vi opbevarer bits i stedet for otte-bytes værdier.
Ulempen ved denne implementering er, at den ikke er så åbenlys, ikke triviel.
En anden ulempe, som mange måske ikke bemærker, er, at denne implementering kan fungere dårligt i visse tilfælde. Det vil sige, den er optimeret til et specifikt tilfælde, til netop dette tilfælde med overlapning af ids for tidsserier i VictoriaMetrics. Det betyder ikke, at den vil være egnet for alle situationer. Hvis den bruges forkert, får vi ikke et performance boost, men en out of memory-fejl og nedsat ydeevne.
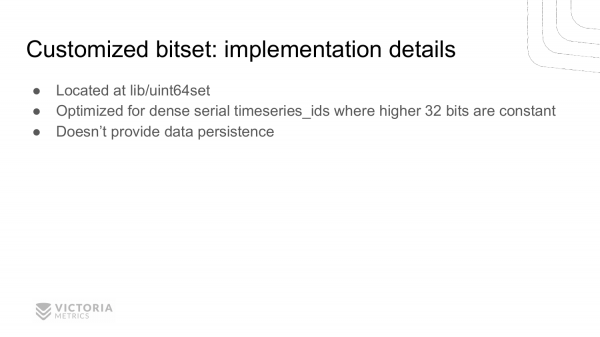
Lad os se nærmere på implementeringen af denne struktur. Hvis du vil se den, findes den i kildekoden til VictoriaMetrics, i mappen . Den er optimeret netop til VictoriaMetrics, hvor timeseries_id repræsenterer en 64-bit værdi, hvor de første 32 bit er konstant og kun de sidste 32 bit ændres.
Denne datastruktur gemmes ikke på disken, den arbejder kun i hukommelsen.
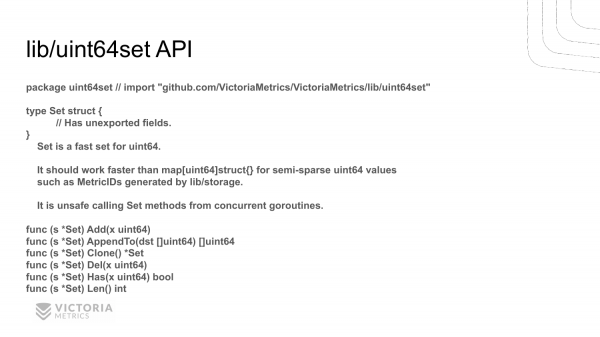
Her er dens API. Det er ikke særlig komplekst. API'et er tilpasset netop det specifikke eksempel på brugen af VictoriaMetrics. Det vil sige, der er ikke unødvendige funktioner. Her er funktioner, der tydeligt bruges af VictoriaMetrics.
Der er en funktion add, der tilføjer nye værdier. Der er en funktion has, der tjekker nye værdier. Og der er en funktion del, der sletter værdier. Der er en hjælpefunktion len, der returnerer størrelsen af mængden. Funktionen clone kloner mængden. Og funktionen appendto omdanner dette sæt til et slice. timeseries_ids.
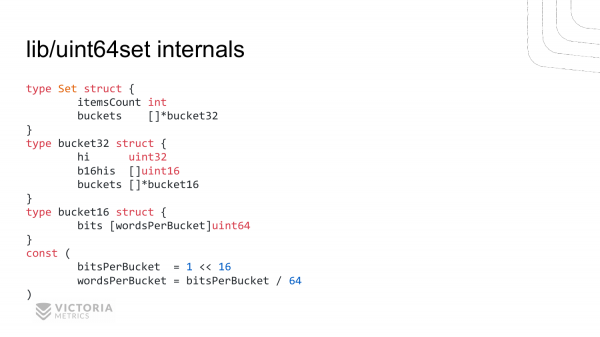
Sådan ser implementeringen af denne datastruktur ud. I sættet er der to elementer:
ItemsCount– det er et hjælpefelt for hurtigt at returnere antallet af elementer i sættet. Man kunne have undgået dette hjælpefelt, men det måtte tilføjes her, fordi VictoriaMetrics ofte forespørger længden af bitset i sine algoritmer.Det andet felt er
buckets. Det er et slice af strukturenbucket32.I hver struktur gemmeshifeltet. Det er de øverste 32 bit. Og to slices —b16hisogbucketsafbucket16strukturer.
Her gemmes de øverste 16 bit fra den anden del af den 64-bit struktur. Og her gemmes bitsets for de nederste 16 bit af hver byte.
Bucket64 består af et array uint64.Længden beregnes med hjælp af disse konstanter. I én bucket16 kan der højst gemmes 2^16=65536 bit. Hvis dette deles med 8, bliver det til 8 kilobyte. Hvis det deles igen med 8, bliver det til 1000 uint64. værdier. Det vil sige, Bucket16 er en 8-kilobyte struktur.
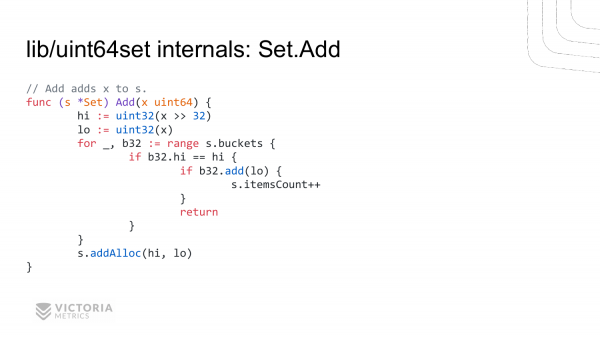
Lad os se på, hvordan en af metoderne til denne struktur tilføjer en ny værdi er implementeret.
Det hele begynder med uint64. værdier. Vi beregner de øverste 32 bits, beregner de nederste 32 bits. Vi går igennem alle buckets. Vi sammenligner de øverste 32 bits i hver bucket med den værdi, der tilføjes. Og hvis de matcher, kalder vi funktionen add i strukturen b32 buckets. Og tilføjer de nederste 32 bits der. Og hvis dette returnerede true, så betyder det, at vi har tilføjet en sådan værdi der, og vi ikke havde en sådan værdi før. Hvis den returnerer false, så var en sådan værdi allerede der. Derefter øger vi antallet af elementer i strukturen.
Hvis vi ikke fandt den nødvendige bucket med den nødvendige hi-værdi, så kalder vi funktionen addAlloc, som allokerer en ny bucket, ved at tilføje den til bucket-strukturen.
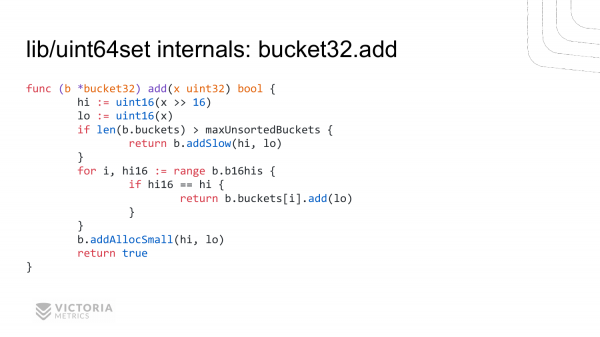
Dette er implementeringen af funktionen b32.add. Den ligner den forrige implementering. Vi beregner de øverste 16 bits, de nederste 16 bits.
Derefter går vi igennem alle de øverste 16 bits. Finder matches. Og ved match kalder vi metoden add, som vi vil se på næste side for bucket16.
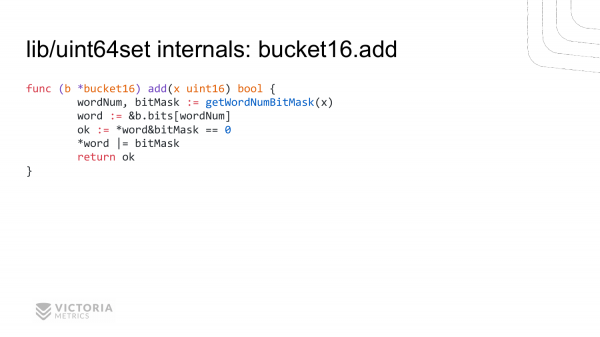
Og her er det nederste niveau, som skal være maksimeret. Vi beregner for uint64. id værdien i slice bit, samt bitmask. Dette er en maske for denne 64-bits værdi, som kan bruges til at kontrollere tilstedeværelsen af denne bit eller sætte den. Vi tjekker om denne bit er sat og sætter den, og returnerer tilstedeværelsen. Her er en sådan implementering, som tillod at fremskynde operationen af krydsning af ids af tidsserier 10 gange sammenlignet med almindelige maps.
I VictoriaMetrics, udover denne optimering, er der mange andre optimeringer. De fleste af disse optimeringer er ikke tilføjet bare sådan, men efter profilering af koden i produktionen.
Dette er den vigtigste regel for optimering – ikke tilføje optimering, antagende at der vil være et flaskehals, fordi det kan vise sig, at der ikke er nogen flaskehals. Optimering forværre normalt kodekvaliteten. Derfor bør man kun optimere efter profilering og helst i produktion, så man arbejder med reelle data. For dem, der er interesserede, kan I se kilden til VictoriaMetrics og studere andre optimeringer, som findes der.
Jeg har et spørgsmål om bitset. Det ligner meget implementeringen af C++ vector bool, optimeret bitset. Tog I implementeringen derfra?
Nej, ikke derfra. I implementeringen af dette bitset har jeg været orienteret om strukturen af disse ids tidserier, som anvendes i VictoriaMetrics. Og deres struktur er sådan, at de øverste 32 bits stort set er konstante. De nederste 32 bits kan ændre sig. Jo lavere bit, jo oftere kan den ændre sig. Derfor er denne implementering specifikt optimeret til denne datamodel. C++-implementeringen, så vidt jeg ved, er optimeret til den generelle situation. Hvis man laver optimering til den generelle situation, betyder det, at den ikke vil være den mest optimale for et konkret tilfælde.
Jeg vil anbefale, at du også ser på Alexey Milovids præsentation. Han fortalte for omkring en måned siden om optimeringer i ClickHouse til specifikke specialiseringer. Han forklarer netop, at i almindelighed er C++-implementeringen eller en anden implementering designet til at fungere godt i gennemsnit. Den kan fungere dårligere end en specialiseret implementering baseret på specifik viden, som vores, når vi ved, at de øverste 32 bits stort set er konstante.
Jeg har et andet spørgsmål. Hvad er den grundlæggende forskel fra InfluxDB?
Der er mange grundlæggende forskelle. Når det gælder ydeevne og hukommelsesforbrug, viser InfluxDB i testene en 10 gange større hukommelsesforbrug for high cardinality tidsserier, når der er mange, for eksempel millioner. For eksempel bruger VictoriaMetrics 1 GB på en million aktive serier, mens InfluxDB på den anden side bruger 10 Gb. Og det er en stor forskel.
Den anden grundlæggende forskel er, at InfluxDB har mærkelige forespørgselssprog – Flux og InfluxQL. De er ikke særlig bekvemme til at arbejde med tidsserier sammenlignet med , som understøttes i VictoriaMetrics. PromQL er forespørgselssproget fra Prometheus.
Og en anden forskel er, at InfluxDB har en lidt mærkelig datamodel, hvor hver linje kan indeholde flere fields med forskellige sæt tags. Disse linjer deles yderligere op i forskellige tabeller. Disse ekstra komplikationer gør det sværere at arbejde med denne database. Den er svær at vedligeholde og forstå.
I VictoriaMetrics er alt meget enklere. Hver tidsserie repræsenterer et nøgle-værdi-par. Værdien er et sæt punkter – (timestamp, værdi), mens nøglen er et sæt label=value. Der er ingen opdeling i fields og measurements. Dette giver dig mulighed for at vælge vilkårlige data og derefter kombinere, tilføje, trække fra, multiplicere, dividere, i modsætning til InfluxDB, hvor beregninger mellem forskellige rækker stadig ikke er implementeret, så vidt jeg ved. Selvom de er implementeret, er de vanskelige, man skal skrive en masse kode.
Jeg har et opklarende spørgsmål. Forstod jeg rigtigt, at der var et eller andet problem, som du fortalte om, at denne inverterede indeks ikke kunne være i hukommelsen, så der er partitionering?
I starten viste jeg en naiv implementering af det inverterede indeks på en standard Go map. Denne implementering er ikke egnet til databaser, fordi det inverterede indeks ikke gemmes på disken, og databasen skal gemme på disken, så når den genstarter, er disse data stadig tilgængelige. I denne implementering vil det inverterede indeks gå tabt ved genstart af applikationen. Og du vil miste adgangen til alle data, fordi du ikke kan finde dem.
Hej! Tak for din præsentation! Jeg hedder Pavel. Jeg kommer fra virksomheden Wildberries. Jeg har et par spørgsmål til dig. Det første spørgsmål. Hvordan ville du mene, hvis du havde valgt en anden princip måde at opbygge arkitekturen for din applikation og partitioneret dataene efter tid, så kunne du muligvis gøre krydsning af data under søgningen, udelukkende baseret på, at der i én partition er data for ét tidsrum, altså for et tidsinterval, og du ikke skulle bekymre dig om, at du har fragmenter spredt forskelligt? Spørgsmål nummer 2 - da du implementerer en sådan algoritme med bitset og alt det andet, har du måske prøvet at bruge processorinstruktioner? Måske har du prøvet sådanne optimeringer?
Svar på det andet spørgsmål med det samme. Vi er ikke kommet så langt endnu. Men hvis det er nødvendigt, så vil vi. Og det første, hvad var spørgsmålet?
Du diskuterede to scenarier. Og sagde, at du valgte den anden med en mere kompleks implementering. Og du foretrak ikke den første, hvor dataene er partitioneret efter tid.
Ja. I det første tilfælde ville den samlede mængde af indekset være større, fordi vi i hver partition skulle opbevare dubletter af data for de tidsserier, der strækker sig over alle disse partitioner. Og hvis din churn rate for tidsserierne er lav, dvs. de samme rækker konstant bruges, ville vi i første tilfælde tabe meget mere plads i forhold til den anden mulighed.
Så ja, tidspartitionering er en god mulighed. Den bruges af Prometheus. Men der er en anden ulempe ved Prometheus. Når den sammenlægger disse datastykkere, skal den holde metadata om alle labels og tidsserier i hukommelsen. Derfor, hvis datastykkene er store, som den sammenlægger, vokser hukommelsesforbruget meget under sammenlægningen, i modsætning til VictoriaMetrics. Ved sammenlægning bruger VictoriaMetrics slet ikke hukommelse, kun et par kilobyte, uanset størrelsen på de sammenlagte datastykkene.
Algoritmen, som du bruger, anvender hukommelse. I den markeres tidsserie-tags med værdier. Og på den måde tjekker du for parret tilstedeværelse i et datasæt og i et andet. Og forstår, om der er sket et intersect eller ej. Normalt implementerer databaser cursorer, iteratorer, der gemmer deres nuværende tilstand og løber gennem de sorterede data, hvilket giver en simpel kompleksitet for de operationer.
Hvorfor bruger vi ikke cursorer til at krydse data?
Ja.
I vores LevelDB eller i mergeset gemmes der netop sorterede rækker. Vi kan bruge en cursor til at finde intersection. Men hvorfor bruge det? Fordi det er langsomt. Fordi cursorer indebærer, at der for hver række skal kald en funktion. Funktionsopkaldet tager 5 nanosekunder. Og hvis du har 100.000.000 rækker, ender det med, at vi bruger et halvt sekund bare på funktionskald.
Ja, det findes. Og jeg har et sidste spørgsmål. Spørgsmålet kan måske lyde lidt underligt. Hvorfor kan man ikke, når dataene kommer ind, beregne alle nødvendige aggregationer og gemme dem i den nødvendige form? Hvorfor gemme enorme mængder i systemer som VictoriaMetrics, ClickHouse mv., for derefter at bruge meget tid på dem?
Jeg vil give et eksempel, så det bliver mere klart. Antag, hvordan fungerer en lille legetøjs speedometer? Det registrerer afstanden, du har tilbagelagt, ved hele tiden at tilføje den til den ene værdi og tiden til den anden. Og så dividerer det. Og får gennemsnitshastigheden. Man kan gøre næsten det samme. Samle alle nødvendige fakta undervejs.
Okay, jeg forstår spørgsmålet. Dit eksempel har relevans. Hvis du ved, hvilke aggregeringer du har brug for, er det den bedste implementering. Men problemet er, at folk gemmer disse metrikker, nogle data i ClickHouse, og de ved endnu ikke, hvordan de vil aggregere, filtrere dem i fremtiden, så de er nødt til at gemme alle rådata. Men hvis du ved, at du skal tælle noget gennemsnitligt, hvorfor så ikke tælle det, i stedet for at gemme en masse rå værdier der? Men det er kun, hvis du helt præcist ved, hvad du har brug for.
For øvrigt understøtter databaser til opbevaring af tidsserier beregningen af aggregeringer. For eksempel understøtter Prometheus . Dvs. det kan gøres, hvis du ved, hvilke aggregeringer du får brug for. VictoriaMetrics har ikke dette endnu, men Prometheus placeres normalt foran den, hvor du kan gøre det i optagelsesreglerne.
For eksempel, på det tidligere job skulle jeg tælle antallet af hændelser i et glidende vindue over den sidste time. Problemet var, at jeg måtte lave en brugerdefineret implementering i Go, dvs. en tjeneste til at tælle denne ting. Denne tjeneste viste sig at være ikke triviel, fordi det er svært at tælle. Implementeringen kan være enkel, hvis du kun skal tælle nogle aggregeringer på faste tidsintervaller. Men hvis du vil tælle hændelser i et glidende vindue, er det ikke så enkelt, som det ser ud. Jeg tror ikke, det er blevet implementeret endnu i ClickHouse eller i tidsseriedatabaser, fordi det er svært at implementere.
Og så et spørgsmål mere. Vi har lige talt om gennemsnit, og jeg kom i tanke om, at der engang var noget som Graphite med backend Carbon. Og den kunne udtynde gamle data, dvs. efterlade ét punkt pr. minut, ét punkt pr. time osv. I princippet er det ret praktisk, hvis vi har brug for rådata, lad os sige, for en måned, og alt det andet kan udtyndes. Men Prometheus og VictoriaMetrics understøtter ikke denne funktionalitet. Er det planlagt at understøtte det? Hvis ikke, hvorfor?
Tak for spørgsmålet. Vores brugere spørger om dette fra tid til anden. De spørger, hvornår vi tilføjer støtte til nedprøvning (downsampling). Der er flere problemer her. For det første forstår hver bruger det som downsampling noget forskelligt: nogle ønsker at få et vilkårligt punkt inden for et givet interval, andre ønsker maksimale, minimale og gennemsnitlige værdier. Hvis flere systemer skriver data til din database, kan man ikke behandle dem ensartet. Det kan vise sig, at der for hvert system skal bruges forskellige nedprøvningsmetoder. Og det er svært at implementere.
Og for det andet er VictoriaMetrics, ligesom ClickHouse, optimeret til at arbejde med store mængder rådata, så den kan behandle en milliard linjer på mindre end et sekund, hvis du har mange kerner i dit system. Scanning af tidsseriepunkter i VictoriaMetrics er 50.000.000 punkter per sekund pr. kerne. Og denne ydeevne skalerer med de tilgængelige kerner. Det vil sige, hvis du har 20 kerner, får du for eksempel scanning af en milliard punkter per sekund. Og denne egenskab ved VictoriaMetrics og ClickHouse reducerer behovet for nedprøvning.
En anden egenskab er, at VictoriaMetrics effektivt komprimerer disse data. Komprimering ligger i gennemsnit fra 0,4 til 0,8 byte pr. punkt i produktion. Hvert punkt består af et tidsstempel + værdi. Og det komprimeres til mindre end en byte i gennemsnit.
Sergej. Jeg har et spørgsmål. Hvad er den mindste tidskvantum for registrering?
En millisekund. For nylig havde vi en samtale med andre databaseudviklere for tidsserier. Deres minimale tidskvantum er et sekund. I Graphite, for eksempel, er det også et sekund. I OpenTSDB er det også et sekund. I InfluxDB – nanosekund præcision. I VictoriaMetrics – en millisekund, fordi det er en millisekund i Prometheus. VictoriaMetrics blev oprindeligt udviklet som en remote storage for Prometheus. Men nu kan den også gemme data fra andre systemer.
Manden, jeg talte med, siger, at de har sekundær præcision — det er tilstrækkeligt for dem, fordi det afhænger af den type data, der gemmes i tidsseriedatabasen. Hvis det er DevOps-data eller data fra infrastruktur, hvor du indsamler dem med et interval på 30 sekunder til et minut, er sekundær præcision tilstrækkeligt, der er ikke behov for noget mindre. Men hvis du indsamler disse data fra højfrekvente handelssystemer, kræves der nanosekund præcision.
Millisekunders præcision i VictoriaMetrics er egnet til både DevOps-sager og kan være passende for de fleste de tilfælde, jeg nævnte i starten af præsentationen. Det eneste, det måske ikke er velegnet til, er high-frequency trading systemer.
Tak! Og endnu et spørgsmål. Hvad er kompatibiliteten i PromQL?
Fuld bagudkompatibilitet. VictoriaMetrics understøtter fuldt ud PromQL. Derudover tilføjer det også yderligere udvidet funktionalitet til PromQL kaldet . Med hensyn til denne udvidede funktionalitet er der et foredrag på YouTube. Jeg talte om det ved Monitoring Meetup i foråret i Sankt Petersborg.
Telegram-kanal .
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Hvad forhindrer dig i at gå over til VictoriaMetrics som en langsigtet opbevaring for Prometheus? (Skriv i kommentarer, jeg tilføjer det til afstemningen))
71,4%Bruger ikke Prometheus5
28,6%Vidste ikke om VictoriaMetrics2
7 brugere har stemt. 12 brugere har undladt at stemme.
Kilde: habr.com
