

I den første del fortalte vi, hvorfor vi besluttede at skifte det gamle BMS-system i vores datacentre til et nyt. Og ikke bare skifte, men udvikle det fra bunden til vores krav. I den anden del fortæller vi, hvordan vi gjorde det.
Markedsanalyse
Med de beskrevne ønsker og afgørelsen om at undlade opdatering af det eksisterende system, skrev vi en kravspecifikation til at finde en løsning på markedet og sendte anmodninger til flere store virksomheder, der kun beskæftiger sig med oprettelse af industrielle SCADA-systemer.
De første svar fra dem viste, at markedslederne inden for overvågningssystemer primært fortsatte med at arbejde på fysiske servere, selvom migrationsprocessen til skyen i denne sektor allerede var begyndt. Hvad angår reservering af virtuelle maskiner – denne mulighed blev ikke understøttet af nogen. Desuden virkede det som om, at ingen af de bemærkelsesværdige udviklere på markedet engang demonstrerede forståelsen af nødvendigheden af reservation: 'clouden falder jo ikke ned' var det mest almindelige svar. Faktisk blev vi tilbudt at placere overvågningen af datacentret i skyen, der fysisk var placeret i det samme datacenter.
Her skal vi lave et lille afsnit om processen med at vælge en entreprenør. Prisen betyder selvfølgelig noget, men under enhver udbudsrunde for implementeringen af et komplekst projekt, i dialogen med leverandørerne, begynder man at føle, hvem af kandidaterne der er mest interesseret og i stand til at realisere det.
Dette er især bemærkelsesværdigt ved komplekse projekter.
Ud fra karakteren af de afklarende spørgsmål til kravspecifikationen kan man opdele entreprenørerne i dem, der er interesserede i blot at sælge (man mærker det standard press fra salgsafdelingen) og dem, der er interesserede i at udvikle et produkt ved at høre og forstå kunden, foretage konstruktive ændringer i kravspecifikationen allerede inden det endelige valg (selv på trods af den reelle risiko for at forbedre andres kravspecifikation og miste udbuddet), til sidst blot dem, der er villige til at tage imod den professionelle udfordring og lave et godt produkt.
Alt dette fik os til at lægge mærke til en relativt lille lokal udvikler – gruppen af selskaber 'Sanline', som hurtigt opfyldte de fleste af vores krav og var klar til at imødekomme alle behov vedrørende det nye BMS.
Risici
Mens de store aktører forsøgte at forstå, hvad vi ønskede, og førte en langsom korrespondance med involvering af pre-sales specialister, indkaldte den lokale udvikler til et møde på vores kontor med deltagelse af sit tekniske team. Under dette møde demonstrerede leverandøren endnu en gang vilje til at deltage i projektet, og – vigtigst af alt – forklarede, hvordan det krævede system vil blive implementeret.
Før mødet identificerede vi to risici ved at arbejde med et team, som ikke har ressourcerne fra en stor national eller international virksomhed:
- Specialisterne kunne overvurdere deres evner og i sidste ende simpelthen ikke kunne klare opgaven, f.eks. blande kompliceret software eller designe urealiserbare backupsalgoritmer.
- Efter projektets afslutning kunne projektteamet opløses, hvilket ville sætte produktstøtten i fare.
For at minimere disse risici indkaldte vi vores egne udviklingsspecialister til mødet. Medarbejderne fra den potentielle leverandør blev omhyggeligt spurgt til, hvordan systemet blev bygget, hvordan backup ville blive implementeret og andre emner, hvor vi, som driftsteam, ikke var tilstrækkeligt kompetente.
Dommen var positiv: arkitekturen for den eksisterende BMS-platform er moderne, enkel og pålidelig, kan tilpasses, og den foreslåede backup- og synkroniseringsordning er logisk og funktionel.
Den første risiko blev håndteret. Den anden blev udelukket, da vi fik bekræftelse fra leverandøren om beredskabet til at overgive os kildekoden til systemet og dokumentationen, samt ved at vælge programmeringssproget Python, som vores specialister er godt bekendte med. Dette garanterede os muligheden for at vedligeholde systemet selv uden vanskeligheder og uden en lang indlæringsperiode for medarbejderne, hvis udviklingsfirmaet forlod markedet.
En ekstra fordel ved platformen var, at den blev implementeret i Docker-containere: i dette miljø fungerer kernen, webinterfacet og produktets database. Denne tilgang giver mange fordele, herunder forudinstallerede indstillinger for den højeste implementeringshastighed sammenlignet med "klassiskt" og nem tilføjelse af nye enheder til systemet. Princippet "alt sammen" forenkler i høj grad implementeringen af systemet: det er tilstrækkeligt at udpakkes systemet for straks at kunne tage det i brug.
Med en sådan løsning er det lettere at lave sikkerhedskopier af systemet, og forbedringer samt opgraderinger kan udføres i et separat miljø uden at stoppe arbejdet i løsningen som helhed.
Efter at begge risici var blevet minimeret, præsenterede entreprenøren et tilbud. I det blev alle de vigtigste parametre for os i BMS-systemet gennemarbejdet.
Redundans
Det nye BMS-system skulle være i skyen, på en virtuel maskine.
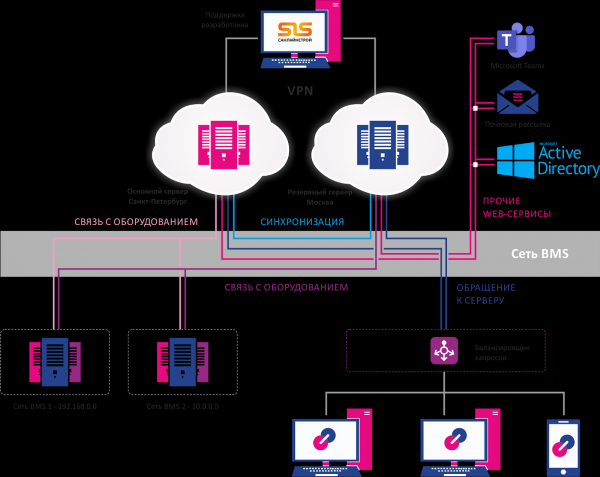
Ingen hardware, ingen servere og alle de ulemper og risici forbundet med denne implementeringsmodel – den cloud-løsning gjorde det muligt for os at slippe for dem for altid. Det blev besluttet, at systemet ville køre i vores cloud på to data center-lokationer i Sankt Petersborg og Moskva. Det er to fuldt funktionelle systemer, der kører i aktiv standby med adgang for alle autoriserede specialister.
De to systemer sikrer hinanden og giver fuld backup både i beregningskapacitet og datatransmissionskanaler. Der er også indført yderligere sikkerhedsforanstaltninger, herunder data- og kanalbackup, systemer, virtuelle maskiner generelt, og separat databackup én gang om måneden (den mest værdifulde ressource i perspektivet af administration og analyse).
Det skal understreges, at backup som en mulighed for BMS-løsningen blev udviklet specifikt efter vores anmodning. Selve backup-skemaet så således ud:
Support
Et vigtigt punkt for effektiv drift af BMS-løsningen er teknisk support.
Her er alt enkelt: det nye system ville koste os 35 000 rubler om måneden på dette parameter for SLA "reaktion inden for 8 timer", det vil sige 35 000 x 12 / 80 = $5 250 om året. Det første år er gratis.
Til sammenligning kostede supporten af den gamle BMS fra leverandøren $18.000 om året med en stigende pris for hver ny enhed, der blev tilføjet! Desuden stillede virksomheden ikke en dedikeret manager til rådighed; al kommunikation foregik gennem salgsmannen, som var interesseret i os som en potentiel køber med den tilsvarende fokus i behandling af anmodninger.
For færre penge fik vi fuld produktstøtte med en konto-manager, der ville deltage i produktudviklingen, med et enkelt kontaktpunkt osv. Støtten blev langt mere fleksibel – takket være direkte adgang til udviklerne for hurtige justeringer af alle aspekter af systemets funktion, integration via API osv.
Opdateringer
Ifølge det foreslåede tilbud i den nye BMS er alle opdateringer inkluderet i prisen for support og kræver derfor ikke ekstra betaling. Undtagelsen er udviklingen af ekstra funktionalitet ud over det, der er angivet i specifikationen.
Det gamle system krævede betaling både for opdatering af den indbyggede gratis software (som Java) og for fejlretning. Det var umuligt at undgå dette; uden opdateringer blev systemet generelt "langsomt" på grund af de gamle versioner af de interne komponenter.
Og selvfølgelig kunne man ikke opdatere softwaren uden at købe supportpakken.
Fleksibel tilgang
Et andet væsentligt krav gjaldt brugergrænsefladen. Vi ønskede at sikre adgang til den via webbrowser fra enhver lokation, uden at en tekniker nødvendigvis skulle være til stede i datacenteret. Derudover stræbte vi efter at oprette en animeret grænseflade, så dynamikken i infrastrukturen blev mere synlig for de vagthavende teknikere.
I det nye system var det også nødvendigt at sikre support for formler til beregning af data fra virtuelle sensorer i ingeniørsystemer – for eksempel til optimal fordeling af elektrisk kapacitet blandt udstyr i racks. For dette skal man have alle de velkendte matematiske operationer, der gælder for sensorværdier, til rådighed.
Derudover var der behov for adgang til SQL-databasen med mulighed for at hente de nødvendige data om udstyrets drift – specifikt alle optegnelser om overvågningen af to tusinde enheder og to tusinde virtuelle sensorer, der genererer cirka 20 tusinde variabler.
Der var også behov for en modul til udstyrsovervågning i rack, der giver en grafisk fremstilling af placeringen af enhederne i hver enhed med en opgørelse af den samlede vægt af "hardware", vedligeholdelse af et bibliotek med enheder og detaljeret information om hvert element.
Godkendelse af kravspecifikation og underskrift af kontrakt
På det tidspunkt, hvor det var nødvendigt at påbegynde arbejdet på det nye system, var kommunikationen med de "store" virksomheder stadig meget langt fra at diskutere priserne på deres tilbud, så vi sammenlignede det modtagne tilbud med omkostningerne ved at opgradere det gamle BMS (se. ), og resultatet viste sig at være mere prisattraktivt og i overensstemmelse med vores krav.
Valget blev truffet.
Efter valget af entreprenør begyndte juristerne at udarbejde kontrakten, mens de tekniske teams fra begge sider finpudsede kravspecifikationen. Som bekendt er en detaljeret og korrekt kravspecifikation grundlaget for enhver succesfuld opgave. Jo mere konkret kravspecifikationen er, desto færre skuffelser som "men vi ville ikke have det sådan".
Her er to eksempler på detaljegraden af kravene i kravspecifikationen:
- Døgnvagterne i datacentrene har beføjelse til at tilføje nye enheder til BMS, oftest PDU'er. I det gamle BMS var dette niveau "administrator", hvilket også tillod ændring af indstillingerne for alle enheder, og det var umuligt at adskille funktioner. Det var vi ikke tilfredse med. I den eksisterende basisversion af den nye platform var skemaet dog analogt. Vi angav straks i kravspecifikationen, at vi ønskede at adskille disse roller: indstillingerne skulle kun ændres af en bemyndiget medarbejder, men døgnvagterne skulle fortsat have mulighed for at tilføje enheder. Dette skema blev godkendt til implementering.
- I enhver standard BMS er der tre typiske kategorier af meddelelser: RØD – der skal straks reagere, GUL – kan overvåges, BLÅ – „Informations“. Vi har traditionelt brugt „blå“ meddelelser til at overvåge overskridelse af kommercielle parametre, for eksempel overskridelse af strømmens grænse for kundens rack. Denne type meddelelser var i vores tilfælde beregnet til ledere og var ikke interessant for driftstjenesten, men i den gamle BMS fyldte de regelmæssigt listen over aktive hændelser og hæmmede det operative arbejde. Vi fandt selve logikken og den farvemæssige differentiering af meddelelserne vellykket og bevarede den, men specificerede i kravspecifikationerne, at „blå“ meddelelser skulle diffuse stille i et separat afsnit uden at forstyrre vagtpersonalet, hvor de ville blive håndteret af kommercielle specialister.
Med tilsvarende detaljegrad blev formaterne for opbygning af diagrammer og rapportering, grænsefladerne, listen over enheder, der skulle overvåges, og mange andre ting nedskrevet.
Det var et virkelig kreativt arbejde for tre arbejdsgrupper – bestillingstjenesten, som dikterede sine krav og betingelser; tekniske specialister fra begge sider, hvis opgave var at omforme disse betingelser til teknisk dokumentation; og programmeringsteamet fra entreprenøren, der implementerede kundens krav baseret på den udarbejdede tekniske dokumentation… I sidste ende tilpassede vi nogle af vores ikke-principielle krav til funktionaliteten af den allerede eksisterende platform, mens entreprenøren forpligtede sig til at skrive yderligere til os.
Parallel drift af to systemer
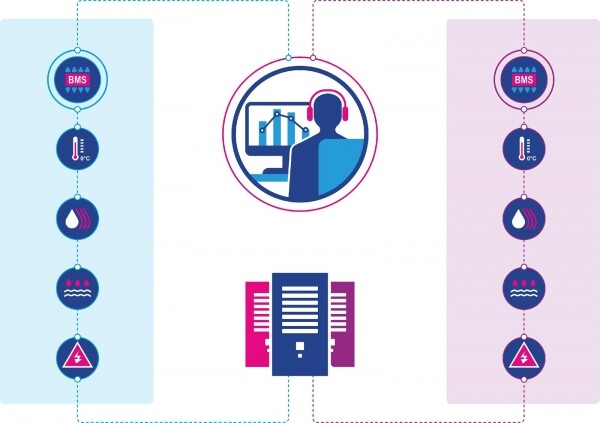
Det var tid til implementering. I praksis betød det, at vi gav entreprenøren mulighed for at implementere en prototype af BMS i vores virtuelle sky og tilbyde netværksadgang til alle de enheder, der krævede overvågning.
På samme tid var det nye system endnu ikke klar til drift. På dette stadium var det vigtigt for os at bevare overvågningen i det gamle system, samtidig med at vi gav adgang til enhederne i det nye system. Det er umuligt at opbygge et system ordentligt, uden at se de enheder, som ikke kan frakobles overvågningen fra det gamle system.
Det var ikke indlysende, om enheder ville kunne klare en samtidig forespørgsel fra to systemer uden reelle tests. Der var en sandsynlighed for, at en dobbelt samtidig forespørgsel ville føre til hyppige svarfejl fra enhederne, hvilket ville resultere i et væld af fejl angående utilgængelighed af enheder, og dermed blokere den gamle overvågningssystem.
Netværksafdelingen har oprettet virtuelle ruter fra prototypen af det nye BMS, der er implementeret i skyen, til enhederne, og vi har fået resultaterne:
- enheder, der er tilsluttet via SNMP-protokollen, udgik praktisk talt ikke i disconnect på grund af samtidige forespørgsler,
- enheder, der er tilsluttet via gateways med modbus-TCP-protokoller, havde problemer, som blev løst ved fornuftigt at reducere frekvensen af deres forespørgsler.
Og så begyndte vi at observere, hvordan et nyt system blev bygget lige foran vores øjne, hvor de enheder, vi allerede kendte, dukker op, men i et andet interface – praktisk, hurtigt, tilgængeligt selv fra en telefon.
Vi vil fortælle om slutresultatet i den tredje del af vores artikel.
Kilde: habr.com
