

Denne artikel hjælper med at forstå, hvordan lastbalancering fungerer i Kubernetes, hvad der sker ved skalering af langvarige forbindelser, og hvorfor det er værd at overveje lastbalancering på klientsiden, hvis du bruger HTTP/2, gRPC, RSockets, AMQP eller andre langvarige protokoller.
Lidt om, hvordan trafikken omfordeles i Kubernetes
Kubernetes tilbyder to nyttige abstraktioner til udrulning af applikationer: tjenester (Services) og udrulninger (Deployments).
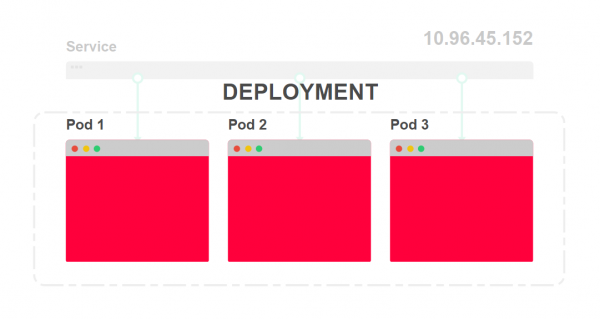
Udrulninger beskriver, hvordan og hvor mange kopier af din applikation der skal være kørende på ethvert givet tidspunkt. Hver applikation udrules som en pod (Pod) og tildeles en IP-adresse.
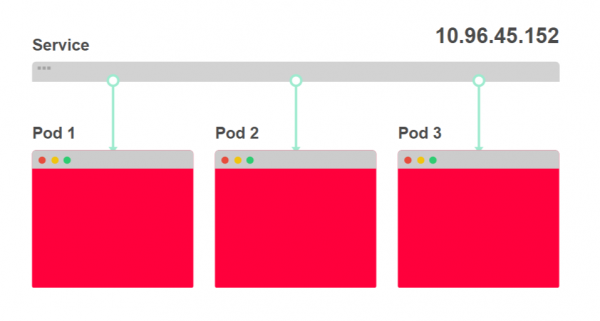
Tjenester fungerer på en måde som en lastbalancer. De er designet til at fordele trafikken over mange pods.
Lad os se, hvordan det ser ud.
- På diagrammet nedenfor ser du tre instanser af en applikation og en lastbalancer:

- Lastbalanceren kaldes en tjeneste (Service), og den tildeles en IP-adresse. Enhver indkommende anmodning omdirigeres til en af pods:

- Udrulningsscenariet definerer antallet af instanser af applikationen. Du vil næsten aldrig skulle udrulle direkte en pod:

- Hver pod tildeles sin egen IP-adresse:

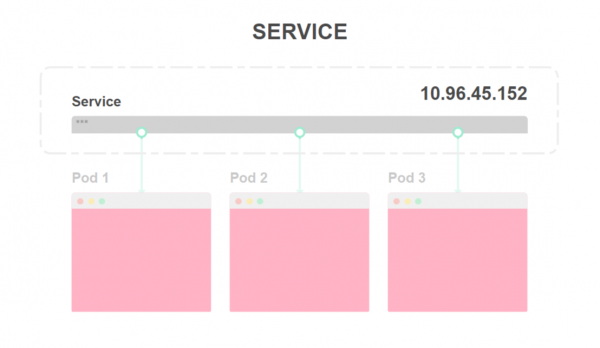
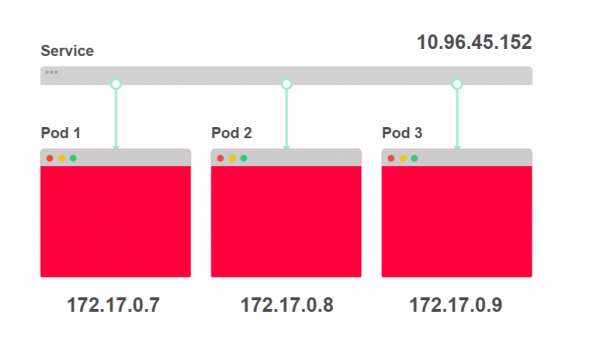
Det er nyttigt at betragte tjenester som et sæt IP-adresser. Hver gang du tilgår en tjeneste, vælges en af IP-adresserne fra listen og bruges som destinationsadresse.
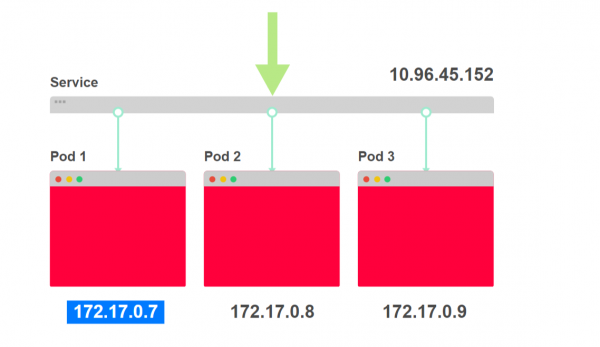
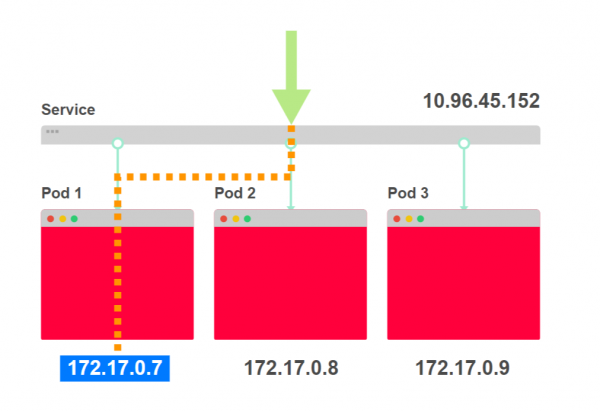
Det ser således ud.
- Der kommer en anmodning curl 10.96.45.152 til tjenesten:

- Tjenesten vælger en af de tre pod-adresser som destination:

- Tra fik omdirigeres til en bestemt pod:


Hvis din applikation består af en frontend og en backend, vil du have både en tjeneste og en udrulning for hver.
Når frontenden sender en anmodning til backenden, behøver den ikke vide, hvor mange pods backenden betjener: det kan være en, ti, eller hundrede.
Frontenden ved heller ikke noget om adresserne på de pods, der betjener backenden.
Når frontenden sender en anmodning til backenden, bruger den IP-adressen på backenden's tjeneste, som ikke ændres.
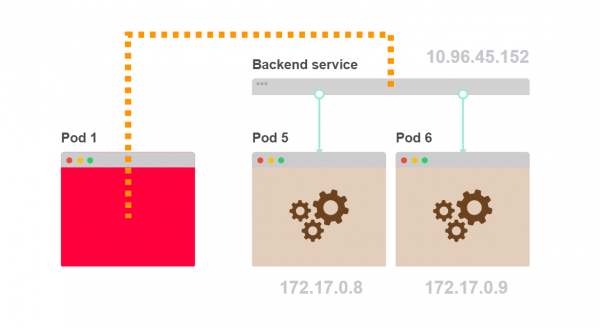
Sådan ser det ud.
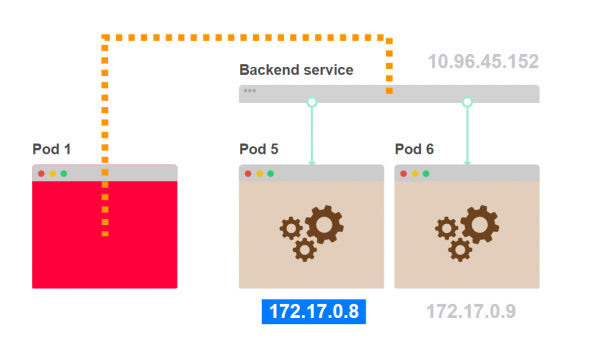
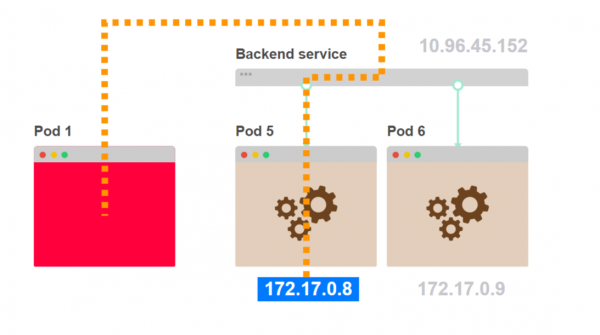
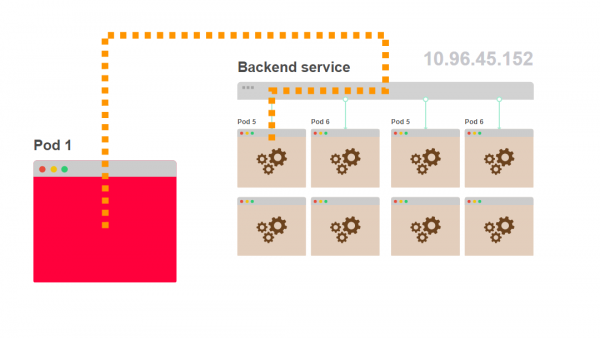
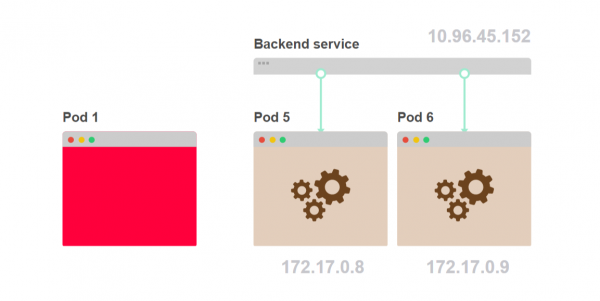
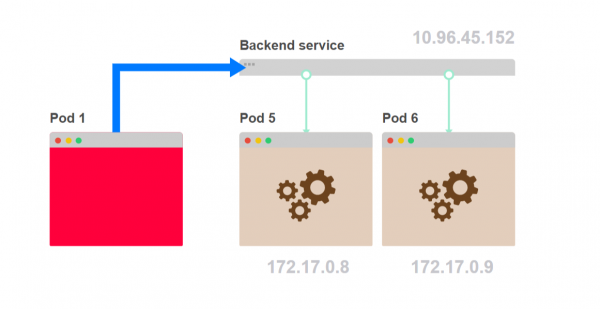
- Pod 1 anmoder en intern backend-komponent. I stedet for at vælge en specifik backend-pod, sender den en anmodning til tjenesten:

- Tjenesten vælger en af backend-poddene som destinationsadresse:

- Traffikken går fra pod 1 til pod 5, valgt af tjenesten:

- Pod 1 ved ikke, hvor mange sådanne pods som pod 5 der er gemt bag tjenesten:

Men hvordan distribuerer tjenesten anmodningerne? Bruges der round-robin belastningsfordeling? Lad os finde ud af det.
Belastningsfordeling i Kubernetes-tjenester
Kubernetes-tjenester eksisterer ikke. Der er ingen proces, der får tildelt en IP-adresse og port for tjenesten.
Du kan bekræfte dette ved at gå til en hvilken som helst node i klyngen og udføre kommandoen netstat -ntlp.
Du vil endda ikke kunne finde den IP-adresse, der er tildelt tjenesten.
Tjenestens IP-adresse er placeret i kontrollaget, i controlleren, og er gemt i databasen — etcd. Denne adresse bruges også af en anden komponent — kube-proxy.
Kube-proxy modtager en liste over IP-adresser for alle tjenester og danner et sæt iptables-regler på hver node i klyngen.
Disse regler siger: "Hvis vi ser tjenestens IP-adresse, skal vi ændre destinationsadressen for anmodningen og sende den til en af poddene."
Tjenestens IP-adresse bruges kun som indgangspunkt og betjenes ikke af nogen proces, der lytter til denne IP-adresse og port.
Lad os se på dette.
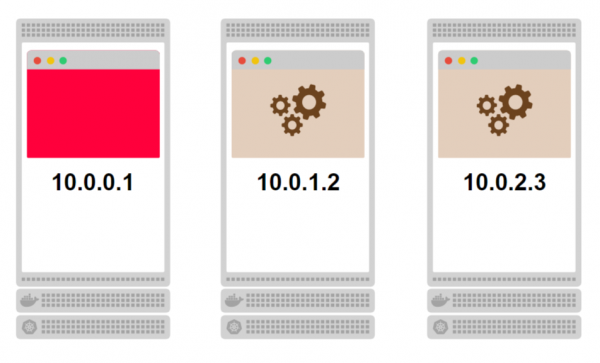
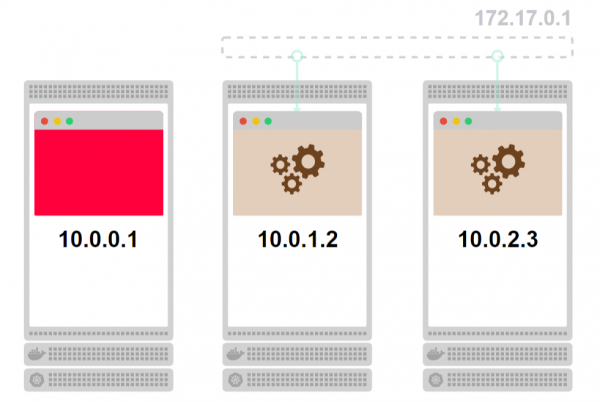
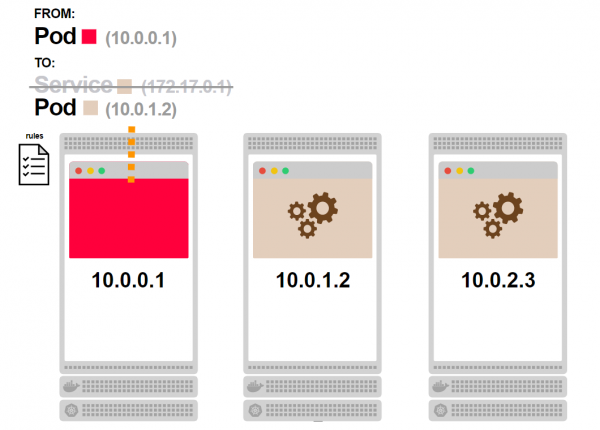
- Lad os overveje en klynge med tre noder. På hver node er der pods:

- De relaterede pods, farvet beige, er en del af tjenesten. Da tjenesten ikke eksisterer som en proces, vises den i grå:

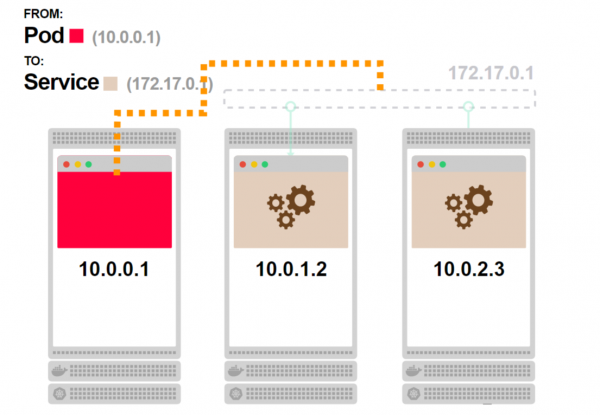
- Den første pod anmoder om tjenesten og skal ramme en af de relaterede pods:

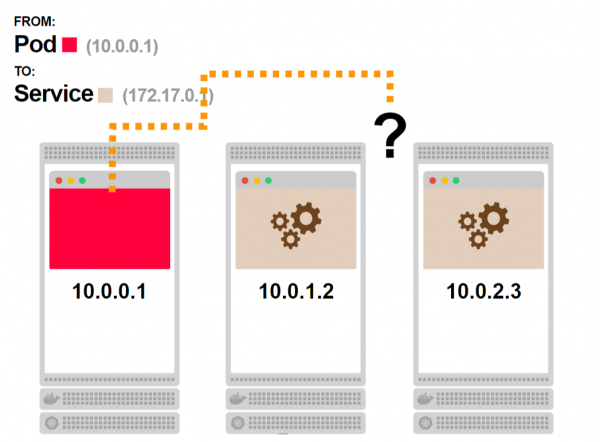
- Men tjenesten eksisterer ikke, der er ingen proces. Hvordan fungerer det så?

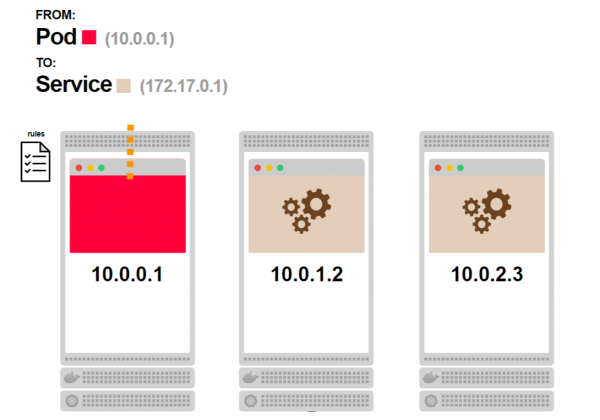
- Før anmodningen forlader noden, går den gennem iptables-reglerne:

- Iptables-reglerne ved, at der ikke er nogen tjeneste, og erstatter dens IP-adresse med en af IP-adresserne fra de pods, der er forbundet med denne tjeneste:

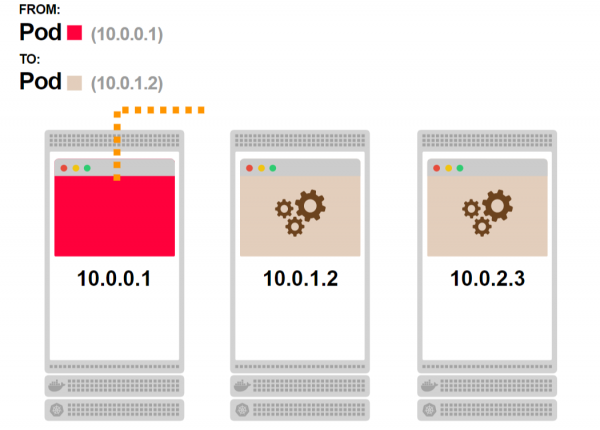
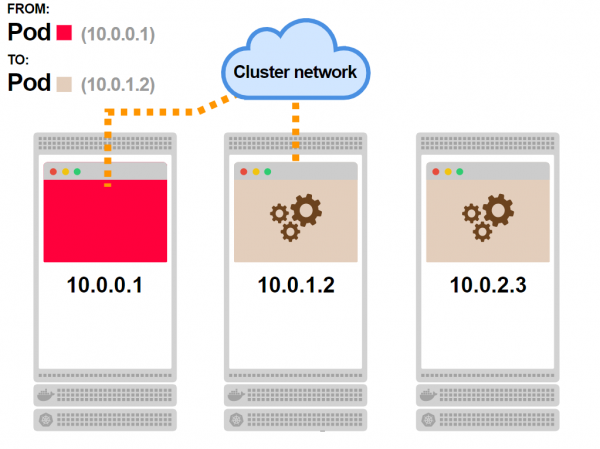
- Anmodningen får en gyldig IP-adresse som destinationsadresse og behandles normalt:
- Afhængigt af netværkstopologien når anmodningen til sidst pod'en:

Kan iptables balancere belastningen?
Nej, iptables bruges til filtrering og blev ikke designet til belastningsbalancering.
Der er dog mulighed for at skrive et sæt regler, der fungerer som en .
Og det er præcis det, der er implementeret i Kubernetes.
Hvis du har tre pods, vil kube-proxy skrive de følgende regler:
- Vælg den første pod med 33 % sandsynlighed, ellers gå videre til næste regel.
- Vælg den anden pod med 50 % sandsynlighed, ellers gå videre til næste regel.
- Vælg den tredje pod.
Sådan et system fører til, at hver pod vælges med en sandsynlighed på 33%.
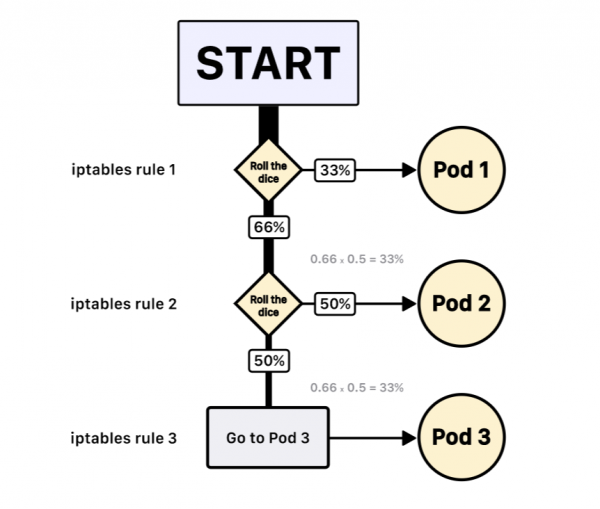
Og der er ingen garanti for, at pod 2 vil blive valgt efter pod 1.
Bemærk: iptables bruger en statistisk modul med tilfældig distribution. Således er balanceringsalgoritmen baseret på tilfældig valg.
Nu hvor du forstår, hvordan tjenester fungerer, lad os se på mere interessante scenarier.
Langvarige forbindelser i Kubernetes skaleres ikke som standard.
Hver HTTP-anmodning fra frontend til backend håndteres af en separat TCP-forbindelse, som åbnes og lukkes.
Hvis frontend sender 100 anmodninger pr. sekund til backend, åbnes og lukkes 100 forskellige TCP-forbindelser.
Du kan reducere behandlingstiden for anmodninger og mindske belastningen ved at åbne én TCP-forbindelse og bruge den til alle efterfølgende HTTP-anmodninger.
I HTTP-protokollen er der indbygget en mulighed kaldet HTTP keep-alive eller genbrug af forbindelsen. I dette tilfælde bruges én TCP-forbindelse til at sende og modtage mange HTTP-anmodninger og svar:
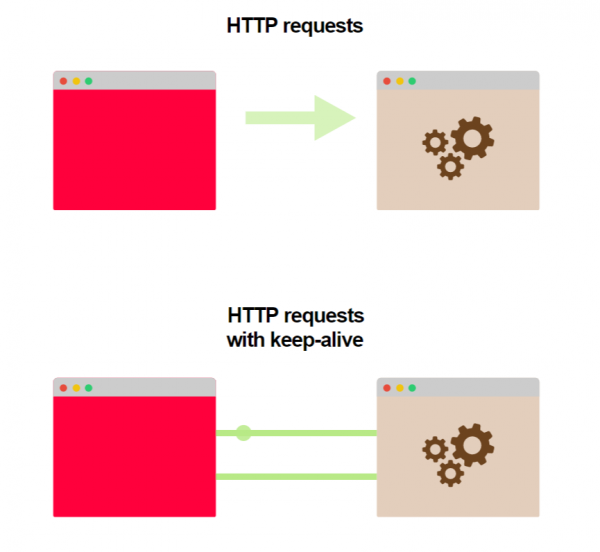
Denne funktion er ikke aktiveret som standard: både server og klient skal konfigureres korrekt.
Selve konfigurationen er simpel og tilgængelig for de fleste programmeringssprog og miljøer.
Her er nogle links til eksempler på forskellige sprog:
Hvad vil der ske, hvis vi bruger keep-alive i en Kubernetes-tjeneste?
Lad os antage, at både frontend og backend understøtter keep-alive.
Vi har én kopi af frontend og tre instanser af backend. Frontend sender den første anmodning og åbner en TCP-forbindelse til backend. Anmodningen når tjenesten, og en af backend-pods vælges som destinationsadresse. Pod'en i backend sender svaret, og frontend modtager det.
I modsætning til en almindelig situation, hvor TCP-forbindelsen lukkes efter modtagelse af svaret, holdes den nu åben til de næste HTTP-anmodninger.
Hvad vil der ske, hvis frontend sender flere anmodninger til backend?
For forwarding these requests, an open TCP connection will be used; all requests will go to the same backend pod where the first request went.
Shouldn’t iptables redistribute the traffic?
Not in this case.
When a TCP connection is established, it goes through iptables rules, which select the specific backend pod to which the traffic will be directed.
Since all subsequent requests go through the already open TCP connection, the iptables rules are no longer triggered.
Lad os se, hvordan det ser ud.
- The first pod sends a request to the service:

- You already know what will happen next. The service does not exist, but there are iptables rules that will process the request:
- One of the backend pods will be chosen as the destination address:

- The request reaches the pod. At this moment, a persistent TCP connection between the two pods will be established:

- Any subsequent request from the first pod will go through the already established connection:

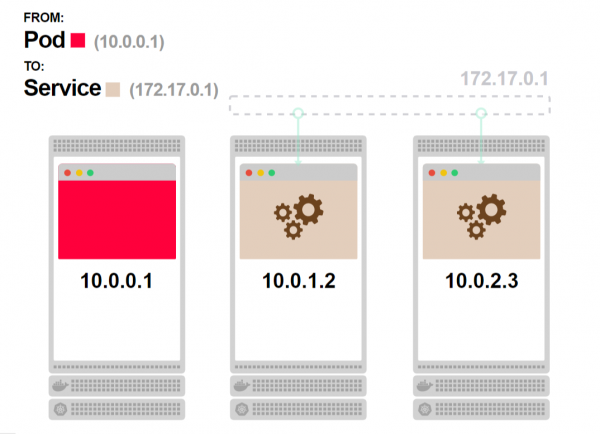
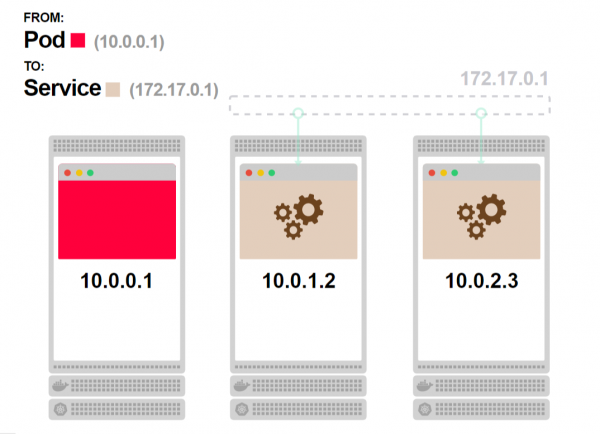
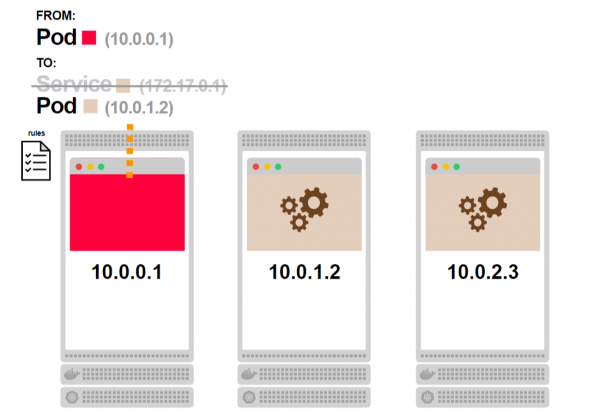
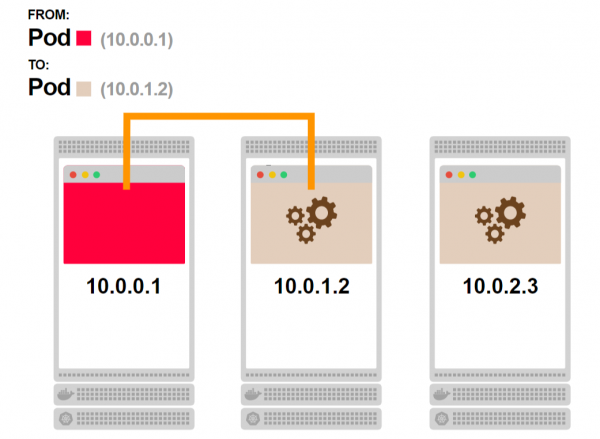
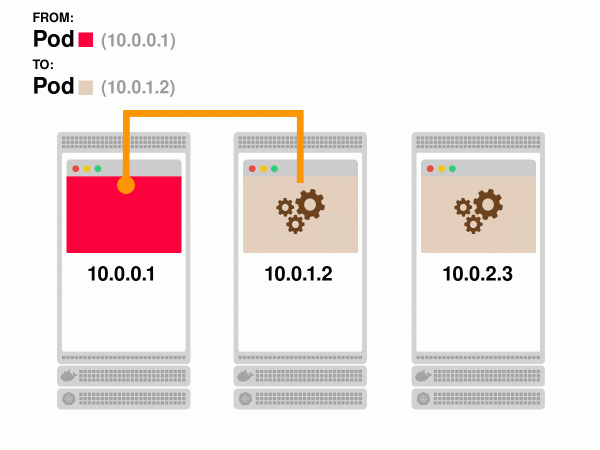
As a result, you get a faster response and higher throughput, but lose the ability to scale the backend.
Even if you have two pods in the backend, with a persistent connection, the traffic will always go to one of them.
Can this be fixed?
Since Kubernetes does not know how to balance persistent connections, this task falls to you.
Services are a set of IP addresses and ports known as endpoints.
Your application can get the list of endpoints from the service and decide how to distribute requests among them. You can open a persistent connection with each pod and balance requests between these connections using round-robin.
Or apply more .
The client-side code responsible for balancing should follow this logic:
- Get the list of endpoints from the service.
- For each endpoint, open a persistent connection.
- When a request needs to be made, use one of the open connections.
- Regularly update the list of endpoints, create new or close old persistent connections when the list changes.
Here’s how it will look.
- Instead of the first pod sending a request to the service, you can balance requests on the client side:

- You need to write code that asks which pods are part of the service:

- Så snart du har fået listen, skal du gemme den på klientsiden og bruge den til at oprette forbindelse til pods:

- Du er selv ansvarlig for load balancing-algoritmen:
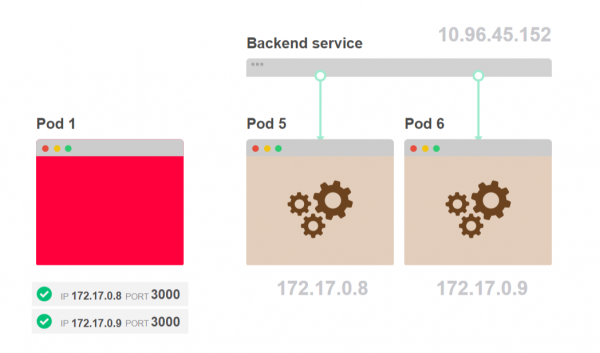
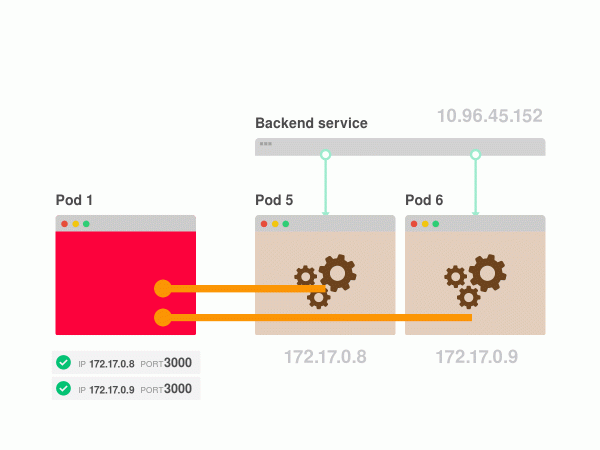
Der opstår nu et spørgsmål: gælder dette problem kun for HTTP keep-alive?
Load balancing på klientsiden
HTTP er ikke den eneste protokol, der kan have permanente TCP-forbindelser.
Hvis din applikation bruger en database, åbnes TCP-forbindelsen ikke hver gang, du behøver at udføre en forespørgsel eller hente et dokument fra databasen.
I stedet åbnes og anvendes en permanent TCP-forbindelse til databasen.
Hvis din database er distribueret i Kubernetes, og adgangen gives som en service, vil du støde på de samme problemer, som er beskrevet i det foregående afsnit.
Én database-replika vil være mere belastet end de andre. Kube-proxy og Kubernetes vil ikke hjælpe med at balancere forbindelserne. Du skal tage dig af balanceringen af forespørgsler til din database.
Afhængigt af hvilken biblioteks du bruger til at oprette forbindelse til databasen, kan der være forskellige muligheder for at løse dette problem.
Her er et eksempel på adgang til MySQL databaseklassen fra Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* hent endpoints fra tjenesten */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Udfør forespørgsler til den klyngede MySQL-database
Der er mange andre protokoller, der bruger permanente TCP-forbindelser:
- WebSockets og sikrede WebSockets
- HTTP/2
- gRPC
- RSockets
- AMQP
Du bør allerede være fortrolig med de fleste af disse protokoller.
Men hvis disse protokoller er så populære, hvorfor findes der så ingen standardiseret løsning til load balancing? Hvorfor kræves der ændringer i klientlogikken? Findes der en indfødt løsning til Kubernetes?
Kube-proxy og iptables er designet til at dække de fleste standard brugsscenarier ved implementering i Kubernetes. Dette er gjort for bekvemmelighedens skyld.
Hvis du bruger en webservice, der tilbyder REST API, er du heldig — i dette tilfælde bruges der ikke permanente TCP-forbindelser, og du kan bruge enhver Kubernetes-service.
Men så snart du begynder at bruge permanente TCP-forbindelser, skal du finde ud af, hvordan du jævnt fordeler belastningen på backends. Kubernetes indeholder ikke nogen færdige løsninger til dette.
Men selvfølgelig eksisterer der muligheder, der kan hjælpe.
Forvaltning af langvarige forbindelser i Kubernetes
I Kubernetes findes der fire typer tjenester:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
De første tre tjenester fungerer på baggrund af en virtuel IP-adresse, som kube-proxy bruger til at oprette iptables-regler. Men den fundamentale base for alle tjenester er headless-tjenesten.
Med headless-tjenesten er der ingen tilknyttet IP-adresse, og den giver kun en mekanisme til at hente en liste over IP-adresser og porte tilknyttet dens pods (endepunkter).
Alle tjenester er baseret på headless-tjenesten.
ClusterIP-tjenesten er en headless-tjeneste med nogle tilføjelser:
- Kontrollaget tildeler den en IP-adresse.
- Kube-proxy opretter de nødvendige iptables-regler.
På den måde kan du ignorere kube-proxy og direkte bruge listen af endepunkter, der er modtaget fra headless-tjenesten til belastningsbalancering i din applikation.
Men hvordan tilføjer man sådan logik til alle applikationer, der er implementeret i klyngen?
Hvis din applikation allerede er implementeret, kan denne opgave synes umulig. Men der er et alternativ.
Service Mesh kan hjælpe dig
Du har sikkert allerede bemærket, at klientbaseret belastningsbalancering er temmelig standard.
Når applikationen startes, så:
- Henter den en liste over IP-adresser fra tjenesten.
- Åbner og opretholder en pulje af forbindelser.
- Opdaterer periodisk puljen ved at tilføje eller fjerne endepunkter.
Når applikationen ønsker at foretage en anmodning, så:
- Vælger den en tilgængelig forbindelse ved hjælp af en eller anden logik (f.eks. round-robin).
- Udfører anmodningen.
Disse trin fungerer både for WebSockets-, gRPC- og AMQP-forbindelser.
Du kan isolere denne logik i et separat bibliotek og bruge det i dine applikationer.
Men i stedet kan du bruge service mesh, såsom Istio eller Linkerd.
Service Mesh supplerer din applikation med en proces, der:
- Automatisk søger efter IP-adresser til tjenester.
- Tjekker forbindelser, såsom WebSockets og gRPC.
- Balancerer anmodninger ved hjælp af det rigtige protokol.
Service Mesh hjælper med at forvalte trafikken inden i klyngen, men det er ret ressourcekrævende. Andre muligheder er at bruge tredjeparts biblioteker, som Netflix Ribbon, eller programmerbare proxyer, som Envoy.
Hvad sker der, hvis man ignorerer spørgsmålene omkring belastningsbalancering?
Du kan undgå at bruge belastningsfordeling og stadig ikke bemærke nogen ændringer. Lad os se på nogle arbejdsscenarier.
Hvis du har flere kunder end servere, er det ikke så stort et problem.
Lad os antage, at der er fem kunder, der forbinder til to servere. Selv uden belastningsfordeling vil begge servere blive brugt:
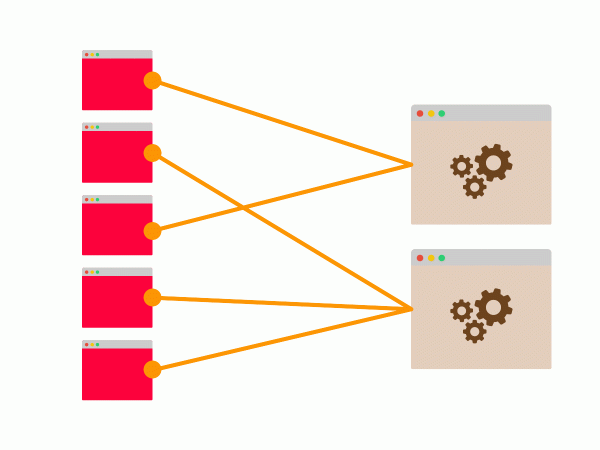
Forbindelserne kan være ujævnt fordelte: muligvis har fire kunder sluttet sig til den samme server, men der er en god chance for, at begge servere vil være i brug.
Det mere problematiske er det modsatte scenarie.
Hvis du har færre kunder og flere servere, kan dine ressourcer blive underudnyttet, og der kan opstå et potentielt flaskehals.
Lad os antage, at der er to kunder og fem servere. I bedste fald vil der være to vedvarende forbindelser til to ud af de fem servere.
De øvrige servere vil stå stille:
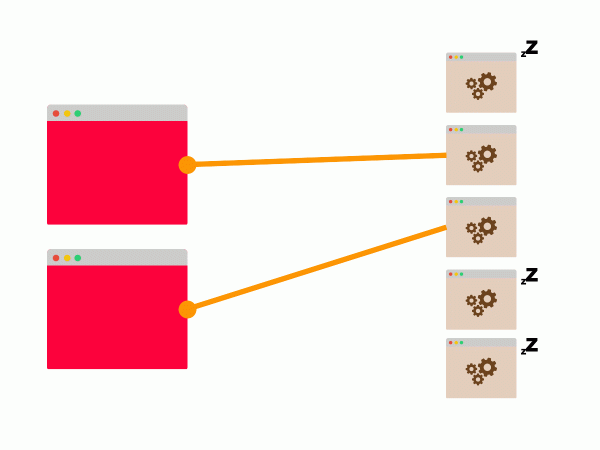
Hvis disse to servere ikke kan håndtere kundeanmodningerne, vil horisontal skalering ikke hjælpe.
Konklusion
Kubernetes-tjenester er designet til at fungere i de fleste standard websigthængende scenarier.
Men så snart du begynder at arbejde med applikationsprotokoller, der bruger vedvarende TCP-forbindelser, såsom databaser, gRPC eller WebSockets, passer tjenesterne ikke længere. Kubernetes tilbyder ikke indbyggede mekanismer til at balancere vedvarende TCP-forbindelser.
Det betyder, at du skal skrive applikationer med henblik på klientbaseret belastningsfordeling.
Oversættelsen er udført af teamet .
Andre artikler om emnet:
- .
- .
- .
Kilde: habr.com
