

Som IPv4-adresserne bliver udtømt, står mange teleoperatører over for nødvendigheden af at organisere adgang til nettet for deres kunder gennem adresseoversættelse. I denne artikel vil jeg forklare, hvordan man kan opnå ydeevne på niveau med Carrier Grade NAT på commodity-servere.
Lidt historie
Temaet om udtømning af IPv4-adressens rum er ikke nyt. På et tidspunkt opstod der ventelister i RIPE, og derefter dukkede der markeder op, hvor blokke af adresser blev handlet og lejeaftaler blev indgået. Langsomt begyndte teleoperatører at tilbyde internetadgang ved hjælp af adresse- og portoversættelse. Nogle havde ikke fået nok adresser til at give hver kunde en 'hvid' adresse, mens andre begyndte at spare penge ved at afstå fra at købe adresser på det sekundære marked. Producenterne af netværksudstyr støttede denne idé, da denne funktion normalt kræver ekstra udvidelseskort eller licenser. For eksempel, hos Juniper i deres MX-routerline (bortset fra de nyeste MX104 og MX204) kan man udføre NAPT på et separat servicekort MS-MIC, på Cisco ASR1k kræves en CGN-licens, og på Cisco ASR9k kræves et separat modul A9K-ISM-100 samt licensen A9K-CGN-LIC. Generelt koster det en del penge.
IPTables
Opgaven med at udføre NAT kræver ingen specialiserede beregningsressourcer, da almindelige CPU'er, som dem der findes i enhver hjemmerouter, kan løse den. I teleoperatørernes skala kan denne opgave løses ved hjælp af commodity-servere, der kører FreeBSD (ipfw/pf) eller GNU/Linux (iptables). Vi vil ikke overveje FreeBSD, da jeg har opgivet at bruge dette operativsystem for længere tid siden, så lad os fokusere på GNU/Linux.
Det er slet ikke svært at aktivere adresseoversættelse. Først skal du skrive en regel i iptables ind i nat-tabellen:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Operativsystemet vil indlæse modulet nf_conntrack, som vil overvåge alle aktive forbindelser og udføre de nødvendige transformationer. Der er flere nuancer. For det første, da det drejer sig om NAT i operatørens skala, skal timeouts justeres, fordi med standardindstillingerne vil størrelsen på oversættelsestabellen hurtigt vokse til katastrofale niveauer. Nedenfor er et eksempel på indstillinger, som jeg har brugt på mine servere:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
For det andet, da størrelsen på oversættelsestabellen som standard ikke er beregnet til at fungere under en operatør, skal den øges:
net.netfilter.nf_conntrack_max = 3145728
Det er også nødvendigt at øge antallet af buckets til hash-tabellen, der gemmer alle oversættelser (dette er en mulighed i modulet nf_conntrack):
options nf_conntrack hashsize=1572864
Efter disse enkle manipulationer får man en fuldt fungerende konstruktion, der kan oversætte et stort antal klientadresser til en pulje af eksterne adresser. Men ydeevnen af denne løsning er ikke tilfredsstillende. I mine første forsøg med at bruge GNU/Linux til NAT (omkring 2013) kunne jeg opnå en ydeevne på omkring 7 Gbit/s ved 0,8 Mpps på en server (Xeon E5-1650v2). Siden da er der foretaget mange forskellige optimeringer i det netværksstak i GNU/Linux-kernen, og ydeevnen på en enkelt server med den samme hardware er steget til næsten 18-19 Gbit/s ved 1,8-1,9 Mpps (dette var grænseværdier), men behovet for den mængde trafik, der behandles af en enkelt server, er steget meget hurtigere. Som et resultat er der udviklet lastbalanceringsordninger for forskellige servere, men alt dette har øget kompleksiteten ved konfiguration, vedligeholdelse og sikring af kvalitetsservice.
NFTables
I dag er en populær trend inden for programmering af 'pakkeomlægning' brugen af DPDK og XDP. Der er skrevet mange artikler om dette emne, lavet forskellige præsentationer, og kommercielle produkter som SKAT fra VasExperts er begyndt at dukke op. Men i en situation med begrænsede ressourcer blandt programmører hos teleoperatører kan det være ret problematisk at udvikle en eller anden 'løsning' baseret på disse rammer selv. Det vil også være meget sværere at implementere en sådan løsning senere hen, især da der vil være behov for at udvikle diagnostiske værktøjer. For eksempel vil standard tcpdump ikke fungere med DPDK, og pakker sendt tilbage i ledningerne med XDP vil den ikke 'se'. Bag alle samtalerne om nye teknologier til at sende pakker til user-space er der blevet overset og Pablo Neira Ayuso, vedligeholder af iptables, om udviklingen af flow offloading i nftables. Lad os se nærmere på denne mekanisme.
Den grundlæggende idé er, at hvis routeren har ladet pakker fra én session passere i begge retninger af strømmen (TCP-sessionen er gået ind i tilstanden ESTABLISHED), er der ikke behov for at lade de følgende pakker fra denne session gå gennem alle firewall-reglerne, da alle disse kontroller alligevel vil ende med at sende pakken videre til routing. Og valget af rute behøver faktisk ikke at udføres — vi ved allerede, hvilken interface og hvilken vært pakkerne skal videresendes til inden for denne session. Der er kun behov for at gemme denne information og bruge den til routing i den tidlige fase af pakkebehandlingen. Ved udførelse af NAT er det nødvendigt yderligere at gemme information om ændringerne af adresser og porte, som er blevet transformeret af modulet nf_conntrack. Ja, selvfølgelig vil forskellige polysere og andre informations- og statistiske regler i iptables stoppe med at fungere, men i forbindelse med opgaven med en separat NAT eller f.eks. en border-router er det ikke så vigtigt, fordi tjenesterne er distribueret på enhederne.
Konfiguration
For at bruge denne funktion skal vi:
- Brug et opdateret kerne. Selvom funktionen selv blev introduceret i kerne 4.16, var den i lang tid meget 'rå' og forårsagede regelmæssigt kernel panic. Alt stabiliserede sig omkring december 2019, da LTS kernerne 4.19.90 og 5.4.5 blev udgivet.
- Skriv iptables-regler om til nftables-format, ved hjælp af en tilstrækkelig ny version af nftables. Det fungerer perfekt i version 0.9.0.
Hvis det første punkt i det hele taget er forståeligt, er det vigtigste at huske at aktivere modulet i konfigurationen under opbygningen (CONFIG_NFT_FLOW_OFFLOAD=m), så kræver det andet punkt forklaring. Reglerne i nftables beskrives slet ikke på samme måde som i iptables. dækker næsten alle aspekter, og der er også specielle af regler fra iptables til nftables. Derfor vil jeg kun vise et eksempel på konfiguration af NAT og flow offload. En kort legende til eksemplet: <i_if>, <o_if> — disse er de netværksgrænseflader, som trafikken går gennem; der kan faktisk være mere end to af dem. <pool_addr_start>, <pool_addr_end> — start- og slutadresse for intervallet af "hvide" adresser.
NAT-konfigurationen er meget enkel:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Forskellen med flow offload er lidt mere kompliceret, men helt forståelig:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Og det er selve konfigurationen. Nu vil al TCP/UDP-trafik blive sendt til fastnat-tabellen og behandlet meget hurtigere.
Resultater
For at illustrere, hvor meget hurtigere det er, vil jeg vedlægge et screenshot af belastningen på to faktiske servere, med identisk hardware (Xeon E5-1650v2), ens konfigurationer, der bruger den samme Linux-kerne, men udfører NAT i iptables (NAT4) og nftables (NAT5).
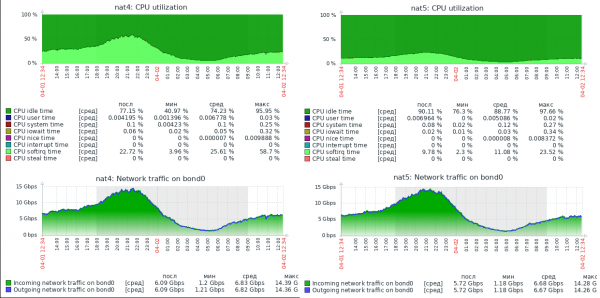
Screenshotet viser ikke grafen for pakker pr. sekund, men i belastningsprofilen for disse servere er den gennemsnitlige pakkestørrelse omkring 800 byte, så værdierne når op på 1.5Mpps. Som man kan se, har serveren med nftables en enorm performance-reserve. I øjeblikket håndterer denne server op til 30Gbit/s ved 3Mpps, og den er tydeligt i stand til at nå den fysiske netværksgrænse på 40Gbps, mens den stadig har ledige CPU-ressourcer.
Jeg håber, dette materiale vil være nyttigt for netværksingeniører, der prøver at forbedre deres serveres ydeevne.
Kilde: habr.com
