

Mit navn er Denis Rozhkov, jeg er leder af softwareudvikling i virksomheden «Gazinformservice», i produktteamet. . Lovgivning og virksomhedsnormer stiller visse krav til sikkerheden om opbevaring af data. Ingen ønsker, at tredjeparter får adgang til fortrolige oplysninger, derfor er følgende spørgsmål vigtige for ethvert projekt: identifikation og autentificering, adgangsstyring til data, sikring af informationsintegritet i systemet, registrering af sikkerhedshændelser. Derfor vil jeg gerne tale om nogle interessante aspekter vedrørende sikkerheden af database-systemer.
Artiklen er forberedt ud fra et oplæg til arrangeret . Hvis du ikke ønsker at læse, kan du se:
Artiklen vil have tre dele:
- Hvordan man beskytter forbindelser.
- Hvad er handlingaudit, og hvordan man registrerer, hvad der sker fra databasen og dens forbindelser.
- Hvordan man beskytter data i selve databasen, og hvilke teknologier der findes til dette.
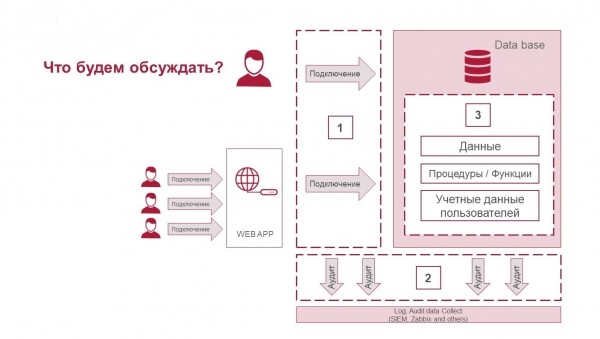
Tre elementer af sikkerhed i database-systemer: beskyttelse af forbindelser, handlingaudit og databeskyttelse.
Beskyttelse af forbindelser
Man kan oprette forbindelse til databasen både direkte og indirekte gennem webapplikationer. Normalt interagerer en bruger fra forretningen, det vil sige en person, der arbejder med database-systemet, ikke direkte med det.
Inden vi taler om beskyttelse af forbindelser, skal vi besvare nogle vigtige spørgsmål, der påvirker, hvordan sikkerhedsforanstaltningerne vil blive tilrettelagt:
- er én forretningsbruger lig med én databasebruger?
- er adgangen til data fra database-systemet kun sikret gennem et API, som du kontrollerer, eller er der direkte adgang til tabellerne?
- er database-systemet adskilt i et sikkert segment, og hvem interagerer med det, og hvordan?
- bruges der pooling/proxy og mellemlag, der kan ændre oplysninger om, hvordan forbindelsen er opbygget, og hvem der bruger databasen?
Lad os nu se, hvilke værktøjer der kan anvendes til beskyttelse af forbindelser:
- Brug database-firewall-løsninger. Et ekstra lag af beskyttelse øger i det mindste gennemsigtigheden af, hvad der sker i database-systemet, og i bedste fald vil du kunne sikre yderligere databeskyttelse.
- Brug adgangskodepolitikker. Anvendelsen afhænger af, hvordan din arkitektur er struktureret. I hvert fald er én adgangskode i konfigurationsfilen til webapplikationen, der forbinder til databasen, utilstrækkelig til beskyttelse. Der findes en række DBA-værktøjer, der gør det muligt at kontrollere, at brugeren og adgangskoden kræver opdatering.
Du kan læse mere om funktionerne til brugerbedømmelse , og du kan også lære om MS SQL Vulnerability Assessment .
- Berig sessionskonteksten med den nødvendige information. Hvis sessionen er uigennemsigtig, forstår du ikke, hvem der arbejder inden for dens rammer i databasen; du kan i forbindelse med den udførte operation supplere oplysninger om, hvem der gør hvad, og hvorfor. Disse oplysninger kan ses i audit-loggen.
- Konfigurer SSL, hvis du ikke har netværksadskillelse mellem databasen og slutbrugerne, og den ikke er i et separat VLAN. I sådanne tilfælde er det nødvendigt at beskytte forbindelsen mellem forbrugeren og selve databasen. Beskyttelsesværktøjer findes også blandt open source.
Hvordan vil dette påvirke databasens ydeevne?
Lad os se på et eksempel med PostgreSQL, hvordan SSL påvirker CPU-belastningen, øger latensen og mindsker TPS, og om det ikke vil tage for mange ressourcer, hvis det aktiveres.
Vi belaster PostgreSQL med pgbench — et simpelt program til kørsel af ydeevnetests. Det udfører gentagne gange den samme sekvens af kommandoer, eventuelt i parallelle database-sessioner, og beregner derefter den gennemsnitlige transaktionshastighed.
Test 1 uden SSL og med brug af SSL — forbindelsen etableres ved hver transaktion:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Test 2 uden SSL og med brug af SSL — alle transaktioner udføres i én forbindelse:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"De øvrige indstillinger:
scalings faktor: 1
forespørgselsmode: simpel
antal klienter: 10
antal tråde: 1
antal transaktioner per klient: 5000
antal transaktioner der faktisk blev behandlet: 50000/50000Ydeevnetest:
INGEN SSL
SSL
Der etableres forbindelse ved hver transaktion
gennemsnitlig latens
171.915 ms
187.695 ms
tps inklusive forbindelser, der etableres
58.168112
53.278062
tps eksklusive forbindelser, der etableres
64.084546
58.725846
CPU
24%
28%
Alle transaktioner udføres i én forbindelse
gennemsnitlig latens
6.722 ms
6.342 ms
tps inklusive forbindelser, der etableres
1587.657278
1576.792883
tps eksklusive forbindelser, der etableres
1588.380574
1577.694766
CPU
17%
21%
Ved lave belastninger er indflydelsen fra SSL sammenlignelig med målefejl. Hvis mængden af overførte data er meget stor, kan situationen være anderledes. Hvis vi etablerer en forbindelse for hver transaktion (hvilket sjældent sker, da forbindelser normalt deles mellem brugerne), har du mange forbindelser/afbrydelser, og indflydelsen kan være lidt større. Det vil sige, at der kan være risici for et fald i ydeevnen, men forskellen er ikke så stor, at man ikke bør bruge beskyttelse.
Bemærk, at der er en betydelig forskel, hvis man sammenligner driftsformer: inden for én session arbejder du, eller de er forskellige. Dette er forståeligt: ressourcer bruges til at oprette hver forbindelse.
Vi havde et tilfælde, hvor vi tilsluttede Zabbix i trust-tilstand, hvilket betyder, at md5 ikke blev kontrolleret, og der var ikke behov for autentificering. Senere bad kunden om at inkludere md5-autentificering. Dette medførte en stor belastning på CPU'en, og ydeevnen faldt. Vi begyndte at lede efter optimeringsmuligheder. En af de mulige løsninger på problemet er at implementere netværksbegrænsninger, oprette separate VLAN'er for databasen, tilføje indstillinger, så det er klart, hvem der forbindes fra, og fjerne autentificeringen. Man kan også optimere autentificeringsindstillingerne for at mindske omkostningerne ved at aktivere autentificeringen, men generelt påvirker brugen af forskellige autentificeringsmetoder ydeevnen og kræver, at disse faktorer tages i betragtning ved design af serverens (hardware) beregningskraft til databasen.
Konklusion: i flere løsninger kan selv små nuancer i autentificeringen have stor indflydelse på projektet, og det er skidt, når dette først bliver klart ved implementeringen i produktion.
Handlingsrevision
Revision kan ikke kun være for databasen. Revision er at få information om, hvad der sker på forskellige segmenter. Det kan være både databasefirewall og operativsystemet, som databasen er bygget på.
I kommercielle databasesystemer i Enterprise-klassen er revision i orden, men det er ikke altid tilfældet med open source. Her er hvad der findes i PostgreSQL:
- default log — indbygget logning;
- udvidelser: pgaudit — hvis du ikke er tilfreds med den standard logning, kan du bruge separate indstillinger, der løser en del opgaver.
Tillæg til rapporten i video:
«Basisregistreringen af operatører kan sikres med det standard logningsværktøj med log_statement = all.
Dette er acceptabelt til overvågning og andre anvendelser, men det giver ikke det detaljeniveau, der normalt er nødvendigt til revision.
Det er ikke nok at have en liste over alle operationer, der udføres med databasen.
Der skal også være mulighed for at finde specifikke udsagn, der er interessante for revisoren.
Det standard logningsværktøj viser, hvad brugeren anmodede om, mens pgAudit fokuserer på detaljerne i, hvad der skete, når databasen udførte anmodningen.
For eksempel kan revisoren ønske at sikre sig, at en specifik tabel blev oprettet inden for det dokumenterede vedligeholdelsesvindue.
Det kan virke som en enkel opgave for grundlæggende revision og grep, men hvad hvis du får noget som dette (bevidst forvirrende) eksempel:
DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;
Det standard logning vil give dig dette:
LOG: statement: DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;
Det ser ud til, at det kan kræve noget kendskab til koden at finde den ønskede tabel, især når tabeller oprettes dynamisk.
Dette er ikke ideelt, da det ville være foretrukket blot at søge efter tabelnavnet.
Her bliver pgAudit nyttigt.
For den samme input vil den generere denne output i loggen:
AUDIT: SESSION,33,1,FUNCTION,DO,,,«DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;"
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Ikke kun DO-blokken registreres, men hele CREATE TABLE-teksten med operationstypen, objekttypen og det fulde navn, hvad der letter søgningen.
Ved at logge SELECT- og DML-operationer kan pgAudit konfigureres til at registrere en separat post for hver relation, som der refereres til i operationen.
Der kræves ikke syntaksanalyse for at finde alle operationer, der vedrører en specifik tabel ()».
Hvordan vil dette påvirke databasens ydeevne?
Lad os udføre tests med aktivering af fuld revision og se, hvad der sker med PostgreSQL's ydeevne. Vi vil aktivere maksimal logning af databasen på alle parametre.
I konfigurationsfilen ændrer vi næsten ingenting, det vigtigste er, at vi aktiverer debug5-tilstand for at få maksimalt information.
postgresql.conf
log_destination = 'stderr'
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = on
log_checkpoints = on
log_connections = on
log_disconnections = on
log_duration = on
log_hostname = on
log_lock_waits = on
log_replication_commands = on
log_temp_files = 0
log_timezone = 'Europe/Moscow'
Med PostgreSQL DB med parametre 1 CPU, 2,8 GHz, 2 GB RAM, 40 GB HDD udfører vi tre belastningstest ved hjælp af kommandoerne:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Testresultater:
Uden logning
Med logning
Den samlede tid til at fylde databasen
43,74 sek
53,23 sek
RAM
24%
40%
CPU
72%
91%
Test 1 (50 forbindelser)
Antal transaktioner over 10 min
74169
32445
Transaktioner/sek
123
54
Gennemsnitlig forsinkelse
405 ms
925 ms
Test 2 (150 forbindelser ved 100 mulige)
Antal transaktioner over 10 min
81727
31429
Transaktioner/sek
136
52
Gennemsnitlig forsinkelse
550 ms
1432 ms
Om størrelser
Størrelsen på databasen
2251 MB
2262 MB
Størrelsen på databasen logger
0 MB
4587 MB
Som et resultat: en fuld revision er ikke særlig god. Mængden af data fra revisionen vil være lig med eller større end mængden af data i selve databasen. Den mængde logning, der genereres under arbejdet med DBMS, er et almindeligt problem i produktionen.
Lad os se på andre parametre:
- Hastigheden ændrer sig ikke meget: uden logning - 43,74 sek, med logning - 53,23 sek.
- Ydelsen for RAM og CPU vil falde, da der skal oprettes en revisionsfil. Dette er også mærkbart i produktionen.
Når antallet af forbindelser øges, vil resultaterne selvfølgelig blive lidt dårligere.
I virksomheder med revision er det endnu mere komplekst:
- der er mange data;
- revisionen kræves ikke kun gennem syslog i SIEM, men også i filer: hvis der sker noget med syslog, skal der være en fil tæt på databasen, hvori dataene gemmes;
- til revision er det nødvendigt med en separat hylde for ikke at gå ned på I/O-diskene, da de kræver meget plads;
- det kan være, at medarbejdere i informationssikkerhed har brug for at implementere standarder, de kræver statslig identifikation.
Adgangsbegrænsning til data
Lad os se på teknologierne, der anvendes til at beskytte data og tilgangen til dem i kommercielle DBMS og open source.
Hvad kan generelt anvendes:
- Kryptering og obfuskering af procedurer og funktioner (Wrapping) — det vil sige separate værktøjer og nyttiggørelse, der gør læsbar kode ulæselig. Desværre kan den ikke ændres eller refaktoreres tilbage. Denne tilgang kræves nogle gange i det mindste på DBMS-siden - logikken for licensbegrænsninger eller godkendelseslogik krypteres specifikt på niveauet for procedurer og funktioner.
- Data synlighedsbegrænsning (RLS) er, når forskellige brugere ser den samme tabel, men med forskellige rækker, hvilket betyder, at nogle brugere ikke kan se visse oplysninger på rækkeniveau.
- Redigering af viste data (Masking) er, når brugere i en kolonne i tabellen ser enten data eller kun stjerner, hvilket betyder, at for nogle brugere vil oplysningerne være skjult. Teknologien bestemmer, hvilke oplysninger der vises til hvilke brugere baseret på adgangsniveau.
- Adgangsbegrænsning Security DBA/Application DBA/DBA handler mere om at begrænse adgangen til selve databasen, hvilket vil sige, at sikkerhedspersonale kan adskilles fra databaseadministratorer og applikationsadministratorer. Der er ikke mange open source-teknologier til dette, men kommercielle databaser har mange. De er nødvendige, når der er mange brugere med adgang til selve serverne.
- Adgangsbegrænsning til filer på filsystemniveau. Man kan tildele rettigheder og privilegier til mapper, så hver administrator kun får adgang til de nødvendige data.
- Mandatadgang og hukommelsesrensning er teknologier, der anvendes sjældent.
- End-to-end kryptering direkte i databasen er klient-side kryptering med nøgleadministration på serversiden.
- Kryptering af data. For eksempel kolonne-kryptering - når du bruger et mekanisme, der krypterer en individuel kolonne i databasen.
Hvordan påvirker dette databaseydelsen?
Lad os tage et eksempel med kolonne-kryptering i PostgreSQL. Der er en modul pgcrypto, som tillader opbevaring af udvalgte felter i krypteret form. Dette er nyttigt, når kun nogle data har værdi. For at læse de krypterede felter sender klienten den dekrypterende nøgle, serveren dekrypterer data og giver dem til klienten. Uden nøglen kan ingen gøre noget med dine data.
Lad os udføre en test med pgcrypto.. Vi opretter en tabel med krypterede data og en med almindelige data. Nedenfor er kommandoerne til oprettelse af tabellerne, og i den første linje er der en nyttig kommando - oprettelse af selve extension med registrering af databasen:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Lad os prøve at lave en dataudtræk fra hver tabel og se på erhvervelsestiderne for udførelsen.
Dataudtræk fra tabellen uden krypteringsfunktion:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
Stopwatchen er tændt.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 rækker)
Tid: 1,386 ms
Dataudtræk fra tabellen med krypteringsfunktion:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
Stopwatchen er tændt.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 rækker)
Tid: 50,203 ms
Ydeevnetest:
Uden kryptering
Pgcrypto (decrypt)
Dataudtræk 1000 rækker
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
Kryptering påvirker ydeevnen betydeligt. Det er klart, at tiden er steget, da dekrypteringsoperationer af krypterede data (som normalt er indkapslet i din logik) kræver betydelige ressourcer. Det vil sige, at ideen om at kryptere alle kolonner, der indeholder data, kan medføre nedsat ydeevne.
Desuden er kryptering ikke en sølvkugle, der løser alle problemer. De dekrypterede data og dekrypteringsnøglen befinder sig på serveren under dekrypterings- og dataoverførselsprocessen. Derfor kan nøglerne blive opsnappet af dem, der har fuld adgang til databaseserveren, for eksempel systemadministratoren.
Når der er én nøgle for hele kolonnen for alle brugere (selv hvis det ikke gælder for alle, men kun for en begrænset gruppe kunder), er det ikke altid godt eller rigtigt. Det er derfor, der er begyndt at blive lavet end-to-end kryptering; databaserne har begyndt at overveje muligheden for datakryptering fra både klient- og server-side, og de såkaldte key-vault opbevaringsløsninger er dukket op — separate produkter, der sørger for håndtering af nøgler fra databasen.

Sikkerhedsmidler i kommercielle og open source databaser
Functions
Type
Password Policy
Audit
Beskyttelse af kildekoden til procedurer og funktioner
RLS
Kryptering
Oracle
Kommerciel
+
+
+
+
+
MsSql
Kommerciel
+
+
+
+
+
Kommerciel
+
+
+
+
udvidelser
PostgreSQL
Gratis
udvidelser
udvidelser
—
+
udvidelser
MongoDb
Gratis
—
+
—
—
Kun tilgængelig i MongoDB Enterprise
Tabellen er langt fra fuld, men situationen er sådan: i kommercielle produkter er sikkerhedsproblemer blevet løst i lang tid, i open source anvendes der som regel kun nogle overbygninger, mange funktioner mangler, og nogle gange er man nødt til at tilføje noget. For eksempel sikkerhedspolitikker — der er mange forskellige udvidelser i PostgreSQL., , , , ), som implementerer politikker for adgangskoder, men efter min mening dækker ingen af dem behovene i den indenlandske erhvervssektor.
Hvad skal man gøre, hvis man ikke kan finde det, man har brug for? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
Man kan derefter bruge tredjepartsløsninger, der arbejder med forskellige databasesystemer, som 'Krypto DB' eller 'Garda DB'. Når det gælder løsninger fra den indenlandske sektor, kender de bedre til GOST end open source.
Den anden mulighed er at skrive selv, hvad der er nødvendigt, implementere adgang til data og kryptering på niveau med procedurer i applikationen. Sandheden er, at det bliver sværere med GOST. Men generelt kan du skjule data, som du ønsker, placere dem i databasesystemet, og derefter hente og dekryptere dem korrekt direkte i applikationen. Tænk samtidig over, hvordan du vil beskytte disse algoritmer på applikationsniveau. Efter vores mening bør dette gøres på databasesystemniveau, da det vil fungere hurtigere.
Denne præsentation blev første gang præsenteret ved af Mail.ru Cloud Solutions. Seandre præsentationer og tilmeld dig nyhedsbreve om arrangementer på Telegram .
Andre artikler om emnet:
- .
- .
Kilde: habr.com
