

Oversættelsen er specielt udarbejdet til studerende på kurset .
er softwareudvikler, Go-entusiast og elsker at løse komplekse problemer. Han er også maintainer af Prometheus og medstifter af Kubernetes SIG instrumentation. Tidligere var han produktionsingeniør hos SoundCloud og ledte overvågningsgruppen hos CoreOS. I øjeblikket arbejder han hos Google.
er infrastrukturingeniør hos Improbable. Han interesserer sig for nye teknologier og udfordringer inden for distribuerede systemer. Han har erfaring med lavniveau-programmering hos Intel, har bidraget til Mesos og har verdensomspændende SRE-erfaring hos Improbable. Han arbejder på at forbedre mikrotjenestens verden. Tre af hans passioner: Golang, open source og volleyball.
Når man ser på vores flagskibsprodukt SpatialOS, kan man fornemme, at Improbable har brug for en højtydende cloud-infrastruktur i global skala med dusinvis af Kubernetes-klynger. Vi var blandt de første til at begynde at bruge overvågningssystemet . Prometheus kan overvåge millioner af metrics i realtid og leveres med et kraftfuldt forespørgselssprog, der gør det muligt at trække de nødvendige oplysninger.
Enkelheden og pålideligheden af Prometheus er en af dets primære fordele. Men efter at have nået en bestemt skala stødte vi på flere ulemper. For at løse disse problemer har vi udviklet , et open source-projekt skabt af Improbable, til problemfri transformation af eksisterende Prometheus-klynger til et enkelt overvågningssystem med ubegrænset opbevaring af historiske data. Thanos er tilgængelig på Github .
Vores mål med Thanos
Ved en given skala opstår der problemer, der går ud over de muligheder, som vanille Prometheus har. Hvordan opbevarer man pålideligt og økonomisk petabytes af historiske data? Kan dette gøres uden at gå på kompromis med svartiden på forespørgsler? Kan man få adgang til alle metrics, der ligger på forskellige Prometheus-servere, med ét API-kald? Kan man på en eller anden måde kombinere de replicerede data, der er indsamlet med Prometheus HA?
For at besvare disse spørgsmål har vi skabt Thanos. I de følgende afsnit beskriver vi, hvordan vi greb disse udfordringer an, og forklarer de mål, vi har sat os.
Dataforespørgsel fra flere Prometheus-instans (global query)
Prometheus tilbyder en funktionel tilgang til sharding. Selv en enkelt Prometheus-server giver tilstrækkelig skalerbarhed til at befri brugerne fra kompleksiteten ved horisontal sharding i næsten alle anvendelsesscenarier.
Skønt dette er en fremragende implementeringsmodel, er det ofte nødvendigt at få adgang til data på forskellige Prometheus-servere gennem et enkelt API eller UI — globalt overblik. Selvfølgelig er der mulighed for at vise flere forespørgsler i et enkelt Grafana-panel, men hver forespørgsel kan kun udføres på én Prometheus-server. På den anden side, med Thanos kan du forespørge og aggregere data fra flere Prometheus-servere, da de alle er tilgængelige fra et enkelt endpoint.
Tidligere, for at opnå globalt overblik i Improbable, organiserede vi vores Prometheus-forekomster i en multilevel . Dette betød at oprette en meta-Prometheus-server, der indsamler metrics fra hver "blad" server.
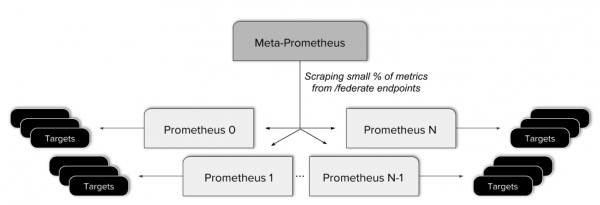
Denne tilgang viste sig at være problematisk. Den førte til en kompleks konfiguration, tilføjede en yderligere potentiel fejlkilde og anvendte komplicerede regler for at give den federated endpoint kun de nødvendige data. Desuden tillader denne form for federation ikke et ægte globalt overblik, da ikke alle data er tilgængelige fra en enkelt API-anmodning.
Dette er tæt relateret til det ensartede datasyn, der er indsamlet på højtilgængelige (high-availability, HA) Prometheus-servere. HA-modellen for Prometheus indsamler data uafhængigt to gange, hvilket er så enkelt, at det ikke kan være lettere. Dog ville det være meget mere praktisk at bruge en samlet og dedupliceret fremstilling af begge strømme.
Der er selvfølgelig et behov for højt tilgængelige Prometheus-servere. Hos Improbable tager vi minut-for-minut overvågning af data meget alvorligt, men at have én Prometheus-forekomst i klyngen er en enkelt fejlkilde. Enhver konfigurationsfejl eller hardwarefejl kan potentielt føre til tab af vigtige data. Selv en simpel implementering kan føre til små afbrydelser i metricsindsamlingen, da genstart kan tage betydeligt længere tid end skrabefrekvensen.
Pålidelig opbevaring af historiske data
Billigt, hurtigt og langsigtet metric-lagring er vores drøm (som deles af de fleste brugere af Prometheus). Hos Improbable måtte vi indstille opbevaringsperioden for metrics til ni dage (for Prometheus 1.8). Dette skaber åbenlyse begrænsninger for, hvor langt tilbage vi kan se.
Prometheus 2.0 er blevet bedre i denne henseende, da antallet af tidsserier ikke længere påvirker serverens samlede ydeevne (se ). Ikke desto mindre gemmer Prometheus data på den lokale disk. Selvom højtydende datakomprimering kan reducere brugen af lokal SSD betydeligt, er der stadig en grænse for mængden af historiske data, der kan gemmes.
Derudover værner vi hos Improbable om pålidelighed, enkelhed og omkostninger. Store lokale diske er mere komplekse at administrere og sikkerhedskopiere. De er dyrere og kræver flere værktøjer til sikkerhedskopiering, hvilket fører til unødvendig kompleksitet.
Nedprøving
Da vi begyndte at arbejde med historiske data, indså vi, at der er fundamentale problemer med O-storstilet, som gør forespørgsler langsommere og langsommere, når vi arbejder med data fra uger, måneder og år.
Standardløsningen på dette problem er (downsampling) — reduktion af signalets prøvehastighed. Ved at sænke prøvehastigheden kan vi "skalere ned" til et større tidsrum og opretholde det samme antal prøver, hvilket vil sikre forespørgningens responsivitet.
Nedprøvning af gamle data er et uundgåeligt krav for enhver løsning til langsigtet lagring og går ud over standard Prometheus.
Yderligere mål
Et af de oprindelige mål for Thanos-projektet var problemfri integration med eksisterende Prometheus-installationer. Det andet mål var nem betjening med minimal adgangsbarriere. Enhver afhængighed skal være let at opfylde for både små og store brugere, hvilket også forudsætter lave grundomkostninger.
Thanos-arkitektur
Når vi nu har opremset vores mål i det forrige afsnit, lad os arbejde hen imod dem og se, hvordan Thanos adresserer disse problemer.
Global visning
For a global view overlaying existing Prometheus instances, we need to link a single entry point for requests to all servers. This is exactly what the Thanos component does. . It is deployed alongside each Prometheus server and acts as a proxy, serving local Prometheus data through the gRPC Store API interface, which allows querying time series data by labels and time range.
On the other hand, there is a horizontally scalable stateless Querier component that does a bit more than just responding to PromQL queries through the standard Prometheus HTTP API. The Querier, Sidecar, and other Thanos components interact via .
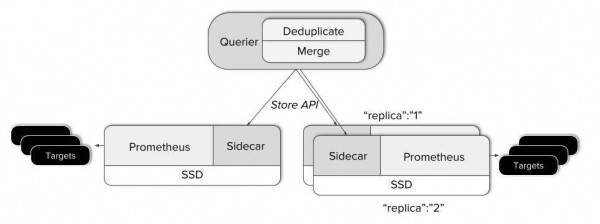
- When the Querier receives a request, it connects to the appropriate Store API server, meaning our Sidecars, and retrieves time series data from the corresponding Prometheus servers.
- After that, it merges the responses and performs the PromQL query on them. The Querier can merge both non-overlapping data and duplicated data from HA Prometheus servers.
This solves the main part of our puzzle — merging data from isolated Prometheus servers into a unified view. In fact, Thanos can be used solely for this capability. No changes are required to existing Prometheus servers!
Unlimited retention!
However, sooner or later we will want to store data that goes beyond the usual retention period of Prometheus. For historical data storage, we have chosen object storage. It is widely available in any cloud, as well as in local data centers, and is very cost-effective. Moreover, virtually any object storage is accessible via the well-known S3 API.
Prometheus writes data from memory to disk approximately every two hours. Each block of stored data contains all data for a fixed time interval and is immutable. This is very convenient, as Thanos Sidecar can simply look at the Prometheus data directory and load new blocks into the object storage buckets as they appear.
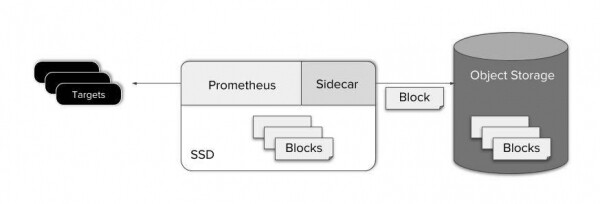
Uploading to the object storage immediately after writing to disk also helps to maintain the simplicity of the scraper (Prometheus and Thanos Sidecar). This simplifies the maintenance, cost, and design of the system.
Som du kan se, er sikkerhedskopiering af data meget enkelt at implementere. Men hvad med forespørgslen til data i objektlagringen?
Thanos Store-komponenten fungerer som en proxy til at hente data fra objektlagringen. Ligesom Thanos Sidecar deltager den i gossip-klassen og implementerer Store API. På denne måde kan eksisterende Querier se den som en Sidecar, som en anden kilde til tidsserie-data – der kræves ingen særlig opsætning.
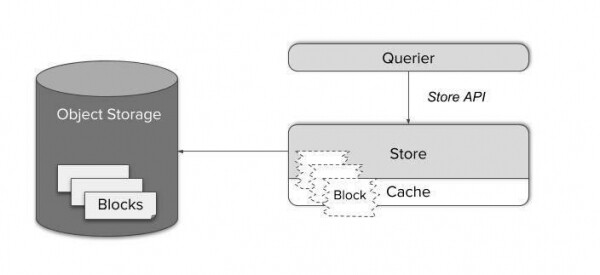
Tidsserie-data består af flere store filer. At hente dem efter behov ville være ret ineffektivt, og lokal caching ville kræve enorm mængde hukommelse og diskplads.
I stedet ved Store Gateway, hvordan man håndterer Prometheus lagringsformat. Takket være en smart forespørgselsplanlægger og caching af kun de nødvendige indeksdele af filerne, er det blevet muligt at reducere komplekse forespørgsler til et minimum antal HTTP-forespørgsler til objektlagringen. Dermed kan antallet af anmodninger reduceres med fire til seks størrelsesordener og opnå en responstid, der generelt er svær at skelne fra anmodninger til data på en lokal SSD.
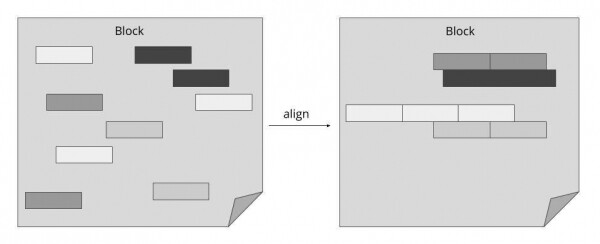
Som vist i diagrammet ovenfor reducerer Thanos Querier betydeligt omkostningerne ved en enkelt forespørgsel til data i objektlagringen ved at bruge Prometheus lagringsformatet og placere relaterede data tæt på hinanden. Ved at bruge denne tilgang kan vi kombinere mange enkeltstående anmodninger til et minimalt antal bulk-operationer.
Kompaktering og nedsampling
Når en ny blok af tidsserie-data er blevet uploadet til objektlagringen, betragter vi den som 'historiske' data, der straks er tilgængelige via Store Gateway.
Efter noget tid ophobes blokke fra en kilde (Prometheus med Sidecar) og udnytter ikke længere hele potentialet for indeksering. For at løse dette problem har vi introduceret en anden komponent kaldet Compactor. Den anvender blot den lokale komprimeringsmekanisme fra Prometheus til de historiske data i objektlagringen og kan køres som en simpel periodisk batchopgave.
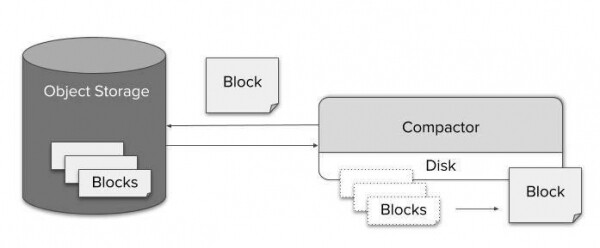
Takket være effektiv komprimering udgør en forespørgsel til lageret over længere tid ikke et problem med hensyn til datastørrelse. Den potentielle omkostning ved at dekomprimere en milliard værdier og køre dem gennem forespørgselsbehandleren vil imidlertid uundgåeligt føre til en betydelig stigning i forespørgselens behandlingstid. På den anden side, da der er hundrede datapunkter for hver skærmpixel, bliver det umuligt selv at visualisere dataene i fuld opløsning. Således er nedsampling ikke kun muligt, men vil heller ikke føre til mærkbare tab i præcision.
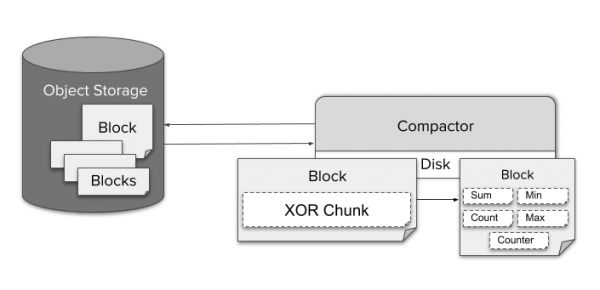
Til nedsampling af data aggregerer Compactor kontinuerligt data med en opløsning på fem minutter og en time. For hvert rå fragment, der er kodet med TSDB XOR-komprimering, lagres forskellige typer aggregerede data, såsom min, max eller sum for en blok. Dette gør det muligt for Querier automatisk at vælge den aggregerede data, der passer til den givne PromQL-forespørgsel.
For at bruge data med nedsat nøjagtighed kræves der ingen speciel konfiguration fra brugeren. Querier skifter automatisk mellem forskellige opløsninger og rådata, når brugeren zoomer ind og ud. Hvis brugeren ønsker det, kan de styre dette direkte via ‘step’-parameteren i forespørgslen.
Da omkostningen ved at opbevare én GB er lille, gemmer Thanos som standard originale data, data med en opløsning på fem minutter og en time. Der er ikke behov for at slette de originale data.
Recording rules
Selv med Thanos er recording rules en væsentlig del af overvågningsstakken. De reducerer kompleksiteten, forsinkelsen og omkostningerne ved forespørgsler. De er også praktiske for brugere, der ønsker at få aggregerede data om metrikker. Thanos er baseret på vanilje-forekomster af Prometheus, så det er helt acceptabelt at gemme recording rules og alerting rules på den eksisterende Prometheus-server. I nogle tilfælde kan dette dog være utilstrækkeligt:
- Globale alert og regel (for eksempel en alarm, når tjenesten ikke fungerer på mere end to ud af tre klynger).
- Regel for data uden for det lokale lager.
- Stræben efter at opbevare alle regler og alarmer ét sted.
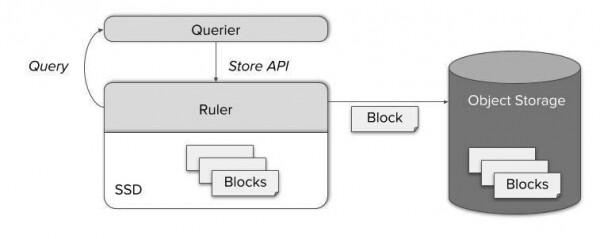
For all these cases, Thanos includes a separate component called Ruler, which calculates rules and alerts through Thanos Queries. Providing a well-known StoreAPI, the Query node can access freshly computed metrics. Later, these metrics are also stored in object storage and become available through Store Gateway.
Thanos Power
Thanos is flexible enough to be customized to your requirements. This is especially useful when migrating from a simple Prometheus. Let's quickly remind ourselves with a small example of what we've learned about Thanos components. Here’s how to transition your vanilla Prometheus into the world of 'unlimited metric storage':
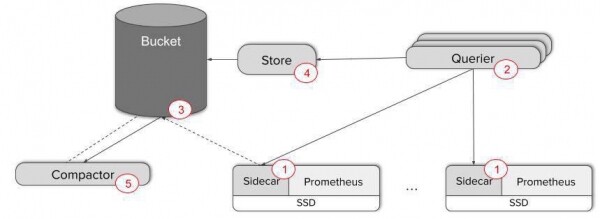
- Add the Thanos Sidecar to your Prometheus servers — for example, a neighboring container in a Kubernetes pod.
- Deploy multiple replicas of Thanos Querier for data viewing capability. At this stage, it's easy to set up gossip between Scraper and Querier. To check component interaction, use the metric 'thanos_cluster_members.'
These two steps are sufficient to ensure a global view and seamless data deduplication from potential HA replicas of Prometheus! Just connect your dashboards to the HTTP Querier endpoint or use the Thanos UI interface directly.
However, if you require backup of metrics and long-term storage, three additional steps will be needed:
- Create an AWS S3 or GCS bucket. Configure Sidecar to copy data to these buckets. You can now minimize local data storage.
- Deploy Store Gateway and connect it to the existing gossip cluster. You can now send queries to the data backups!
- Deploy Compactor to enhance query efficiency for prolonged time intervals using compaction and downsampling.
If you want to learn more, feel free to check out our og !
In just five steps, we transformed Prometheus into a reliable monitoring system with a global view, unlimited storage time, and potential high availability of metrics.
Pull request: we need you!
From the very beginning, it has been an open-source project. Seamless integration with Prometheus and the ability to use only part of Thanos makes it an excellent choice for scaling a monitoring system effortlessly.
Vi er altid glade for GitHub Pull Requests og Issues. Tøv ikke med at kontakte os via Github Issues eller Slack., hvis du har spørgsmål eller feedback, eller hvis du vil dele din oplevelse! Hvis du kan lide det, vi laver hos Improbable, så kontakt os gerne — !
Kilde: habr.com
