

Hej, Habr! Jeg præsenterer for jer oversættelsen af artiklen af forfatterne Burak Yavuz, Brenner Heintz og Denny Lee, som blev forberedt op til kursusstarten fra OTUS.
Data, ligesom vores erfaring, akkumuleres og udvikles konstant. For ikke at falde bagud skal vores mentale modeller af verden tilpasses de nye data, hvoraf nogle indeholder nye dimensioner - nye måder at observere ting, som vi tidligere ikke havde kendskab til. Disse mentale modeller adskiller sig ikke væsentligt fra skemaerne for tabeller, som definerer, hvordan vi klassificerer og behandler ny information.
Dette bringer os til spørgsmålet om skemastyring. Efterhånden som forretningsopgaver og krav ændrer sig over tid, ændrer strukturen af dine data sig også. Delta Lake giver mulighed for nemt at implementere nye dimensioner, når dataene ændrer sig. Brugerne har adgang til en simpel semantik for at administrere skemaerne for deres tabeller. Disse værktøjer inkluderer skemaoverholdelse (Schema Enforcement), som beskytter brugerne mod utilsigtet at forurene deres tabeller med fejl eller unødvendige data, samt skemaevolution (Schema Evolution), som gør det muligt automatisk at tilføje nye kolonner med værdifulde data på de relevante steder. I denne artikel vil vi dykke ned i brugen af disse værktøjer.
Forståelse af skemaer for tabeller
Hver DataFrame i Apache Spark indeholder et skema, der definerer formet på data, såsom datatyper, kolonner og metadata. Med Delta Lake gemmes skemaet for tabellen i JSON-format inden i transaktionsloggen.
Hvad er skemaoverholdelse?
Skemaoverholdelse (Schema Enforcement), også kendt som skema-validering (Schema Validation), er en beskyttelsesmekanisme i Delta Lake, som sikrer datakvaliteten ved at afvise poster, der ikke svarer til tabellens skema. Ligesom en receptionist i en populær restaurant, der kun accepterer reservationer, kontrollerer den, om hver datakolonne, der indtastes i tabellen, er på den tilsvarende liste over forventede kolonner (med andre ord, om der er en 'reservation' for hver af dem) og afviser enhver post med kolonner, der ikke er på listen.
Hvordan fungerer skemaoverholdelse?
Delta Lake anvender skemakontrol ved skrivning, hvilket betyder, at alle nye poster i tabellen kontrolleres for kompatibilitet med skemaet for den målrettede tabel under skrivning. Hvis skemaet er inkompatibelt, annullerer Delta Lake transaktionen helt (data skrives ikke), og der oprettes et undtagelse for at informere brugeren om uoverensstemmelsen.
For at bestemme kompatibiliteten af en post bruger Delta Lake følgende regler. Den skrivne DataFrame:
- kan ikke indeholde yderligere kolonner, som ikke findes i skemaet for den målrettede tabel. Og omvendt, er det i orden, hvis de indkommende data ikke indeholder alle kolonner fra tabellen - disse kolonner vil blot blive tildelt nul-værdier.
- kan ikke have kolonnedata typer, der adskiller sig fra kolonnedata typerne i den målrettede tabel. Hvis en kolonne i den målrettede tabel indeholder data af typen StringType, men den tilsvarende kolonne i DataFrame indeholder data af typen IntegerType, vil tvangsanvendelse af skemaet kaste en undtagelse og forhindre fuldførelsen af skrivningsoperationen.
- kan ikke indeholde kolonnenavne, der kun adskiller sig i store og små bogstaver. Det betyder, at du ikke kan have kolonner med navnene 'Foo' og 'foo' defineret i én tabel. Selvom Spark kan bruges i enten følsom eller ufølsom til store bogstaver tilstand (som standard ufølsom), bevarer Delta Lake store og små bogstaver, men er ufølsom inden for skemalagring. Parquet er følsom over for store bogstaver ved lagring og returnering af kolonneinformation. For at undgå mulige fejl, dataskader eller tab (som vi personligt har oplevet i Databricks) har vi besluttet at tilføje denne begrænsning.
For at illustrere dette, lad os se på, hvad der sker i den følgende kode, når vi prøver at tilføje nogle nyligt genererede kolonner i en Delta Lake-tabel, som endnu ikke er konfigureret til at acceptere dem.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
I stedet for automatisk at tilføje nye kolonner, håndhæver Delta Lake skemaet og stopper skrivningen. For at hjælpe med at identificere hvilken kolonne (eller flere) der forårsager uoverensstemmelsen, udskriver Spark begge skemaer fra staksporet til sammenligning.
Hvad er fordelene ved tvangsanvendelse af skema?
Da tvinge anvendelsen af skemaet er en tilstrækkelig striks kontrol, så det er et fremragende værktøj til at fungere som en portvagt for et rent, helt transformeret datasæt, der er klar til produktion eller forbrug. Det anvendes typisk på tabeller, der direkte leverer data:
- Maskinlæringsalgoritmer
- BI dashboards
- Dataanalyse og visualiseringsværktøjer
- Enhver produktionssystem, der kræver strengt strukturerede, strengt typede semantiske skemaer.
For at forberede dine data til denne endelige barriere anvender mange brugere en simpel 'multi-hop' arkitektur, som gradvist tilføjer struktur til deres tabeller. For at lære mere om dette kan du læse artiklen
Selvfølgelig kan tvinge anvendelsen af skemaet bruges hvor som helst i din pipeline, men husk at strømmende skrivning til tabellen i sådanne tilfælde kan være frustrerende, fordi du for eksempel glemmer, at du har tilføjet en yderligere kolonne til de indkommende data.
Forebyggelse af datadybning
På dette tidspunkt kan du spørge dig selv, hvad al denne opsætning handler om? I sidste ende kan en uventet 'skema mismatch'-fejl pludselig binde dine hænder i dit arbejdsflow, især hvis du er ny i Delta Lake. Hvorfor ikke bare lade skemaet ændre sig, som det skal, så jeg kan skrive mit DataFrame, uanset hvad?
Som det gamle ordsprog siger, 'en ounce forebyggelse er værd en pund behandling'. På et tidspunkt, hvis du ikke passer på anvendelsen af dit skema, vil problemer med datatypernes kompatibilitet stige op — tilsyneladende ensartede kilder til rådata kan indeholde grænsetilfælde, beskadigede kolonner, forkert dannede mappinger eller andre uhyggelige ting, der besøger dine mareridt. Den bedste tilgang er at stoppe disse fjender ved porten — med hjælp af tvinge anvendelsen af skemaet — og tage sig af dem i lyset, og ikke senere, når de begynder at snuse rundt i de mørke dybder af din arbejds kode.
Den tvingende anvendelse af skemaet giver dig sikkerhed for, at dit tabelskema ikke ændres, medmindre du selv bekræfter en ændring. Dette forhindrer 'fortynding' af data, der kan ske, når nye kolonner tilføjes så ofte, at tidligere værdifulde, komprimerede tabeller mister deres værdi og nytte på grund af en oversvømmelse af data. Ved at opfordre dig til at være bevidst, sætte høje standarder og forvente høj kvalitet, gør den tvingende anvendelse af skemaet præcis det, det er designet til — at hjælpe dig med at være samvittighedsfuld, og dine tabeller med at forblive rene.
Hvis du ved nærmere overvejelse beslutter, at du faktisk man skal vil tilføje en ny kolonne — intet problem, her er en enkel rettelse. Løsningen er evolutionen af skemaet!
Hvad er evolutionen af skemaet?
Evolutionen af skemaet er en funktion, der gør det nemt for brugere at ændre det nuværende tabelskema i takt med, at dataene ændrer sig over tid. Den bruges oftest, når man tilføjer eller overskriver data for automatisk at tilpasse skemaet til at inkludere en eller flere nye kolonner.
Hvordan fungerer evolutionen af skemaet?
Ved at følge eksemplet fra det foregående afsnit kan udviklere nemt bruge evolutionen af skemaet til at tilføje nye kolonner, der tidligere er blevet afvist på grund af skemaoverensstemmelse. Evolutionen af skemaet aktiveres ved at tilføje .option('mergeSchema', 'true') til din Spark-kommando .write eller .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
For at se grafen skal du udføre følgende Spark SQL-forespørgsel
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 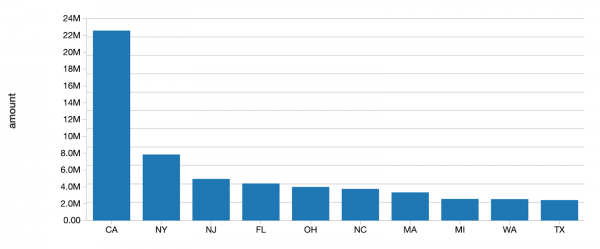
Alternativt kan du indstille denne mulighed for hele Spark-sessionen ved at tilføje spark.databricks.delta.schema.autoMerge = True til Spark-konfigurationen. Men vær forsigtig med dette, da den tvingende anvendelse af skemaet ikke længere vil advare dig om utilsigtede skemaoverensstemmelser.
Ved at inkludere parameteren mergeSchema, vil alle kolonner, der findes i DataFrame, men mangler i mål tabellen, automatisk blive tilføjet til slutningen af skemaet som en del af skrive-transaktionen. Næstede felter kan også blive tilføjet, og de vil også blive tilføjet til slutningen af de tilsvarende kolonner i strukturen.
Ingeniører og forskere kan bruge denne mulighed til at tilføje nye kolonner (måske en nyligt overvåget metrik eller en kolonne med salgstal for denne måned) til deres eksisterende produktionsmodeller for maskinlæring uden at bryde de eksisterende modeller, der er baseret på de gamle kolonner.
Følgende typer af skemaændringer er acceptable inden for skemaets evolution, mens man tilføjer eller overskriver en tabel:
- Tilføjelse af nye kolonner (dette er det mest almindelige scenarie)
- Ændring af datatyper fra NullType -> enhver anden type eller opgradering fra ByteType -> ShortType -> IntegerType
Andre ændringer, der ikke er tilladt inden for skemaets evolution, kræver, at både skemaet og dataene bliver overskrevet ved at tilføje .option("overwriteSchema", "true"). For eksempel, hvis kolonnen "Foo" oprindeligt var integer, og det nye skema skulle være af strengdatatypen, ville alle Parquet-filer (data) skulle overskrives. Sådanne ændringer inkluderer:
- fjernelse af en kolonne
- ændring af datatypen for en eksisterende kolonne (in place)
- omdøbning af kolonner, der kun adskiller sig i store og små bogstaver (f.eks. "Foo" og "foo")
Endelig vil den kommende udgivelse af Spark 3.0 fuldt ud understøtte eksplicit DDL (ved hjælp af ALTER TABLE), hvilket giver brugerne mulighed for at udføre følgende handlinger på tabelskemaer:
- tilføjelse af kolonner
- ændring af kommentarer til kolonner
- justering af tabelens egenskaber, der bestemmer tabelens adfærd, som f.eks. at indstille varigheden for opbevaring af transaktionsloggen.
Hvad er fordelene ved skemaets evolution?
Skemaets evolution kan anvendes, når du har til hensigt at ændre skemaet for din tabel (modsat de tilfælde, hvor du utilsigtet har tilføjet kolonner til din DataFrame, som ikke burde være der). Dette er den nemmeste måde at migrere dit skema på, fordi det automatisk tilføjer de korrekte kolonnenavne og datatyper uden behov for at erklære dem eksplicit.
Konklusion
Tvangsmæssig anvendelse af skemaet afviser eventuelle nye kolonner eller andre skemaændringer, der ikke er kompatible med din tabel. Ved at fastsætte og opretholde disse høje standarder kan analytikere og ingeniører stole på, at deres data har det højeste niveau af integritet, hvilket gør det klart for dem at træffe mere effektive forretningsbeslutninger.
På den anden side supplerer skemaets evolution den tvangsmæssige anvendelse, hvilket forenkler forventede automatiske skemaændringer. I sidste ende burde det ikke være kompliceret at tilføje en kolonne.
Tvangsmæssig anvendelse af skemaet er yang, hvor skemaets evolution er yin. Når disse funktioner anvendes sammen, bliver det lettere end nogensinde at undertrykke støj og justere signalet.
Vi vil også gerne takke Mukul Murti og Pranav Anand for deres bidrag til denne artikel.
Andre artikler i denne serie:
Relaterede artikler
Kilde: habr.com
