

I Sitimobil bruger vi MySQL-databasen som vores primære lager til vedholdende data. Vi har flere databaseklustre til forskellige tjenester og formål.
Den vedholdende tilgængelighed af masteren er en kritisk indikator for funktionaliteten i hele systemet og dets enkelte dele. Den automatiske gendannelse af klusteret i tilfælde af masterfejl reducerer kraftigt responstiden på hændelser og systemnedetid. I denne artikel vil jeg gennemgå opstillingen for høj tilgængelighed (HA) af MySQL-klusteret baseret på og virtuelle IP-adresser (VIP).
HA-løsning baseret på VIP
Først vil jeg kort beskrive, hvad vores datalagringssystem indebærer.
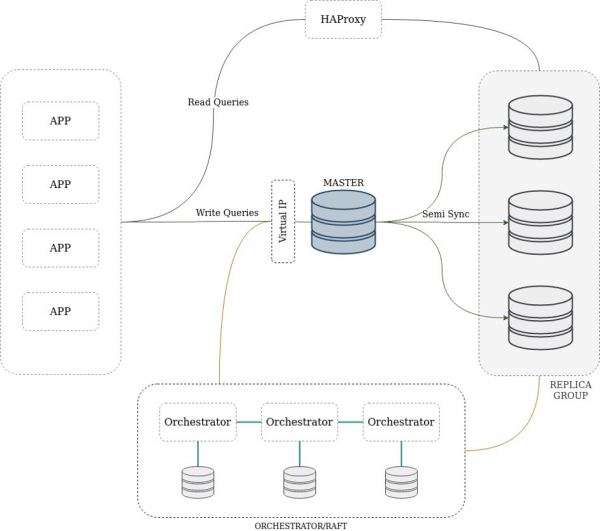
Vi anvender den klassiske replikationsordning med én master, der er tilgængelig for skrivning, og mange replikaer, der kun bruges til læsning. Klusteret kan indeholde en mellemliggende master — en node, der samtidig er både replik og master for andre. Klienter henvender sig til replikaerne gennem HAProxy, hvilket tillader jævn belastningsfordeling og nem skalering. Brugen af HAProxy skyldes historiske årsager, og vi er i øjeblikket i gang med at migrere til ProxySQL.
Replikationen udføres i halvsynkron tilstand baseret på GTID. Det betyder, at mindst én replik skal registrere transaktionen i loggen, før den betragtes som vellykket. Denne replikationsmetode sikrer den optimale balance mellem ydeevne og dataintegritet i tilfælde af svigt af hovednoden. Generelt overføres alle ændringer fra masteren til replikaerne ved hjælp af Row Based Replication (RBR), men nogle noder kan have mixed binlog format.
Orkestratoren opdaterer regelmæssigt tilstandene i klusterets topologi, analyserer de indsamlede oplysninger, og i tilfælde af problemer kan den starte proceduren for automatisk gendannelse. Selve proceduren styres af udvikleren, da den kan implementeres på forskellige måder: baseret på VIP, DNS, ved hjælp af tjenesteopdagelsestjenester eller skræddersyede mekanismer.
En af de enkle måder at gendanne masteren ved svigt er at bruge svømmende VIP-adresser.
Hvad du skal vide om denne løsning, før vi går videre:
- VIP er en IP-adresse, der ikke er knyttet til en specifik fysisk netværksgrænseflade. Når en node fejler, eller ved planlagte vedligeholdelsesarbejder, kan vi skifte VIP til en anden ressource med minimal nedetid.
- Frigivelse og tildeling af en virtuel IP-adresse er billige og hurtige operationer.
- For at arbejde med VIP kræves adgang til serveren via SSH eller brug af specialværktøjer, for eksempel
keepalived.
Lad os overveje mulige problemer med vores master og præsentere, hvordan mekanismen for automatisk genopretning skal fungere.
Der er mistet netværksforbindelse til masteren, eller der er opstået et problem på 'hardware'-niveau, og serveren er utilgængelig.
- Orkestratoren opdaterer klyngens topologi, hver replika rapporterer om utilgængeligheden af masteren. Orkestratoren starter processen med at vælge en replika, der er egnet til rollen som ny master, og begynder genopretningen.
- Vi forsøger at fjerne VIP fra den gamle master — uden held.
- Replikaen skifter til rollen som master. Topologien omstruktureres.
- Vi tilføjer en ny netværksgrænseflade med VIP. Da det ikke lykkedes at fjerne VIP, startes der i baggrunden en periodisk afsendelse af forespørgsler, gratuitous ARP. Denne type anmodning/response tillader opdatering af IP- og MAC-adresseopslagstabellen på de tilsluttede switches, hvilket dermed informerer om flytningen af vores VIP. Dette minimerer sandsynligheden for
split brainved tilbagevenden af den gamle master. - Alle nye forbindelser omdirigeres straks til den nye master. Gamle forbindelser mislykkes, og der foretages nye forespørgsler til databasen på applikationsniveau.
Serveren fungerer normalt, der er sket et nedbrud på DBMS-niveau.
Algoritmen er lig den forrige situation: opdatering af topologien og igangsættelse af genopretningsprocessen. Da serveren er tilgængelig, frigiver vi succesfuldt VIP på den gamle master, flytter den til den nye og sender flere ARP-forespørgsler. En mulig tilbagevenden af den gamle master bør ikke påvirke den omstrukturerede klynge og applikationens funktion.
Andre problemer
Nedbrud af replikaer eller intermediære mestre fører ikke til automatiske handlinger og kræver manuel indgriben.
Den virtuelle netværksgrænseflade tilføjes altid midlertidigt, det vil sige, at efter genstart af serveren tildeles VIP automatisk ikke. Hver DB-instans starter som standard i skrivebeskyttet tilstand, orkestret skifter automatisk den nye master til skrivning og forsøger at etablere skrivebeskyttet på den gamle master. Disse handlinger har til formål at reducere sandsynligheden for split brain.
Under genoprettelsen kan der opstå problemer, som også bør meddeles gennem orkestrets UI ud over de standard overvågningsværktøjer. Vi har udvidet REST API'et med en sådan mulighed ( er i øjeblikket under overvejelse).
Den overordnede skabelon for HA-løsningen præsenteres nedenfor.
Valg af ny master
Orkestret er tilstrækkeligt intelligent og prøver at vælge som ny master baseret på følgende kriterier:
- efterslæb af replikaen i forhold til masteren;
- versionen af MySQL for masteren og replikaen;
- typen af replikering (RBR, SBR eller mixed);
- placering i samme eller forskellige datacentre;
- tilstedeværelse
errant GTID— transaktioner, der er blevet udført på replikaen og mangler på masteren; - brugerdefinerede regler for valg tages også i betragtning.
Ikke hver replika er en ideel kandidat til rollen som master. For eksempel kan replikaen blive brugt til sikkerhedskopiering af data, eller serveren kan have en svagere 'hardware'-konfiguration. Orkestret håndterede regler, der gør det muligt at indstille dine præferencer for udvælgelse af kandidater fra de mest ønskede til de ignorerede.
Reaktionstid og genopretning
I tilfælde af en hændelse er det vigtigt at minimere systemets nedetid, så vi overvejer MySQL-parametrene, der påvirker opbygningen og opdateringen af cluster-topologien af orkestret:
- — antallet af sekunder, som replikaen venter på at modtage nye data eller heartbeat-signal fra masteren, før forbindelsen betragtes som tabt, og genoprettelse udføres. Jo lavere værdi, jo hurtigere kan replikaen bestemme, at forbindelsen til masteren er brudt. Vi sætter denne værdi til 5 sekunder.
- — antal sekunder mellem genforbindelsesforsøg. I tilfælde af netværksproblemer vil en lav værdi af denne parameter muliggøre hurtig genforbindelse og forhindre, at processen med at gendanne klyngen starter. Den anbefalede værdi er 1 sekund.
MASTER_RETRY_COUNT— det maksimale antal genforbindelsesforsøg.MASTER_HEARTBEAT_PERIOD— intervallet i sekunder, hvorefter master sender et heartbeat-signal. Som standard er det halvdelen af værdienslave_net_timeout.
Orkestratorparametre:
DelayMasterPromotionIfSQLThreadNotUpToDate— hvis det er lig medtrue, vil masterrollen ikke blive anvendt på det kandidat-replika, før SQL-tråden på replikanten har udført alle de uansøgte transaktioner fra Relay Log. Vi bruger denne mulighed for ikke at miste transaktioner under betingelser, hvor alle kandidat-replikaer er bagud.InstancePollSeconds— frekvensen af opbygning og opdatering af topologi.RecoveryPollSeconds— frekvensen af topologianalyse. Ved opdagelse af et problem startes gendannelsen af topologi. Dette, der er lig med 1 sekund.
Hver node i klyngen spørges af orkestratoren én gang hvert InstancePollSeconds sekund. Ved opdagelse af et problem opdateres klyngens tilstand tvungetTestningen af HA-ordningen begyndte vi med at udvikle et lokalt
Testbænk
testmiljø Under øvelserne vælger vi en af metoderne til at simulere problemet: hurtigt dræbe masteren ved hjælp af
, blidt afslutte processen og stoppe serveren ( kill -9docker-compose stop), simulere netværksproblemer ved hjælp afiptables -j REJECT iptables -j DROP eller . Vi forventer følgende resultater:orkestratoren vil opdage problemer med masteren og opdatere topologien på ikke mere end 10 sekunder;
- gendannelsesproceduren vil automatisk starte: netværkskonfigurationen vil ændres, masterrollen vil overgå til replikatet, topologien vil blive ombygget;
- автоматически запустится процедура восстановления: изменится сетевая конфигурация, роль мастера перейдёт к реплике, топология перестроится;
- den nye master vil være tilgængelig for skrivning, og de levende repliker vil ikke gå tabt under ombygningen;
- data vil begynde at blive skrevet til den nye master og repliceres;
- den samlede gendannelsestid vil være højst 30 sekunder.
Som du ved, kan systemet opføre sig forskelligt i test- og produktionsmiljøer på grund af forskellig hardwarekonfiguration og netværk, samt forskelle i syntetisk og reel belastning osv. Derfor gennemfører vi jævnligt øvelser under reale forhold for at teste, hvordan systemet reagerer ved tab af netværksforbindelse eller nedbrydning af dets enkelte dele. I fremtiden ønsker vi at opbygge en fuldt identisk infrastruktur for begge miljøer og automatisere dens testning.
Konklusioner
Funktionaliteten af hovednoden i datalagringssystemet er en af de primære opgaver for SRE-teamet og driften. Implementeringen af orkestratoren og HA-løsningen baseret på VIP har givet følgende resultater:
- pålidelig opdagelse af problemer med DB-clusterets topologi;
- automatisk og hurtig reaktion på hændelser relateret til masteren, hvilket reducerer systemets nedetid.
Men løsningen har sine begrænsninger og ulemper:
- skalerings-HA-skemaet på flere datacentre kræver en fælles L2-netværk mellem dem;
- før vi tildeler VIP på den nye master, skal vi frigøre det på den gamle. Processen er sekventiel, hvilket øger gendannelsestiden;
- frigivelse af VIP kræver SSH-adgang til serveren eller en anden metode til at kalde fjerntjenester. Da serveren eller databasen oplever problemer, der førte til gendannelsesprocessen, kan vi ikke være sikre på, at frigivelsen af VIP vil være vellykket. Dette kan føre til, at to servere har den samme virtuelle IP-adresse, hvilket skaber et problem.
split brain.
For at undgå split brain, kan man bruge metoden (“Shoot The Other Node In The Head”), som fuldstændigt isolerer eller frakobler den problematiske node. Der er også andre måder at implementere høj tilgængelighed i klusteret: en kombination af VIP og DNS, serviceopdagelse og proxy-tjenester, synkron replikation og andre metoder, som har deres fordele og ulemper.
Jeg har fortalt om vores tilgang til at skabe en fejltolerant MySQL-klynge. Den er enkel at implementere og giver et acceptabelt niveau af pålidelighed under de nuværende forhold. Efterhånden som hele systemet og infrastrukturen udvikler sig, vil denne tilgang uden tvivl også udvikle sig.
Kilde: habr.com
