

Et kort indledende ord
Jeg mener, at vi kunne udføre flere opgaver, hvis vi fik trinvise instruktioner, der fortalte os, hvad vi skulle gøre og hvordan. Jeg kan selv huske øjeblikke i mit liv, hvor jeg ikke kunne begynde på noget, fordi det var svært at forstå, hvor man skulle starte. Måske har du engang set ordene "Data Science" på internettet og tænkt, at du var langt fra det, og at folk, der beskæftiger sig med det, er et helt andet sted. Men de er lige her. Og måske, takket være folk fra denne branche, har en artikel om emnet dukket op i din feed. Der findes mange kurser, der kan hjælpe dig med at mestre dette håndværk, og her vil jeg hjælpe dig med at tage dit første skridt.
Er du klar? Jeg siger straks, at du skal kunne Python 3, da jeg vil bruge det her. Jeg anbefaler også, at du installerer Jupyter Notebook på forhånd eller ser, hvordan du bruger Google Colab.
Første skridt
Kaggle er din betydelige allierede i denne opgave. Man kan i princippet klare sig uden det, men det vil jeg fortælle om i en anden artikel. Det er en platform, hvor der afholdes konkurrencer i Data Science. I de tidlige faser af hver sådan konkurrence vil du få en utrolig mængde erfaring med at løse opgaver af forskellige slags, erfaring med udvikling og teamwork, hvilket er vigtigt i vores tid.
Vi vil tage vores opgave derfra. Den hedder: "Titanic". Problemet er som følger: at forudsige, om hver enkelt person overlever. Generelt set er opgaven for en person, der beskæftiger sig med DS, at indsamle data, behandle dem, træne en model, lave forudsigelser osv. På Kaggle kan vi dog springe dataindsamlingen over — de er tilgængelige på platformen. Vi skal downloade dem, så kan vi begynde arbejdet!
Det kan gøres på følgende måde:
Under fanen Data findes de filer, der indeholder dataene.


Vi har downloadet dataene, forberedt vores Jupyter-notesbøger og…
Andet skridt
Hvordan downloader vi nu disse data?
For det første importerer vi de nødvendige biblioteker:
import pandas as pd
import numpy as np
Pandas vil gøre det muligt for os at indlæse .csv-filer til videre behandling.
Numpy er nødvendigt for at repræsentere vores datatabel som en matrix med tal.
Lad os komme videre. Vi tager filen train.csv og downloader den:
dataset = pd.read_csv('train.csv')
Vi vil referere til vores udvalg af train.csv data gennem variablen dataset. Lad os tage et kig på, hvad der er der:
dataset.head()
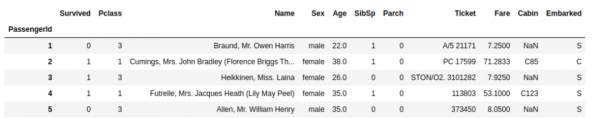
Funktionen head() giver os mulighed for at se de første par rækker i datasættet.
Kolonnen Survived er netop vores resultater, som er kendte i dette datasæt. I forhold til opgaven skal vi forudsige kolonnen Survived for dataene i test.csv. Disse data indeholder information om andre Titanic-passagerer, hvis udfald vi ikke kender.
Lad os derfor opdele vores tabel i afhængige og uafhængige data. Det er ret enkelt. Afhængige data er de data, der afhænger af de uafhængige, det vil sige, hvad der findes i udfaldene. Uafhængige data er de data, der påvirker udfaldet.
For eksempel har vi et sådant datasæt:
«Vova studerede informatik — nej.
Vova fik karakteren 2 i informatik.»
Karakteren i informatik afhænger af svaret på spørgsmålet: Studerede Vova informatik? Klar? Lad os komme videre, vi er allerede tættere på målet!
Den traditionelle variabel for uafhængige data er X. For afhængige er det y.
Vi gør følgende:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Hvad er det? Med funktionen iloc[:, 2: ] siger vi til Python: Jeg vil se dataene, der starter fra den anden kolonne (inklusive, forudsat at tællingen starter fra nul). I den anden linje siger vi, at vi vil se dataene fra den første kolonne i y.
[ a:b, c:d ] — dette er konstruktionen, som vi bruger i parenteserne. Hvis vi ikke angiver nogle variabler, vil de blive gemt som standard. Det vil sige, at vi kan angive [:,: d] og så får vi i datasættet alle kolonner undtagen dem, der starter fra nummer d og videre. Variablerne a og b bestemmer rækkerne, men vi har brug for dem alle, så vi lader det være som standard.
Lad os se, hvad vi har fået:
X.head() 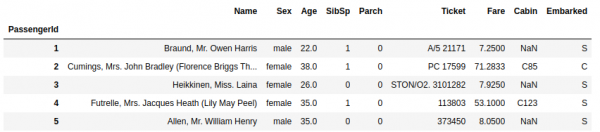
y.head() 
For at forenkle denne korte lektion vil vi fjerne kolonnerne, der kræver særlig 'pleje', eller som slet ikke påvirker overlevelsen. De indeholder data af typen str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Lad os gå til næste skridt.
Skridt tre
Her skal vi kode vores data, så maskinen bedre kan forstå, hvordan disse data påvirker resultatet. Men vi vil ikke kode alt, kun datatyper som str, som vi har efterladt. Kolonnen "Sex". Hvordan vil vi kode det? Lad os forestille os dataene om personens køn som en vektor: 10 — mand, 01 — kvinde.
Først skal vi konvertere vores tabeller til en NumPy-matrix:
X = np.array(X)
y = np.array(y)
Og nu ser vi:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Biblioteket sklearn er et fantastisk bibliotek, der gør det muligt for os at udføre hele arbejdet inden for data science. Det indeholder et stort antal interessante maskinlæringsmodeller samt hjælper os med dataforberedelse.
OneHotEncoder vil gøre det muligt for os at kode personens køn i det format, vi har beskrevet. Der vil blive oprettet 2 klasser: mandlig, kvindelig. Hvis personen er mand, vil der blive skrevet 1 i kolonnen "mandlig", og i "kvindelig" vil der være 0.
Efter OneHotEncoder() kommer [1] — det betyder, at vi ønsker at kode kolonne nummer 1 (nul-baseret tælling).
Super. Lad os komme videre!
Som regel sker det, at nogle data forbliver ufyldte (det vil sige NaN — not a number). For eksempel er der information om en person: hans navn, køn, men data om hans alder mangler. I sådanne tilfælde anvender vi følgende metode: vi finder det aritmetiske gennemsnit for alle kolonner, og hvis nogen data i kolonnen er manglende, fylder vi tomrummet med det aritmetiske gennemsnit.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Og nu skal vi tage højde for, at der kan opstå situationer, hvor dataene er meget spredte. Nogle data ligger i intervallet [0:1], mens andre kan gå op i hundreder og tusinder. For at udelukke sådan spredning og gøre computeren mere præcis i beregningerne, vil vi skalere dataene, gøre dem proportionalt mindre. Lad os sikre os, at ingen tal overstiger tre. Til dette formål vil vi bruge funktionen StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Nu ser vores data sådan ud:

Klassisk. Vi er allerede tættere på vores mål!
Trin fire
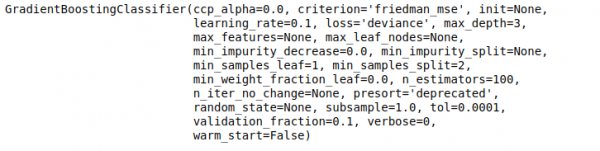
Lad os træne vores første model! I sklearn-biblioteket kan vi finde mange interessante ting. Jeg har anvendt Gradient Boosting Classifier-modellen til denne opgave. Vi bruger en classifier, da vores opgave er en klassificeringsopgave. Vi skal forudsige, om en person tilhører 1 (overlevet) eller 0 (ikke overlevet).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funktionen fit fortæller Python: Lad modellen finde sammenhænge mellem X og y.
På mindre end et sekund er modellen klar.
Hvordan anvender vi den? Det ser vi nu!
Trin fem. Konklusion
Nu skal vi indlæse tabellen med vores testdata, for hvilke vi skal lave forudsigelser. Vi vil udføre de samme handlinger med denne tabel, som vi gjorde med X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Lad os anvende vores model nu!
gbc_predict = gbc.predict(X_test)
Det er gjort. Vi har lavet forudsigelser. Nu skal vi gemme dem i en csv-fil og uploade dem til hjemmesiden.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Færdig. Vi har fået en fil med forudsigelser for hver passager. Det sidste skridt er at uploade disse beslutninger til hjemmesiden og få vurderet forudsigelsen. Denne enkle løsning giver ikke blot 74% korrekthed offentligt, men også et lille spark til Data Science. De mest nysgerrige kan skrive til mig i private beskeder og stille spørgsmål. Tak til alle!
Kilde: habr.com
