

Introduktion
 «Man skal løbe alt, hvad man kan, for kun at holde sig på stedet,
og for at komme et sted hen, skal man løbe mindst dobbelt så hurtigt!»
(c) Alice i Eventyrland
For nogen tid siden blev jeg bedt om at holde en forelæsning til vores analytikere om design af datamodeller, da vi efter at have arbejdet længe på projekter (nogle gange i flere år) mister fokus på det, der sker rundt omkring i IT-teknologierne. I vores virksomhed (som det nu engang er) bruges der på mange projekter ikke NoSQL-databaser (i det mindste ikke endnu), så i min forelæsning brugte jeg derfor lidt tid på dem med eksemplet HBase og forsøgte at rette mit materiale mod dem, der aldrig har arbejdet med dem. Især illustrerede jeg nogle aspekter af designet af datamodeller med et eksempel, som jeg for flere år siden læste . Ved at gennemgå eksemplerne sammenlignede jeg flere løsninger på den samme opgave for bedre at formidle hovedideerne til lytterne.
For nylig, «for ikke at lave noget», stillede jeg mig selv spørgsmålet (de lange majferieuger i karantæne indbyder til dette), hvor meget de teoretiske resultater vil svare til praksis? Egentlig var det sådan, at idéen til denne artikel blev født. En udvikler, der ikke er ny til NoSQL, vil måske ikke finde noget nyt i den (og derfor kan han med det samme springe halvdelen af artiklen over). Men for analytikere, som endnu ikke har arbejdet tæt med NoSQL, tror jeg, at den vil være nyttig for at få en grundlæggende forståelse af design af datamodeller til HBase.
Gennemgang af eksemplet
Efter min mening er det vigtigt at overveje fordele og ulemper, før man begynder at bruge NoSQL-databaser. Ofte kan opgaven løses med traditionelle relationelle databaser. Derfor bør NoSQL ikke anvendes uden væsentlige grunde. Hvis der alligevel er truffet beslutning om at bruge en NoSQL-database, skal man dog tage højde for, at designmetoderne her adskiller sig en smule. Især kan nogle af dem virke uvante for dem, der tidligere kun har arbejdet med relationelle databaser (efter mine observationer). I den "relationelle" verden bevæger vi os som regel fra modellering af emneområdet og derefter, hvis nødvendigt, udfører vi denormalisering af modellen. I NoSQL skal vi straks tage højde for de forventede brugsscenarier for data og i starten denormalisere oplysningerne. Derudover er der flere andre forskelle, som vil blive beskrevet nedenfor.
Lad os overveje følgende "syntetiske" opgave, som vi vil arbejde videre med:
Vi skal designe strukturen til at lagre en liste over venners relationer i et abstrakt socialt netværk. For enkelhedens skyld antager vi, at alle forbindelser er retningsbestemte (som på Instagram, ikke LinkedIn). Strukturen skal effektivt muliggøre:
- At svare på, om bruger A følger bruger B (læsemønster)
- At tillade tilføjelse/fjernelse af forbindelser i tilfælde af at bruger A tilmelder sig/afmelder sig bruger B (ændringsmønster)
Selvfølgelig er der mange måder at løse opgaven på. I en almindelig relationel database ville vi sandsynligvis blot have lavet en tabel for forbindelser (muligvis typet, hvis det for eksempel kræves at opbevare en brugergruppe: familie, arbejde osv. til hvilken denne "ven" tilhører), og for at optimere adgangshastigheden ville vi tilføje indekser/partitionering. Den endelige tabel ville sandsynligvis se nogenlunde sådan ud:
bruger_id
ven_id
Vase
Petya
Vase
Olya
her og videre for tydelighedens og bedre forståelsens skyld vil jeg angive navne i stedet for ID'er
I tilfælde af HBase ved vi, at:
- effektiv søgning, der ikke fører til en fuld tabelskanning, er mulig udelukkende baseret på nøglen
- Netop derfor er det en dårlig idé at skrive almindelige SQL-forespørgsler til sådanne databaser; teknisk set kan du selvfølgelig sende en SQL-forespørgsel med joins og anden logik fra Impala til HBase, men hvor effektivt vil det være...
Derfor er vi nødt til at bruge bruger-ID'et som nøgle. Den første tanke om "hvor og hvordan man opbevarer ID'erne på vennerne?" kan være idéen om at opbevare dem i kolonner. Denne mest åbenlyse og "naive" mulighed ville se nogenlunde således ud (lad os kalde det Mulighed 1 (standard), så vi kan henvise til det senere):
RowKey
Kolonner
Vase
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Her svarer hver række til en enkelt bruger i netværket. Kolonnerne har navne: 1, 2, ... - efter antal venner, og i kolonnerne opbevares venners ID'er. Det er vigtigt at bemærke, at hver række vil have et forskelligt antal kolonner. I eksemplet ovenfor har én række tre kolonner (1, 2 og 3), mens den anden kun har to (1 og 2) - her benyttede vi to egenskaber ved HBase, som ikke findes i relationelle databaser:
- muligheden for dynamisk at ændre sammensætningen af kolonner (tilføj en ven -> tilføj en kolonne, fjern en ven -> fjern en kolonne)
- forskellige rækker kan have forskellige sammensætninger af kolonner
Lad os tjekke vores struktur for at se, om den opfylder kravene:
- Læsning af data: for at forstå, om Vasya er tilmeldt Olya, skal vi læse hele rækken ved at bruge RowKey = "Vasya" og gennemgå kolonneværdierne, indtil vi "møder" Olya i dem. Eller gennemgå værdierne i alle kolonner, "ikke møde" Olya og returnere svaret False;
- Ændring af data: tilføjelse af en ven: til en sådan opgave skal vi også læse hele rækken ved at bruge RowKey = "Vasya" for at tælle det samlede antal hans venner. Dette samlede antal venner er nødvendigt for at bestemme kolonnenummeret, hvor ID'et på den nye ven skal skrives.
- Ændring af data: sletning af en ven:
- Vi skal læse hele rækken ved at bruge RowKey = "Vasya" og gennemgå kolonnerne for at finde den specifikke, hvor den slettede ven er gemt;
- Derefter skal vi, efter sletningen af vennen, "flytte" alle data en kolonne over for ikke at få "huller" i nummereringen.
Lad os nu vurdere, hvor produktive de algoritmer, som vi skal implementere på siden af "den hypotetiske applikation", vil være, ved at bruge Lad os betragte størrelsen af vores hypotetiske sociale netværk som n. Den maksimale antal venner, en bruger kan have, er (n-1). Vi kan i fremtiden forsømme denne (-1), da den i forbindelse med brugen af O-symbolik er ubetydelig.
- Læsning af data: det er nødvendigt at læse hele rækken og gennemgå alle dens kolonner. Så den øvre grænse for omkostninger vil være cirka O(n)
- Ændring af data: tilføjelse af en ven: for at bestemme antallet af venner er det nødvendigt at gennemgå alle kolonner i rækken, hvorefter der indsættes en ny kolonne => O(n)
- Ændring af data: sletning af en ven:
- På samme måde som ved tilføjelse – det kræver at gennemgå alle kolonner => O(n)
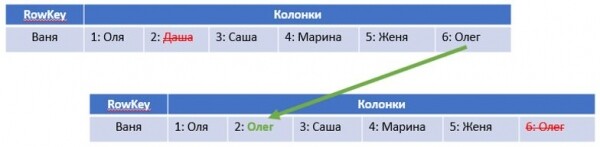
- Efter fjernelse af kolonnerne skal vi "skubbe" dem. Hvis vi implementerer dette direkte, vil det kræve op til (n-1) operationer. Men vi vil her og i det følgende anvende en anden tilgang, der vil udføre en "pseudo-skub" med et fast antal operationer – det vil sige, at det vil tage konstant tid uanset n. Denne konstante tid (for at være præcis, O(2)) kan sammenlignes med O(n), som vi kan forsømme. Tilgangen er illustreret på tegningen nedenfor: vi kopierer blot dataene fra den "sidste" kolonne til den, hvor dataene skal fjernes, hvorefter vi fjerner den sidste kolonne:

I alt har vi i alle scenarier opnået en asymptotisk beregningstid O(n).
Måske har du allerede bemærket, at vi næsten altid skal læse hele rækken fra databasen, og i to ud af tre tilfælde kun for at gennemgå alle kolonnerne og tælle det samlede antal venner. Derfor kan vi som et forsøg på optimering tilføje en kolonne "count", hvor det samlede antal venner for hver bruger i netværket opbevares. På denne måde kan vi undgå at læse hele rækken for at tælle det samlede antal venner og kun læse en kolonne "count". Det vigtigste er ikke at glemme at opdatere "count" ved manipulation af dataene. Derved opnår vi en forbedring Mulighed 2 (count):
RowKey
Kolonner
Vase
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
Sammenlignet med den første mulighed:
- Læsning af data: for at få svar på spørgsmålet "Læser Vasya Olya?" er der ikke sket nogen ændringer => O(n)
- Ændring af data: tilføjelse af en ven: Vi har forenklet indsættelsen af en ny ven, da vi nu ikke behøver at læse hele rækken og gennemgå dens kolonner, men i stedet kan få værdien fra kolonnen 'count' og dermed straks bestemme nummeret på kolonnen til indsættelse af den nye ven. Dette reducerer den beregningsmæssige kompleksitet til O(1)
- Ændring af data: sletning af en ven: Ved sletning af en ven kan vi også benytte denne kolonne for at reducere antallet af I/O-operationer ved 'flytningen' af data én celle til venstre. Men behovet for at gennemgå kolonnerne for at finde den, der skal slettes, forbliver, så => O(n)
- På den anden side betyder det, at vi nu ved opdatering af data hver gang skal opdatere kolonnen 'count', men dette tager konstant tid, som i O-notationen kan ignoreres.
Generelt synes løsning 2 at være lidt mere optimal, men det er snarere 'en evolution snarere end en revolution'. For at gennemføre en 'revolution' har vi brug for Løsning 3 (col).
Lad os vende alt 'på hovedet': vi tildeler kolonnen navnet som brugeridentifikator.! Hvad der skrives i selve kolonnen er ikke så vigtigt for os; det kan være tallet 1 (der kan også gemmes nyttige oplysninger såsom gruppe 'familie/venner/osv.'). Denne tilgang kan overraske den uforberedte 'almindelige' person, som ikke tidligere har haft erfaring med NoSQL-databaser, men den giver os mulighed for at udnytte HBase's potentiale i denne opgave meget mere effektivt:
RowKey
Kolonner
Vase
Petja: 1
Olga: 1
Dasha: 1
Petya
Masha: 1
Vasia: 1
Her får vi med det samme flere fordele. For at forstå dem, lad os analysere den nye struktur og vurdere den beregningsmæssige kompleksitet:
- Læsning af data: For at besvare spørgsmålet om, hvorvidt Vasia er tilmeldt Olga, er det nok at læse én kolonne 'Olga': hvis den findes, er svaret True, hvis ikke – False => O(1)
- Ændring af data: tilføjelse af en ven: Tilføjelse af en ven: det er nok blot at tilføje en ny kolonne 'ven ID' => O(1)
- Ændring af data: sletning af en ven: det er nok blot at slette kolonnen 'ven ID' => O(1)
Som vi kan se, er en væsentlig fordel ved denne lagringsmodel, at vi i alle de nødvendige scenarier kun arbejder med én kolonne, hvilket undgår at læse hele rækken fra databasen og især at gennemgå alle kolonnerne i denne række. Vi kunne have afsluttet her, men...
Man kan tænke videre og optimere ydeevnen samt reducere input-output operationer ved adgang til databasen. Hvad hvis man gemmer al information om forbindelsen direkte i selve række-nøglen? Det vil sige at lave nøglen som en sammensat type som userID.friendID? I så fald behøver vi slet ikke at læse kolonnerne i rækken.Valg 4 (row)):
RowKey
Kolonner
Vasya.Petya
Petja: 1
Vasya.Olya
Olga: 1
Vasya.Dasha
Dasha: 1
Petya.Masha
Masha: 1
Petya.Vasya
Vasia: 1
Det er åbenlyst, at vurderingen af alle scenarier for datamanipulation i denne struktur, ligesom i den tidligere variant, vil være O(1). Forskellen fra variant 3 vil kun være effektiviteten af input-output operationer i databasen.
Og til sidst, en 'sløjfe'. Det er let at bemærke, at i variant 4 vil vores række-nøgle have variable længde, hvilket muligvis kan påvirke ydeevnen (her husker vi, at HBase gemmer data som byte-sæt og rækker i tabellerne er sorteret efter nøgle). Plus, vi har en separator, der i nogle scenarier kan kræve behandling. For at udelukke denne påvirkning kan vi bruge hashes af userID og friendID, og eftersom begge hashes vil have en konstant længde, kan vi blot sammenkæde dem uden separator. Så vil dataene i tabellen se således ud:Valg 5 (hash)):
RowKey
Kolonner
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petja: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olga: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasia: 1
Det er åbenlyst, at den algoritmiske kompleksitet ved at arbejde med en sådan struktur i de scenarier, vi ser på, vil være den samme som i variant 4 – det vil sige O(1).
Sammenfattende vil vi samle alle vores vurderinger af den beregningsmæssige kompleksitet i en tabel:
Tilføjelse af en ven
Kontrol af ven
Sletning af ven
Mulighed 1 (standard)
O(n)
O(n)
O(n)
Valg 2 (count)
O(1)
O(n)
O(n)
Valg 3 (column)
O(1)
O(1)
O(1)
Valg 4 (row)
O(1)
O(1)
O(1)
Valg 5 (hash)
O(1)
O(1)
O(1)
Som det fremgår, ser mulighederne 3-5 ud til at være de mest foretrukne og teoretisk set sikrer, at alle nødvendige datamanipulationsscenarier kan udføres på konstant tid. I betingelsen for vores opgave er der ikke noget klart krav om at få en liste over alle brugerens venner, men i det virkelige projektarbejde ville det som gode analytikere være klogt at "forudse", at en sådan opgave kan opstå, og "lægge en dyne". Derfor er mine præferencer på siden af mulighed 3. Men det er helt muligt, at denne forespørgsel i et reelt projekt allerede kunne være løst med andre midler, så uden et samlet syn på hele opgaven er det bedst ikke at drage endelige konklusioner.
Forberedelse af eksperimentet
De ovenfor nævnte teoretiske overvejelser ønskes nu afprøvet i praksis – det var formaliteten bag den idé, der opstod i løbet af de lange weekender. For dette er det nødvendigt at vurdere hastigheden af vores "hypotetiske applikation" under alle de beskrevne scenarios for anvendelse af databasen, samt stigningen i denne tid i takt med størrelsen af det sociale netværk (n). Den parameter, der interessere os og som vi vil måle under eksperimentet, er den tid, som "den hypotetiske applikation" bruger på at udføre én "forretningsoperation". Med "forretningsoperation" skal vi forstå en af følgende:
- Tilføjelse af én ny ven
- Kontrol af, om bruger A er ven med bruger B
- Sletning af én ven
Dermed, i betragtning af de krav, der er angivet i den oprindelige problemformulering, tegner scenariet for kontrol sig som følgende:
- Optagelse af data. Generér tilfældigt et udgangspunkt netværk af størrelse n. For større nærhed til "den virkelige verden" skal antallet af venner for hver bruger også være en tilfældig størrelse. Mål den tid, det tager vores "hypotetiske applikation" at skrive alle de genererede data til HBase. Del derefter den opnåede tid med det samlede antal tilføjede venner – således får vi den gennemsnitlige tid pr. "forretningsoperation".
- Læsning af data. For each user, create a list of 'profiles' to check whether the user is subscribed to them or not. The length of the list should be approximately equal to the number of the user's friends, with half of the checked friends yielding a 'Yes' response and half a 'No'. The checks should be performed in such a way that 'Yes' and 'No' alternate (meaning we will need to cycle through all columns of the row for options 1 and 2 every second case). The total check time is then divided by the number of friends checked to obtain the average time per check.
- Data deletion. Remove all friends from the user. The order of deletion should be random (that is, 'shuffle' the initial list used for recording the data). The total check time is then divided by the number of friends deleted to obtain the average time per check.
The scenarios need to be run for each of the 5 variations of data models and for different sizes of the social network, to see how the time changes as it grows. Within one n connection in the network, the list of users to check should naturally be the same for all 5 variations.
For better understanding, below is an example of generated data for n= 5. The written 'generator' produces three dictionaries of IDs as output:
- first – for insertion
- second – for checking
- third – for deletion
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # a total of 15 friends

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # a total of 18 subjects checked

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # a total of 15 friends
As can be seen, all IDs over 10,000 in the check dictionary are precisely those that will give a False answer. Insertion, checking, and deletion of 'friends' is carried out exactly in the sequence specified in the dictionary.
The experiment was conducted on a laptop running Windows 10, where one Docker container was running an HBase database, and another was running Python with Jupyter Notebook. Docker was allocated 2 CPU cores and 2 GB of RAM. All logic, including the emulation of the 'conditional application' and the 'wrapper' for generating test data and measuring time, was written in Python. The library used for working with HBase was , for calculating hashes (MD5) for option 5 — hashlib
Under consideration of the computational power of a specific laptop, a launch for n = 10, 30, … 170 was experimentally chosen – when the total time of the full testing cycle (all scenarios for all options for all n) was still somewhat reasonable and fit within the time of one tea break (on average 15 minutes).
It is important to note that in this experiment we primarily assess not absolute performance figures. Even the relative comparison of two different options may not be entirely accurate. Currently, we are interested in the nature of the change in time depending on n, as with the configuration of the 'test bench' mentioned above, obtaining time estimates that are 'cleansed' of random and other factors is very difficult (and such a task was not set).
Experiment Result
The first test – how the time spent on filling the friends list changes. The result – in the graph below.
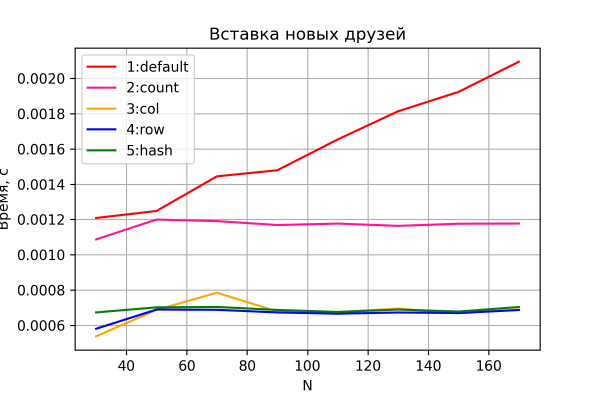
Options 3-5 show predictably almost constant time for the 'business operation', which does not depend on the growth of the network size, with no distinguishable difference in performance.
Option 2 also shows constant performance, but slightly worse, almost exactly twice as much compared to options 3-5. This is encouraging, as it aligns with theory – in this option, the number of input/output operations to/from HBase is indeed twice as high. This could serve as indirect evidence that our test bench provides decent accuracy.
Option 1, as expected, turns out to be the slowest and demonstrates linear growth in time spent on adding a single friend, dependent on the size of the network.
Now let's look at the results of the second test.
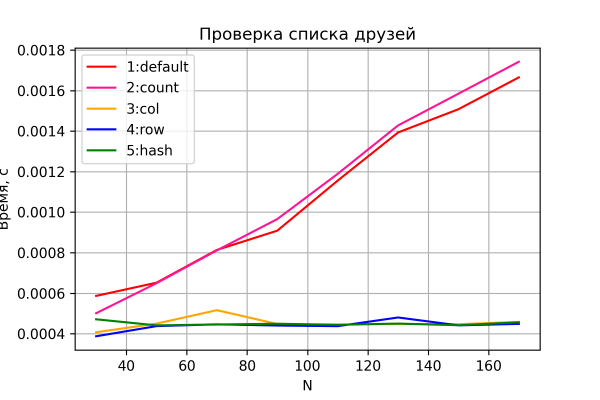
Variationerne 3-5 opfører sig igen som forventet – konstant tid, uafhængig af netværksstørrelsen. Variationerne 1 og 2 viser en lineær stigning i tiden, når netværksstørrelsen vokser og har en lignende ydeevne. Variation 2 viser sig dog at være lidt langsommere – tilsyneladende på grund af behovet for at læse og behandle den ekstra kolonne "count", hvilket bliver mere mærkbart, når n vokser. Men jeg vil stadig undlade at drage nogen konklusioner, da nøjagtigheden af denne sammenligning er ret lav. Desuden har forholdene (hvilken variation, 1 eller 2, der er hurtigere) ændret sig fra kørsel til kørsel (mens de bevarer karakteren af afhængigheden og "går næse ved næse").
Og den sidste graf – resultatet af testningen af sletning.
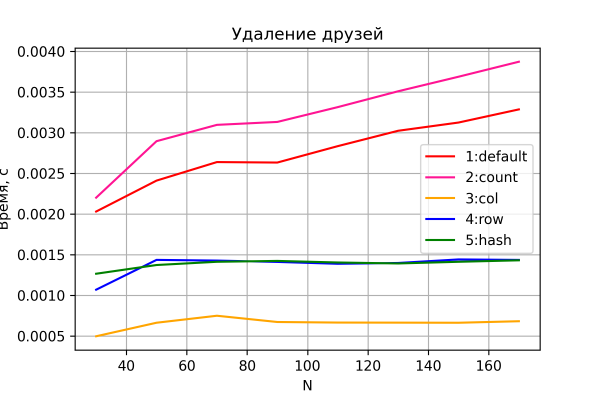
Her er der igen ingen overraskelser. Variationerne 3-5 gennemfører sletning på konstant tid.
Og hvad der er interessant, variationerne 4 og 5 viser, i modsætning til de tidligere scenarier, en lidt dårligere ydeevne end variation 3. Tilsyneladende er operationen med at slette en række mere omkostningsfuld end operationen med at slette en kolonne, hvilket i det hele taget giver mening.
Variationerne 1 og 2 viser, som forventet, en lineær stigning i tiden. Samtidig er variation 2 konsekvent langsommere end variation 1 – på grund af den ekstra input/output-operation ved "vedligeholdelse" af kolonnen count.
Generelle konklusioner fra eksperimentet:
- Variationerne 3-5 viser større effektivitet, da de udnytter fordelene ved HBase; deres ydeevne varierer kun med en konstant, og den afhænger ikke af netværksstørrelsen.
- Forskellen mellem variationerne 4 og 5 blev ikke registreret. Men det betyder ikke, at variation 5 ikke bør anvendes. Det er meget muligt, at det anvendte eksperimentelle scenarie, med hensyn til specifikationerne for testmiljøet, ikke gjorde det muligt at afsløre det.
- Karakteren af den tid, der kræves for at udføre "forretningsoperationer" med data, bekræftede generelt de tidligere teoretiske resultater for alle variationer.
Epilog
Grovende eksperimenter bør ikke opfattes som absolute sandheder. Der er mange faktorer, der ikke er blevet taget i betragtning og har forårsaget forvrængninger i resultaterne (særligt synlige fluktuationer på grafer ved små netværksstørrelser). For eksempel hastigheden af thrift, der anvendes af happybase, volumen og implementeringsmetoden for den logik, jeg havde skrevet i Python (jeg påtager mig ikke at sige, at koden var skrevet optimalt og effektivt udnyttede alle komponenters muligheder), muligvis specifikationen af HBase caching, baggrundsaktivitet fra Windows 10 på min bærbare computer osv. Generelt kan det siges, at alle teoretiske udledninger har vist deres levedygtighed eksperimentelt. Eller i det mindste kunne de ikke afvises ved et sådant "frontalangreb".
Afslutningsvis — anbefalinger til alle, der lige er begyndt at designe datamodeller i HBase: abstraher fra tidligere erfaringer med relationelle databaser og husk "budene":
- Når vi designer, starter vi fra opgaven og datamanipulationsmønstrene, ikke fra modellen for det emneområde
- Effektiv adgang (uden full table scan) – kun via nøgle
- Denoormalisering
- Forskellige rækker kan indeholde forskellige kolonner
- Dynamisk sammensætning af kolonner
Kilde: habr.com
