

Vi havde 2 sække græs, 75 meskalin tabletter, et Unix-miljø, et Docker-repositorium og opgaven var at implementere kommandoerne docker pull og docker push uden Docker-klienten.
OPD:
Spørgsmål: Hvad skal alt dette bruges til?
Svar: Belastningstestning af produktet (IKKE ved hjælp af bash, skripterne gives til uddannelsesmæssige formål). Det blev besluttet at undgå Docker-klienten for at reducere unødvendige lag (inden for rimelige grænser) og dermed simulere en højere belastning. Resultatet var, at alle systemforsinkelser fra Docker-klienten blev fjernet. Vi fik en relativt ren belastning direkte på produktet.
I artiklen blev der anvendt GNU værktøjer.
Lad os først finde ud af, hvad disse kommandoer gør.
Så hvad bruges docker pull til? Ifølge :
"Hent et billede eller et repositorium fra et register".
Her finder vi et link til .
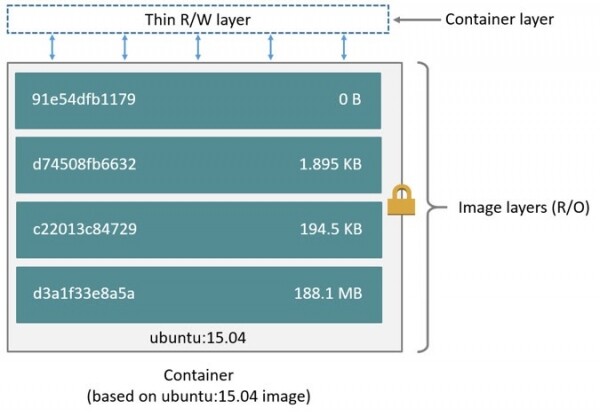
Herfra kan vi forstå, at et Docker-billede er et sæt af nogle lag, som indeholder information om de seneste ændringer i billedet, som vi åbenbart har brug for. Vi fortsætter med .
Her siges følgende:
"Et 'billede' er en kombination af et JSON-manifest og individuelle lagfiler. Processen med at hente et > billede centrerer sig om at hente disse to komponenter."
Så det første skridt ifølge dokumentationen er “Hentning af et Billedmanifest”.
Vi vil bestemt ikke hente det, men vi har brug for dataene herfra. Her gives et eksempel på en forespørgsel: GET /v2/{name}/manifests/{reference}
"Navn- og referenceparameteren identificerer billedet og er påkrævet. Referencen kan inkludere en tag eller en digest."
Vores Docker-repositorium er rullet ud lokalt, lad os prøve at udføre forespørgslen:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Som svar får vi JSON, hvori vi på nuværende tidspunkt kun er interesseret i lagene, nærmere bestemt deres hashes. Når vi har dem, kan vi gå gennem hver enkelt og udføre den følgende forespørgsel: "GET /v2/{name}/blobs/{digest}"
"Adgang til et lag vil blive reguleret af navnet på repositoriet, men er unikt identificeret i registreret af digest."
Digest er i dette tilfælde hash, som vi har fået.
Lad os prøve
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
Lad os se, hvilken fil vi endte med at få som det første lag.
file firstLayer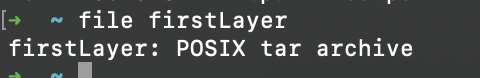
Det vil sige, at lagene repræsenterer tar-arkiver, og når vi pakker dem ud i den rigtige rækkefølge, får vi indholdet af billedet.
Lad os skrive et lille bash-script, så vi kan automatisere det hele.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Nu kan vi starte det med de ønskede parametre og få indholdet af den nødvendige image
.\/script.sh dirName "http:\/\/localhost:8081\/link\/to\/docker\/registry" myAwesomeImage 1.0Del 2 — docker push
Her bliver det lidt mere kompliceret.
Lad os starte igen med . Så vi skal uploade hver layer, samle den tilsvarende manifest og uploade den også. Det lyder tilsyneladende enkelt.
Ved at studere dokumentationen kan vi opdele upload-processen i flere trin:
- Initialisering af processen — "POST \/v2\/{repoName}\/{blobs}\/{uploads}\"
- Upload af layer (vi bruger monolitisk upload, det vil sige, at hver layer sendes i sin helhed) — "PUT \/v2\/{repoName}\/{blobs}\/{uploads}\/{uuid}?digest={digest}"
Content-Length: {size of layer}
Content-Type: application\/octet-stream
Layer Binary Data". - Upload af manifestet — "PUT \/v2\/{repoName}\/{manifests}\/{reference}".
Men dokumentationen udelader et trin, uden hvilket intet vil fungere. For monolitisk upload, ligesom for delvis (chunked), er det nødvendigt at udføre en PATCH-anmodning, før vi uploader layer:
"PATCH \/v2\/{repoName}\/{blobs}\/{uploads}\/{uuid}"
Content-Length: {size of chunk}
Content-Type: application\/octet-stream
{Layer Chunk Binary Data}".
Ellers vil du ikke kunne komme videre end det første punkt, da du i stedet for den forventede statuskode 202 vil få 4xx.
Nu ser algoritmen således ud:
- Initialisering
- Patch layer
- Upload layer
- Upload manifest
Punkterne 2 og 3 vil gentages så mange gange som nødvendigt for antallet af layers, der skal uploades.
For at starte har vi brug for en hvilken som helst image. Jeg vil bruge archlinux:latest
docker pull archlinux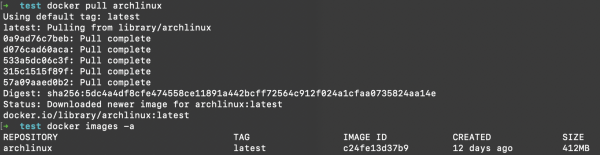
Nu gemmer vi den lokalt til videre analysere
docker save c24fe13d37b9 -o savedArch
Lad os pakke den modtagne arkiv ud i den nuværende mappe
tar xvf savedArch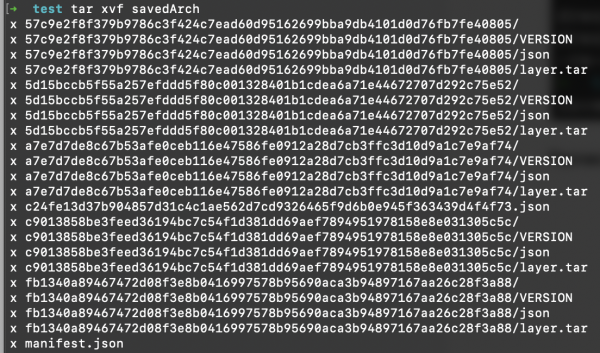
Som vi kan se, ligger hver layer i sin egen mappe. Lad os nu se på strukturen af manifestet, som vi har modtaget
cat manifest.json | json_pp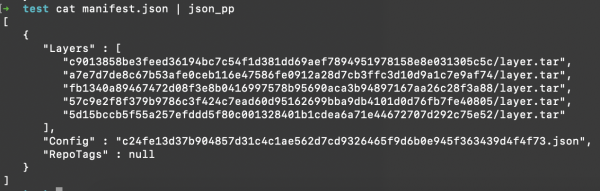
Ikke meget. Lad os se, hvilken manifest der er nødvendig for upload, i henhold til .
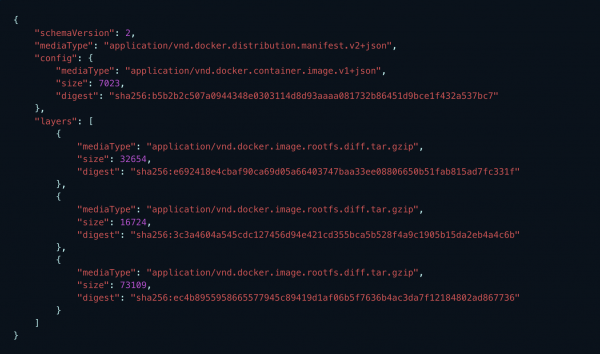
Åbenbart passer det eksisterende manifest ikke til vores behov, så vi laver vores eget med sorte kort og kvinder, layers og konfigurationer.
Vi vil altid have minimum en config-fil og et array af layers. Skema version 2 (aktuel på tidspunktet for artikelens skrivning), mediaType vil vi lade være uændret:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Efter oprettelsen af den basale manifest er det nødvendigt at udfylde den med gyldige data. Til dette formål bruger vi skabelonen for JSON-objektet for layer:
{
		 "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
		 "size": ${layersSizes[$i]},
		 "digest": "sha256:${layersNames[$i]}"
	},
den vil vi tilføje til manifestet for hver layer.
Derefter skal vi finde størrelsen på konfigurationsfilen og erstatte pladsholderne i manifestet med de reelle data
sed -i "s/config_size/[0;32m$configSize[0m/g; s/config_hash/[0;32m$configName[0m/g" $manifestFileNu kan vi initieres proces for upload af og gemme uuid, som alle følgende anmodninger skal ledsages af.
Det fulde script ser cirka sådan ud:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
vi kan bruge et færdigt script:
./uploadImage.sh "~/path/to/saved/image" "http://localhost:8081/link/to/docker/registry" myRepoName 1.0OPD:
Hvad fik vi ud af det?
For det første, reelle data til analyse, da testene kører i blazemeter, og dataene fra Docker-klienten er ret uinformative i forhold til de rene HTTP-anmodninger.
For det andet, skiftet gjorde det muligt for os at øge antallet af virtuelle brugere til Docker-upload med cirka 150% og opnå en gennemsnitlig svartid, der var 20-25% hurtigere. For Docker-download lykkedes det os at øge antallet af brugere med 500%, mens den gennemsnitlige svartid faldt med cirka 60%.
Tak for opmærksomheden.
Kilde: habr.com
