

For et halvt år siden — en offentlig til PostgreSQL.
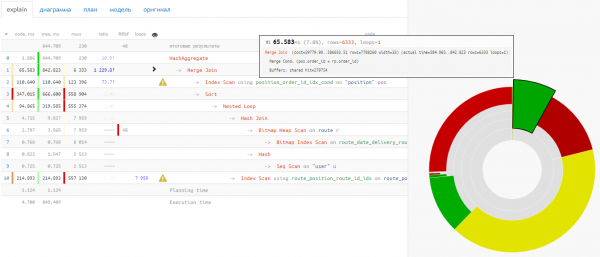
I løbet af de seneste måneder har vi lavet en præsentation om det , forberedt en opsummerende baseret på anbefalinger, som den giver... men vigtigst af alt - vi har samlet jeres feedback og set på de reelle brugsscenarier.
Og nu er vi klar til at fortælle om de nye funktioner, I kan benytte jer af.
Support til forskellige planformater
Plan fra loggen, sammen med forespørgslen
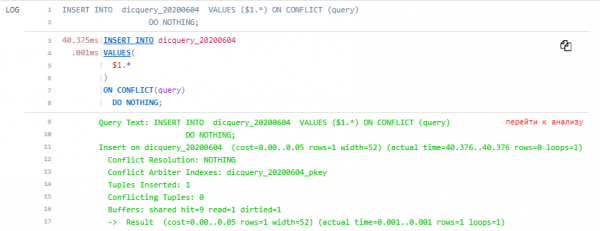
Vi vælger hele blokken fra konsollen, startende fra linjen med Query Text, med alle ledende mellemrum:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Indsæt på dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Konfliktløsning: NOTHING
          Konfliktvoldende indekser: dicquery_20200604_pkey
          Indsatte tupler: 1
          Konflikterende tupler: 0
          Buffere: shared hit=9 read=1 dirtied=1
          ->  Resultat  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
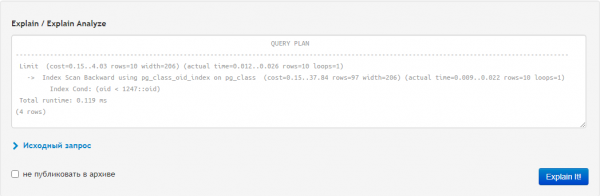
… og vi kaster alt det kopierede direkte ind i feltet for planen uden at dele det:
Som resultat får vi en bonus til den analyserede plan også med fanen „konktext“, hvor vores forespørgsel præsenteres i al sin pragt:
JSON og YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
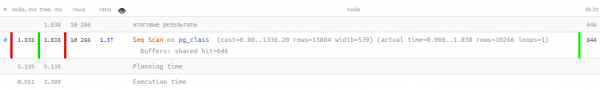
]"Uanset om det er med eller uden eksterne citationstegn, som pgAdmin kopierer, kaster vi det i det samme felt, og resultatet er fantastisk:
Udvidet visualisering
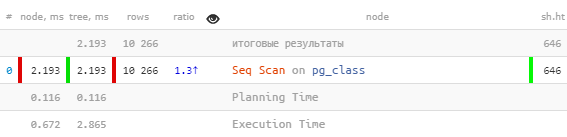
Planning Time / Execution Time
Nu er det lettere at se, hvor den ekstra tid gik hen under udførelsen af forespørgslen:
I/O Timing
Nogle gange støder man på situationer, hvor der ser ud til at være ikke så mange ressourceskriver-læsning i planen, men ikke desto mindre er udførelsestiden uforholdsmæssigt lang.
Her må vi sige: "Åh, måske var disken på serveren alt for belastet på det tidspunkt, så det tog så lang tid at læse!" Men det er ikke særlig præcist…
Men dette kan bestemt bestemmes med absolut sikkerhed. Faktisk er der indstillinger i konfigurationen af PG-serveren, der :
Inkluderer måling af I/O-operationers tid. Denne parameter er som standard deaktiveret, da det kræver konstant forespørgsel af den aktuelle tid fra operativsystemet, hvilket kan sænke ydeevnen betydeligt på nogle platforme. For at vurdere omkostningerne ved tidsmåling på din platform kan du bruge værktøjet pg_test_timing. Statistik over I/O kan findes gennem visningen pg_stat_database, i outputtet fra EXPLAIN (når parameteren BUFFERS anvendes) og gennem visningen pg_stat_statements.
Denne parameter kan også aktiveres i en lokal session:
SET track_io_timing = TRUE;Og nu til det mest interessante — vi har lært at forstå og vise disse data med alle transformationer af udførelsestræet in mente:
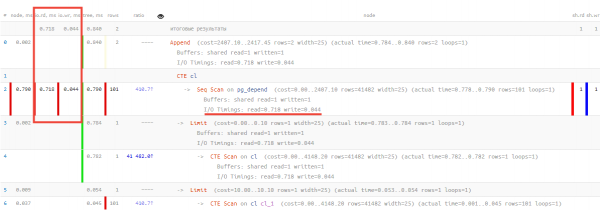
Her kan man se, at ud af 0.790ms blev 0.718ms brugt på læsning af én datakilde, 0.044ms — til at skrive den samme, mens der kun blev brugt 0.028ms på al anden nyttig aktivitet!
Fremtiden med PostgreSQL 13
Du kan læse den fulde oversigt over de nye funktioner , og vi fokuserer specifikt på ændringerne i planerne.
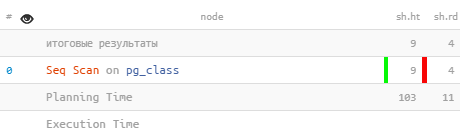
Planlægningsbuffere
Håndteringen af de ressourcer, der er afsat til planlæggeren, er også blevet reflekteret i en anden patch, der ikke er relateret til pg_stat_statements. EXPLAIN med BUFFERS-optionen vil rapportere antallet af buffere, der er blevet brugt i planlægningsfasen:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
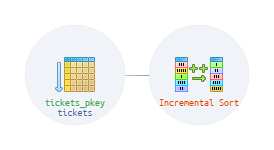
Inkrementel sortering
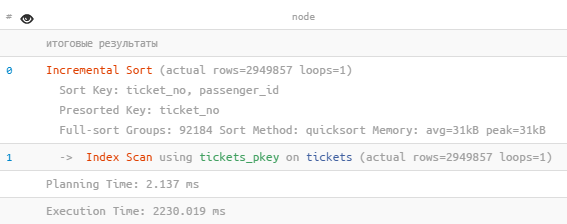
I tilfælde, hvor sortering efter mange nøgler (k1, k2, k3…) er nødvendig, kan planlæggeren nu drage fordel af, at dataene allerede er sorteret efter flere af de første nøgler (f.eks. k1 og k2). I dette tilfælde kan man undgå at sortere alle dataene forfra og i stedet opdele dem i sekventielle grupper med de samme værdier k1 og k2 og "delsortere" efter k3.
Således opdeles hele sorteringen i flere sekventielle sorteringer af mindre størrelse. Dette reducerer det nødvendige hukommelsesforbrug, og det giver også mulighed for at returnere de første data tidligere, end når hele sorteringen er udført.
 Incremental Sort (actual rows=2949857 loops=1)
   Sort Key: ticket_no, passenger_id
   Presorted Key: ticket_no
   Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
   ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
Forbedringer af UI/UX
Skærmbilleder, de er overalt!
Nu er der mulighed for hurtigt at tage et screenshot af fanen til udklipsholderen i fuld bredde og dybde af fanen — «sigtekornet» øverst til højre:
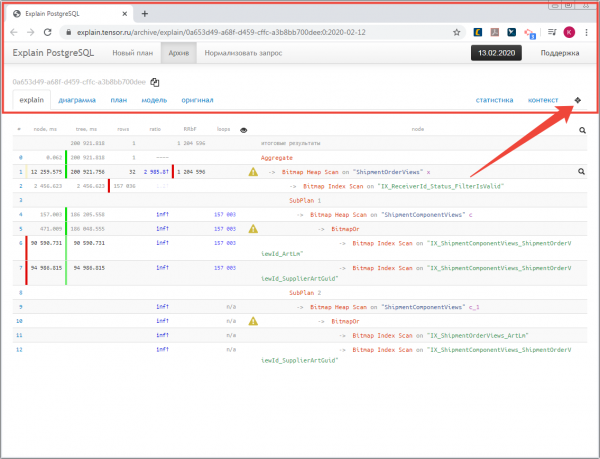
Faktisk er de fleste billeder til denne publikation blevet indhentet på netop denne måde.
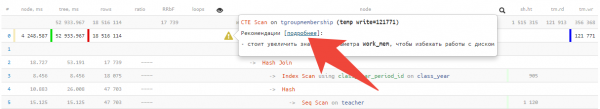
Anbefalinger på noder
Der er ikke kun blevet flere, men der kan også , ved at klikke på linket:
Sletning fra arkivet
Nogle har virkelig bedt om at få muligheden for at slette «helt» selv ikke-offentlige planer i arkivet — det er muligt, bare tryk på det relevante ikon:
Og glem ikke, at vi har , hvor man kan skrive sine kommentarer og forslag.
Kilde: habr.com
