

I efteråret 2019 fandt der et længeventet event i iOS-teamet hos Mail.ru Cloud sted. Den primære database til vedholdende opbevaring af applikationens tilstand blev en ganske eksotisk løsning for mobilverdenen. (LMDB). Under artiklen præsenteres en grundig gennemgang i fire dele. Først vil vi diskutere årsagerne til et sådant ukonventionelt og vanskeligt valg. Derefter ser vi på de tre søjler i LMDB-arkitekturen: memory-mapped filer, B+-træ, copy-on-write-tilgangen til gennemførelse af transaktionalitet og multiversionering. Til slut — den praktiske del. Her vil vi se på, hvordan man designer og implementerer et dataskema med flere tabeller oven på den lavniveau key-value API.
Indhold
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivation for implementering
For omkring fem år siden begyndte vi at bekymre os om at måle, hvor ofte vores applikations grænseflade lagger. Vi gjorde dette ikke uden grund. Vi modtog flere klager over, at applikationen nogle gange stoppede med at reagere på brugerens handlinger: knapper kunne ikke trykkes, lister kunne ikke scrolle osv. Mht. målemetodikken hos AvitoTech, så her begrænser jeg mig til blot at give en idé om størrelsesordenen.
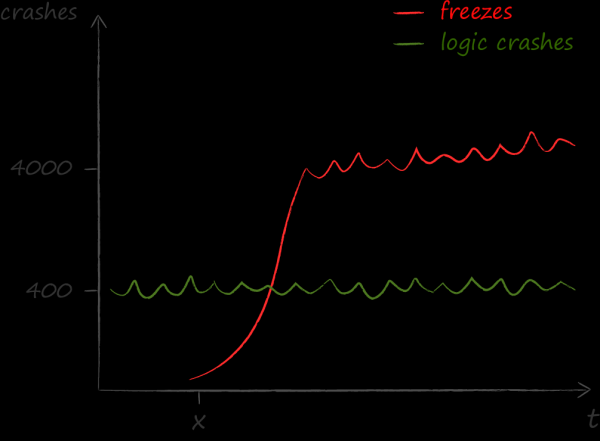
Resultaterne af målingerne var som et koldt brusebad for os. Det viste sig, at der var mange flere problemer forårsaget af fryseproblemer end nogen andre. Før vi blev opmærksomme på dette faktum var den vigtigste tekniske kvalitetsindikator crash free, men efterfølgende skiftede fokus Ved at bygge
et dashboard med fryseproblemer en kvantitativ og to threads en artikel på Habré I dette nuværende narrativ vil jeg fremhæve de aspekter ved løsningen, der påvirkede valget af database.
Aktormodellen for at organisere systemet antager, at multitrådning bliver dens anden natur. Objekterne i modellen elsker at krydse grænserne mellem trådene. Det gør de ikke sjældent og forskellige steder, men praktisk talt konstant og overalt.
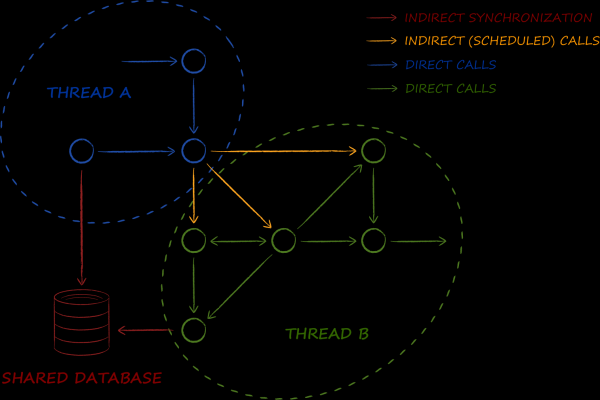
Databasen er en af de hjørnesten, der er præsenteret i skemaet. Dens hovedopgave er at implementere makropatternet . I en enterprise-verden bruges den til at organisere synkronisering af data mellem tjenester, mens den i en aktorarkitektur synkroniserer data mellem tråde. Dermed har vi brug for en database, der fungerer problemfrit i et multitrådsmiljø. Dette betyder, at de objekter, der genereres fra den, mindst skal være trådsikre og ideelt set helt immutable. Det er velkendt, at de sidstnævnte kan bruges samtidig fra flere tråde uden at kræve nogen som helst låsninger, hvilket gavnligt påvirker ydeevnen.
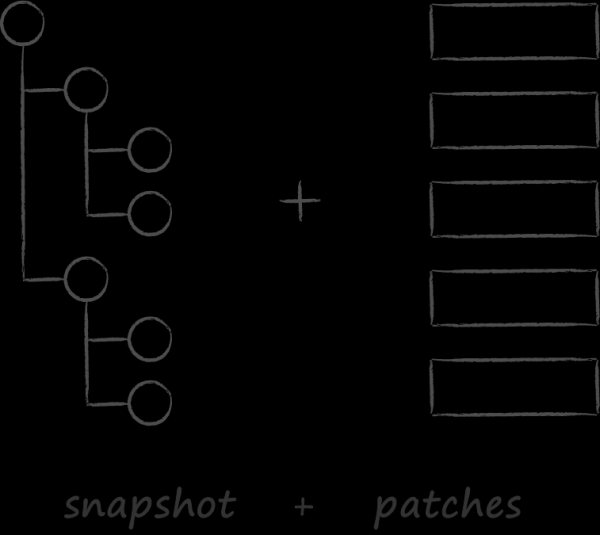 En anden væsentlig faktor, der påvirkede valget af database, er vores cloud API. Det blev inspireret af synkroniseringsmetoden, der anvendes i git. Som det, sigtede vi mod , som ser mere end passende ud for cloud-kunder. Det var meningen, at de kun skulle hente den fulde tilstand af skyen én gang, og derefter skulle synkroniseringen i langt de fleste tilfælde ske gennem anvendelse af ændringer. Desværre er denne mulighed stadig kun i den teoretiske zone, og i praksis har kunderne ikke endnu lært at arbejde med patches. Der er en række objektive grunde til dette, som vi lader ligge af hensyn til ikke at forlænge introduktionen. I øjeblikket er der dog langt større interesse for de lærdomme, der kan drages fra, hvad der sker, når API'et sagde 'A', og dets forbruger ikke sagde 'B'.
Så hvis du forestiller dig git, der ved udførelse af kommandoen pull i stedet for at anvende patches på et lokalt snapshot sammenligner dets fulde tilstand med serverens fulde tilstand, så har du en ret præcis opfattelse af, hvordan synkronisering foregår i cloud-klienter. Det er ikke svært at gætte, at for at gøre dette kræves det at allokere to DOM-træer i hukommelsen med metadata om alle server- og lokale filer. Det viser sig, at hvis en bruger gemmer 500.000 filer i skyen, er det nødvendigt at genskabe og destruere to træer med 1 million noder for at synkronisere. Og hver node er en aggregat, der indeholder en graf af underobjekter. I dette lys viste resultaterne af profileringen sig at være forventede. Det blev opdaget, at selv uden at tage hensyn til algoritmen for sammensmeltning, koster selve proceduren for at skabe og derefter destruere et enormt antal små objekter allerede en del. Problemet forværres af, at grundlæggende synkroniseringsoperationer er inkluderet i mange bruger-scenarier. Som følge heraf bekræfter vi det andet vigtige kriterium i valget af databaser — muligheden for at implementere CRUD-operationer uden dynamisk objektallokering.
Andre krav er mere traditionelle, og deres samlede liste ser således ud.
- Trådsikkerhed.
- Multiprocessering. Det skyldes ønsket om at bruge den samme databaseinstans til at synkronisere tilstanden ikke kun mellem tråde, men også mellem hovedapplikationen og iOS-udvidelser.
- Mulighed for at repræsentere gemte enheder som immutabale objekter.
- Fravær af dynamiske allokeringer i forbindelse med CRUD-operationer.
- Understøttelse af transaktioners grundlæggende egenskaber : atomaritet, konsistens, isolering og pålidelighed.
- Hastighed i de mest populære tilfælde.
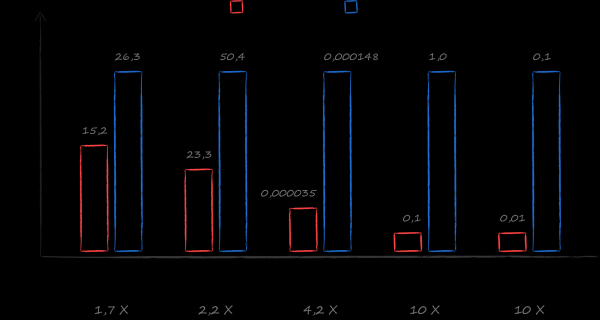
Et godt valg med så mange krav var og er stadig SQLite. Men i løbet af min undersøgelse af alternativer stødte jeg på en bog . Under her guidance, a benchmark was created comparing the performance with different databases in real cloud scenarios. The results exceeded all expectations. In the most popular cases — obtaining a cursor on a sorted list of all files and a sorted list of all files for a given directory — LMDB was ten times faster than SQLite. The choice became obvious.
2. Positioning of LMDB
LMDB is a very small library (only 10K lines) that implements the most fundamental database layer — a storage engine.
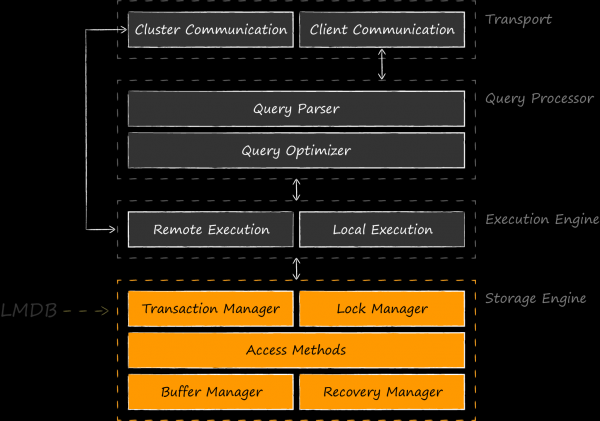
The diagram shows that comparing LMDB with SQLite, which also implements higher levels, is not entirely accurate, similar to comparing SQLite with Core Data. It would be fairer to mention similar storage engine competitors — BerkeleyDB, LevelDB, Sophia, RocksDB, and others. There are even developments where LMDB acts as a component storage engine for SQLite. The first such experiment took place in 2012. Howard Chu . LumoSQL The main application of LMDB is as an engine for application databases. The library owes its existence to the developers of OpenLDAP
, who were greatly dissatisfied with BerkeleyDB as the basis for their project. Starting from the humble library , Howard Chu was able to create one of the most popular alternatives today. He dedicated his very cool presentation . A good example of conquering storage was shared by Leonid Yuriev (aka ) from Positive Technologies in his presentation at Highload 2015 . In it, he discusses LMDB in the context of a similar implementation task for ReOpenLDAP, while LevelDB was subject to comparative criticism. As a result of the implementation, Positive Technologies even developed an actively evolving fork with very appealing features, optimizations, and LMDB is often used as a storage as is. For example, the Mozilla Firefox browser .
it for a number of needs, and starting from version 9, Xcode it over SQLite for storing indexes. den SQLite til opbevaring af indekser.
Motoren har gjort sit indtog i verden af mobiludvikling. Dets anvendelse kan ses i iOS-klienten til Telegram. LinkedIn gik endnu længere og valgte LMDB som standardlager til deres egenudviklede datacache-framework, som nævnt i sin artikel i 2016.
LMDB kæmper effektivt for sin plads i solen i et segment efterladt af BerkeleyDB efter overtagelsen af Oracle. Biblioteket værdsættes for sin hastighed og pålidelighed selv i forhold til lignende løsninger. Som bekendt findes der ikke gratis frokoster, og det er vigtigt at understrege den trade-off, man må stå overfor, når man vælger mellem LMDB og SQLite. Diagrammet ovenfor viser tydeligt, hvordan den øgede hastighed opnås. For det første betaler vi ikke for ekstra lag af abstraktion over diskopbevaringen. Det står klart, at man i en god arkitektur ikke kan undgå dem, men de vil være langt mere slanke. Der vil ikke være funktioner, der ikke er efterspurgt af den specifikke applikation, såsom understøttelse af SQL-forespørgsler. For det andet muliggør det optimal implementering af applikationsoperationer til forespørgsler om diskopbevaring. Hvis SQLite griber ud fra de gennemsnitlige behov for en gennemsnitlig applikation, så er du som applikationsudvikler godt klar over de vigtigste belastningsscenarier. Et mere effektivt valg vil medføre en højere pris både for udviklingen af den oprindelige løsning og for dens efterfølgende vedligeholdelse.
3. Tre søjler i LMDB
Når man ser på LMDB fra fugleperspektiv, er det tid til at dykke dybere. De følgende tre sektioner vil fokusere på de grundlæggende søjler, som arkitekturen af lageret hviler på:
- Memory-mapped filer som en mekanisme til at arbejde med disken og synkronisering af interne datastrukturer.
- B+-træet som en organisation af den lagrede datastruktur.
- Copy-on-write som en tilgang til at sikre ACID-egenskaberne ved transaktioner og multiversionering.
3.1. Søjle nr. 1. Memory-mapped filer
De viste filerne i hukommelsen er en så vigtig arkitektonisk komponent, at de endda er nævnt i navnet på lageret. Spørgsmål vedrørende caching og synkronisering af adgangen til de gemte oplysninger er helt og aldeles overladt til operativsystemet. LMDB indeholder ingen caches internt. Dette er en bevidst beslutning fra forfatterens side, da læsning af data direkte fra de viste filer gør det muligt at skære mange hjørner i implementeringen af motoren. Nedenfor præsenteres langt fra en fuldstændig liste over nogle af dem.
- Opretholdelsen af datakonsistens i lageret, når det bruges fra flere processer, bliver en opgave for operativsystemet. I det næste afsnit vil denne mekanisme blive beskrevet i detaljer og med billeder.
- Fraværet af caches fjerner helt LMDBs omkostninger forbundet med dynamiske tildelinger. Læsning af data repræsenterer i praksis blot en indstilling af en peger til den rigtige adresse i den virtuelle hukommelse, og ikke mere. Det lyder som fantasi, men i kildekoden til lageret er alle kald til salloc koncentreret i funktionen, der konfigurerer lageret.
- Fraværet af caches betyder også fravær af låsninger, der er forbundet med synkronisering af adgangen til dem. Læsere, som på samme tid kan eksistere i et vilkårligt antal, møder ikke et eneste mutex på deres vej til dataene. Dette giver en ideel lineær skalerbarhed i læsehastigheden i forhold til antallet af CPU'er. I LMDB er det kun modificerende operationer, der er underlagt synkronisering. Der kan kun være én skribent ad gangen.
- Minimum af caching- og synkroniseringslogik befrier koden fra ekstremt komplekse typer af fejl forbundet med drift i et multitrådet miljø. På Usenix OSDI 2014-konferencen præsenteredes der to interessante forskningsartikler om databaser: og . Herfra kan man hente oplysninger både om den uden fortilfælde pålidelighed af LMDB samt om den praktisk talt fejlfri implementering af ACID-egenskaber for transaktioner, som også overgår dem i SQLite.
- Den minimalistiske tilgang i LMDB muliggør, at maskinrepræsentationen af dens kode helt kan placeres i L1-cache i processoren og dermed giver de deraf følgende hastighedskarakteristika.
Desværre er situationen med filerne i hukommelsen på iOS ikke så uproblematisk, som man gerne ville. For mere bevidst at kunne diskutere de relaterede ulemper, er det nødvendigt at huske de generelle principper for implementering af denne mekanisme i operativsystemer.
Generel information om mapper i hukommelsen
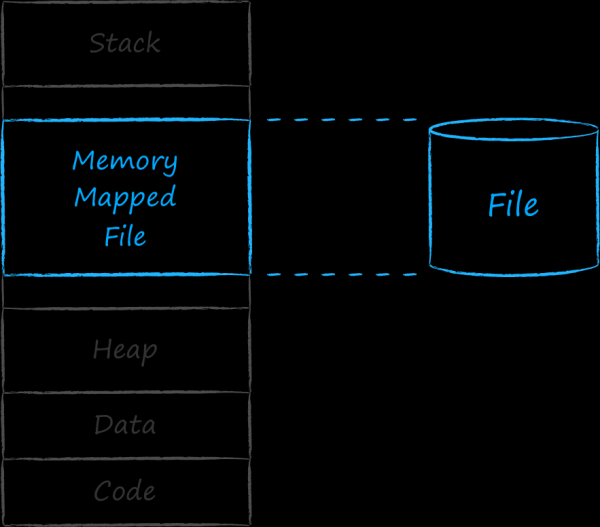 Operativsystemet associerer en entitet, kaldet en proces, med hver eksekverbar applikation. Hver proces tildeles et kontinuerligt interval af adresser, hvor den placerer alt, hvad den har brug for for at fungere. I de laveste adresser findes sektioner med kode og hardkodede data og ressourcer. Derefter er der et voksende blok af dynamisk adresseområde, som vi kender som heap. I denne hukommelse opbevares adresser til entiteter, der opstår i programmets kørsel. Øverst findes den hukommelse, der anvendes af applikationens stak. Den vokser og svinder, med andre ord har dens størrelse også en dynamisk natur. For at stakken og heap ikke skal kollidere og forstyrre hinanden, er de adskilt i forskellige ender af adresseområdet. Mellem de to dynamiske sektioner i toppen og bunden er der et hulrum. Adresserne i dette mellemområde bruger operativsystemet til at associere en række forskellige entiteter med processen. Især kan det knytte et kontinuerligt sæt adresser til en fil på disken. En sådan fil kaldes en mappe i hukommelsen.
Det adresseområde, der tildeles processen, er kæmpestort. Teoretisk set er antallet af adresser kun begrænset af størrelsen på en peger, der bestemmes af systemets bitdybde. Hvis den blev 1-til-1 matchet med den fysiske hukommelse, ville den første proces opsluge al RAM, og der kunne ikke være tale om multitasking.
Men fra erfaring ved vi, at moderne operativsystemer kan køre så mange processer samtidig, som man ønsker. Dette er muligt, fordi de kun på papiret tildeler processerne en masse hukommelse, mens de i virkeligheden kun indlæser den del af den fysiske hukommelse, der er efterspurgt her og nu. Derfor kaldes den hukommelse, der er associeret med processen, virtuel.
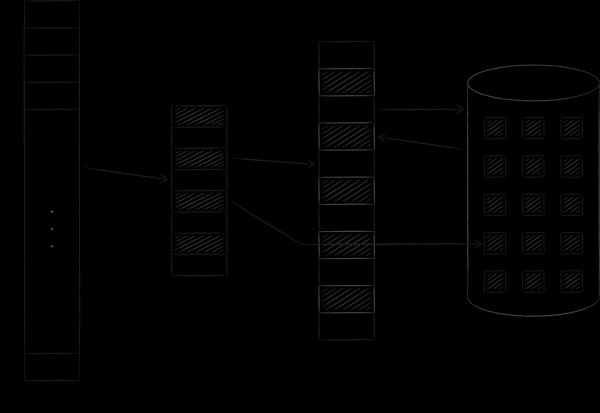
Operativsystemet organiserer virtuel og fysisk hukommelse som sider af en bestemt størrelse. Så snart en side i den virtuelle hukommelse bliver efterspurgt, indlæser operativsystemet den i den fysiske hukommelse og tilknytter dem i en speciel tabel. Hvis der ikke er nogen ledige pladser, kopieres en tidligere indlæst side til disken, og den efterspurgte tager dens plads. Denne procedure, som vi snart vil vende tilbage til, kaldes swapping. Billedet nedenfor illustrerer den beskrevne proces. Her blev side A med adressen 0 indlæst og placeret på siden i den primære hukommelse med adressen 4. Dette faktum er reflekteret i tilsvarende tabel i celle nummer 0.
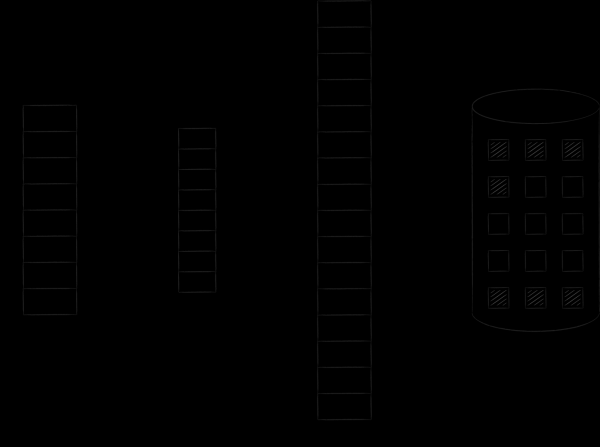
Med de indlæste filer i hukommelsen er historien den samme. Logisk set er de angiveligt kontinuerligt og fuldstændigt placeret i det virtuelle adresseområde. Men i den fysiske hukommelse tilgår de side for side og kun efter behov. Modifikation af sådanne sider synkroniseres med filen på disken. På den måde kan man udføre filind / ud, simpelthen ved at arbejde med bytes i hukommelsen — alle ændringer vil automatisk blive overført af operativsystemets kerne til den oprindelige fil.
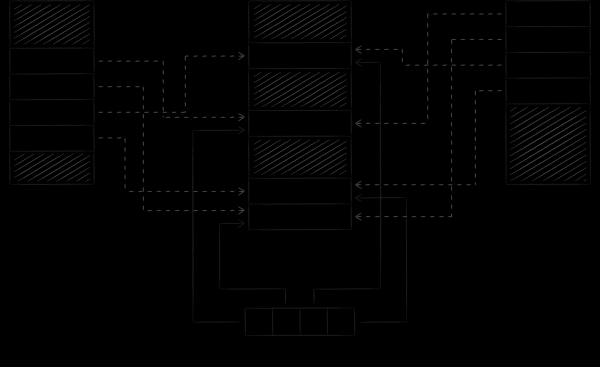
Billedet nedenfor viser, hvordan LMDB synkroniserer sin tilstand, når den arbejder med en database fra forskellige processer. Ved at mappe den virtuelle hukommelse af forskellige processer til den samme fil forpligter vi de facto operativsystemet til transitivt at synkronisere bestemte blokke af deres adresseområder, som LMDB ser på.
Et vigtigt aspekt er, at LMDB som standard ændrer datafilen gennem systemopkaldsmekanisme write, mens selve filen vises i read-only tilstand. Denne tilgang har to vigtige konsekvenser.
Den første konsekvens er generel for alle operativsystemer. Dens essens er at tilføje beskyttelse mod utilsigtet beskadigelse af databasen af ukorrekt kode. Som bekendt har de udførende instruktioner i processen frihed til at få adgang til data fra ethvert sted i dens adresseområde. På samme tid, som vi lige har nævnt, betyder visning af filen i read-write tilstand, at enhver instruktion også kan ændre den. Hvis den gør det ved en fejltagelse, f.eks. ved at forsøge at overskrive et array-element ved et ikke-eksisterende indeks, kan den ved en fejl ændre den fil, der er mappet til denne adresse, hvilket vil føre til beskadigelse af databasen. Hvis filen derimod er vist i read-only tilstand, vil et forsøg på at ændre det tilsvarende adresseområde føre til, at programmet afsluttes med et signal SIGSEGV, og filen forbliver intakt.
Den anden konsekvens er allerede specifik for iOS. H verken forfatteren eller nogen andre kilder nævner det eksplicit, men uden det ville LMDB ikke være anvendelig på dette mobile operativsystem. Næste afsnit er dedikeret til dette emne.
Specificiteten af memory-mapped filer i iOS
I 2018 var der et vidunderligt oplæg ved WWDC . Det beskriver, at alle sider, der findes i fysisk hukommelse i iOS, hører til en af 3 typer: dirty, compressed og clean.
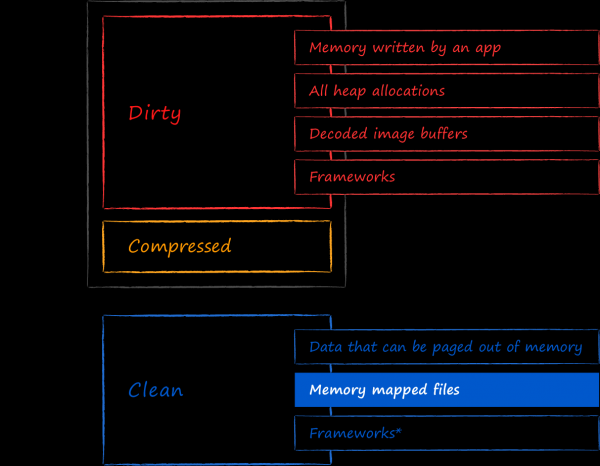
Clean memory er summen af sider, som uden problemer kan fjernes fra den fysiske hukommelse. De data, der findes i dem, kan genindlæses fra deres oprindelige kilder efter behov. Read-only memory-mapped filer falder netop ind under denne kategori. iOS er ikke bange for at fjerne de mappede sidefiler fra hukommelsen på ethvert tidspunkt, da de garanteret er synkroniserede med filen på disken.
I dirty memory findes alle ændrede sider, uanset hvor de oprindeligt lå. Især vil memory-mapped filer, der er ændret via skrivning til den tilknyttede virtuelle hukommelse, også blive klassificeret som sådanne. Ved at åbne LMDB med flaget MDB_WRITEMAP, kan du personligt bekræfte dette efter at have foretaget ændringer.
Når en app begynder at bruge for meget fysisk hukommelse, komprimerer iOS dens beskidte sider. Den samlede hukommelse, som de beskidte og komprimerede sider optager, kaldes appens hukommelsesfodaftryk. Når dette når et bestemt tærskelværdi, træder systemdæmonen OOM killer ind og afslutter processen tvangsmæssigt. Dette er en særlig egenskab ved iOS sammenlignet med desktop-operativsystemer. I modsætning til dem tillader iOS ikke reduktion af hukommelsesfodaftrykket via swapping af sider fra fysisk hukommelse til disk. Årsagerne til dette kan kun gættes. Måske er proceduren for intensiv flytning af sider til disk og tilbage for energikrævende for mobile enheder, eller også sparer iOS ressourcer til skrivning af celler på SSD-diskene, eller måske var designerne ikke tilfredse med det samlede systemperformance, hvor alt konstant swappes. Uanset hvad det er, forbliver fakta fakta.
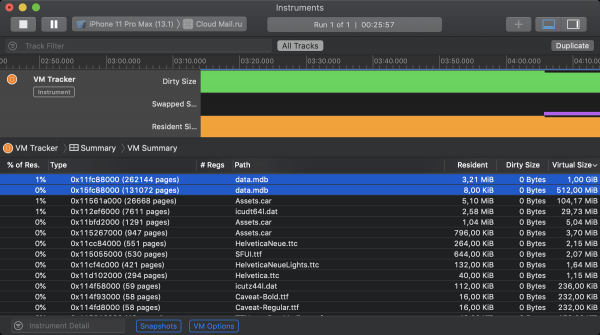
Den gode nyhed, som tidligere nævnt, er, at LMDB som standard ikke bruger mmap-mekanismen til at opdatere filer. Dette betyder, at de viste data klassificeres som ren hukommelse af iOS og ikke bidrager til hukommelsesfodaftrykket. Dette kan verificeres med Xcode-værktøjet kaldet VM Tracker. På skærmbilledet nedenfor vises den virtuelle hukommelsestilstand af iOS-appen Cloud under drift. Ved opstart blev der initialiseret 2 instanser af LMDB. Den første fik lov til at mappe sin fil til 1GiB virtuel hukommelse, den anden til 512MiB. Selvom begge lagre optager et bestemt volumen af resident hukommelse, bidrager ingen af dem til den beskidte størrelse.
Og nu er det tid til dårlige nyheder. Takket være swapping-mekanismen i 64-bit desktop-operativsystemer kan hver proces optage så meget virtuelt adresseområde, som det frie plads på harddisken tillader til dets potentielle swap. Udskiftningen af swapping med kompression i iOS reducerer dramatisk det teoretiske maksimum. Nu skal alle aktive processer passe ind i hovedhukommelsen (læse: den operationelle hukommelse), og alle der ikke kan komme ind, er underlagt tvangsafslutning. Dette er nævnt i den ovenfor omtalte . Vi kan gøre dette, da vi har ledige porte (eller vi frigør dem på forhånd) i switchene . Som et resultat begrænser iOS strengt størrelsen af hukommelsen, der er tilgængelig til tildeling via mmap. Her er Du kan se på de empiriske grænser for mængden af hukommelse, der kunne allokeres på forskellige enheder ved hjælp af dette systemopkald. På de nyeste iOS-smartphones er der givet 2 gigabyte, mens de topmoderne iPads har fået 4. I praksis må man dog finde sig i de mindst understøttede enheder, hvor situationen er meget trist. Værre er det, at man i VM Tracker kan opdage, at LMDB langt fra er den eneste, der kræver memory-mapped hukommelse. Større dele bliver taget af systemallokeringsmetoder, ressourcefiler, billedhåndteringsrammer og andre mindre sultne enheder.
Efter eksperimenterne i Cloud er vi nået frem til følgende kompromisværdier for den tildelte LMDB-hukommelse: 384 megabyte for 32-bit enheder og 768 for 64-bit. Efter forbrug af dette volumen begynder alle ændrende operationer at afsluttes med koden MDB_MAP_FULL. Vi observerer sådanne fejl i vores overvågning, men de er så få, at de på nuværende tidspunkt kan ignoreres.
En ikke åbenlys årsag til det overdrevne hukommelsesforbrug fra lageret kan være langtidsholdbare transaktioner. For at forstå, hvordan disse to fænomener hænger sammen, vil vi se på de to resterende søjler i LMDB.
3.2. Søjle nr. 2. B+-træ
For at emulere tabeller over et key-value lager er det nødvendigt, at følgende operationer er tilgængelige i dets API:
- Indsættelse af et nyt element.
- Søgning efter et element med en given nøgle.
- Sletning af et element.
- Iterering over intervaller af nøgler i rækkefølge af deres sortering.
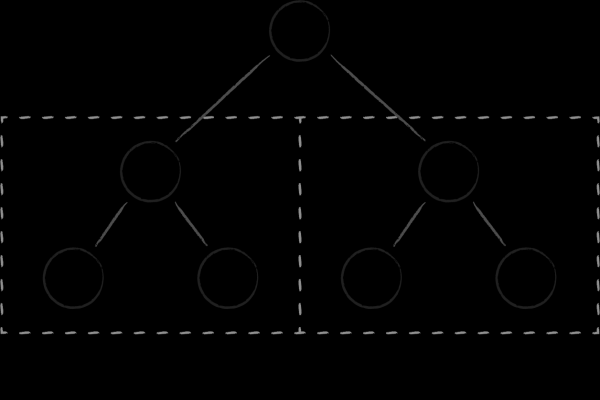 Den enkleste datastruktur, der nemt kan implementere alle fire operationer, er et binært søgetræ. Hver node repræsenterer en nøgle, der deler hele delmængden af underliggende nøgler i to undertræer. I venstre undertræ er dem, der er mindre end forælderen, og i højre undertræ dem, der er større. At opnå et sorteret sæt af nøgler opnås gennem en af de klassiske trægennemgange.
Binariske træer har to fundamentale ulemper, som forhindrer dem i at være effektive som diskbaserede datastrukturer. For det første er graden af deres balance uforudsigelig. Der er en betydelig risiko for at få træer, hvor højden af de forskellige grene kan variere meget, hvilket i høj grad forværrer den algoritmiske kompleksitet ved søgning sammenlignet med det forventede. For det andet fratar et væld af krydsreferencer mellem noder binariske træer lokalitet i hukommelsen. Nabo-noder (set i forhold til forbindelserne mellem dem) kan være på helt forskellige sider i den virtuelle hukommelse. Som følge heraf kan det selv for en simpel gennemgang af flere nærliggende noder i træet kræve at besøge et sammenligneligt antal sider. Dette er et problem, selv når vi overvejer effektiviteten af binariske træer som in-memory datastruktur, da konstant rotation af sider i CPU-cache er en kostbar affære. Når det så kommer til ofte at indlæse de relaterede sider fra disk, bliver situationen helt uholdbar. .
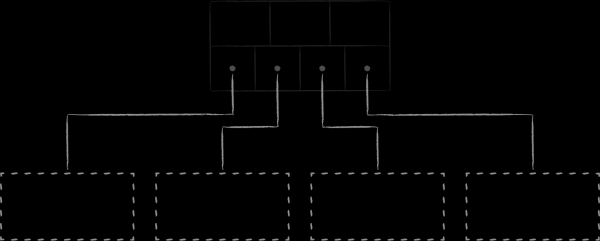 B-træer, som er en evolution af binariske træer, løser de problemer, der er nævnt i det forrige afsnit. For det første er de selvbalancerende. For det andet opdeler hver af deres noder mængden af børn nøgle i stedet for to, på M ordnede undergrupper, hvor M kan være ret stort, i størrelsesordenen flere hundrede eller endda tusinde.
Som følge heraf:
- Hver node indeholder et stort antal allerede sorterede nøgler, og træerne får en meget lav højde.
- Træet opnår egenskaben ved lokalitet i hukommelsen, da nøgler, der ligger tæt på hinanden, naturligt ligger nært hinanden på den samme eller nabo noder.
- Antallet af transitnoder reduceres, når man navigerer ned gennem træet under søgeoperationen.
- Antallet af læste mål-noder ved range-forespørgsler reduceres, da hver af dem allerede indeholder et stort antal sorterede nøgler.
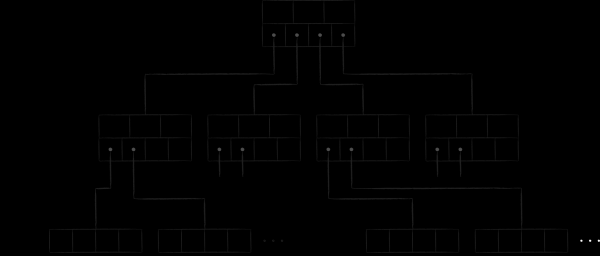
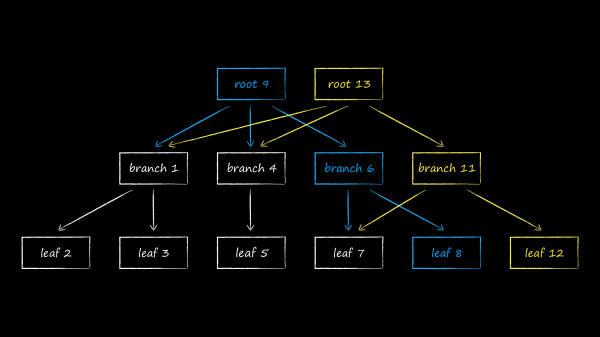
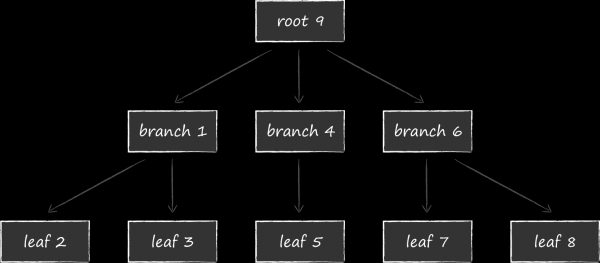
I LMDB bruges en variant af B-træet kaldet B+-træet til datalagring. Diagrammet ovenfor viser tre typer noder, som findes i det:
- I toppen findes roden (root). Den materialiserer intet andet end konceptet af en database inde i lageret. Inden for en enkelt instans af LMDB kan der oprettes flere databaser, som deler et mapperet virtuelt adresseområde. Hver af dem begynder med sin egen rod.
- I bunden findes bladene (leaf). Det er dem, og kun dem, der indeholder de nøgleværdi-par, der gemmes i databasen. Dette er faktisk essensen af B+-træer. Mens et almindeligt B-træ gemmer value-dele i noderne på alle niveauer, gør B+-variationen det kun i bunden. For at fastslå dette faktum vil vi herefter kalde den underart af træet, der benyttes i LMDB, blot B-træ.
- Mellem roden og bladene er der 0 eller flere tekniske niveauer med navigationsnoder (branch). Deres opgave er at opdele det sorterede sæt af nøgler mellem bladene.
Fysisk set er noderne blokke af hukommelse med forudbestemt længde. Deres størrelse er et multiplum af størrelsen på hukommelsessiderne i operativsystemet, som vi nævnte tidligere. Nedenfor vises strukturen af en node. I headeren findes metadata, den mest åbenlyse af dem for eksempel er kontrolsummen. Herefter kommer information om offsetter, der angiver positionen af datacellerne. Dataene kan være nøgler, hvis vi taler om navigationsnoder, eller hele nøgleværdi-par i tilfældet med bladene. Yderligere information om sidenes struktur kan findes i arbejdet .
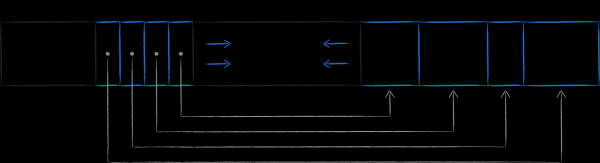
Når vi har forstået den interne opbygning af nodesiderne, vil vi herefter forsimple B-træet i LMDB i følgende form.
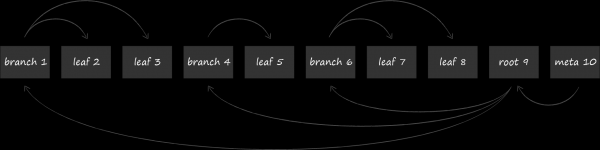
Sider med noder er placeret sekventielt på disken. Sider med højere numre er placeret tættere på slutningen af filen. Den såkaldte meta-side (meta page) indeholder oplysninger om offsetter, der hjælper med at finde rødderne af alle træerne. Ved åbning af LMDB-filen scanner den sidemæssigt filen fra slutningen mod starten for at finde en gyldig meta-side og finder via den eksisterende databaser.
Nu, når man har en forståelse af den logiske og fysiske struktur af datalagring, kan man gå videre til at overveje den tredje søjle i LMDB. Det er ved hjælp af denne, at alle ændringer i lagret sker transaktionelt og isoleret fra hinanden, hvilket også giver databasen egenskaben af multiversionering.
3.3. Søjle nr. 3. Copy-on-write
Nogle operationer med B-træet indebærer en række ændringer i dets noder. Et eksempel på dette er tilføjelsen af en ny nøgle til en node, der allerede har nået sin maksimale kapacitet. I så fald er det nødvendigt, for det første at opdele noden i to, og for det andet at tilføje en henvisning til den nye, afspaltede undernode i dens forælder. Denne procedure er potentielt meget farlig. Hvis en del af ændringerne i rækken (f.eks. nedbrud, strømafbrydelse osv.) skulle ske, vil træet forblive i en inkonsekvent tilstand.
En af de traditionelle løsninger for at sikre databasen mod fejl er at tilføje en ekstra diskdata struktur ved siden af B-træet – en transaktionslog, der også er kendt som write-ahead log (WAL). Dette er en fil, hvor den foreslåede operation skrives til slutningen, før selve B-træet ændres. Dermed, hvis der opdages datakorruption under selvdiagnose, konsulterer databasen loggen for at genskabe sig selv.
LMDB har valgt en anden metode til at sikre mod fejl, kaldet copy-on-write. Dets essens er, at i stedet for at opdatere data på den eksisterende side, kopieres den først helt, og alle ændringer foretages derefter i kopien.
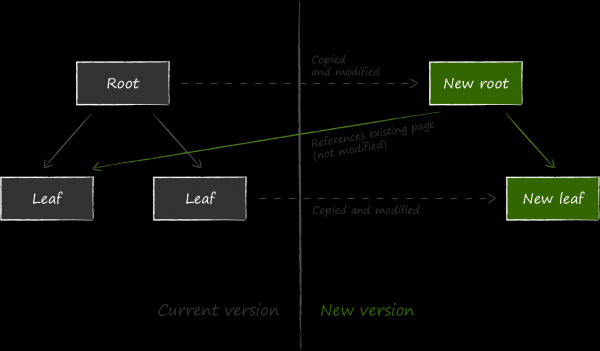
For at de opdaterede data skal være tilgængelige, er det nødvendigt at ændre henvisningen til den aktuelle node i dens overordnede node. Da det også skal ændres, kopieres det også forhåndsvis. Processen fortsætter rekursivt op til roden. De sidste data, der ændres, er på metasiden.
Hvis der under opdateringsproceduren opstår en uventet afslutning af processen, vil enten den nye meta-side ikke blive oprettet, eller den vil ikke blive gemt på disken, og dens kontrolsum vil være forkert. I begge tilfælde vil de nye sider være utilgængelige, mens de gamle ikke vil blive berørt. Dette fritager LMDB for behovet for at føre en write ahead log for at opretholde datakonsistens. De facto strukturen til datalagring på disken, der er beskrevet ovenfor, påtager sig samtidig denne funktion. Manglen på en eksplicit transaktionslog er et af kendetegnene ved LMDB, der sikrer høje læsehastigheder.
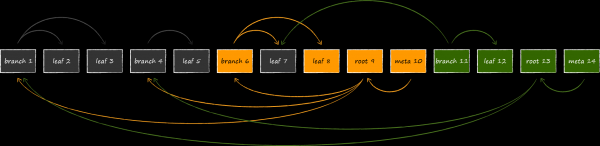
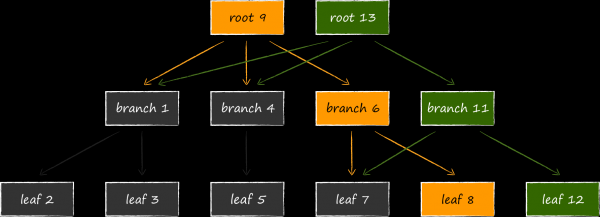
Den resulterende struktur kaldet append-only B-tree sikrer naturligt isolering af transaktioner og multiversionering. I LMDB er hver åben transaktion forbundet med det aktuelle rod af træet. Så længe transaktionen ikke er afsluttet, vil siderne i det tilknyttede træ aldrig blive ændret eller genbrugt til nye versioner af data. Således kan man arbejde med præcis det datasæt, der var aktuelt på tidspunktet for åbningen af transaktionen, selvom lagringen fortsætter med aktivt at blive opdateret. Dette er essensen af multiversionering, som gør LMDB til den ideelle datakilde for alle os, der elsker UICollectionView. Når man åbner en transaktion, er der ikke behov for at øge applikationens hukommelsesforbrug ved hastigt at hente de aktuelle data ind i en in-memory struktur, af frygt for at stå tilbage med tomme hænder. Denne egenskab adskiller LMDB fordelagtigt fra SQLite, som ikke kan prale af en sådan total isolering. Åbner man i sidstnævnte to transaktioner og sletter en bestemt post inden for en af dem, vil denne post ikke kunne findes i den anden tilbageværende.
Den bagsiden af medaljen er den potentielt meget større forbrug af virtuel hukommelse. På diaset vises, hvordan databasens struktur vil se ud, hvis den ændres samtidig med 3 åbne læsetransaktioner, der ser på forskellige versioner af databasen. Da LMDB ikke kan genbruge noder, der kan nås fra rødderne, der er knyttet til de aktuelle transaktioner, har lageret ikke andet valg end at placere en fjerde rod i hukommelsen og at duplikere de ændrede sider igen.
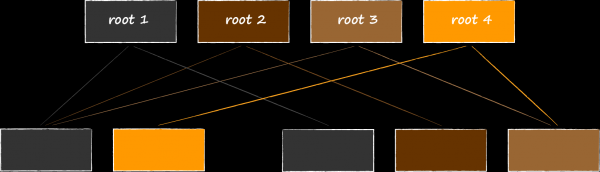
Her vil det ikke være overflødigt at minde om afsnittet om memory-mapped filer. Det virker som om, den ekstra brug af virtuel hukommelse ikke burde bekymre os for meget, da det ikke bidrager til applikationens memory footprint. Men samtidig er det bemærket, at iOS er meget sparsom med sin tildeling, og vi kan ikke, som på servere eller desktops, uden videre tildele LMDB et område på 1 terabyte og slet ikke tænke over denne egenskab. Vi bør, hvis muligt, forsøge at gøre transaktioners levetid så kort som muligt.
4. Design af dataskemaer over key-value API
Analysen af API'en starter med en gennemgang af de grundlæggende abstraktioner, der tilbydes af LMDB: miljøet og databaserne, nøgler og værdier, transaktioner og cursorer.
Bemærkning om kodeoptegnelser
Alle funktioner i den offentlige LMDB API returnerer resultatet af deres operationer som en fejlkode, men i alle efterfølgende listings er kontrol af denne udeladt for at være mere kortfattet. I praksis brugte vi faktisk vores C++ wrapper , hvor fejl materialiseres som C++ undtagelser.
Som den hurtigste måde at tilslutte LMDB til et projekt for iOS eller macOS foreslår jeg mit CocoaPod .
4.1. Grundlæggende abstraktioner
Miljø (environment)
Struktur MDB_env er opbevaringen af LMDB's interne tilstand. En serie af funktioner med præfikset mdb_env giver mulighed for at konfigurere nogle af dens egenskaber. I den enkleste tilfælde ser initialisering af motoren således ud.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);I Mail.ru Cloud-applikationen ændrede vi som standard kun på to parametre.
Den første er størrelsen på det virtuelle adresserum, som filsystemet kortlægges til. Desværre kan den specifikke værdi variere betydeligt fra kørsel til kørsel, selv på samme enhed. For at tage højde for denne egenskab iOS, tilpasser vi den maksimale lagringskapacitet dynamisk. Startende med en vis værdi halveres den successivt, indtil funktionen mdb_env_open returnerer et resultat, der er forskelligt fra ENOMEM. Teoretisk set er der også den modsatte tilgang — først at allokere minimal hukommelse til motoren og så, ved fejlhåndtering, øge den. Dog er denne metode langt mere besværlig. Årsagen er, at procedure til genallokering af hukommelse (remap) ved hjælp af funktionen MDB_MAP_FULLmdb_env_set_map_size invalidere alle entiteter (kursører, transaktioner, nøgler og værdier), der blev skabt tidligere af motoren. At tage højde for sådan en udvikling i koden vil medføre betydelig kompleksitet. Hvis du dog er meget afhængig af virtuel hukommelse, kan det være en god idé at overveje en forgrening, der er kommet langt frem og tilbyder "automatisk justering af databases størrelse under kørsel". Den anden parameter, hvis standardværdi ikke fungerer for os, regulerer mekanikken for at sikre tråd-sikkerhed. Desværre, i det mindste i iOS 10, er der problemer med understøttelsen af lokal trådopbevaring. Af denne grund åbnes lageret i eksemplet ovenfor med flaget MDB_NOTLS
. Derudover var det nødvendigt også at forkeC++ wrapperen Databasen repræsenterer en separat instans af et B-træ, som vi diskuterede tidligere. Dens åbning sker inden for en transaktion, hvilket i starten kan virke lidt underligt. MDB_txn *txn; MDB_dbi dbi; mdb_txn_begin(env, NULL, MDB_RDONLY, &txn); mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi); mdb_txn_abort(txn);
Databaser
Faktisk er en transaktion i LMDB en del af lageret, ikke en specifik database. Dette koncept muliggør atomiske operationer over entiteter, der findes i forskellige databaser. Teoretisk åbner dette for muligheden for at modellere tabeller som forskellige databaser, men jeg tog dengang en anden vej, som er beskrevet i detaljer nedenfor.
Nøgler og værdierMDB_val
Nøgler og værdier
Struktur MDB_val modellerer konceptet som både nøgle og værdi. Lagringen har ingen opfattelse af deres semantik. For den er hvad som helst blot et array af bytes i en given størrelse. Den maksimale størrelse for en nøgle er 512 bytes.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Ved hjælp af en sammenligner sorterer lagringen nøglerne i stigende rækkefølge. Hvis den ikke erstattes med sin egen, bruges den standard, som sorterer dem byte-for-byte i leksikografisk række.
Transaktioner
Transaktionssystemet er beskrevet i detaljer i , derfor vil jeg her kort gentage deres vigtigste egenskaber:
- Understøttelse af alle grundlæggende egenskaber : atomaritet, konsistens, isolation og pålidelighed. Jeg kan ikke undlade at nævne, at der på macOS og iOS er en fejl angående holdbarhed, der er rettet i MDBX. Du kan læse mere om det i deres .
- Tilgangen til multitrådning beskrives med diagrammet "single writer / multiple readers". Forfatterne blokerer hinanden, men blokerer ikke læsere. Læsere blokerer hverken forfattere eller hinanden.
- Understøttelse af indlejrede transaktioner.
- Understøttelse af multiversionering.
Multiversioneringen i LMDB er så god, at jeg gerne vil demonstrere den i aktion. Koden nedenfor viser, at hver transaktion arbejder med den nøjagtige version af databasen, der var gældende på tidspunktet for dens åbning, og er helt isoleret fra alle efterfølgende ændringer. Initialisering af lageret og tilføjelse af testposten indebærer ikke noget interessant, så disse ritualer er efterladt under spoiler.
Tilføjelse af testpost
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Åbner 2 transaktioner, hvor hver ser på databasen med en post.
mdb_txn_begin(env, NULL, 0, &txn1); // read-write
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // read-only
// I den første transaktion sletter vi den eksisterende post fra databasen.
mdb_del(txn1, dbi, &key, NULL);
// Bekræfter sletningen.
mdb_txn_commit(txn1);
// Åbner den tredje transaktion, som ser på
// den aktuelle version af databasen, hvor posten allerede er væk.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Sikrer os, at posten for den ønskede nøgle ikke længere eksisterer.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Afslutter transaktionen.
mdb_txn_abort(txn3);
// Sikrer os, at posten stadig kan findes med nøglen i den anden transaktion,
// som var åbnet på tidspunktet for eksisterendelsen af posten i databasen.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Tjekker, at den modtagne værdi ikke er affald, men gyldige data.
assert(*(int *)val.mv_data == 997);
// Afslutter transaktionen, der arbejder med en forældet, men konsistent database.
mdb_txn_abort(txn2);Jeg anbefaler at prøve det samme trick med SQLite og se, hvad der sker.
Multi-versioning bringer nogle rigtig praktiske fordele til livet for iOS-udviklere. Med denne funktion kan man nemt og ubesværet justere hastigheden på opdateringen af datakilden til skærmformularer, baseret på brugeroplevelsen. For eksempel kan vi tage funktionen i Mail.ru Cloud, der automatisk indlæser indhold fra systemets mediegalleri. Ved en god forbindelse kan klienten tilføje flere fotos til serveren pr. sekund. Hvis man efter hver upload opdaterer UICollectionView med medieindholdet i brugerens cloud, kan man glemme alt om 60 fps og glidende scrolling under denne proces. For at forhindre hyppige opdateringer af skærmen er det nødvendigt at begrænse hastigheden for ændringer i dataene i bunden. UICollectionViewDataSource.
Hvis databasen ikke understøtter multiversionering og kun tillader arbejde med den aktuelle tilstand, så for at skabe et stabilt snapshot af dataene, er det nødvendigt at lave en kopi enten i en in-memory datastruktur eller i en midlertidig tabel. Begge tilgange er meget omkostningstunge. I tilfælde af in-memory lagring får vi omkostninger både i form af hukommelse, som skyldes opbevaring af de konstruerede objekter, samt i tid, der er forbundet med overflødige ORM-omdannelser. Hvad angår den midlertidige tabel, så er det en endnu dyrere løsning, som kun giver mening i ikke-trivielle tilfælde.
Multiversionering i LMDB løser opgaven med at opretholde en stabil datakilde meget elegant. Man skal bare åbne en transaktion, og voilà — så længe vi ikke afslutter den, er datasættet garanteret fastlåst. Logikken for hastigheden af opdateringen ligger nu helt og holdent i hænderne på præsentationslaget uden væsentlige ressourceomkostninger.
Cursors
Cursors giver en mekanisme til ordnet iteration over nøgle-værdi par gennem traversal af et B-træ. Uden dem ville det være umuligt effektivt at modellere tabeller i databasen, som vi nu vil se nærmere på.
4.2. Tabelmodellering
Egenskaben ved ordnede nøgler gør det muligt at konstruere en højere abstraktion såsom en tabel oven på grundlæggende abstraktioner. Vi ser på denne proces gennem eksemplet på hovedtabellen for en cloud-kunde, hvor information om alle brugerens filer og mapper er cachelagret.
Tabelskema
Et af de hyppige scenarier, som tabelstrukturen med en mappe-træ skal være tilpasset til, er hentning af alle elementer, der findes i en angivet mappe. En god model for databasens organisation til effektive forespørgsler af denne art er . For at implementere dette oven på et key-value lager er det nødvendigt at sortere nøglerne for filer og mapper på en måde, så de grupperes efter tilhørsforhold til den overordnede mappe. Derudover, for at vise indholdet af mappen i den velkendte Windows-visning (først mapper, dernæst filer, og begge sorterede alfabetisk), er det nødvendigt at inkludere de relevante yderligere felter i nøglefeltet.
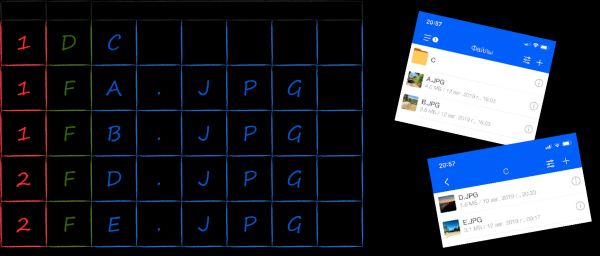
Billedet nedenfor viser, hvordan repræsentationen af nøgler som et byte-array kan se ud, baseret på den stillede opgave. Først placeres byte med identifikatoren for den overordnede mappe (røde), derefter typen (grønne), og til sidst navnet (blå). Når de er sorteret af LMDB's standardkomparator i leksikografisk rækkefølge, ordnes de som ønsket. En sekventiel gennemgang af nøglerne med det samme røde præfiks giver os de tilhørende værdier i den rækkefølge, som de skal vises i brugergrænsefladen (til højre), uden at der kræves yderligere postbehandling.
Serialisering af nøgler og værdier
Der findes mange metoder til serialisering af objekter i verden. Da vi ikke havde nogen andre krav end hastighed, valgte vi den hurtigste, som var mulig — en dump af oplagring, der anvendes af en instans af C-sprogstrukturen. På den måde kan nøglen til et mappen kan modelleres med følgende struktur NodeKey.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
For at gemme NodeKey i lageret skal pointeren på dataene positioneres til begyndelsen af strukturen, og deres størrelse beregnes med funktionen MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
I det første kapitel om kriterierne for valg af database nævnte jeg minimering af dynamiske allokeringer i forbindelse med CRUD-operationer som en vigtig faktor i valget. Koden til funktionenserialize viser, hvordan det i tilfælde af LMDB helt kan undgås ved indsættelse af nye poster i databasen. Det ankomne byte-array fra serveren transformeres først til stak-strukturer, og derefter dumpes de på en trivial måde i lageret. I betragtning af at der også ikke er dynamiske allokeringer i LMDB, kan man opnå en fantastisk situation målt på iOS — at arbejde med data gennem hele deres rejse fra netværket til disken kun med stak-hukommelse! Sortering af nøgler med en binær komparator
Sortering af nøgler med en binær sammenligner
Forholdet mellem nøglerne bestemmes af en speciel funktion kaldet en sammenligningsfunktion. Da motoren ikke ved noget om semantikken af de byte, den indeholder, har den standard sammenligningsfunktion ikke andet valg end at sortere nøgler i leksikografisk rækkefølge ved at sammenligne dem byte for byte. At bruge den til at sortere strukturer er som at barbere sig med et slagtekniv. Ikke desto mindre finder jeg denne metode acceptabel i enkle tilfælde. Alternativet beskrives lidt længere nede, men her vil jeg bemærke et par uhensigtsmæssigheder, der kan opstå på denne vej.
Det første, man skal huske på, er repræsentationen af primitive datatyper i hukommelsen. På alle Apple-enheder gemmes heltalsvariabler i formatet . Det betyder, at den mindst signifikante byte vil befinde sig til venstre, og man kan ikke sortere heltal ved hjælp af byte-sammenligning. For eksempel vil et forsøg på at gøre dette med et sæt tal fra 0 til 511 resultere i følgende.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
For at løse dette problem skal heltal gemmes i nøglen i et format, der er egnet til byte-sammenligningsfunktionen. Funktioner fra familien hton* vil hjælpe med denne nødvendige konvertering (specifikt htons til to-byte tal fra eksemplet).
Formatet for strengrepræsentation i programmering er som bekendt en hel . Hvis semantikken af strenge samt den kodning, der bruges til at repræsentere dem i hukommelsen, antyder, at der kan være mere end en byte pr. tegn, er det bedst straks at opgive ideen om at bruge den standard sammenligningsfunktion.
Det andet, man skal have in mente, er for felterne i strukturen defineret af kompilatoren. På grund af dem kan der dannes bytes med affaldsværdier i hukommelsen mellem felterne, hvilket naturligvis ødelægger byte-sorteringen. For at eliminere affald skal man enten erklære felterne i en strengt bestemt rækkefølge, mens man husker justeringsreglerne, eller bruge attributten packed.
Sortering af nøgler med en ekstern sammenligningsfunktion
Logikken bag sammenligning af nøgler kan vise sig at være for kompleks til en binær sammenligningsfunktion. En af de mange årsager er, at der er tekniske felter indeni strukturer. Jeg vil illustrere deres opståen med et eksempel fra den nøgle, vi allerede kender, til et element i en mappe.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
På trods af sin enkelhed bruger den i de fleste tilfælde alt for meget hukommelse. Bufferen til navnet optager 256 byte, selvom fil- og mappenavne sjældent overstiger 20-30 tegn.
En af de standardmetoder til at optimere størrelsen på en post er at "skære" den ned til den faktiske størrelse. Ideen er, at indholdet af alle variable længdefelter opbevares i bufferen i slutningen af strukturen, mens deres længder opbevares i separate variabler. Ifølge denne tilgang transformeres nøglen NodeKey således.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Ved serialisering angives størrelsen af data ikke MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } for hele strukturen, men størrelsen af alle felter med fast længde plus størrelsen af den faktisk brugte del af bufferen.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Som følge af den udførte refactoring har vi opnået en betydelig besparelse i pladskravene for nøglerne. Men på grund af det tekniske felt nameLength, er den standard binære sammenligner ikke længere egnet til at sammenligne nøgler. Hvis vi ikke skifter den ud med vores, vil længden af navnet have højere prioritet ved sortering end selve navnet.
LMDB tillader at tildele hver database sin egen sammenligningsfunktion for nøgler. Dette gøres med funktionen mdb_set_compare som skal være defineret før åbning. Af åbenlyse årsager kan man ikke ændre den i løbet af, at databasen eksisterer. Comparatoren får to nøgler i binær format som input, og returnerer resultatet af sammenligningen: mindre (-1), større (1) eller lige (0). Pseudokoden til NodeKey ser således ud.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey * const aKey = (NodeKey * const)a->mv_data;
    NodeKey * const bKey = (NodeKey * const)b->mv_data;
    return // ...
}
Så længe alle nøgler i databasen har samme type, er det korrekt at konvertere deres byte-repræsentation til typen af den anvendte nøglestruktur. Der er dog en nuance, som vil blive diskuteret lidt længere nede i afsnittet "Læsning af poster."
Serialisering af værdier
Nøgleopbevaring med LMDB fungerer ekstremt intensivt. Sammenligningen mellem nøglerne foregår under enhver applikationsoperation, og hastigheden på komparatoren påvirker hele løsningens ydeevne. I en ideel verden burde den standard binære komparator være tilstrækkelig til at sammenligne nøgler, men hvis man endelig skal bruge sin egen, så skal proceduren for deserialisering af nøgler være så hurtig som muligt.
Værdi-delen af posten (værdien) interesserer databasen ikke særligt meget. Konverteringen fra byte-repræsentation til objekt finder kun sted, når det er nødvendigt for applikationskoden, for eksempel til visning på skærmen. Da dette sker relativt sjældent, er kravene til hastigheden af denne procedure ikke så kritiske, og i dens implementering har vi meget større frihed til at fokusere på brugervenlighed. For eksempel til serialisering af metadata om endnu ikke indlæste filer bruger vi NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Der er dog tilfælde, hvor ydelsen stadig er vigtig. For eksempel, når vi gemmer metainformation om filstrukturen i brugerens sky, bruger vi stadig det samme dump af objekternes hukommelse. Den interessante udfordring ved at danne deres serialiserede repræsentation er det faktum, at elementerne i kataloget modelleres ved hjælp af en klasses hierarki.
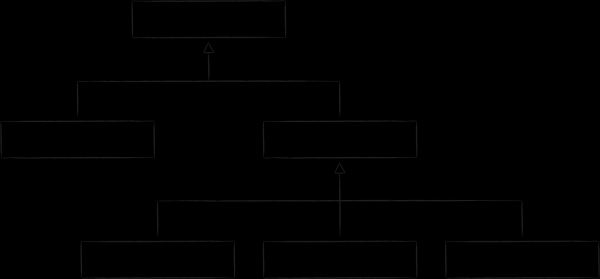
Til dens implementering på C-sprog føres specifikke felter af efterkommere til separate strukturer, og deres forbindelse til basen bestemmes gennem et union-felt. Indholdet af unionen angives gennem den tekniske attribut type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Tilføjelse og opdatering af poster
Serielle nøgler og værdier kan tilføjes til opbevaringen. Til dette bruges funktionen mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);I konfigurationstrinnet kan du tillade eller forbyde lagring af flere poster med samme nøgle. Hvis nøgleduplikering er forbudt, kan du ved indsættelse af en post definere, om det er tilladt at opdatere en allerede eksisterende post eller ej. Hvis overskrivning kun kan ske som følge af en fejl i koden, kan du sikre dig imod dette ved at angive et flag. NOOVERWRITE.
Læsning af poster
For at læse poster i LMDB er funktionen mdb_gettilgængelig. Hvis et nøgle-værdi-par tidligere er præsenteret med dumpede strukturer, ser denne procedure ud som følger.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Den viste liste viser, hvordan serialisering via dumpede strukturer gør det muligt at undgå dynamisk allokering, ikke kun ved skrivning, men også ved læsning af data. Den returnerede pointer mdb_get peger præcist på den adresse i virtuel hukommelse, hvor databasen gemmer den byte-repræsentation af objektet. Faktisk får vi en slags ORM, der praktisk talt gratis sikrer meget høj læsehastighed. På trods af denne tiltrækkende tilgang skal man huske på flere relaterede egenskaber.
- For read-only transaktioner vil pointeren til værdi-strukturen i sikkerhed forblive gyldig, så længe transaktionen ikke afsluttes. Som nævnt tidligere forbliver B-træets sider, hvor objektet ligger, uændrede takket være copy-on-write princippet, så længe mindst én transaktion refererer til dem. Samtidig, så snart den sidste tilknyttede transaktion afsluttes, kan siderne genbruges til nye data. Hvis det er nødvendigt, at objekterne overlever den transaktion, der har skabt dem, skal de dog stadig kopieres.
- For read-write transaktioner vil pointeren til den modtagne værdi-struktur kun være gyldig indtil den første modificerende procedure (indsættelse eller sletning af data).
- Selvom strukturen
NodeValueikke er fuldgyldig, men beskåret (se afsnittet 'Sortering af nøgler med ekstern sammenligner'), kan du trygt tilgå dens felter gennem pointeren. Det vigtigste er ikke at afdereferere den! - På ingen måde må strukturen ændres gennem den modtagne peger. Alle ændringer skal kun ske gennem metoden
mdb_put. Men selv med det bedste ønske vil det ikke være muligt, da det mindste område af hukommelsen, hvor denne struktur er placeret, er kortlagt i readonly-tilstand. - Remap filen til adressen i procesens adresseområde for eksempel for at øge den maksimale størrelse på lageret ved hjælp af funktionen
invalidere alle entiteter (kursører, transaktioner, nøgler og værdier), der blev skabt tidligere af motoren. At tage højde for sådan en udvikling i koden vil medføre betydelig kompleksitet. Hvis du dog er meget afhængig af virtuel hukommelse, kan det være en god idé at overveje en forgrening, der er kommet langt frem og tilbyder "automatisk justering af databases størrelse under kørsel".invalidere fuldstændigt alle transaktioner og de dertil knyttede enheder generelt og pegerne på læste objekter specifikt.
Endelig er der en anden funktion, som er så snedig, at dens essens ikke kan være blot endnu et punkt. I kapitlet om B-træet gav jeg en skematisk oversigt over, hvordan dets sider er organiseret i hukommelsen. Heraf følger, at adressen til begyndelsen af bufferen med de serialiserede data kan være helt vilkårlig. På grund af dette er pegeren til dem, der er opnået i strukturen MDB_val og konverteret til en peger til strukturen, generelt set ikke justeret. Samtidig kræver arkitekturerne for nogle chips (iOS tilfældet er armv7) at adressen for enhver data er et multiplum af størrelsen på maskinens ord eller med andre ord systemets bitdygtighed (for armv7 — det er 32 bit). Med andre ord operationer som *(int *foo)0x800002 betragtning til løb og resulterer i en dom med EXC_ARM_DA_ALIGN. Denne triste skæbne kan undgås på to måder.
Den første indebærer, at data kopieres på forhånd til en sikkert justeret struktur. For eksempel vil dette afspejles i en brugerdefineret komparator sådan.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return \/\/ ...
}
En alternativ metode er at informere kompilatoren på forhånd om, at strukturer med nøgle og værdi muligvis ikke er justeret ved hjælp af attributten aligned(1). På ARM kan den samme effekt og med attributten packed. Da denne metode også fremmer optimering af den plads, strukturen optager, synes jeg den metode at være mere foretrukken, selvom den medfører øgede omkostninger ved adgang til data.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Range-anmodninger
For iterating through a group of records in LMDB, a cursor abstraction is provided. We will explore how to use it using the familiar table of user cloud metadata as an example.
When displaying a list of files in a directory, it is necessary to find all keys associated with its child files and folders. In previous sections, we sorted the keys NodeKey in such a way that they are primarily ordered by the identifier of the parent directory. Thus, technically, the task of retrieving the contents of a folder boils down to positioning the cursor at the upper boundary of the group of keys with a specified prefix and then iterating down to the lower boundary.
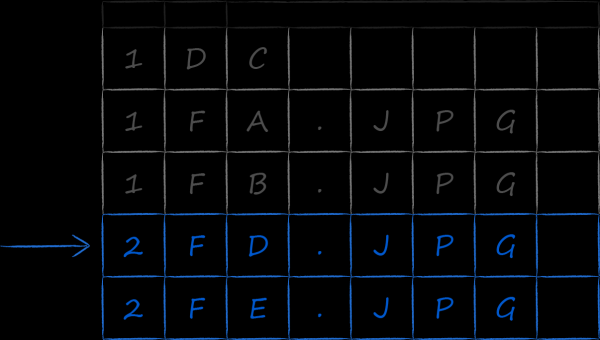
The upper boundary can be found "straightforwardly" through sequential search. To do this, the cursor is set to the beginning of the entire list of keys in the database and then incremented until a key with the identifier of the parent directory is found below it. This approach has two obvious drawbacks:
- Linear search complexity, although it is known that in trees in general and in B-trees in particular it can be performed in logarithmic time.
- It is wasteful to load all pages prior to the sought one from file into main memory, which is extremely costly.
Fortunately, the LMDB API provides an efficient way to initially position the cursor. To do this, a key needs to be formed that has a value known to be less than or equal to the key located at the upper boundary of the interval. For example, regarding the list in the above illustration, we can create a key in which the field parentId is set to 2, while all other fields are filled with zeros. Such a partially filled key is passed to the function mdb_cursor_get with the operation specified as MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);If the upper boundary of the group of keys is found, we then iterate over it until either we encounter a key with a different value parentId, or the keys run out entirely.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// processing...
} while (MDB_NOTFOUND != rc && // check end of table
IsTargetKey(key)); // check end of keys groupDet er en glæde, at vi i forbindelse med iterationen ved hjælp af mdb_cursor_get får både nøglen og værdien. Hvis det er nødvendigt at kontrollere felter fra value-delen af posten for at opfylde udvælgelseskriterierne, er de tilgængelige uden yderligere anstrengelser.
4.3. Modelleringsforhold mellem tabeller
Indtil nu har vi været i stand til at se på alle aspekter af design og arbejde med en entitetstabel database. Man kan sige, at en tabel er et udvalg af sorteret data bestående af ensartede nøgle-værdi-par. Hvis vi forestiller os nøglen som et rektangel og den tilknyttede værdi som et parallelepiped, får vi et visuelt diagram af databasen.

I det virkelige liv er det dog sjældent muligt at klare sig med så få ressourcer. Ofte kræves det i en database for det første at have flere tabeller, og for det andet at foretage udvælgelse i en rækkefølge, der adskiller sig fra den primære nøgle. Dette sidste afsnit handler om oprettelsen af disse tabeller og deres sammenkobling.
Indekstabeller
I cloud-applikationen er der en sektion "Galleri". Her vises medieindhold fra hele clouden, sorteret efter dato. For at optimere denne udvælgelse er det nødvendigt at oprette endnu en tabel ved siden af hovedtabellen med en ny type nøgler. I denne vil der være et felt med datoen for filens oprettelse, som vil fungere som det primære sorteringskriterium. Da de nye nøgler henviser til de samme data som nøglerne i hovedtabellen, kaldes de indeksnøgler. På billedet nedenfor er de fremhævet i orange.
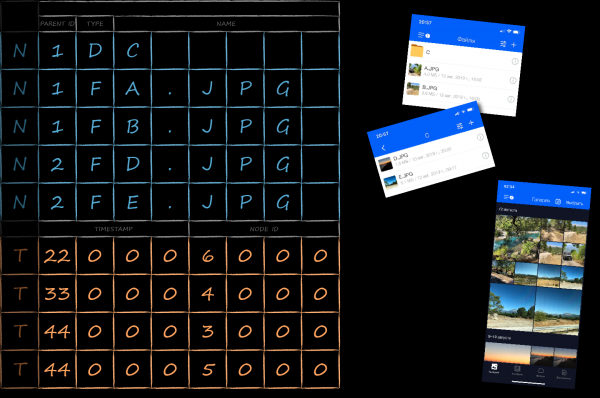
For at skelne mellem nøglerne fra forskellige tabeller inden for én database er der tilføjet et ekstra teknisk felt tableId til alle. Ved at gøre det til det mest prioriterede for sorteringen opnår vi gruppering af nøgler først efter tabeller og derefter inden for tabellerne ifølge deres egne regler.
Indeksnøglen henviser til de samme data som den primære nøgle. En direkte implementering af denne egenskab ved at associerer en kopi af value-delen fra den primære nøgle er suboptimalt fra flere perspektiver:
- Set fra et pladsperspektiv, da metadata kan være ret tunge.
- Set fra et præstationsperspektiv, da det ved opdatering af metadata vil kræve en omskrivning på to nøgler.
- Når det kommer til kodeunderstøttelse, så snart vi glemmer at opdatere dataene for en af nøglerne, vil vi opleve en vanskelig at fange fejl i datainkonsistens i lageret.
Lad os derefter se på, hvordan vi kan eliminere disse mangler.
Organisering af forbindelser mellem tabeller
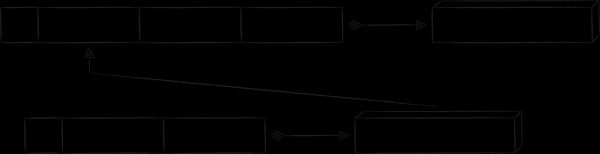
For at forbinde indekstabellen med hovedtabellen er mønsteret «nøgle som værdi». Som navnet antyder, fungerer en kopi af den primære nøgleværdi som value-delen i indekposten. Denne tilgang eliminerer alle de ovenfor nævnte mangler ved opbevaring af en kopi af value-delen af den primære post. Den eneste ulempe er, at det kræver to forespørgsler til databasen for at få værdien via indeksnøglen i stedet for én. Skematisk ser den resulterende databaseplan således ud.
Et andet mønster for organisering af forbindelser mellem tabeller er «overflødig nøgle». Dets essens ligger i at tilføje ekstra attributter til nøglen, som ikke er nødvendige for sortering, men for at genskabe den relaterede nøgle. I Mail.ru Cloud-appen er der virkelige eksempler på dets anvendelse, men for at undgå en dybdegående dykning i konteksten af specifikke iOS-rammer, vil jeg give et opdigtet, men mere forståeligt eksempel.
I de cloud-baserede mobile klienter er der en side, hvor alle filer og mapper vises, som brugeren har givet adgang til andre. Da der er relativt få sådanne filer, mens der er meget relateret specifik information omkring offentligheden (hvem der har fået adgang, med hvilke rettigheder osv.), ville det ikke være rationelt at tunge value-delen af posten i hovedtabellen med det. Men hvis man vil vise disse filer offline, er det stadig nødvendigt at opbevare det et sted. En naturlig løsning er at oprette en separat tabel til det. På skemaet herunder har dens nøgle præfikset «P», og pladsholderen «propname» kan erstattes med en mere konkret værdi «offentlig info».
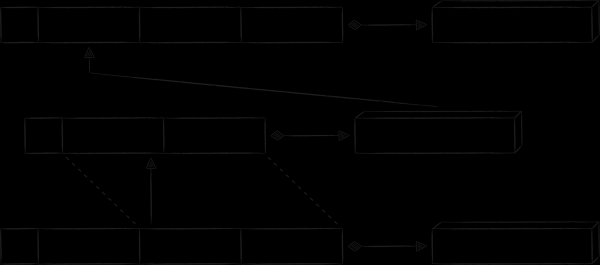
Alle unikke metadata, som den nye tabel blev oprettet for at kunne lagre, findes i value-delen af posten. Samtidig ønsker vi ikke at duplikere de data om filer og mapper, som allerede findes i hovedtabellen. I stedet tilføjes overskydende data i nøgle «P» i form af felterne «node ID» og «timestamp». Takket være dem kan vi konstruere en indeksnøgle, hvorfra vi kan få den primære nøgle, hvormed vi endelig kan få metadataene for noden.
Konklusion
Vi vurderer implementeringen af LMDB positivt. Efter det blev antallet af app-crashes reduceret med 30%.
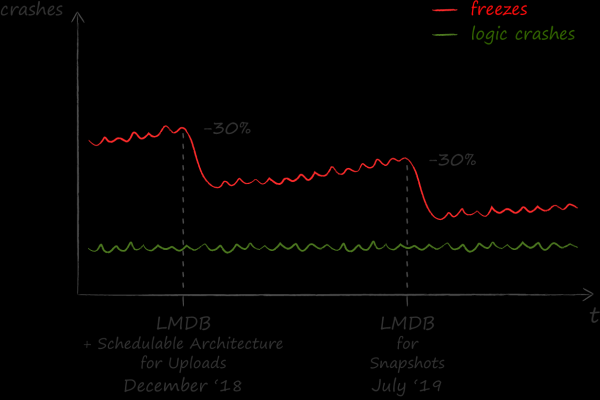
Resultaterne af det udførte arbejde er blevet bemærket uden for iOS-teamet. På nuværende tidspunkt er en af de vigtigste sektioner 'Filer' i Android-appen også gået over til at bruge LMDB, og andre dele er på vej. Sproget C, som key-value-lagringen er implementeret i, har været en god støtte for oprindeligt at lave et anvendelseslag omkring det tværplatformmæssigt på C++. For sømløs integration af det resulterende C++-bibliotek med den platformspecifikke kode på Objective-C og Kotlin blev der brugt en kodegenerator fra Dropbox, men det er en helt anden historie.
Kilde: habr.com
