

Capacity Tier (eller hvad vi kalder det internt — kaptier) blev introduceret allerede i Veeam Backup and Replication 9.5 Update 4 under navnet Archive Tier. Ideen bag det er at give mulighed for at flytte backups, der er uden for det såkaldte operational restore window, til objektlagre. Dette hjalp med at frigøre diskplads for de brugere, der havde lidt af det. Denne mulighed kaldes Move Mode.
For at udføre denne enkle (som det ser ud) handling var det nødvendigt at opfylde to betingelser: alle punkter fra den flyttede backup skal være uden for det ovennævnte operational restore window, som eksplicit angives i UI. Og for det andet: kæden skal være i såkaldt "sealed mode" (sealed backup chain eller Inactive Backup Chain). Det vil sige, at der med tiden ikke sker ændringer i denne kæde.
Men i VBR v10 blev konceptet udvidet med nye funktioner — Copy Mode, Sealed Mode og en funktion med det vanskeligt udtalte navn Immutability.
Det er om disse spændende emner, vi vil tale i dag. Først om hvordan det fungerede i VBR9.5u4, og derefter om ændringerne i den tiende version.
Og lad mig undskylde til fortalere for rent sprog, men det er umuligt at oversætte så mange termer.
Så der vil være en del anglicismer her.
Og mange GIF'er.
Og billeder.
- Uden mindste fortrydelse. Artikels forfatter.
Hvordan det var
Så lad os starte med at gennemgå operational restore window og sealed backup (eller hvad de kaldes i dokumentationen Inactive Backup Chain). Uden deres forståelse kan yderligere forklaring ikke gives.
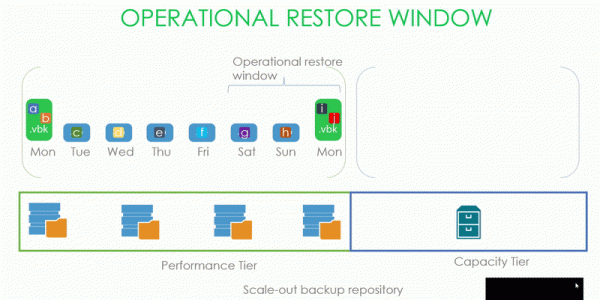
Som vi ser på billedet, har vi en backup-kæde med datablokke, der er placeret på Performance tier SOBR-repositoriet, til hvilket Capacity Tier er tilsluttet. Vores vindue for operationel backup er tre dage.
Dermed forsegler den oprettede .vbk fil fra mandag den tidligere kæde, hvis vindue er sat til tre dage. Og derfor kan vi trygt begynde at flytte alt, hvad der er ældre end disse tre dage, til capacity tier.
Men hvad var præcist meningen med den sealed kæde, og hvad kunne sendes til capacity tier i update 4?
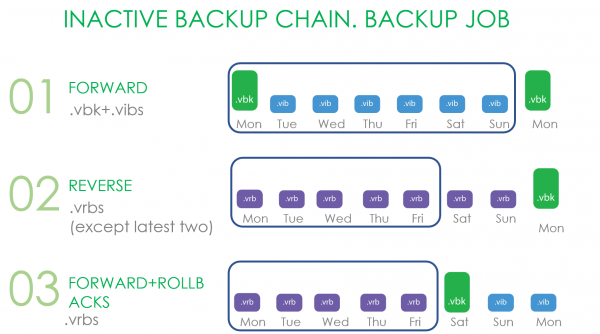
For Forward Incremental er tegnet på, at kæden er forseglet, ved oprettelsen af en ny fuld backup. Og det er ligegyldigt, hvordan denne fuld backup opnås: både synthetic full og active full backups tælles med.
I tilfælde af Reverse er det alle filer, der ikke falder inden for det operationelle vindue.
I tilfælde af Forward increment med rollbacks, er det alle rollbacks og .vbk, hvis der på performance extentet er en anden .vbk.
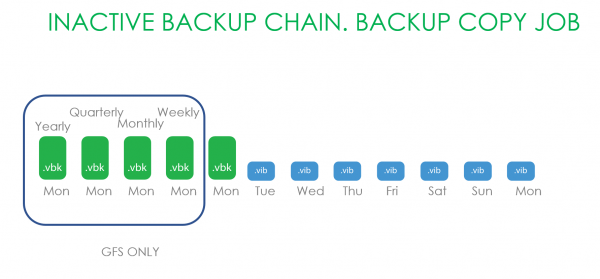
Lad os nu se på muligheden for at arbejde med Backup Copy kæder. Her blev der kun taget hensyn til det, der falder ind under GFS retention. Fordi alt, der er gemt i nyere backup copy kæder, kan på en eller anden måde være ændret.
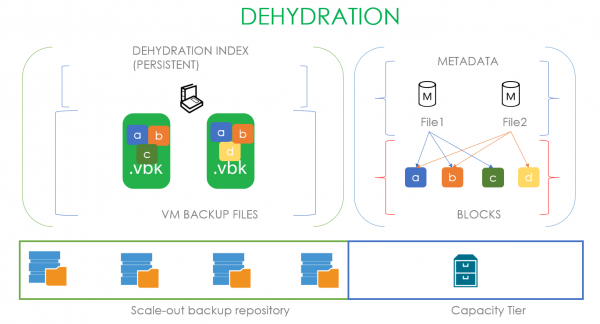
Lad os kigge under motorhjelmen. Her sker der en proces kaldet dehydriering — efterladelse af tomme backup-filer på extentet og flytning af blokke fra disse filer til capacity tier. For at optimere denne proces anvendes såkaldt dehydreringsindeks, som gør det muligt ikke at kopiere blokke, der allerede er blevet kopieret til capacity tier.
Lad os se, hvordan det ser ud med et eksempel: antag at vi har en .vbk, der er gået ud af driftvinduet og tilhører en forseglet kæde. Det betyder, at vi har fuld ret til at flytte den til capacity tier. På tidspunktet for flytningen oprettes der en metadatafil i capacity tier og blokke fra den flyttede fil. I metadatafilen beskrives det på blokniveau, hvilke blokke vores fil består af. I tilfældet vist på billedet består vores første fil af blokke a, b, c, og i metadataene er der links til disse blokke. Når vi får en anden .vbk fil, klar til at flytte og bestående af blokke a, b og d, forstår vi, ved at analysere dehydreringsindekset, at vi kun skal flytte blok d. Og dens metadatafil vil indeholde links til de to tidligere blokke og en ny.
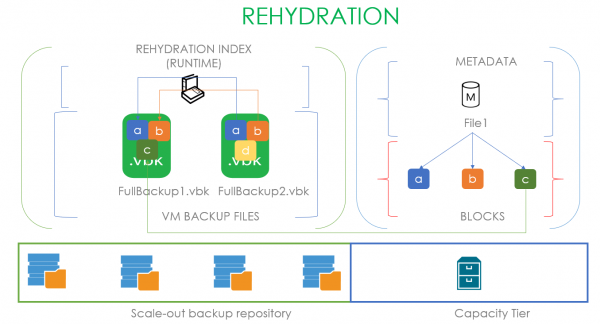
Derfor kaldes processen med at udfylde disse tomrum med data reghydrering. Her anvendes et specielt reghydrationsindeks, der bygger på den ældste .vbk fil på det lokale performance extent. Det vil sige, at hvis brugeren ønsker at genskabe en fil fra capacity tier, opretter vi først et indeks over blokke fra den ældste komplette backup og flytter kun de manglende blokke fra capacity tier. I det viste tilfælde, for at reghydrere FullBackup1.vbk i henhold til reghydrationsindekset, mangler vi kun blok C, som vi henter fra capacity tier. Hvis capacity tier er en cloud object storage, kan det spare enorme omkostninger.
Det kan se ud til, at denne teknologi er identisk med den, der anvendes i WAN-acceleratorer, men det er kun en illusion. I acceleratorer foregår der global deduplicering, mens der her anvendes lokal deduplicering inden for hver fil baseret på en bestemt offset. Dette skyldes forskellene i de opgaver, der skal løses: her skal vi kopiere store filer med fuld backup, og ifølge vores undersøgelser giver en sådan dedupliceringsalgoritme det bedste resultat, selvom der går lang tid imellem.
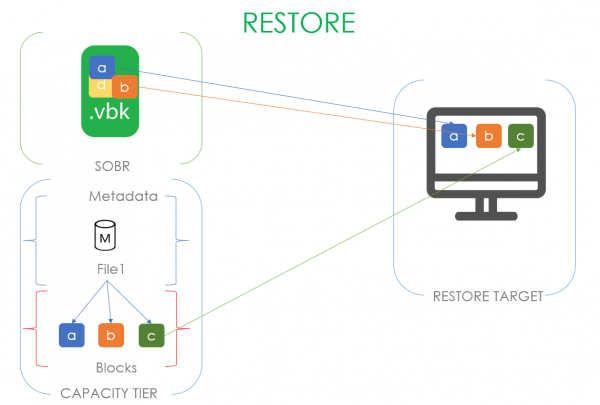
Men der er mere til indekserne! Der er også et indeks til datagendannelse! Når vi starter gendannelsen af en maskine, der er placeret i kapacitetstierne, vil vi kun læse unikke datablokke, som ikke er i performance-stierne.
Som det blev
Det var alt for introduktionen. Den er ret detaljeret, men som nævnt tidligere kan vi ikke forklare, hvordan de nye funktioner fungerer uden disse detaljer. Derfor, uden yderligere forord, går vi videre til det første punkt.
Copy mode
I høj grad baseret på eksisterende teknologier, men bærer en helt anden logik af brug.
Målet med denne tilstand er at sikre, at alle data, der er placeret på det lokale ekstent, har en kopi i kapacitetstierne.
Hvis man sammenligner Move og Copy-tilstande direkte, ser det således ud:
- Flytning kan kun ske med en forseglet kæde. I tilfælde af copy-tilstanden sendes absolut alt, uanset hvad der sker i backup-jobbet.
- Flytning udløses, når filer går ud over vinduet for operationel backup, mens kopiering udløses lige så snart backup-filen er tilgængelig.
- Sporing af nye data til kopiering sker konstant, mens flytning kun udløses hver fjerde time.
I betragtnings af den nye tilstand vil jeg foreslå at starte med simple eksempler, før vi går til de mere komplekse.
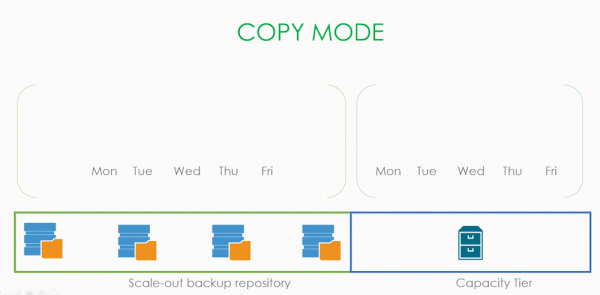
I det mest banale tilfælde modtager vi blot nye filer med inkrementer, og vi kopierer dem til kapacitetstierne. Uanset hvilken tilstand der bruges i backup-jobbet, uanset om den tilhører den forseglede del af kæden eller ej, og uanset om vores operationelle vindue er udløbet. Vi tager bare og kopierer.
Processen bag dette er stadig dehydrering, som beskrevet ovenfor. I kopi-tilstand sørger den også for, at vi ikke kopierer blokke, der allerede findes i vores objektlager. Den eneste forskel er, at hvis vi i bevægelses-tilstand erstatter rigtige filer med dummy-filer, så rører vi ikke ved dem her og lader alt forblive som det er. Ellers er det nøjagtigt den samme dehydreringsteknik, der omhyggeligt prøver at spare dine penge og tid.
Spørgsmålet opstår — hvis vi ser på brugergrænsefladen, er der mulighed for at vælge begge muligheder samtidigt. Hvordan vil en sådan kombineret tilstand fungere?
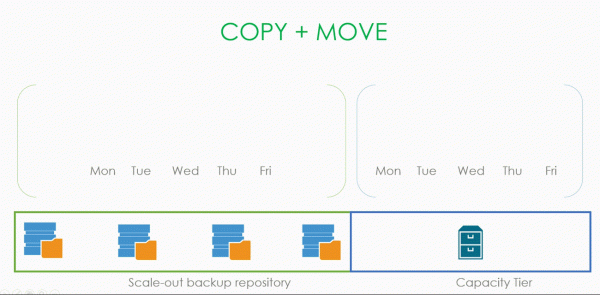
Lad os finde ud af det.
Det starter standardmæssigt: en backupfil oprettes og kopieres straks. Der oprettes en inkrementel backup og kopieres også. Dette fortsætter, indtil vi indser, at filerne er kommet uden for vores operationelle vindue, og der opstår en indkapslet kæde. På dette tidspunkt udfører vi dehydrering og erstatter disse filer med dummy-filer. Naturligvis kopierer vi ikke igen til kapacitetstier.
Hele denne interessante logik styres blot af et enkelt flueben i grænsefladen: Copy backups to object storage as soon as they are created.
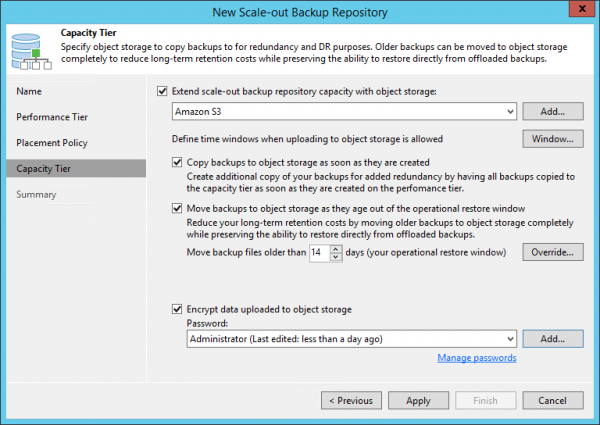
Hvorfor har vi denne Copy tilstand?
Det ville være bedre at omformulere spørgsmålet — hvilke risici beskytter vi os imod med det? Hvilket problem hjælper det os med at løse?
Svaret er indlysende: det er selvfølgelig datagendannelse. Hvis vi har en fuld kopi af lokale data på objektlageret, så er det ligegyldigt, hvad der sker med vores produktionsmiljø, vi kan altid gendanne data fra filer placeret i en hypotetisk Amazon.
Lad os derfor gennemgå de mulige scenarier fra det mest enkle til det mere komplekse.
Den enkleste ulykke, der kan ramme os, er utilgængeligheden af en af filerne i backupkæden.
En mere sørgelig historie er, at en af extentserne i vores SOBR-lager er gået i stykker.
Det bliver endnu værre, når hele SOBR-lageret bliver utilgængeligt, men kapacitetstierne fungerer.
Og det er helt slemt — når backupserveren dør, og dit første ønske er at prøve at nå den canadiske grænse på ti minutter.
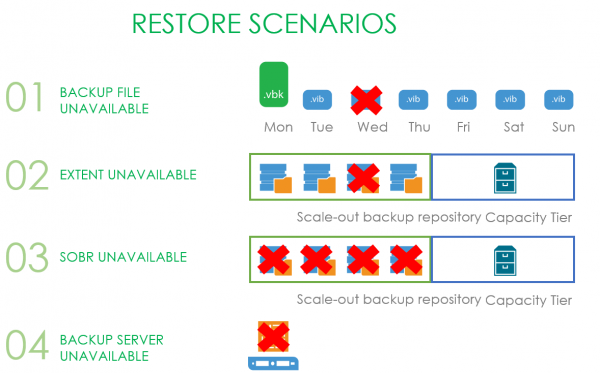
Lad os så tage et kig på hver situation enkeltvis.
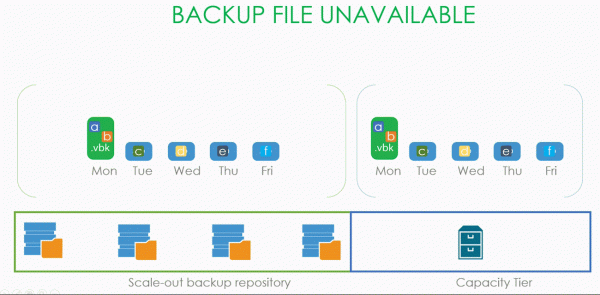
Når vi mister en (eller måske endda flere) backupfiler, er det nok at starte genindscanningen af databasen, og den mistede fil vil blive erstattet af en tom fil. Og ved hjælp af regenereringsprocessen (som nævnt i begyndelsen af artiklen) kan brugeren downloade data fra kapacitetspoolen til det lokale lager.
Nu er situationen mere kompleks. Lad os antage, at vores SOBR består af to extent, der kører i Performance-tilstand, hvilket betyder, at vores .vbk- og .vib-filer er spredt over dem i et ret uregelmæssigt lag. På et tidspunkt bliver en af extentene utilgængelig, og brugeren skal hurtigt gendanne maskinen, hvor en del af dataene ligger på netop denne extent.
Brugeren starter genopretningsguiden, vælger det punkt, han ønsker at gendanne til, og i løbet af arbejdet indser guiden, at han ikke har alle nødvendige data lokalt, og derfor skal de downloades fra kapacitetspoolen. De blokke, der er tilbage på det lokale lager, vil ikke blive downloadet fra skyen. Tak til restore-indekset (ja, det blev også omtalt i begyndelsen af artiklen).
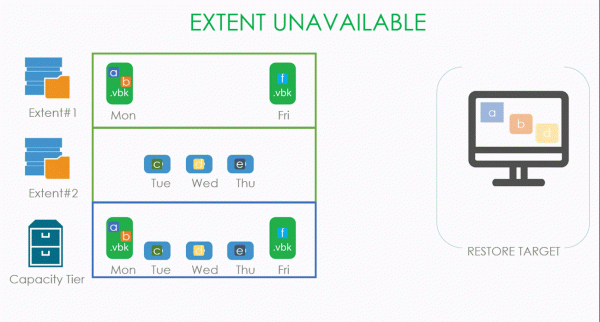
En underkategori af dette tilfælde er, at hele SOBR-repositoriet er blevet utilgængeligt. I dette tilfælde har vi intet at kopiere fra de lokale lagre, og alle blokke downloades fra skyen.
Og den mest interessante situation er, at backup-serveren er død. Her er der to muligheder: enten er administratoren dygtig og har lavet konfigurationsbackups, eller administratoren har været sin egen værste fjende og ikke lavet konfigurationsbackup.
I det første tilfælde vil han bare skulle implementere en ren installation af VBR et eller andet sted og gendanne sin database fra backup med standardværktøjer. Ved afslutningen af denne proces vil alt vende tilbage til det sædvanlige. Eller det vil blive gendannet ifølge et af de ovenstående scenarier.
Men hvis administrationen enten er sin egen fjende, eller backup-konfigurationen også har lidt den skæbnesvangre fejl, så vil vi ikke lade dem i stikken selv her. Til dette tilfælde har vi indført en ny procedure kaldet Import Object Storage. Den tillader os at springe den manuelle proces med at genskabe SOBR-repositoriet over og knytte det til et kapacitetstier med efterfølgende rescanning, og blot tilføje objektlagringen i VIMAP-interfacet og starte proceduren Import Storage Repository. Det eneste, der kan stå imellem dig og dine backups, er en anmodning om at indtaste adgangskoden, hvis dine backups er blevet krypteret.
Det var det for Copy Mode, og vi går videre til
Sealed Mode
Hovedkonceptet er, at der ikke må opstå nye backups på den valgte extent af SOBR-repositoriet. Indtil v10 havde vi kun Maintenance Mode, hvor al aktivitet med repositoriet var fuldstændig forbudt. En slags hårdkogt tilstand for at tage lageret ud af drift, hvor kun knappen Evacuate var tilgængelig, som én gang transporterer backups til en anden extent.
Sealed mode er en slags "blød" version: vi forbyder oprettelse af nye backups og sletter gradvist gamle i henhold til den valgte retention, men undervejs mister vi ikke muligheden for at gendanne fra de gemte punkter. Det er en meget nyttig funktion, når vi enten nærmer os slutningen af levetiden for maskinvaren, som skal udskiftes, eller når det bare skal frigøres til noget vigtigere, og man ikke har nogen steder at transportere alt på én gang. Eller det er ikke muligt at slette.
Princippet for arbejdet er ganske enkelt: man skal forbyde alle write-operationer (oprettelse af nye data) og tillade read (gendannelse) og delete (retention).
Begge tilstande kan anvendes samtidigt, men man skal huske, at Maintenance har højere prioritet.
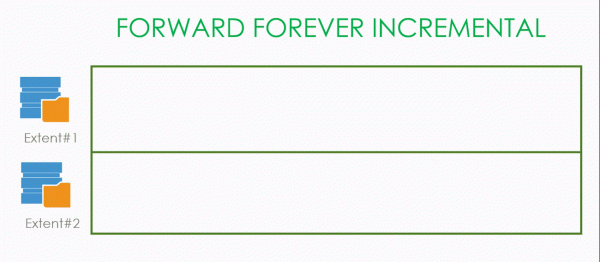
Som et eksempel kan vi tage et SOBR, der består af to extents. Antag, at der blev oprettet backups i Forward Forever Incremental-tilstand i de første fire dage, og derefter forseglede vi extenten. Dette fører til, at vi initierer oprettelsen af en ny aktiv fuld på den anden tilgængelige extent. Hvis vores retention er fire, så når hele kæden, der ligger på den forseglede extent, overskrider dens grænse, kan den med god samvittighed slettes.
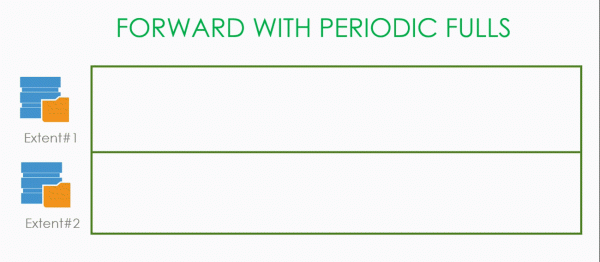
Der er situationer, hvor sletning sker tidligere. For eksempel, i Forward incremental med periodiske fulde sikkerhedskopier. Hvis vi i de første to dage har oprettet fulde sikkerhedskopier, og vi beslutter os for at forsegle depotet om torsdagen, vil filen fra mandag blive slettet om fredagen, når der oprettes en ny fuld sikkerhedskopi, da der ikke er afhængigheder til dette punkt. Og selve punktet afhænger ikke af nogen. Derefter venter vi, indtil der er oprettet fire punkter på det tilgængelige omfang, og sletter de resterende tre, som ikke kan slettes uafhængigt af hinanden.
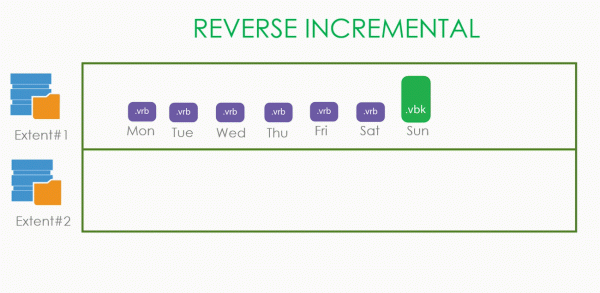
Det er lettere med Reverse Incremental. Her afhænger de ældste punkter ikke af noget, og kan derfor slettes uden problemer. Så snart en ny .vbk er oprettet på det nye omfang, vil de gamle .vrb blive slettet én ad gangen.
Forresten, hvorfor opretter vi hver gang en ny .vbk: Hvis vi ikke gjorde det, men fortsatte den gamle kæde af inkrementer, ville den gamle .vbk hænge i lang tid i enhver tilstand, hvilket ville forhindre dens sletning. Derfor blev det besluttet, at så snart omfanget forsegles, opretter vi en fuld sikkerhedskopi på et ledigt omfang.
Det er mere kompliceret med kapacitetstier.
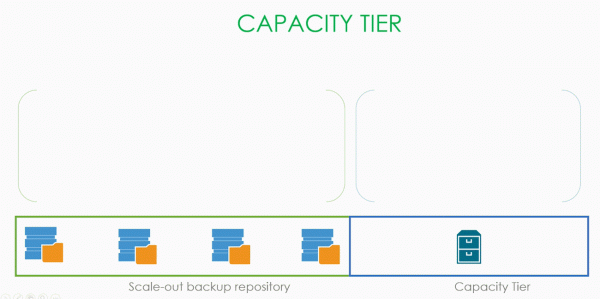
Lad os først se på copy mode. Antag, at vi aktivt har oprettet sikkerhedskopier i fire dage, og derefter blev kapacitetstien forseglet. Vi sletter ikke noget, men holder tålmodigt retention, hvorefter vi sletter data fra kapacitetstien.
Det samme sker i move mode — vi venter på retention, sletter det gamle i lokal lagring, sletter det, der er gemt i object storage.
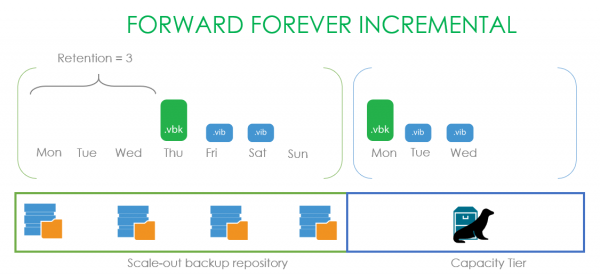
Et interessant eksempel med Forever forward incremental. Vi indstiller retention til tre punkter og begynder at lave sikkerhedskopier fra mandag, som flittigt kopieres til skyen. Efter forsegling af depotrummet fortsætter sikkerhedskopierne med at blive oprettet og overholder tre punkter, men de data, der er gemt i kapacitetstien, forbliver afhængige og kan ikke slettes. Derfor venter vi på torsdag, når vores .vbk overskrider retention, og først derefter kan vi trygt slette hele den gemte kæde.
Og en lille bemærkning: Alle eksempler her er vist med én maskine. Hvis du har flere i sikkerhedskopien, vil retention være forskellig afhængigt af, om der er lavet en Active Full eller ej.
Og det er i princippet alt. Så lad os gå videre til den mest hardcore funktion —
Immutability
Ligesom med de tidligere punkter, skal vi først tale om, hvilket problem denne funktion løser. Når vi først gemmer vores backups et sted, opstår der et stærkt ønske om at sikre deres integritet, altså fysisk forhindre enhver sletning eller modifikation i løbet af den angivne retention. Dette gælder også for administratorer og deres root-konti. Det gør det muligt at beskytte dem mod utilsigtet eller bevidst ødelæggelse. Dem, der arbejder med AWS, kan have stødt på en lignende funktion kaldet Object Lock.
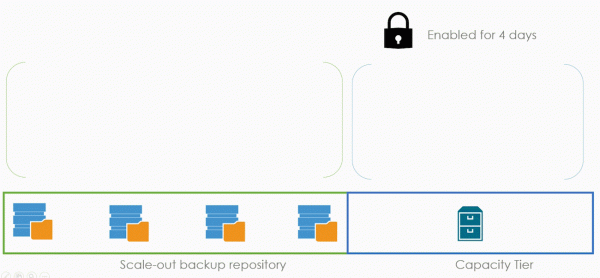
Lad os nu se på tilstanden i almindelige vendinger, og så går vi i dybden med detaljerne. I vores eksempel vil Immutability blive aktiveret for vores kapacitetsskive med en retention på fire dage. Og backup’en vil have Copy-tilstand aktiveret.
Immutability interagerer ikke med den generelle retention. For eksempel tilføjer det ikke ekstra punkter eller lignende. Bare i løbet af de fire dage kan en person ikke slette backup-filer. Hvis man laver en backup om mandagen, kan filen kun slettes om fredag.
Alle tidligere forklarede koncepter vedrørende dehydrering, indekser og metadata fungerer stadig på nøjagtig samme måde. Men med en forudsætning — blokken anvendes ikke kun til data, men også til metadata. Dette er lavet for at beskytte mod, hvis en ondsindet angriber beslutter sig for at slette vores metadata-database, så blokke med data ikke bliver til en ubrugelig binær grød.
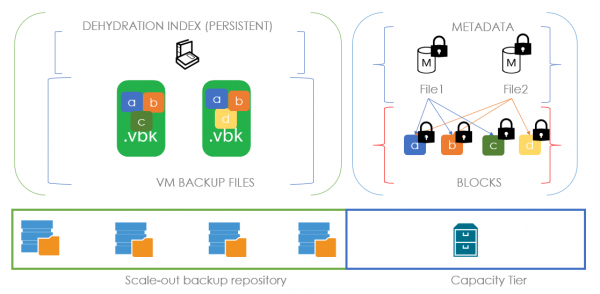
Og nu er det et godt tidspunkt at forklare vores teknologi til blokgeneration. Eller block generation. For dette vil vi se på den situation, der førte til dens fremkomst.
Lad os tage en tidslinje på seks dage, hvor vi nedenfor markerer tidspunktet for forventet udløb af immutability. Vi opretter en fil på den første dag, bestående af blok data a og dens metadata. Hvis immutability er indstillet til tre dage, er det logisk at antage, at dataene vil blive låst op og slettet på den fjerde dag. På den anden dag tilføjer vi en ny file2, der består af blok b med de samme indstillinger. Blok a skal stadig slettes på den fjerde dag. Men på den tredje dag sker der noget skræmmende — der oprettes en fil File3, bestående af en ny blok d og et link til den gamle blok a. Det betyder, at immutability-flaget for blok a skal genindstilles til en ny periode, der flyttes til den sjette dag. Og her opstår der et problem — der opstår et enormt antal af sådanne blokke i virkelige backup'er. For at forlænge deres immutability-periode skal man konstant lave et stort antal forespørgsler. Og faktisk bliver det en næsten uendelig daglig proces, da vi med stor sandsynlighed ved hver kopiering vil finde store bunker af deduplicerede blokke. Hvad betyder et stort antal forespørgsler hos objektstorage-udbydere? Rigtigt! En enorm regning ved slutningen af måneden.
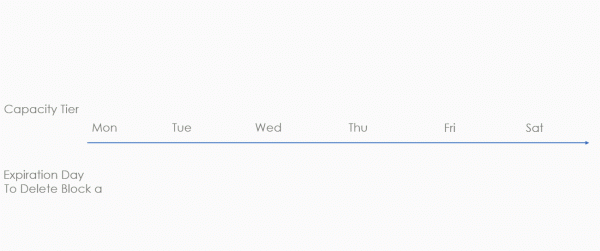
Og for ikke at prissætte mine dyrebare kunder urimeligt højt, blev der opfundet en mekanisme til block generation. Dette er en ekstra periode, som vi tilføjer til den fastsatte immutability-periode. I eksemplet nedenfor er denne periode lig med to dage. Men det er kun til illustration. I virkeligheden anvendes der en formel, der giver cirka ti ekstra dage ved månedlig låsning.
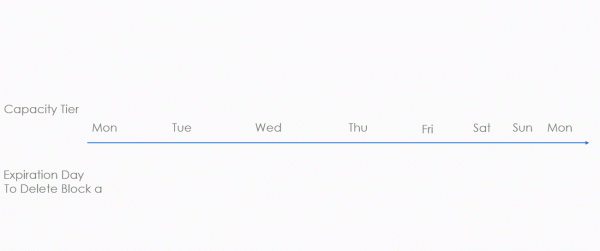
Lad os fortsætte med at se på den samme situation, men denne gang med block generation. Vi opretter file1 fra blok a og metadata den første dag. Vi aggregerer generationsperioden og immutability — hvilket betyder, at filen kan slettes først på den sjette dag. Hvis vi på den anden dag opretter File2, der består af blok b og en reference til blok a, sker der ikke noget med den forventede slettedato. Den forbliver som den var på den sjette dag. På den måde forsøger vi at spare penge på antallet af forespørgsler. Den eneste situation, hvor tidsrammen kan skubbes, er hvis generationsperioden er udløbet. Det vil sige, at hvis File3 på den tredje dag indeholder en reference til blok a, vil generation 2 blive tilføjet, da Gen1 allerede er udløbet. Og den forventede slettedato for blok a vil blive skubbet til den ottende dag. Dette gør det muligt for os at dramatisk reducere antallet af forespørgsler for at forlænge levetiden for deduplikering af blokke, hvilket sparer en masse penge for kunderne.
Selve teknologien er tilgængelig for S3-brugere og S3-kompatibelt udstyr, hvis producenter garanterer, at deres implementering ikke adskiller sig fra Amazons. Herfra kommer svaret på det legitime spørgsmål om, hvorfor Azure ikke understøttes — de har en lignende funktion, men den fungerer på container-niveau, ikke individuelle objekter. Forresten, i selve Amazon er der object lock i to tilstande: compliance og governance. I den sidstnævnte tilstand bevares muligheden for, at den største administrator af administratorer og root af rødderne, på trods af object lock, stadig kan slette data. I compliance-tilstanden er alt låst fast, og back-ups kan ikke slettes af nogen. Selv ikke af Amazons administratorer (ifølge deres officielle udtalelser). Vi understøtter netop denne tilstand.
Og, traditionelt, nogle nyttige links:
- Om i alle detaljer.
- Al information om i bedste form
- O i detaljer
Kilde: habr.com
