

Netflix — markededsfører inden for internet-tv — selskabet, der har skabt og aktivt udvikler dette segment. Netflix er kendt ikke kun for sit omfattende katalog af film og serier, der er tilgængelige fra næsten enhver del af verden og på enhver enhed med en skærm, men også for sin pålidelige infrastruktur og unikke ingeniørkultur.
Et tydeligt eksempel på Netflix' tilgang til udvikling og vedligeholdelse af komplekse systemer blev præsenteret på DevOops 2019 af — udviklingsdirektør hos Netflix. Kandidat fra Fakultetet for Matematik, Informatik og Naturvidenskab ved NNGU opkaldt efter Lobatchevsky. Sergey var en af de første ingeniører i Open Connect — CDN-teamet hos Netflix. Han har bygget overvågnings- og analyse-systemer for video data, lanceret den populære tjeneste FAST.com til at vurdere hastigheden af internetforbindelsen og har i de seneste par år arbejdet på at optimere internetanmodninger, så Netflix-applikationen fungerer hurtigere for brugerne.
Præsentationen fik de bedste anmeldelser fra konferencedeltagerne, og vi har forberedt en tekstversion til dig.
I præsentationen fortalte Sergey detaljeret
- om, hvad der påvirker forsinkelsen af internetanmodninger mellem klienten og serveren;
- hvordan man kan reducere denne forsinkelse;
- hvordan man designer, vedligeholder og overvåger fejlresistente systemer;
- hvordan man opnår resultater på kort tid, med minimal risiko for forretningen;
- hvordan man analyserer resultaterne og lærer af fejlene.
Svarene på disse spørgsmål er vigtige ikke kun for dem, der arbejder i store virksomheder.
De præsenterede principper og teknikker bør kendes og praktiseres af alle, der udvikler og vedligeholder internetprodukter.
Herefter — fortællingen fra taleren.
Vigtigheden af hastigheden på internettet
Hastigheden af internetanmodninger er direkte forbundet med forretningen. Lad os se på shoppingområdet: Amazon sagde i 2009, Der bliver flere og flere mobile enheder, og dermed mobile hjemmesider og applikationer. Hvis din side indlæses længere end 3 sekunder, mister du omkring halvdelen af brugerne. Siden
juli 2018 Hastigheden af forbindelsen er også vigtig i finansielle institutioner, hvor forsinkelse er kritisk. I 2015 afsluttede Hibernia Networks
arbejdet med kabelstrækningen mellem New York og London til en pris på 400 millioner dollars, for at reducere forsinkelsen mellem byerne med 6 ms. Forestil dig, 66 millioner dollars for 1 ms reduktion i forsinkelse!
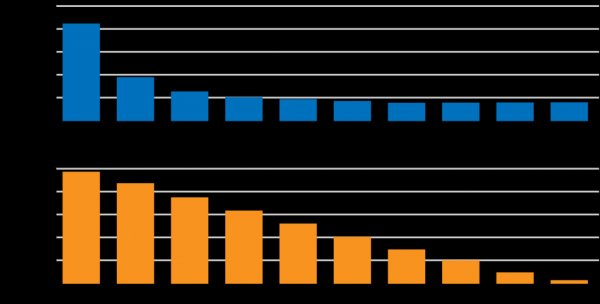
Ifølge , hastigheden på forbindelsen over 5 Mbit/s stopper med at have en direkte indflydelse på hastigheden af indlæsning af en typisk hjemmeside. Men der er en lineær sammenhæng mellem forbindelsesforsinkelse og siden indlæsningshastighed:
Men Netflix er ikke et typisk produkt. Indflydelsen af forsinkelse og hastighed på brugeren er et aktivt område for analyse og udvikling. Der er appindlæsning og indholdsvalg, som afhænger af forsinkelse, men indlæsning af statiske elementer og streaming afhænger også af hastigheden på forbindelsen. Analyse og optimering af de nøglefaktorer, der påvirker brugerens servicekvalitet, er et aktivt udviklingsområde for flere teams i Netflix. En af opgaverne er at reducere forsinkelsen af forespørgsler mellem Netflix-enheder og den cloud-infrastruktur.
I denne rapport vil vi fokusere specifikt på reduktion af forsinkelse (latency) ved at tage udgangspunkt i Netflix-infrastrukturen. Vi vil se fra et praktisk synspunkt på, hvordan man griber design-, udviklings- og driftsprocesserne af komplekse distribuerede systemer an, og bruge tid på innovation og resultater i stedet for diagnose af driftsproblemer og nedbrud.
Inden for Netflix
Tusindvis af forskellige enheder understøtter Netflix-applikationer. Deres udvikling håndteres af fire forskellige teams, der laver separate versioner af klienten til Android, iOS, TV og webbrowsere. Og vi bruger en masse ressourcer på at forbedre og personalisere brugergrænsefladen. Derfor kører vi samtidig hundreder af A/B-tests.
Personalisering understøttes af hundrede mikrotjenester i AWS-clouden, som leverer personaliserede data til brugeren, anmodningshåndtering, telemetri, Big Data og kodning. Visualiseringen af trafik ser således ud:
Til venstre er entry point, og derefter fordeles trafikken mellem flere hundrede mikrotjenester, der understøttes af forskellige backend-teams.
En anden vigtig komponent i vores infrastruktur er Open Connect CDN, som leverer statisk indhold til slutbrugeren — videoer, billeder, kode til klienter osv. CDN er placeret på tilpassede servere (OCA — Open Connect Appliance). Inden i findes der SSD- og HDD-diskarrays, der kører på den optimerede FreeBSD, med NGINX og en række tjenester. Vi designer og optimerer hardware- og softwarekomponenter, så en sådan CDN-server kan sende så meget data som muligt til brugerne.
„Væggen“ af disse servere ved internettrafikudvekslingspunktet (Internet eXchange — IX) ser således ud:
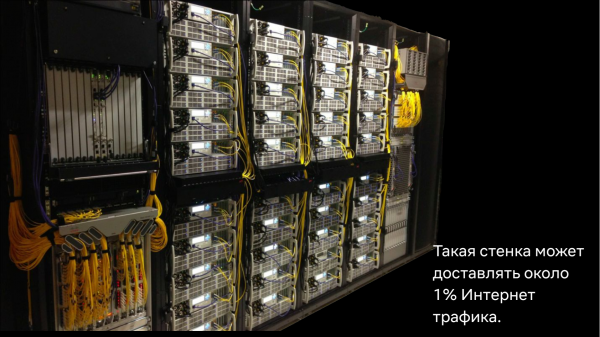
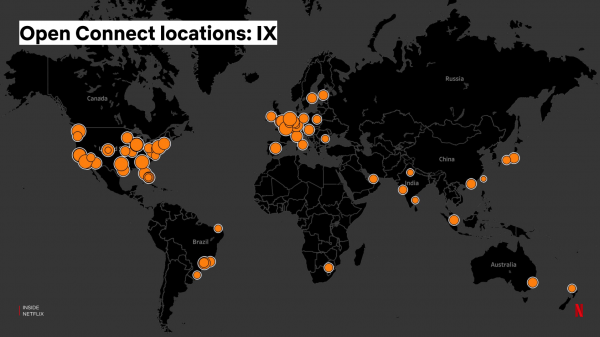
Internet Exchange giver internetudbydere og indholdsleverandører mulighed for at „forbinde“ sig til hinanden for en mere direkte dataudveksling på internettet. Der er omkring 70-80 Internet Exchange-punkter i hele verden, hvor vores servere er installeret, og vi står selv for installation og vedligeholdelse af dem:
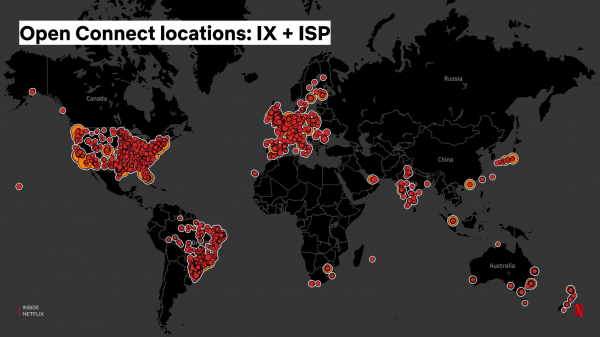
Derudover leverer vi også servere direkte til internetudbydere, som de installerer i deres netværk, hvilket forbedrer lokaliseringsmuligheden for Netflix-trafik og kvaliteten af streaming for brugerne:
Et sæt af AWS-tjenester er ansvarlige for at dirigere videoforekomster fra kunder til CDN-servere, samt konfigurere selve serverne — opdatering af indhold, programkode, indstillinger osv. Til dette har vi også bygget et backbone-netværk, som forbinder servere i Internet Exchange-punkter med AWS. Backbone-netværket består af et globalt netværk af fiberkabler og routere, som vi kan designe og konfigurere baseret på vores behov.
Ifølge , vores CDN-infrastruktur leverer i peak-timer cirka ⅛ af den globale internettrafik og ⅓ af trafikken i Nordamerika, hvor Netflix har været længst. Imponerende tal, men for mig er en af de mest overraskende præstationer, at hele CDN-systemet udvikles og vedligeholdes af et team på mindre end 150 personer.
Oprindeligt blev CDN-infrastrukturen designet til at levere videodata. Men over tid har vi indset, at vi også kan bruge den til at optimere dynamiske forespørgsler fra kunder til AWS-skyen.
Om at accelerere internettet
I dag har Netflix 3 AWS-regioner, og forsinkelsen på forespørgsler til skyen vil afhænge af, hvor langt kunden er fra den nærmeste region. Samtidig har vi mange CDN-servere, der bruges til at levere statisk indhold. Kan vi på en eller anden måde bruge denne infrastruktur til at accelerere dynamiske forespørgsler? Desværre er det ikke muligt at cache disse forespørgsler — API'er er personaliserede, og hvert resultat er unikt.
Lad os lave en proxy på CDN-serveren og begynde at lede trafikken gennem den. Vil det være hurtigere?
Materiale
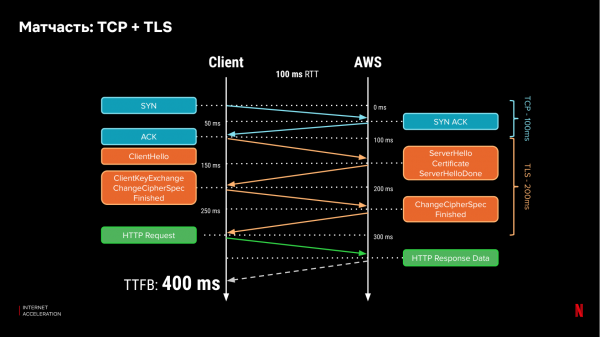
Lad os huske, hvordan netværksprotokoller fungerer. I dag bruger størstedelen af trafikken på internettet HTTPS, som afhænger af lavere niveau protokoller, TCP og TLS. For at kunden kan oprette forbindelse til serveren, udfører de et handshake, og for at etablere en sikker forbindelse skal kunden udveksle beskeder med serveren tre gange og mindst én gang til for at overføre data. Ved en forsinkelse på én udveksling (RTT) på 100 ms vil vi have brug for 400 ms for at få det første databit:
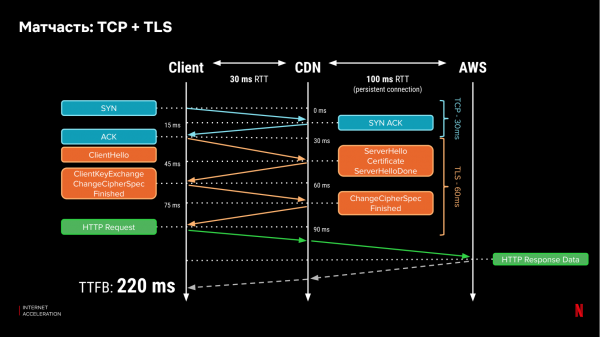
Hvis vi placerer certifikaterne på CDN-serveren, kan vi væsentligt forkorte "handshake"-tiden mellem kunden og serveren, hvis CDN ligger tættere på. Lad os antage, at forsinkelsen til CDN-serveren er 30 ms. Så vil det tage 220 ms for at få det første databit:
Men fordelene stopper ikke her. Efter at forbindelsen er blevet etableret, øger TCP congestion vinduet (mængden af information, som den kan overføre via denne forbindelse parallelt). Hvis et datapakke går tabt, reducerer klassiske implementeringer af TCP-protokollen (som TCP New Reno) det åbne "vindue" med halvdelen. Stigningen i congestion vinduet, og hastigheden af genopretning efter tab afhænger igen af forsinkelsen (RTT) til serveren. Hvis forbindelsen kun går til CDN-serveren, vil denne genopretning være hurtigere. Desuden er pakke tab en standardfænomen, især for trådløse netværk.
Internetkapaciteten kan falde, især i myldretiden på grund af trafik fra brugerne, hvilket kan føre til "trafikpropper". På internettet er der ingen måde at prioritere nogle anmodninger over andre. For eksempel at prioritere små og forsinkelsessensitive anmodninger i forhold til "tunge" datastreams, der belaster netværket. Men i vores tilfælde gør vores eget backbone-netværk dette muligt på en del af anmodningens rejse — mellem CDN og skyen, og vi kan konfigurere det fuldt ud. Vi kan prioritere små og forsinkelsessensitive pakker, mens store datastreams kan sendes lidt senere. Jo tættere CDN er på kunden — jo mere effektivt bliver det.
Derudover har applikationslagsprotokoller (OSI niveau 7) også indflydelse på forsinkelsen. Nye protokoller som HTTP/2 tillader en optimering af ydeevnen for parallelle anmodninger. Dog har vores klienter hos Netflix nogle ældre enheder, som ikke understøtter de nye protokoller. Ikke alle klienter kan opdateres eller optimalt konfigureres. Mellem CDN-proxyen og skyen har vi imidlertid fuld kontrol og muligheden for at bruge nye, optimale protokoller og indstillinger. Den ineffektive del med de gamle protokoller vil kun fungere mellem klienten og CDN-serveren. Desuden kan vi multiplexe anmodninger på det allerede etablerede forbindelsen mellem CDN og skyen, hvilket forbedrer udnyttelsen af forbindelsen på TCP-niveau:
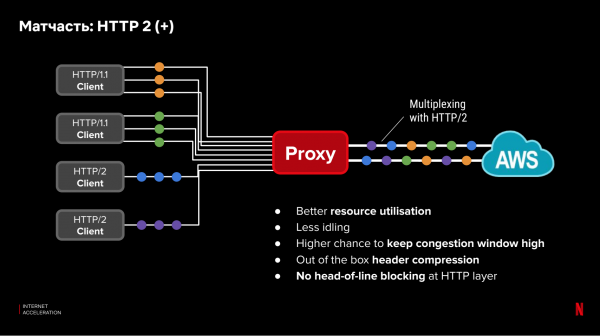
Måling
Selvom teorien lover forbedringer, kaster vi os ikke straks ud i at lancere systemet i produktion. I stedet skal vi først bevise, at idéen fungerer i praksis. For at gøre dette skal vi besvare flere spørgsmål:
- Hastighed: Bliver proxyen hurtigere?
- Pålidelighed: Vil den bryde oftere?
- Kompleksitet: Hvordan integreres det med applikationer?
- Omkostninger: Hvad koster det at implementere yderligere infrastruktur?
Lad os se nærmere på vores tilgang til vurderingen af det første punkt. De andre behandles på en lignende måde.
For at analysere hastigheden af anmodninger ønsker vi at indhente data fra alle brugere uden at bruge meget tid på udvikling og uden at nedbringe produktionen. Der er flere tilgange til dette:
- RUM, eller passiv måling af anmodninger. Vi måler den tid, det tager at udføre aktuelle anmodninger fra brugere og sikrer fuld dækning af brugerne. Ulempen er, at signalet ikke er helt stabilt på grund af mange faktorer, for eksempel forskellige anmodningsstørrelser, behandlingstid på serveren og klienten. Derudover kan man ikke teste en ny konfiguration uden effekt på produktionen.
- Laboratorietests. Specialiserede servere og infrastruktur, som simulerer kunder. Med dem udfører vi de nødvendige tests. På den måde opnår vi fuld kontrol over måleresultaterne og et klart signal. Men der er ikke fuld dækning af enheder og brugerplaceringer (især med tjenesten på globalt plan og understøttelse af tusindvis af enhedsmodeller).
Hvordan kan man kombinere fordelene ved begge metoder?
Vores team har fundet en løsning. Vi har skrevet et lille stykke kode — en prøvning — som vi har integreret i vores applikation. Prøverne gør det muligt for os at udføre fuldt kontrollerede netværkstests fra vores enheder. Det fungerer på følgende måde:
- Kort efter indlæsningen af applikationen og afslutningen af den indledende aktivitet, starter vi vores prøver.
- Klienten sender en anmodning til serveren og modtager 'opskriften' på testen. Opskriften er en liste af URL-adresser, som der skal laves HTTP(s) anmodninger til. Desuden konfigurerer opskriften anmodningens parametre: forsinkelser mellem anmodninger, mængde af forespurgte data, HTTP(s) headers osv. Samtidig kan vi teste flere forskellige opskrifter parallelt — ved anmodning om konfiguration vælges det tilfældigt, hvilken opskrift der skal gives.
- Tiden for start af prøven vælges, så det ikke konflikerer med aktiv brug af netværksressourcer på klienten. I princippet vælges et tidspunkt, når klienten ikke er aktiv.
- Efter modtagelsen af opskriften sender klienten anmodninger til hver af URL-adresserne parallelt. Anmodningen til hver af adresserne kan gentages — de såkaldte 'pulser'. Ved den første puls måler vi, hvor lang tid det tog at oprette forbindelsen og downloade data. Ved den anden puls måler vi tidsforbruget ved overførslen af data gennem den allerede etablerede forbindelse. Før den tredje puls kan vi indstille en forsinkelse og måle hastigheden for at genoprette forbindelsen osv.
Under testen måler vi alle parametre, som enheden kan opnå:
- DNS forespørgsels tid;
- TCP forbindelsestid;
- TLS forbindelsestid;
- tid til at modtage det første byte data;
- den samlede indlæsningstid;
- statuskode for resultatet.
- Efter alle målinger er afsluttet, downloader prøven resultaterne af alle målinger til analyse.
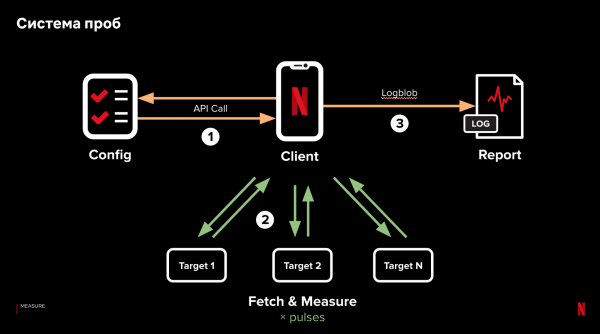
Nøglepunkterne er minimal afhængighed af logikken på klienten, databehandling på serveren og måling af parallelle forespørgsler. På denne måde får vi mulighed for at isolere og teste indflydelsen af forskellige faktorer, der påvirker forespørgslernes ydeevne, variere dem inden for en opskrift og opnå resultater fra rigtige kunder.
Denne infrastruktur har vist sig nyttig ikke kun til analyse af forespørgslernes ydeevne. I øjeblikket har vi 14 aktive opskrifter, over 6000 prøver pr. sekund, der indsamler data fra hele verden og dækker alle enheder. Hvis Netflix skulle købe en sådan tjeneste fra tredjepartsfirmaer, ville det koste millioner af dollars om året med meget dårligere dækning.
Vi tester teorien i praksis: prototype
Med et sådant system har vi fået mulighed for at vurdere effektiviteten af CDN proxyen på forespørgselslatens. Nu skal vi:
- oprette en proxyprototype;
- placere prototypen på CDN;
- bestemme, hvordan man dirigerer kunder til proxyen på en bestemt CDN-server;
- sammenligne ydeevnen med forespørgsler i AWS uden proxy.
Opgaven er at vurdere effektiviteten af den foreslåede løsning så hurtigt som muligt. Til at implementere prototypen valgte vi Go, takket være de gode netværksbiblioteker. På hver CDN-server installerede vi proxyprototypen som en statisk binær fil for at minimere afhængigheder og lette integrationen. I den indledende implementering brugte vi i videst muligt omfang standardkomponenter samt mindre modifikationer til HTTP/2 connection pooling og request multiplexing.
For balancing between AWS regions, we used a geographical DNS database, the same one used for client balancing. To select a CDN server for the client, we use TCP Anycast for servers in Internet Exchange (IX). In this scenario, we use one IP address for all CDN servers, while the client will be directed to the CDN server with the least number of IP hops. For the CDN servers installed with internet providers (ISP), we have no control over the router to configure TCP Anycast, so we engage , by which clients are directed to internet providers for video streaming.
So, we have three types of paths for the request: to the cloud via the open internet, through a CDN server in IX, or through a CDN server located at the internet provider. Our goal is to understand which path is better, and what benefits a proxy provides compared to how requests are directed in production. To do this, we use a probing system in the following way:
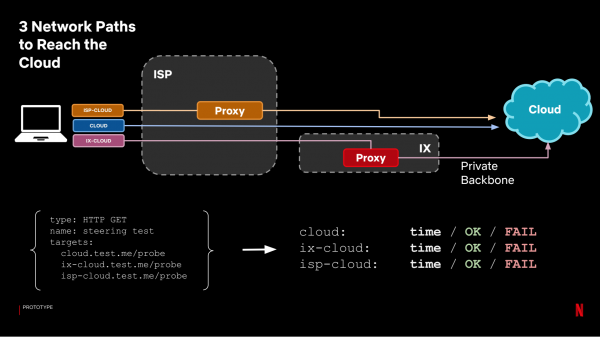
Each path becomes a separate target, and we look at the time we achieved. For analysis, we combine the proxy results into one group (selecting the best time between IX and ISP proxy) and compare it with the time of requests to the cloud without a proxy:
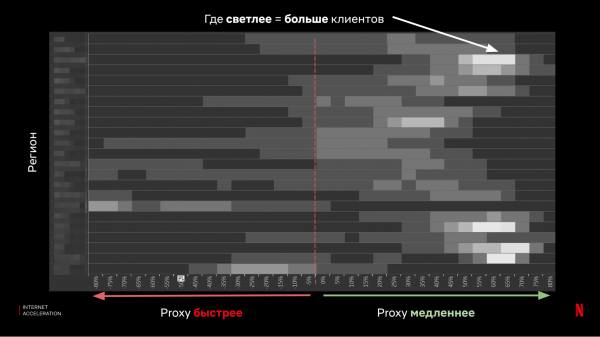
As seen, the results turned out to be ambiguous — in most cases, the proxy provides a good speedup, but there are also a sufficient number of clients for whom the situation noticeably worsens.
As a result, we accomplished several important things:
- We evaluated the expected performance of requests from clients to the cloud via CDN proxy.
- We obtained data from real clients across all types of devices.
- We understood that the theory was not confirmed 100%, and the initial proposal with CDN proxy will not work for us.
- We did not take risks — we did not change the production configurations for clients.
- We did not break anything.
Prototype 2.0
So, we return to the drawing board and repeat the process from scratch.
The idea is to instead of 100% proxy, we will determine the fastest path for each client and direct requests there — that is, we will do what is called client steering.
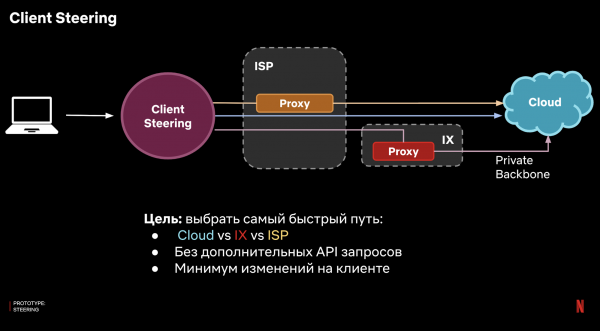
Hvordan implementerer vi det? Vi kan ikke bruge logik på serversiden, eftersom målet er at oprette forbindelse til denne server. Det skal gøres på klienten, og ideelt set med minimal kompleks logik for at undgå integrationsproblemer med et stort antal klientplatforme.
Svaret er brugen af DNS. I vores tilfælde har vi vores egen DNS-infrastruktur, og vi kan konfigurere et domæneområde, hvor vores servere vil være autoritative. Det fungerer sådan:
- Klienten sender en anmodning til DNS-serveren ved at bruge en vært, f.eks. api.netflix.com.
- Anmodningen når vores DNS-server.
- DNS-serveren ved, hvilken rute der er hurtigst for denne klient, og leverer den relevante IP-adresse.
Der er en ekstra kompleksitet i løsningen: autoritative DNS-udbydere ser ikke klientens IP-adresse og kan kun se IP-adressen på den rekursive resolver, som klienten bruger.
I sidste ende skal vores autoritative resolver træffe beslutninger ikke for en enkelt klient, men for en gruppe af klienter baseret på den rekursive resolver.
For at løse dette bruger vi de samme probes, samler måleresultater fra klienter fra hver af de rekursive resolvere og beslutter, hvor denne gruppe skal hen — gennem en proxy via IX ved hjælp af TCP Anycast, gennem ISP-proxy eller direkte til skyen.
Vi får et system som dette:
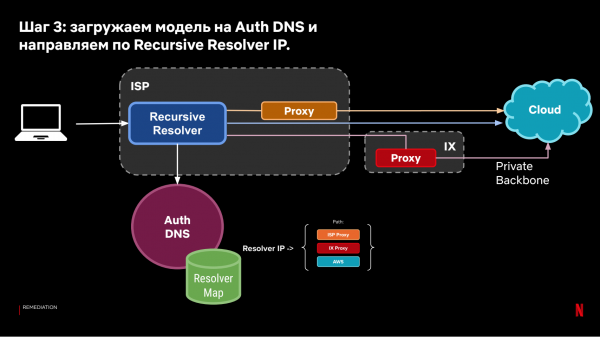
Den resulterende model for DNS steering gør det muligt at lede klienter baseret på historiske observationer af forbindelseshastigheder fra klienter til skyen.
Igen er spørgsmålet — hvor effektivt vil denne tilgang fungere? For at finde ud af det bruger vi igen vores system af probes. Derfor konfigurerer vi en recent-konfiguration, hvor et mål følger DNS steering, og et andet går direkte til skyen (nuværende produktion).
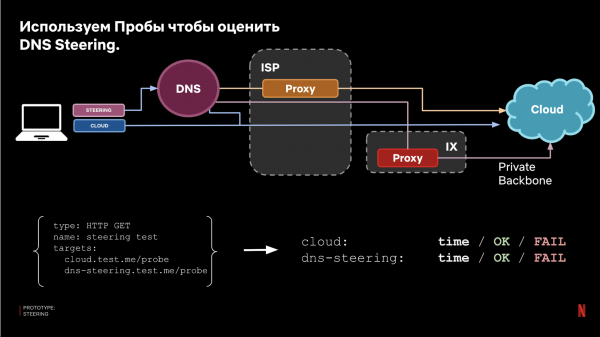
I sidste ende sammenligner vi resultaterne og får en vurdering af effektiviteten:
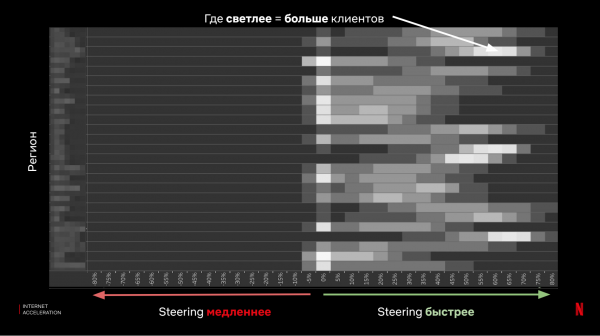
Vi har i sidste ende lært nogle vigtige ting:
- Vi har vurderet den forventede ydeevne for anmodninger fra kunder til skyen ved hjælp af DNS Steering.
- We obtained data from real clients across all types of devices.
- Vi har bevist effektiviteten af den foreslåede idé.
- We did not take risks — we did not change the production configurations for clients.
- We did not break anything.
Nu til det svære — vi starter i produktion.
Det letteste er nu bag os — vi har en fungerende prototype. Den svære del nu er at implementere løsningen for al Netflix-trafik, udrulle den til 150 millioner brugere, tusindvis af enheder, hundreder af mikroservices og konstant skiftende produkter og infrastruktur. Netflix-serverne modtager millioner af forespørgsler i sekundet, og man kan nemt bryde tjenesten med en uforsigtig handling. Samtidig ønsker vi at dirigere trafikken dynamisk gennem tusindvis af CDN-servere, i en verden, hvor tingene konstant ændrer sig og går i stykker på de mest upassende tidspunkter.
Og på trods af alt dette er der tre ingeniører i teamet, som er ansvarlige for udvikling, implementering og fuld support af systemet.
Derfor vil vi nu tale om rolig og sund søvn.
Hvordan fortsætter man udviklingen, uden at bruge al tiden på support? Vores tilgang bygger på tre principper:
- Vi reducerer det potentielle omfang af nedbrud (blast radius).
- Vi forbereder os på overraskelser — vi forventer, at noget går i stykker, på trods af testning og personlig erfaring.
- Gradvis nedbrydning (graceful degradation) — hvis noget ikke fungerer korrekt, skal det automatisk repareres, selvom det måske ikke er den mest effektive måde.
Det viste sig, at i vores tilfælde, med denne tilgang til problemet, kunne vi finde en enkel og effektiv løsning og gøre systemsupporten betydeligt enklere. Vi indså, at vi kunne tilføje et lille stykke kode til klienten og overvåge fejl i netværksanmodninger forårsaget af forbindelsesproblemer. Ved netværksfejl laver vi fallback direkte til skyen. Denne løsning kræver ikke betydelige anstrengelser fra klientteams, men reducerer betydeligt risikoen for uventede nedbrud og overraskelser for os.
Selvfølgelig, på trods af fallback, følger vi stadig en klar disciplin i udviklingsprocessen:
- Prøvetest.
- A/B-test eller Canaries.
- Graduel udrulning (progressive rollout).
Med prøverne er tilgangen beskrevet — ændringer testes først ved hjælp af en opsat opskrift.
Til canary-testning skal vi have sammenlignelige par servere, hvor vi kan se, hvordan systemet fungerer før og efter ændringer. For dette udtager vi par af servere fra vores mange CDN-sites, som modtager sammenlignelig trafik:
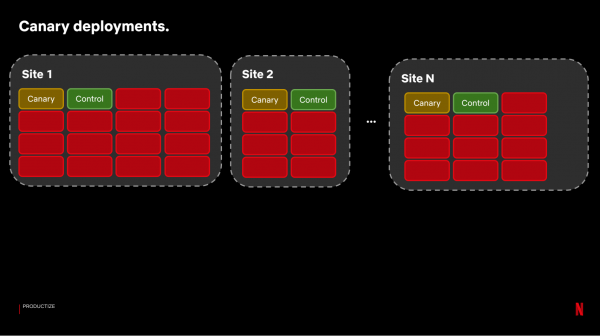
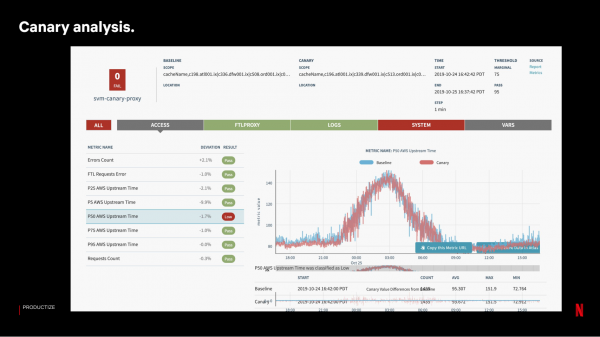
Derefter implementerer vi bygningen med ændringer på Canary-serverne. For at vurdere resultaterne kører vi et system, der sammenligner cirka 100-150 metrikker med et kontroludvalg af servere:
Hvis Canary-testen er vellykket, ruller vi gradvist op, bølge for bølge. På hver hjemmeside opdaterer vi ikke serverne samtidigt — tabet af en hel hjemmeside ved problemer har en mere betydelig indflydelse på servicen for brugerne end tabet af samme antal servere, men på forskellige steder.
Generelt afhænger effektiviteten og sikkerheden af denne tilgang af antallet og kvaliteten af de indsamlede metrikker. For vores anmodningsaccelerationssystem indsamler vi metrikker fra alle mulige komponenter:
- fra kunder — antal sessioner og forespørgsler, fallback rates;
- proxy — statistik over antal og tid af forespørgsler;
- DNS — antal og resultater af forespørgsler;
- cloud edge — antal og tid til behandling af forespørgsler i skyen.
Alt dette samles i en samlet pipeline, og alt efter behov beslutter vi, hvilke metrikker der skal sendes til real-time analyse, og hvilke der skal sendes til Elasticsearch eller Big Data for mere detaljeret diagnose.
Overvågning
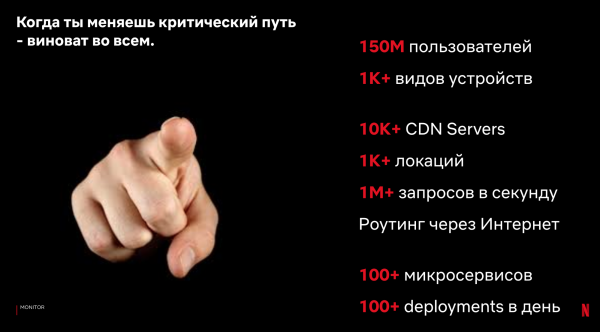
I vores tilfælde laver vi ændringer på den kritiske vej for forespørgsler mellem kunden og serveren. Antallet af forskellige komponenter på klienten, på serveren og på vejen gennem internettet er enormt. Ændringer på klienten og serveren sker konstant — under arbejdet af mange forskellige teams og naturlige ændringer i økosystemet. Vi er midt imellem — ved diagnosticering af problemer er der stor chance for, at vi er involveret. Derfor skal vi klart forstå, hvordan vi definerer, indsamler og analyserer metrikker for hurtig lokaliserings af problemer.
Ideelt set — fuld adgang til alle slags metrikker og filtre i realtid. Men der er mange metrikker, så spørgsmålet om omkostninger opstår. I vores tilfælde adskiller vi metrikker og udviklingsværktøjer på følgende måde:
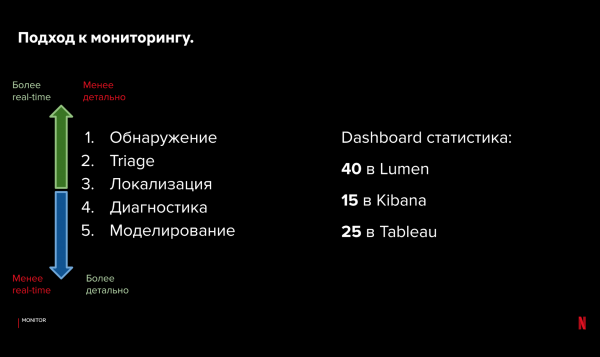
Til opdagelse og triage af problemer bruger vi vores egen real-time system med open source og — til visualisering. Det gemmer aggregerede metrikker i hukommelsen, er pålideligt og integreres med alerts-systemet. Til lokaliserings- og diagnoseformål har vi adgang til logs fra Elasticsearch og Kibana. Til statistisk analyse og modellering bruger vi big data og visualisering i Tableau.
Det virker som om det er meget besværligt at arbejde med en sådan tilgang. Men med en hierarkisk organisering af metrikker og værktøjer kan vi hurtigt analysere problemet, identificere problemetypen og derefter - dykke ned i de detaljerede metrikker. For at identificere fejlkilden bruger vi generelt omkring 1-2 minutter. Derefter arbejder vi med et specifikt team på diagnosticeringen - fra flere minutter til nogle timer.
Selv hvis diagnosticeringen foregår hurtigt, ønsker vi ikke, at det sker ofte. Ideelt set ønsker vi kun at modtage en kritisk alert, når der er betydelig indflydelse på servicen. For vores forespørgselsaccelerationssystem har vi kun 2 alerts, som vil underrette:
- procent Client Fallback - vurdering af kundeadfærd;
- procent Probe errors - data om stabiliteten af netværkskomponenter.
Disse kritiske alerts holder øje med, om systemet fungerer for de fleste brugere. Vi ser på, hvor mange kunder der har anvendt fallback, hvis de ikke kunne få accelerationen af forespørgsler. I gennemsnit har vi mindre end 1 kritisk alert om ugen, selvom der sker et enormt antal ændringer i systemet. Hvorfor er det tilstrækkeligt for os?
- Der er client fallback i tilfælde af, at vores proxy ikke fungerer.
- Der er et automatisk styresystem, der reagerer på problemer.
Lad os gå mere i dybden med det sidste. Vores probesystem og systemet til automatisk bestemmelse af den optimale rute for forespørgsler fra klienten til skyen gør det muligt automatisk at håndtere nogle problemer.
Lad os vende tilbage til vores konfiguration af probes og 3 kategorier af ruter. Udover indlæsningstiden kan vi se på selve leveringen. Hvis det ikke lykkes at indlæse data, kan vi ved at kigge på resultaterne på forskellige ruter bestemme, hvor og hvad der gik galt, og om vi kan reparere det automatisk ved at ændre forespørgselsruten.
Eksempler:
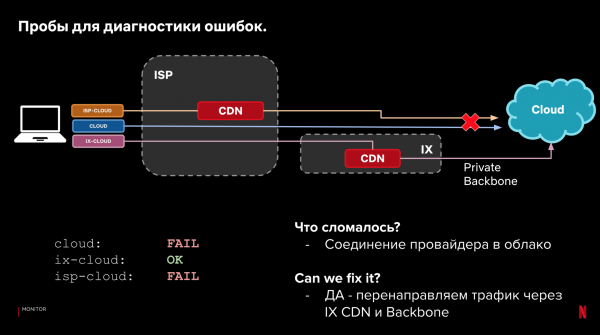
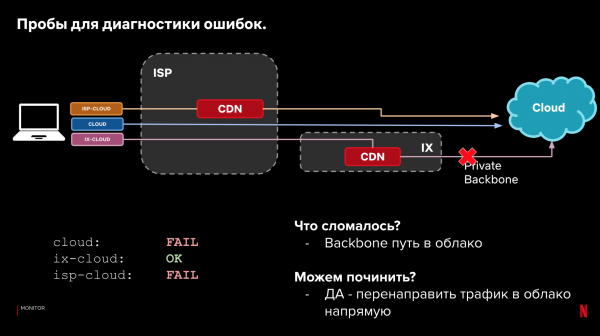
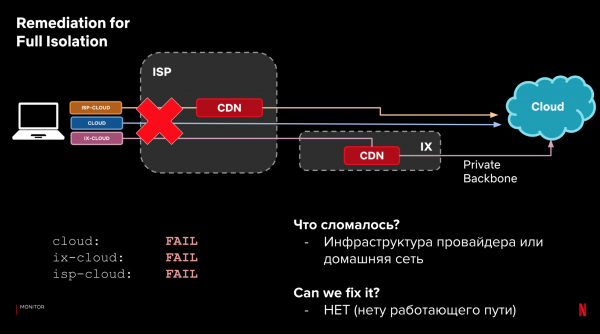
Denne proces kan automatiseres. Integreres i styresystemet. Og lære det at reagere på problemer med ydeevne og pålidelighed. Hvis noget begynder at gå i stykker - reagere, hvis der er en bedre mulighed. Herudover er øjeblikkelig reaktion ikke kritisk takket være fallback på klienterne.
Derfor kan principperne for systemunderstøttelse formuleres som følger:
- reducerer omfanget af fejl;
- indsamler metrikker;
- reparerer automatisk fejl, hvis vi kan;
- hvis ikke, underretter vi;
- Vi arbejder på dashboards og triage værktøjer for hurtig reaktion.
Lærte lektioner
Det tager ikke lang tid at skrive en prototype. I vores tilfælde var den klar efter blot 4 måneder. Med den fik vi nye målinger, og efter 10 måneder fra udviklingens start modtog vi den første produktionstrafik. Så begyndte det kedelige og meget komplekse arbejde: gradvist at produktivere og skalerer systemet, migrere hovedtrafikken og lære af fejlene. Denne effektive proces vil ikke være lineær — på trods af alle bestræbelser kan man ikke forudse alt. Hurtig iteration og respons på nye data er meget mere effektivt.
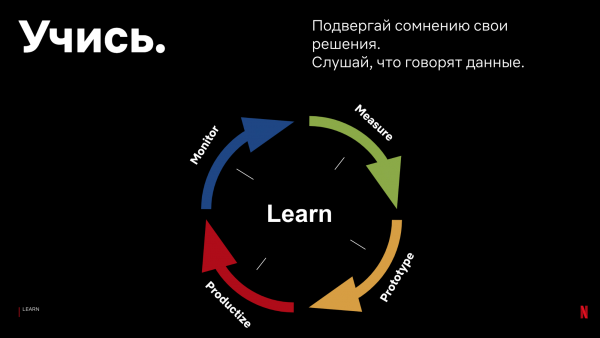
Ud fra vores erfaring kan vi anbefale følgende:
- Tro ikke på din intuition.
Vores intuition har konstant svigtet os, på trods af det store erfaringsniveau blandt teammedlemmerne. For eksempel forudså vi forkert den forventede acceleration ved brug af CDN-proxyer eller adfærden af TCP Anycast.
- Få data fra produktionen.
Det er vigtigt at få adgang til mindst en lille mængde produktionsdata så hurtigt som muligt. Antallet af unikke tilfælde, konfigurationer og indstillinger under laboratorieforhold er næsten umulige at opnå. Hurtig adgang til resultaterne giver mulighed for hurtigt at opdage potentielle problemer og tage dem med i systemarkitekturen.
- Følg ikke andres rådgivning og resultater — indsamle dine egne data.
Følg principperne for indsamling og analyse af data, men tag ikke blindt andres resultater og påstande. Kun du kan vide præcist, hvad der fungerer for dine brugere. Dine systemer og dine kunder kan være betydeligt forskellige fra andre virksomheder. Heldigvis er værktøjerne til analyse nu tilgængelige og lette at bruge. De resultater, du opnår, kan ikke stemme overens med det, som Netflix, Facebook, Akamai og andre virksomheder hævder. I vores tilfælde adskiller ydeevnen af TLS, HTTP2 eller statistikken om DNS-forespørgsler sig fra resultaterne fra Facebook, Uber, Akamai — fordi vi har andre enheder, kunder og datastreams.
- Stræb ikke efter modetrends unødigt og uden vurdering af effektiviteten.
Start simpelt. Det er bedre at lave et simpelt fungerende system på kort tid, end at bruge en enorm mængde tid på at udvikle unødvendige komponenter. Løs opgaver og problemer, der er vigtige baseret på dine målinger og resultater.
- Vær klar til nye anvendelser.
Ligesom det er svært at forudse alle problemer, er det også svært at forudse fordele og anvendelser. Tag et eksempel fra startups — deres evne til at tilpasse sig kundernes forhold. I dit tilfælde kan du opdage nye problemer og deres løsninger. I vores projekt havde vi som mål at reducere ventetiden på forespørgsler. Men under analysen og diskussionerne indså vi, at vi også kan anvende proxy-servere til:
- at fordele trafik mellem AWS-regioner og reducere omkostninger;
- at modellere stabiliteten af CDN;
- at konfigurere DNS;
- at konfigurere TLS/TCP.
Konklusion
I rapporten beskrev jeg, hvordan Netflix løser problemet med at fremskynde internetforespørgsler mellem kunder og cloud. Hvordan vi indsamler data ved hjælp af systemet til prøver hos kunderne, og bruger de indsamlede historiske data til at dirigere produktionsforespørgsler fra kunderne gennem den hurtigste rute på internettet. Hvordan vi bruger netværksprotokollers principper, vores CDN-infrastruktur, backbone-netværk, og DNS-servere for at opnå dette mål.
Men vores løsning er blot et eksempel på, hvordan vi i Netflix implementerede et sådant system. Hvad der fungerede for os. Den praktiske del af min rapport til jer — de udviklings- og supportprincipper, som vi følger for at opnå gode resultater.
Vores løsning på problemet er måske ikke passende for jer. Men teorien og udviklingsprincipperne forbliver, selv hvis I ikke har jeres egen CDN-infrastruktur, eller hvis jeres infrastruktur er væsentligt anderledes end vores.
Vigtigheden af hastigheden af forespørgsler på forretningen forbliver også. Og selv for en enkel service skal I træffe valg mellem "cloud"-udbydere, serverplaceringer, CDN og DNS-udbydere. Jeres valg vil påvirke effektiviteten af internetforespørgsler for jeres kunder. Og det er vigtigt for jer at måle og forstå denne indflydelse.
Start med enkle løsninger, vær opmærksom på, hvordan I ændrer produktet. Lær i processen og forbedr systemet baseret på data fra jeres kunder, jeres infrastruktur, og jeres forretning. Tænk på muligheden for uventede nedbrud under designprocessen. Så vil I kunne fremskynde jeres udviklingsproces, forbedre løsningens effektivitet, undgå unødvendig belastning på supporten og sove roligt.
I år i online-formatet. Du vil have mulighed for at stille spørgsmål til en af DevOps-fædrene, nemlig John Willis!
Kilde: habr.com
