

For to år siden lavede jeg allerede et indlæg about . Nu er der noget udvikling i projektet, og jeg har også offentliggjort under , derfor besluttede jeg at skrive denne lille anmeldelse på Habr.
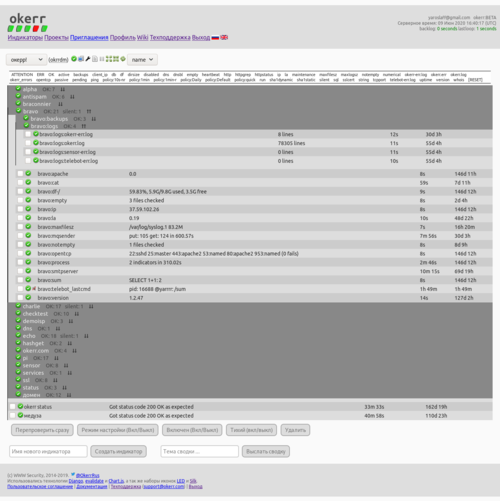
[ ]
Hvem kan være interesseret i dette
Du kan være interesseret, hvis du arbejder i et lille team eller helt alene. Du har ikke overvågning og er ikke sikker på, om det er nødvendigt. Eller måske har du prøvet en populær, seriøs overvågningsløsning "til store drenge", men for dig har den ikke "fløjet", eller den fungerer næsten i standardkonfigurationen og har ikke ændret dit liv væsentligt. Og også — hvis du ikke planlægger at afsætte en hel medarbejder (eller endda en afdeling) til at overvåge et dashboards i flere timer om dagen eller konfigurere det.
Hvad adskiller okerr
Senere vil jeg vise interessante træk ved okerr, der adskiller det fra nogle andre overvågningsløsninger.
Okerr er en hybrid overvågning
Ved intern overvågning kører der en "agent" på de observerede maskiner, som sender data til overvågningsserveren (for eksempel ledig plads på diske). Ved ekstern overvågning udfører serveren netværkschecks (for eksempel ping eller tilgængelighed af hjemmesiden). Hver tilgang har sine begrænsninger. Okerr bruger begge varianter. Tjek inde i serverne udføres af en meget lille (30Kb) agent eller dine egne skripter og applikationer, mens de netværksmæssige udføres via okerr-sensorer i forskellige lande.
okerr er ikke bare software, men også en service
Serverdelen af enhver overvågning er stor og kompleks, den er svær at installere og konfigurere, den kræver ressourcer. Med okerr kan du installere din egen overvågningsserver (den er gratis og open-source), eller du kan bare bruge klientdelen og benytte dig af vores serverservice. Også gratis.
Hvis overvågning kan kompensere for manglende pålidelighed hos servere og applikationer, opstår et filosofisk spørgsmål – hvem vogter vagten? Hvordan vil overvågningen informere os om et problem, hvis den selv er 'død' af en eller anden grund, enten isoleret eller sammen med andre ressourcer (for eksempel hvis forbindelsen til datacenteret falder?). Ved brug af den eksterne tjeneste okerr – løses dette problem – du vil modtage en alarm, selvom hele datacenteret med dine servere går ned eller angribes af zombier.
Selvfølgelig er der en risiko for, at serveren okerr selv bliver utilgængelig, det er sandt (som det er kendt, bliver 90% pålidelighed altid opnået nemt og 'gratis', 99% kræver minimumsindsats, og hver efterfølgende ni'er bliver eksponentielt sværere). Men for det første er chancerne for dette lavere, og for det andet kan et problem kun gå ubemærket hen, hvis det falder sammen tidsmæssigt med problemer på vores servere. Hvis vi har en pålidelighed på 99,9%, og du har 99,9% (relativt høje tal), så er chancen for en ubemærket fejl 0,1% af 0,1% = 0,0001%. At tilføje tre ni'er til pålideligheden næsten uden indsats og omkostninger – det er ganske godt!
Endnu en fordel ved overvågning som service er, at hostingudbyderen eller webstudiet kan installere en okerr-server hos sig selv og tilbyde adgang til kunderne som en betalt eller gratis tillægstjeneste. Dine konkurrenter har blot hosting og hjemmesider – mens du har pålidelig hosting med overvågning.
Okerr handler om indikatorer.
En indikator er en 'lampe'. Den har to grundlæggende tilstande – grøn (OK) eller rød (ERR). I projektet er der mange grupperede (f.eks. efter servere) indikatorer. På projektets hovedside ser du straks, om alt er grønt (og du kan lukke ned), eller om noget brænder rødt og skal rettes. Ved overgangen mellem disse tilstande sendes der en meddelelse. En gang om dagen, når du har det indstillet, sendes der et resumé af projektet.
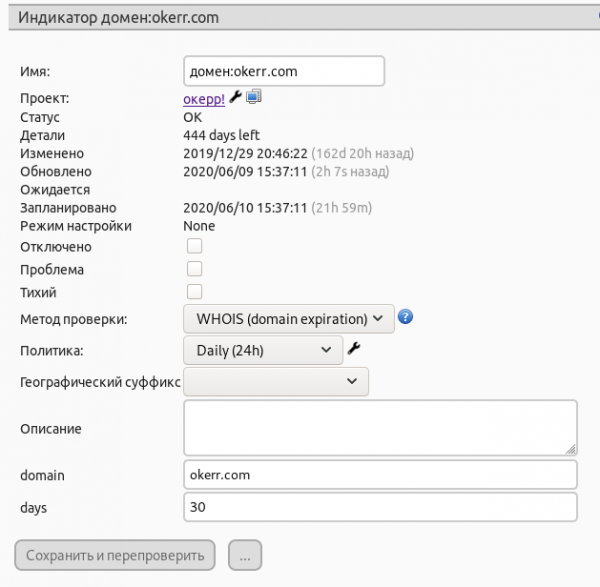
Hver okerr-indikator har indbyggede betingelser, hvorefter den ændrer tilstand (i Zabbix kaldes dette 'trigger'). For eksempel må load average ikke overstige 2 (selvfølgelig kan dette justeres). Og for hver intern kontrol (load average, disk fri, …) er der en watchdog. Hvis vi af en eller anden grund ikke har modtaget en succesfuld bekræftelse til den aftalte tid – registreres der en fejl, og der sendes en alarm.
Den sædvanlige arbejdsrutine hos os omfatter en morgencheck af e-mails, hvor vi blandt andre beskeder ser opsummeringen (denne tid planlægger vi til arbejdstidens start). Hvis alt ser godt ud der, så tager vi os af andre vigtige opgaver (men vi kan hurtigt tjekke dashboardet fra okerr for at sikre, at alt er grønt på dette tidspunkt). Hvis der kommer et alert, reagerer vi.
Selvfølgelig er der mulighed for blot at holde «informations»-indikatorer (for at se netværkets tilstand fra overvågningen), men alt er designet til at gøre det enkelt, let og hurtigt at lave indikatorer til automatisk overvågning og udsendelse af alarmer.
Formålet med at konfigurere okerr er alarmerne, så du kan oprette en indikator på et minut. Den kan have været «søvnende» i et år og blot taget imod opdateringer, og når noget går galt efter et år, så tændes den og sender en alarm. Den tid, du engang brugte på at oprette indikatorer, betaler sig tilbage, da du straks bliver informeret om problemet, før alle andre. Måske fik du endda løst problemet, inden nogen bemærkede det. Hurtigt oprettet tæller ikke som faldet!
Sikkerhed
Det ville være trist, hvis du sætter overvågning op for at øge pålideligheden, men i stedet bliver angrebet gennem den, da der er mange netværkssårbarheder i forskellige overvågningsværktøjer., ).
Agenten (okerrmod fra pakken ), der kører på systemet, er ikke en netværksserver, men en klient. Derfor er der ingen ekstra åbne porte på den overvågede server, klienten fungerer nemt bag en firewall eller NAT, og den er meget svær (jeg vil sige «umulig») at hacke via netværket, da den i princippet ikke lytter på et netværkssocket.
Fuldt overvågningsomfang
Vi har i øjeblikket en regel om, at vi får at vide om alle tekniske problemer fra okerr. Hvis reglen pludselig brydes (okerr ikke advarer om den forestående ankomst (hvis det er muligt) eller om den allerede er indtruffet) — så tilføjer vi kontroller til okerr.
Eksterne kontroller
En ganske typisk sammensætning:
- ping
- http status
- kontrol af gyldighed og friskhed af SSL-certifikatet (advarer, hvis det er ved at udløbe)
- åben TCP-port og banner på den
- http grep (siden [skal] have en bestemt tekst)
- sha1 hash for at opdage ændringer på siden.
- DNS (DNS-posten skal have en bestemt værdi)
- WHOIS (advarer hvis domænet snart udløber)
- Antispam DNSBL (kontrollerer værten med det samme over 50+ antispam-blacklister)
Interne kontroller
Også et ret typisk sæt (men let udvideligt).
- df (ledig plads på diske)
- load average
- opentcp (åbne lytte TCP-sockets — vil notificere, hvis noget er startet eller er gået ned)
- uptime — bare uptime for serveren. Vil notificere, hvis det ændres nedad (dvs. hvis serveren er genstartet)
- client_ip
- dirsize — vi bruger det til at overvåge, når vores rootfs for virtuelle maskiner overskrider den tilladte størrelse, uden at indføre strenge begrænsninger, samt til størrelsen af brugernes hjemmekataloger
- empty og nonempty — overvåger filer, der skal være tomme (eller ikke tomme). For eksempel skal serverens fejllog okerr være tom, og hvis der er én linje, får jeg en notifikation og tjekker. Mens mail.log på mailserveren skal være IKKE tomt (en gang i N minutter efter rotation). Nogle gange kan det være tomt efter systemopdatering, hvor logrotate ikke kunne genstarte rsyslog korrekt.
- linecount — antal linjer i filen (som wc -l). Vi bruger det som en mildere erstatning for empty, når fejlloggen stadig kan vokse, men kun langsomt (for eksempel ved vi, at Googlebot slår på nogle lukkede sider). Der er et loft på 2 linjer over 20 minutter. Hvis det overskrides — vil der komme en alert.
Interesserende interne kontroller
Hvis du har læst 'diagonalt' indtil nu, vil det blive mere interessant at læse nøje.
backups
Overvåger backups i katalogen. Vore backupfiler har navne som "ServerName-20200530.tar.gz". For hver server oprettes en indikator i okerr med ServerName-DATE.tar.gz (den faktiske dato ændres til strengen "DATE"). Der overvåges både tilstedeværelsen af en ny backup og dens størrelse (for eksempel må den ikke være mindre end 90% af den tidligere backup).
Hvad skal der gøres for at den nye backup begynder at blive overvåget, efter vi har startet oprettelsen og lagt den i denne katalog? Ingenting! Det er en meget praktisk tilgang, når man skal gøre 'ingenting', fordi:
- At gøre 'ingenting' er temmelig hurtigt, det sparer tid.
- Det er svært at glemme at gøre 'ingenting'.
- Det er svært at gøre 'ingenting' forkert, med fejltagelse. Ingenting er den mest pålidelige metode.
Hvis nye backupfiler pludselig stopper med at dukke op — vil der komme en alert. Hvis du for eksempel har slukket en af serverne, og dens backups ikke længere skal være der — skal du fjerne indikatoren (via webgrænsefladen eller fra shell via API).
maxfilesz
Holder øje med størrelsen på de største filer (typisk: /var/log/*). Dette gør det muligt at fange uforudsigelige problemer, såsom adgangskodegennembrud eller spamudsendelse via serveren.
runstatus/runline
Dette er to vigtige proxy-moduler til at starte andre programmer på serveren. Runstatus rapporterer til indikatoren om programmet har afsluttet med fejl. For eksempel, i okerr er der ikke (ikke nødvendigt) et modul til at kontrollere, at systemd-tjenester fungerer. Dette gøres gennem runstatus (se nedenfor). Runline rapporterer til serveren den linje, som programmet genererer. For eksempel, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" i konfigurationen skaber Runline på vores server en indikator servername:temp med temperaturniveauet for processoren.
sql
Udfører en numerisk forespørgsel til MySQL og rapporterer resultatet i indikatoren. I en simpel case kan du f.eks. lave "SELECT 1" — dette vil kontrollere, at databasen generelt fungerer.
Men en langt mere interessant anvendelse — f.eks. at spore antallet af ordrer i en webshop. Hvis du ved, at du har omkring 100 ordrer i timen, kan du sætte en minimumsgrænse på 100 eller 80. Så hvis dine salg pludselig falder — får du et alert, og du kan reagere.
Bemærk — det er ligegyldigt, hvilken uforudsigelig årsag der ligger bag:
- Serveren er simpelthen utilgængelig (strømafbrydelse eller netværksproblem), og alerten kom fordi indikatoren "er blevet forældet".
- Serveren er overbelastet, arbejder langsomt, eller pakker går tabt, brugerne har det svært og forlader uden køb.
- Serveren er blevet sorteret ind i spamlister, og e-mails fra den bliver ikke accepteret, brugerne kan ikke registrere sig.
- Budgettet til reklamekampagnen er udløbet, bannere kører ikke.
Der kan være mange årsager, og det kan være umuligt at forudse dem alle, hvilket gør det teknisk svært at overvåge. Men man kan nemt overvåge den endelige parameter (ordrerne) og på baggrund af dem afgøre, at situationen er mistænkelig og fortjener at blive undersøgt nærmere.
Logiske indikatorer
Giver mulighed for at bruge logiske udtryk (Python-syntax) via modulet (). For udtrykket er data fra projektet og dets indikatorer tilgængelige. For eksempel, i afsnittet om SQL-kontrol ovenfor, bemærkede du måske et svagt punkt — om dagen kan vi have op til 100 salg i timen, men om natten — 20, og det er normalt, ikke et problem. Hvordan skal vi håndtere det? Indikatoren vil jo konstant panikke om natten.
Det er muligt at oprette to indikatorer, en dag- og en natindicators. Begge kan være „stille“ (de vil ikke sende meddelelser). Og oprette en logisk indikator, der kræver, at dagindikatoren er OK inden kl. 20:00, og efter kl. 20:00 er det tilstrækkeligt, at natindikatoren er OK.
Et andet eksempel på brug af logisk indikator er eskalering. For eksempel kan projektlederen fravælge alarmer (han har ikke brug for dem, administratorer skal reagere på almindelige problemer), men tilmelde sig en logisk indikator, der bliver rød, hvis nogen indikator i projektet ikke er repareret inden for den tildelte tid.
Derudover er der mulighed for at tildele tilladt tid til arbejde, for eksempel fra 3 til 5 om morgenen. Det bekymrer os ikke, hvis servere og hjemmesider „går ned“ i dette tidsrum. Men kl. 5:00 skal de fungere. Hvis de ikke fungerer på andet tidspunkt - alarm. Den logiske indikator tager også højde for serverreservedele. Hvis du har 5 webservere, så kan administratorer slukke 1-2 servere når som helst. Men hvis der er mindre end 3 ud af 5 servere aktive - vil der være en alarm.
Eksemplerne ovenfor er ikke funktioner i okerr, ikke nogle funktioner, der skal aktiveres og konfigureres. Alle disse funktioner er ikke i okerr, men der er en logisk modul, der gør det muligt at implementere denne funktionalitet (Lidt ligesom i programmeringssprog - hvis vi har aritmetiske operatorer, så har vi ikke brug for en særlig funktion i sproget til beregning af 20% moms, det kan altid laves af en selv til egne behov).
Logisk indikator er muligvis et af de få relativt komplekse emner i okerr, men den gode nyhed er, at du ikke behøver at mestre dem, indtil der opstår behov. Men de udvider væsentligt mulighederne, samtidig med at systemet forbliver relativt simpelt.
Tilføjelse af egne tjek
Jeg vil meget gerne formidle tanken om, at okerr ikke er et sæt af tusind færdige kontroller til alle situationer, men derimod primært en enkel motor med en simpel mulighed for at oprette sine egne kontroller. Oprettelsen af egne kontroller i okerr er ikke en opgave for hackere, medudviklere af systemet eller i det mindste avancerede brugere af okerr, men en håndterbar opgave for enhver administrator, der for en måned siden første gang installerede linux.
Kontrollerne for minimum gør gennem modulet :
Denne linje i konfigurationen vil advare, hvis /bin/true pludselig ikke kan starte eller returnerer ikke 0.
true_OK=\/bin\/trueBare en linje — og så er vi allerede lidt udvidet funktionaliteten i okerr.
Selv sådan en kontrol har sin værdi: hvis din server skulle gå ned — opdateres den tilsvarende indikator på serveren okerr ikke rettidigt, og efter et stykke tid vil der opstå en alarm.
Denne kontrol vil informere dig om, at serveren apache2 er faldet (man ved aldrig…):
apache_OK="systemctl is-active --quiet apache2"Så hvis du ejer et hvilket som helst programmeringssprog, kan du i det mindste skrive shell-scripts — så kan du allerede tilføje dine egne kontroller.
Mere komplekst — du kan skrive (i hvilket som helst sprog) din egen modul til okerrmod. I den enkleste form ser det sådan ud:
#!/usr/bin/python3

print("STATUS: OK")
Det er sandt, ikke så svært? Modulet skal udføre selve kontrollen og returnere resultaterne til STDOUT. Et mere komplekst modul giver for eksempel følgende:
$ okerrmod --dump df
NAME: pi:df-\/
TAGS: df
METHOD: numerical|maxlim=90
DETAILS: 49.52%, 13.9G\/28.2G brugt, 13.0G fri
STATUS: 49.52

NAME: pi:df-\/boot
TAGS: df
METHOD: numerical|maxlim=90
DETAILS: 84.32%, 53.1M\/62.9M brugt, 9.9M fri
STATUS: 84.32
Det opdaterer straks flere indikatorer (adskilt med en tom linje), og om nødvendigt opretter det dem, angiver kontroldetaljer og tags, så de nemt kan findes på dashboardet.
Telegram
Der er en Telegram-bot . Du behøver ikke at fylde din telefon med separate apps (jeg bryder mig heller ikke om, at der for Pjaterechny er én app med kort, for Lenta en anden, for MTS en tredje, og så videre for alle). Én Telegram er nok. Gennem Telegram kan du også modtage alarmer med det samme og tjekke status for projektet samt give en kommando til at genkontrollere alle problematiske indikatorer. Du går ud af teatret\/flyet, ikke har holdt hånden på pulsen i to timer, tænder for telefonen, trykker på én knap i chatbotten, og sikrer dig, at alt er i orden.
Statussider
I vores tid er statussider næsten et must for enhver virksomhed, der har IT, en ansvarlig tilgang til pålidelighed, og som respekterer sine kunder\/brugere.
Forestil dig en situation - en bruger ønsker at gøre noget, se information eller afgive en bestilling, og noget fungerer ikke. Han ved ikke, hvad problemet er, hvem der har ansvaret, og hvornår det bliver løst. Måske har dit firma bare en ikke-fungerende hjemmeside? Eller det gik i stykker for et halvt år siden og vil blive repareret om to år? Men køleskabet skal købes nu, det er allerede i indkøbskurven... Det er helt anderledes, når en person ser, at der er noget galt med dig (i det mindste er det klart, at problemet ikke ligger hos ham), at problemet er blevet opdaget, at I allerede arbejder på det, og måske endda har angivet en omtrentlig tid for løsning. Brugen kan abonnere og få en notifikation på e-mail, når problemet er blevet løst, og han kan gøre det, han ønskede (købe køleskabet).
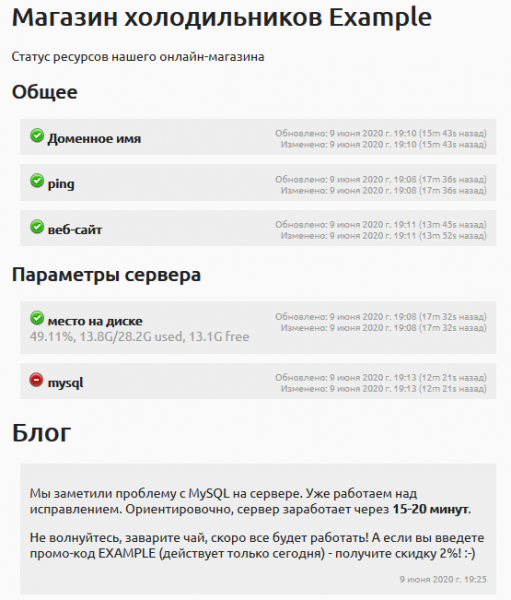
Problemer, downtime - det sker for alle. Men brugere og partnere stoler mere på dem, der er mere gennemsigtige og ansvarligt håndterer dette.
Her er . Her er nogle eksempler på, hvordan disse sider ser ud hos projekterne og . .
Failover
For ikke at gøre denne artikel endnu længere, vil jeg endnu en gang henvise til min tidligere artikel - . Hvis du kan lave en duplikerende server, så har du i princippet ingen lang nedetid med brug af failover - så snart problemet opdages, bliver brugerne automatisk omdirigeret til den fungerende reserve-server. Og jeg synes, det er en meget interessant, markant funktion, der næsten ikke findes andre steder.
Lave systemkrav
For okerr-serverne - bruger vi maskiner med RAM fra 2Gb. For netværkssensorer er selv 512Mb tilstrækkeligt. Klientdelen - er næsten nul. (Pakke vejer 26 Kb, men kræver Python3 og standardbiblioteker). Klienten køre ud fra cron-scriptet, så den har et nul konstant hukommelsesforbrug. Blandt de observerede maskiner har vi sensorer (super-billige VPS'er med 512Mb RAM) og Raspberry Pi. Du kan endda sende opdateringer uden klientdelen ! (se nedenfor)
I lyset af dette - okerr, måske, den mest gratis Overvågningssystemet er fra de eksisterende, for selv at bruge et andet gratis open-source system som Zabbix eller Nagios, skal man allokere ressourcer (server), og det koster penge. Derudover kræver det stadig en vis vedligeholdelse af serveren. Med okerr kan man fjerne denne del. Man kan også vælge ikke at fjerne den og bruge sin egen server — alt efter hvad man foretrækker.
API og integration i eget software
En simpel og åben arkitektur. Okerr har en ret simpel , som er let at arbejde med. Skal der oprettes 1000 indikatorer? Én shell-script på 3-4 linjer klarer det. Skal 1000 indikatorer omkonfigureres? Det er også meget nemt. For eksempel, vi ønsker at genkontrollere alle vores HTTPS certifikater præcist med den russiske sensor:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Indikatoren kan opdateres enten ved at bruge vores klientmodul eller endda uden dette, blot gennem curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Indikatorer kan opdateres direkte fra dit eget program. For eksempel ved at sende heartbeat-signaler, så okerr ved, at det kører, og genererer en alarm, hvis det falder ned eller fryser. Forresten gør komponenterne i okerr netop dette — okerr overvåger sig selv, og problemer i næsten enhver modul vil blive opdaget og generere en fejladvarsel. (Og i tilfælde af dette 'næsten' — de krydstjekkes fra en anden server)
Sådan ser koden (forenklet) ud i vores telegram-bot:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
For opdatering af indikatorer fra Python-programmer — der er et bibliotek , for andre sprog findes der ikke biblioteker, men man kan enten kalde skriptet okerrupdate eller udføre en HTTP-anmodning til okerr-serveren.
Hvordan okerr hjælper os
Okerr har ændret vores liv. Det virkelig. Måske kunne et andet overvågningssystem også have gjort det, men det er let og enkelt at arbejde med okerr, og det har alle de funktioner, vi har brug for (det, der ikke var der — har vi tilføjet). Forresten, hvis der mangler en funktion — spørg, så vil jeg overveje at tilføje den (jeg lover ikke noget, men jeg ønsker, at okerr skal være det bedste overvågningssystem til små-mellemstore projekter). Eller endnu bedre, tilføj det selv — det er nemt.
Vi har formået at leve efter princippet "at finde ud af alle problemer fra okerr". Hvis der pludselig opstår et problem, som vi ikke har hørt om fra okerr - så tilføjer vi en kontrol i okerr. (i dette tilfælde forstår jeg "vi" som brugere af systemet, ikke medudviklere). I starten skete dette ofte, men nu er det blevet meget sjældnere.
Overvågning
Gennem okerr overvåger vi størrelsen på loggene på alle servere. Det er selvfølgelig umuligt at læse hver eneste linje i loggen omhyggeligt, men blot at overvåge væksten i hastigheden giver allerede meget. Gennem dette har vi opdaget spam-udsendelser og brute-force forsøg på passwords, samt når nogle af applikationerne "går amok", hvor de fejler og gentager spørgsmålet gang på gang (hver gang tilføjer de et par linjer i loggen).
SSL-certifikater. Næsten med det samme efter lanceringen begyndte vores kunde at tilbyde sine kunder gratis SSL-certifikater (ca. tusind af dem). Og det viste sig at være et mareridt at administrere! Problemet er, at hjemmesiderne er "levende", kunderne beder jævnligt om ændringer, programmererne laver dem. De kan for eksempel frit flytte hjemmesiden til en anden DocumentRoot. Eller tilføje en ubetinget Rewrite i konfigurationen af virtuel vært. Selvfølgelig bryder den automatiske opdatering af certifikater efter noget sådant. Nu tilføjes alle vores SSL-værter automatisk til okerr gennem et andet nyttigt værktøj fra vores pakke . Vi starter blot a2okerr.py — og hvis der pludselig er dukket op flere nye hjemmesider på serveren - så vises de automatisk i okerr. Hvis certifikatet af en eller anden grund ikke opdateres, er vi i videns om det tre uger før certifikatet udløber, og så finder vi ud af, hvorfor det ikke opdateres, den hund. a2certbot.py fra den samme pakke - det hjælper meget i dette (det kontrollerer straks de mest sandsynlige problemer - og skriver, hvad der har været godt, og hvor der sandsynligvis er problemer).
Vi overvåger udløbsdatoen for alle vores domæner. Og alle vores mailservere, som sender mail - bliver også kontrolleret mod 50+ forskellige blacklister. (Og nogle gange havner de i dem). Forresten, vidste du, at Googles mailservere også er på blacklisterne? Bare for selvtjek har vi tilføjet mail-wr1-f54.google.com til de overvågede servere, og den er faktisk på blacklisten SORBS! (Det siger noget om værdien af "antispamfolk")
Backups – I mentioned earlier how easy it is to keep track of them with okerr. We monitor both fresh backups on our server and (with the help of a separate utility that uses okerr) – the backups we upload to Amazon Glacier. And yes – problems do occasionally arise. That's why we keep an eye on it.
We use an escalation indicator. It shows if a problem hasn't been resolved for a long time. And I sometimes forget about tasks when I'm resolving issues. Escalation is a good reminder, even if you're keeping an eye on things yourself.
Overall, I believe the quality of our work has improved significantly. Downtime is nearly nonexistent (or the client doesn't notice it in time. Just sshhh!), while the amount of work has decreased and the working conditions have become calmer. We have moved from frantic work patching holes with tape to a calm and measured approach, where many problems are anticipated in advance and there's time to prevent them. Even issues that do occur have become easier to fix: firstly, we find out about them before clients start to panic, and secondly, it's often the case that the problem is related to recent work (while fixing one thing, another broke) – which makes it easier to address on the spot.
Here's another case...
Did you know that in the popular Debian 9 (Stretch), a widely used package like phpmyadmin has been in a vulnerable status for many months now? (). When the vulnerability was disclosed, we quickly patched it through various means. However, I set up tracking in okerr for the security-tracker page to know when a proper solution (via SHA1 content hash) is released. A few times, the indicator alerted me when the page changed, but as you can see – it still does not state that the issue has been resolved (since January 2019!). By the way, does anyone know what the issue is that such an important package has remained vulnerable for over a year?
En anden gang i en lignende situation: efter en sårbarhed i SSH skulle alle servere opdateres. Og når man giver en opgave - så skal man kontrollere udførelsen. (Underordnede har en tendens til at misforstå, glemme, forvirre sig, lave fejl). Derfor tilføjede vi først en kontrol af SSH-versionen på alle servere i okerr, og gennem okerr overvågede vi, at opdateringerne blev implementeret på alle servere. (Praktisk! Jeg valgte denne type indikator, og man kan straks se, hvilken version der kører på hvilken server). Da vi var sikre på, at opgaven var udført på alle servere - fjernede vi indikatorerne.
Par gange har der været situationer, hvor et bestemt problem opstår, og så går det lige pludselig væk. (det kender nok alle?). Indtil man bemærker det, indtil man tjekker - og så er der allerede ikke noget at tjekke - alt fungerer godt. Men så går det i stykker igen. Det skete for os, for eksempel med de produkter, vi indlæste i Amazon Marketplace (MWS). På et tidspunkt var de uploadede lagre forkerte (forkerte mængder varer og forkerte priser). Vi fik det løst. Men for at finde ud af det - var det vigtigt at få kendskab til problemet med det samme. Desværre er MWS, ligesom alle Amazons tjenester - lidt langsom, så der var altid et efterslæb, men alligevel - vi formåede i det mindste at opfange forbindelsen mellem problemet og de scripts, der forårsagede det (vi lavede en kontrol, knyttede den til okerr, og tjekkede straks ved modtagelse af en alert).
For nylig tilføjede en stor og dyr europæisk hostingudbyder, som vores kunde bruger, en interessant sag til vores erfaringer. Pludselig forsvandt ALLE vores servere fra radaren! Først opdagede kunden selv (hurtigere end Okerr!), at den hjemmeside, han arbejdede med, ikke kunne åbnes, og han oprettede en ticket om dette. Men ikke kun én hjemmeside, faktisk alle sammen! (Natasha, vi har ødelagt det hele!). Her begyndte Okerr at sende lange beskeder med alle indikatorer, der var tændt. Panik, panik, vi løber rundt (hvad skal man ellers gøre?). Til sidst blev alt genoprettet. Det viste sig, at der var planlagte arbejder i datacentret (gør dette en gang hvert par år), og de skulle selvfølgelig have advaret os. Men et eller andet gik galt, og de glemte at advare. Nå, det er ikke så vigtigt. Men efter genopretning af alt - skal alt jo tjekkes igen! Jeg kan ikke forestille mig, hvordan jeg ville have gjort det manuelt. Okerr testede alt på få minutter. Det viste sig, at størstedelen af serverne blot var midlertidigt utilgængelige, men fungerede. Nogle blev overbelastede, men genstartede også som de skulle. Vi mistede to backups, som ifølge tidsplanen skulle være blevet oprettet og uploadet, mens denne totale katastrofe stod på. Jeg havde ikke engang oprettet dem, det kom en alarm et døgn senere om, at alt var fint, og backups var dukket op. Jeg kan godt lide dette eksempel, fordi Okerr viste sig at være meget nyttigt i en situation, vi ikke havde overvejet på forhånd, men det er også overvågningens opgave — at modstå det uforudsigelige.
Til Okerr-sensorerne bruger vi de billigste hostingtjenester (kvalitet og pålidelighed er ikke vigtige, de forsikrer hinanden). For nylig fandt vi en meget aktiv hostingudbyder til super lave priser, benchmark-resultaterne er fantastiske. Men... nogle gange viser det sig, at udgående forbindelser fra virtualiseringsserveren udføres fra en anden (naboende) IP. Mirakler. Modulet client_ip får ikke den rigtige IP. Og ifølge serverloggene kan man se, at opdateringen også kom fra denne nabo-IP. Vi undersøger det nu med supportteamet. Det er godt, at vi opdagede dette i fredelig tid. Men for eksempel er det ofte sådan, at adgangsrettighederne er defineret gennem en hvidliste af IP'er — og hvis serveren en gang imellem blinker i kort tid — kan man bruge lang tid på at finde dette problem. får ikke den rigtige IP. Og ifølge serverloggene for indikatoren kan man se, at opdateringen også kom fra denne nabo-IP. Vi undersøger det nu med support. Det er godt, at vi opdagede dette i fredelig tid. Men for eksempel er det ofte sådan, at adgangsrettighederne er defineret gennem en hvidliste af IP'er — og hvis serveren en gang imellem blinker kortvarigt — kan det tage lang tid at opsnappe dette problem.
Og så igen — nu vi taler om VPS-hosting — bruger vi altid billige (hetzner, ovh, scaleway). Både benchmark-resultaterne og stabiliteten er meget tilfredsstillende. Vi bruger også det betydeligt dyrere Amazon EC2 til andre projekter. Så, takket være okerr har vi vores velbegrundede mening. Begge falder indimellem. Og jeg vil ikke sige, at vores observationer over en længere periode viser, at de billige hostingløsninger som hetzner er betydeligt mindre stabile end EC2. Så hvis du ikke er bundet af andre funktioner hos Amazon — hvorfor betale mere? 🙂
Hvad nu?
Hvis jeg ikke har skræmt dig væk fra Okerr endnu — så prøv det! Du kan komme ind via dette link til (Klik lige nu!). Men husk — at demokontoen er fælles for alle, så hvis du laver noget — kan andre i den samme konto forstyrre dig. Eller (bedre) registrer dig via linket til — det er enkelt, uden SMS. Hvis du ikke ønsker at bruge din rigtige e-mail — kan du bruge en engangs-e-mail, som mailinator (jeg anbefaler ). Sådanne konti kan blive slettet over tid — men de er fine til test.
Efter registreringen vil du blive tilbudt at gennemgå et træningsforløb (fuldføre nogle ikke særlig svære opgave). De oprindelige grænser er meget lave, men til træning eller én server er de tilstrækkelige. Efter gennemførelsen af træningsforløbet — vil grænserne (for eksempel, det maksimale antal indikatorer) blive hævet.
Fra dokumentationen — først og fremmest til serverdelen og klienten (). Men hvis der er noget, du ikke forstår — skriv til support (at) okerr.com eller efterlad en ticket — vi vil forsøge at løse det hurtigt.
Hvis du vil bruge det seriøst, og disse forhøjede grænser ikke er nok — så skriv også til support, så vi kan hæve dem (gratis).
Vil du installere okerr serveren på din egen server? Her er . Vi anbefaler at installere på en ren virtuel maskine, så du nemt kan gøre det med installationsscriptet. På din egen virtuelle maskine — ingen begrænsninger :-). Og igen, hvis der er noget — vil vi altid gøre vores bedste for at hjælpe.
Vi ønsker, at dette projekt skal flyve, så verden bliver mere pålidelig takket være os. Takket være gratis software og tjenester er verden blevet mere venlig og udvikler sig hurtigere. Kildekoden kan opbevares på gratis GitHub, og man kan bruge gratis Gmail til e-mail. Vi bruger gratis til support. Der er ikke behov for at betale for servere, man skal ikke downloade og konfigurere eller løse forskellige driftsproblemer. Hver ny projekt, hver gruppe — har straks både e-mail, repositories og CRM. Og alt dette er meget kvalitetsfyldt, gratis og tilgængeligt med det samme. Vi ønsker, at det samme skal gælde for overvågning — små virksomheder og projekter skulle kunne bruge Okerr gratis, og selv i fase med opstart og vækst have pålidelighed som store, seriøse projekter.
Kilde: habr.com
