

I 2018 blev begrebet MLOps hurtigt introduceret i professionelle kredse og på relevante konferencer om AI, hvor det hurtigt fik fodfæste i branchen og nu udvikler sig som et selvstændigt område. I fremtiden kan MLOps blive et af de mest eftertragtede områder inden for IT. Hvad er det egentlig, og hvordan anvendes det, lad os se nærmere på det.
Hvad er MLOps
MLOps (sammensmeltning af teknologier og processer inden for maskinlæring og metoder til implementering af udviklede modeller i forretningsprocesser) er en ny måde at samarbejde på mellem repræsentanter fra erhvervslivet, forskere, matematikere, maskinlæringseksperter og IT-ingeniører ved oprettelsen af kunstig intelligens systemer.
Med andre ord er det en måde at omdanne metoder og teknologier fra maskinlæring til et nyttigt værktøj til at løse forretningsudfordringer.
Det er vigtigt at forstå, at produktionskæden begynder længe før udviklingen af modellen. Det første skridt er at definere forretningsopgaven, hypoteser om den værdi, der kan udvindes fra data, og forretningsideen om dens anvendelse.
Selve begrebet MLOps opstod som en analogi til begrebet DevOps anvendt på modeller og teknologier inden for maskinlæring. DevOps er en tilgang til softwareudvikling, der muliggør hurtigere implementering af individuelle ændringer, samtidig med at fleksibilitet og pålidelighed opretholdes gennem en række metoder, som omfatter kontinuerlig udvikling, opdeling af funktioner i en række uafhængige mikrotjenester, automatiseret testning og deployment af individuelle ændringer, global overvågning af systemets ydeevne, samt system til hurtig respons på identificerede fejl og mere.
DevOps definerede softwarelivscyklussen, og der opstod en idé i ekspertmiljøet om at anvende den samme metode på big data. DataOps er et forsøg på at tilpasse og udvide metoden under hensyntagen til de særlige forhold ved opbevaring, transmission og behandling af store datamængder på forskellige og interagerende platforme.
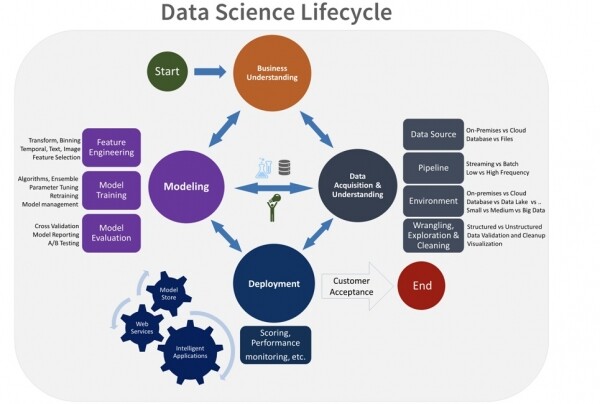
Med fremkomsten af en kritisk masse af maskinlæringsmodeller, der er implementeret i virksomheders forretningsprocesser, er der observeret en stærk lighed mellem livscyklussen for matematiske modeller inden for maskinlæring og livscyklussen for software. Forskellen ligger blot i, at algoritmerne for modellerne skabes ved hjælp af værktøjer og metoder til maskinlæring. Derfor opstod idéen naturligt at anvende og tilpasse de allerede kendte tilgange til softwareudvikling for maskinlæringsmodeller. Således kan følgende nøglefaser identificeres i livscyklussen for maskinlæringsmodeller:
- identifikation af forretningsideen;
- træning af modellen;
- test og implementering af modellen i forretningsprocessen;
- drift af modellen.
Når der i driftsfasen opstår behov for at ændre eller genuddanne modellen med nye data, startes cyklussen forfra — modellen revideres, testes, og en ny version deployeres.
Det er et forbehold. Hvorfor genuddanne og ikke overuddanne? Begrebet "overuddannelse af en model" har en dobbelt betydning: blandt specialister betyder det en fejl i modellen, hvor modellen forudsiger godt og faktisk gentager den forudsagte parameter på træningsdatasættet, men fungerer meget dårligere på et eksternt datasæt. Naturligvis er en sådan model en defekt, da denne fejl forhindrer dens anvendelse.
I denne livscyklus ser det logisk ud at bruge DevOps-værktøjer: automatiseret test, deployment og overvågning, samt at gøre modelberegninger til separate mikrotjenester. Men der er også en række særlige forhold, der forhindrer direkte anvendelse af disse værktøjer uden en ekstra ML-wrapper.
Hvordan får man modeller til at fungere og generere overskud
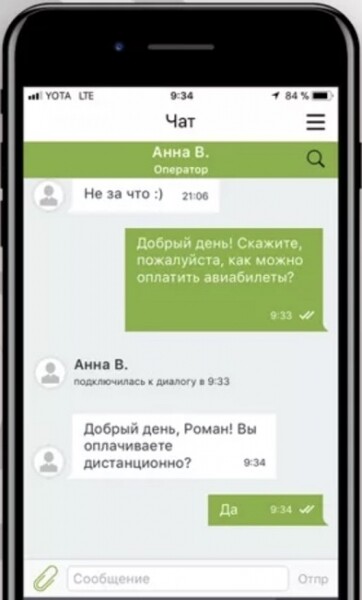
Som et eksempel, hvor vi vil demonstrere anvendelsen af MLOps-tilgangen, vil vi tage den klassiske opgave med at automatisere chat-support for bankprodukter (eller andre produkter). Normalt ser forretningsprocessen for chat-support således ud: en kunde ind-taster en besked med et spørgsmål i chatten og modtager et svar fra specialisten inden for rammerne af et foruddefineret dialogtræ. Automatisering af en sådan chat løses typisk ved hjælp af ekspertbestemte regelsæt, som kan være meget tidskrævende at udvikle og vedligeholde. Effektiviteten af sådan automatisering kan, afhængigt af opgavens kompleksitet, være 20-30%. Det er naturligt at tænke, at det vil være mere fordelagtigt at implementere en kunstig intelligens-modul — en model, der er udviklet ved hjælp af maskinlæring, som:
- kan håndtere et større antal forespørgsler uden operatørens deltagelse (afhængig af emnet kan effektiviteten i nogle tilfælde nå op på 70-80%);
- bedre kan tilpasse sig usædvanlige formuleringer i dialogen - kan identificere hensigten, det reelle ønske fra brugeren baseret på en uklart formuleret forespørgsel;
- kan vurdere, hvornår modellens svar er passende, og hvornår der er tvivl om 'bevidstheden' af dette svar, hvilket kræver at stille et yderligere præciserende spørgsmål eller skifte til en operatør;
- kan automatiseres til at blive videreuddannet (i stedet for en gruppe udviklere, der konstant tilpasser og justerer svarscenarierne, bliver modellen videreuddannet af en Data Science-specialist, der anvender de relevante maskinlæringsbiblioteker).
Hvordan får man en sådan avanceret model til at fungere?
Som med enhver anden opgave skal man, inden man udvikler et sådant modul, først definere forretningsprocessen og formelt beskrive den specifikke opgave, som vi vil løse ved hjælp af maskinlæringsmetoden. Her begynder processen med operationalisering, som er markeret med forkortelsen Ops.
Det næste skridt er, at en Data science-specialist i samarbejde med en dataingeniør vurderer tilgængeligheden og tilstrækkeligheden af data samt forretningshypotesen om, hvorvidt forretningsideen fungerer. De udvikler en prototype af modellen og tester dens faktiske effektivitet. Først efter bekræftelse fra virksomheden kan overgangen fra modelludvikling til integration i systemer, der udfører specifikke forretningsprocesser, begynde. En omfattende plan for implementering, en dyb forståelse af, hvordan modellen vil blive brugt på hvert trin, og hvilken økonomisk effekt den vil have, er grundlæggende i implementeringen af MLOps i virksomhedens teknologiske landskab.
Med udviklingen af AI-teknologier vokser antallet og mangfoldigheden af opgaver, der kan løses ved hjælp af maskinlæring, eksponentielt. Hver sådan forretningsproces repræsenterer et økonomisk besparelse for virksomheden gennem automatisering af arbejdsopgaver på massepositioner (callcenter, kontrol og sortering af dokumenter osv.), det er udvidelsen af kundebasen ved at tilføje nye attraktive og praktiske funktioner, besparelser ved optimal ressourceanvendelse og omfordeling af ressourcer, og meget mere. I sidste ende er hver proces rettet mod at skabe værdi og bør, som følge heraf, generere en bestemt økonomisk effekt. Her er det meget vigtigt klart at formulere forretningsideen og beregne den forventede fortjeneste ved implementeringen af modellen i den samlede værdiskabelsesstruktur i virksomheden. Der opstår situationer, hvor implementeringen af modellen ikke retfærdiggør sig selv, og den tid, som maskinlæringsspecialisterne bruger, kan være meget dyrere end en operatørs arbejdsplads, der udfører denne opgave. Derfor er det nødvendigt at forsøge at identificere sådanne tilfælde tidligt i systemudviklingen af AI.
Derfor begynder modelens profit kun at komme, når forretningsopgaven i processen med MLOps er korrekt formuleret, prioriteterne er fastlagt, og implementeringsprocessen for modellen i systemet er formuleret tidligt i udviklingsforløbet.
Ny proces – nye udfordringer
Et omfattende svar på det principielle spørgsmål om, hvorvidt ML-modeller er anvendelige til at løse opgaver, samt det overordnede spørgsmål om tillid til AI — er en af de centrale udfordringer i udviklingen og implementeringen af MLOps-tilgange. Virksomheder er oprindeligt skeptiske over for implementeringen af maskinlæring i processer — det er vanskeligt at stole på modeller i de situationer, hvor mennesker tidligere har arbejdet. For virksomheder fremstår programmer som en "black box", hvis relevans for svarene endnu skal bevises. Desuden er der strenge krav fra statslige reguleringer inden for banksektoren, telekommunikation og andre områder. Alle systemer og algoritmer, der er implementeret i bankprocesser, er underlagt revision. For at løse denne udfordring og overbevise både virksomheder og regulerende instanser om berettigelsen og korrektheden af svarene fra kunstig intelligens, implementeres overvågningsværktøjer sammen med modellen. Derudover er der en procedure for uafhængig validering, som er obligatorisk for reguleringsmodeller og opfylder kravene fra centralbanken. En uafhængig ekspertgruppe gennemfører en revision af de resultater, som modellen har opnået baseret på inputdata.
Den anden udfordring er vurdering og håndtering af modelrisici ved implementeringen af maskinlæringsmodellen. Hvis selv en person ikke kan svare med hundrede procent sikkerhed på, om det var en hvid eller blå kjole, så har kunstig intelligens også ret til at tage fejl. Det skal også tages i betragtning, at data kan ændre sig over tid, og modellerne skal opdateres for at returnere tilstrækkeligt præcise resultater. For at undgå at forretningsprocessen lider, er det nødvendigt at styre modelrisici og overvåge modellens drift, regelmæssigt opdatere den med nye data.
Men efter den første fase med mistillid opstår en tilbagevirkende effekt. Jo flere modeller der med succes implementeres i processerne, jo større bliver virksomhedens appetit på at anvende kunstig intelligens — der opstår konstant nye opgaver, som kan løses med maskinlæringsmetoder. Hver opgave starter en hel proces, der kræver forskellige kompetencer:
- dataingeniører forbereder og behandler data;
- datascientister anvender værktøjer til maskinlæring og udvikler modeller;
- IT implementerer modellen i systemet;
- ML-ingeniøren bestemmer, hvordan denne model korrekt skal integreres i processen, hvilket IT-værktøj der skal bruges afhængigt af kravene til anvendelsesmetoden for modellen med hensyn til beløbsstrøm, svartid osv.
- ML-arkitekten designer, hvordan det fysisk kan implementeres som en softwareløsning i et industrisystem.
Hele cyklus kræver mange højt kvalificerede specialister. På et bestemt udviklingstrin og niveauet for udbredelse af ML-modeller i forretningsprocesser viser det sig, at det bliver dyrt og ineffektivt at skalere antallet af specialister lineært i forhold til stigende antal opgaver. Derfor opstår spørgsmålet om automatiseringen af MLOps-processen — at definere flere standardklasser af opgaver inden for maskinlæring, udvikle typiske databehandlingspipelines og genskoling af modeller. I det ideelle scenarie kræves der fagfolk, der er lige dygtige i krydsfeltet mellem Big Data, Data Science, DevOps og IT for at løse sådanne opgaver. Derfor er den største udfordring i Data Science-industrien og den største udfordring ved organiseringen af MLOps-processerne manglen på sådanne kompetencer på det nuværende arbejdsmarked. Specialister, der opfylder sådanne krav, er i øjeblikket sjældne på arbejdsmarkedet og værdsættes højt.
Om kompetencer
Teoretisk set kan alle MLOps-opgaver løses med klassiske DevOps-værktøjer uden at ty til en specialiseret rollemodel. Som nævnt tidligere bør data scientist ikke kun være matematiker og specialist i dataanalyse, men også guru for hele pipelinen — det er ham, der står for udviklingen af arkitekturen, programmering af modeller på flere sprog afhængigt af arkitekturen, forberedelse af datavaner og deployment af selve applikationen. Dog tager oprettelsen af den teknologiske infrastruktur, der realiseres i den end-to-end MLOps-proces, op til 80% af arbejdsindsatsen, hvilket betyder, at en kvalificeret matematiker, som en kvalitets Data Scientist, kun vil dedikere 20% af sin tid til sit speciale. Derfor bliver det livsvigtigt at skelne mellem rollerne for specialister, der udfører processen med implementering af maskinlæringsmodeller.
Hvor detaljeret roller skal opdeles, afhænger af virksomhedens størrelse. Det er én ting, når en specialist i en startup fungerer som både ingeniør, arkitekt og DevOps, fordi der kun er én person. Det er helt anderledes i en stor virksomhed, hvor alle udviklingsprocesser er koncentreret om et fåtal af højtuddannede Data Science-specialister, mens programmører eller specialister i databaser, der er mere almindelige og billigere på arbejdsmarkedet, kan tage sig af størstedelen af de rutinemæssige opgaver.
Derfor afhænger grænsen mellem valg af specialister til at sikre MLOps-processen og hvordan operacionalisering af de udviklede modeller er organiseret, direkte heraf hastigheden og kvaliteten af de udviklede modeller, teamets produktivitet og mikroklimaet i det.
Hvad der allerede er gjort af vores team
Vi begyndte for nylig at opbygge struktur for kompetencer og MLOps-processer. Men allerede nu er vores projekter inden for livscyklusstyring af modeller og anvendelse af modeller som en service i MVP-testfase.
Vi har også defineret en optimal struktur for kompetencer og organisationsstruktur for interaktion mellem alle deltagere i processen for en stor virksomhed. Agile-teams er blevet organiseret for at løse opgaver for hele spektret af forretningskunder, og der er etableret interaktionsprocesser med projektteams til oprettelse af platforme og infrastruktur, som danner fundamentet for det byggeri af MLOps.
Spørgsmål til fremtiden
MLOps er et voksende område, der lider af mangel på kompetencer og vil tage fart i fremtiden. Men indtil videre er det bedst at tage udgangspunkt i DevOps-praksisser. Hovedmålet med MLOps er at udnytte ML-modeller mere effektivt til at løse forretningsopgaver. Men der opstår mange spørgsmål i den forbindelse:
- Hvordan kan tiden til at sætte modeller i produktion forkortes?
- Hvordan kan bureaukratiske friktioner mellem teams med forskellige kompetencer reduceres og samarbejdsvilligheden øges?
- Hvordan kan modeller overvåges, versioner administreres og effektiv overvågning organiseres?
- Hvordan skaber man en virkelig cirkulær livscyklus for moderne ML-modeller?
- Hvordan kan processen med maskinlæring standardiseres?
Hvor hurtigt MLOps helt kan realisere sit potentiale, afhænger i høj grad af svarene på disse spørgsmål.
Kilde: habr.com
