

Vi i Badoo overvåger konstant nye teknologier og vurderer, om de skal anvendes i vores system. Vi ønsker at dele en af disse undersøgelsers resultater med samfundet. Den handler om Loki — et system til logaggregatering.
Loki er en løsning til opbevaring og visning af logs; denne stak tilbyder også et fleksibelt system til analyse af logs og sending af data til Prometheus. I maj blev der udgivet en ny opdatering, som skaberne promoverer aktivt. Vi er interesserede i, hvad Loki kan, hvilke funktioner det tilbyder, og i hvilken grad det kan fungere som et alternativ til ELK — den stak vi bruger nu.
Hvad er Loki
Grafana Loki er et sæt komponenter til et fuldt funktionelt system til håndtering af logs. I modsætning til andre lignende systemer er Loki baseret på ideen om kun at indeksere metadata for logs — labels (lige som i Prometheus), mens selve logs komprimeres ved siden af i separate chunks.
,
Før vi går videre til beskrivelsen af, hvad man kan gøre med Loki, vil jeg gerne forklare, hvad der menes med "ideen om kun at indeksere metadata". Lad os sammenligne Lokis tilgang med den traditionelle metode til indeksering, såsom Elasticsearch, ved at se på et eksempel med en linje fra nginx-loggen:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Traditionelle systemer parser hele linjen, inklusive felter med mange unikke værdier som user_id og item_id, og gemmer alt i store indekser. Fordelen ved denne tilgang er, at man hurtigt kan udføre komplekse forespørgsler, da næsten alle data er i indekset. Men dette medfører, at indekset bliver stort, hvilket kræver meget hukommelse. Resultatet er, at det fuldtekstede indeks af logs er sammenligneligt i størrelse med selve logs. For at kunne søge hurtigt i det, skal indekset være indlæst i hukommelsen. Jo flere logs, jo hurtigere vokser indekset, og jo mere hukommelse bruger det.
Loki's tilgang kræver, at der kun udtrækkes de nødvendige data fra strengen, hvor antallet af værdier ikke er stort. På den måde får vi en lille indeks og kan søge data ved at filtrere dem efter tid og indekserede felter, og derefter scanne de resterende med regulære udtryk eller substring-søgning. Processen ser ikke ud til at være den hurtigste, men Loki opdeler forespørgslen i flere dele og udfører dem parallelt, hvilket behandler store datamængder på kort tid. Antallet af shards og parallelle forespørgsler kan konfigureres, således at mængden af data, der kan behandles pr. tidsenhed, er lineært afhængig af antallet af tilegnede ressourcer.
Denne afvejning mellem et stort hurtigt indeks og et lille indeks med parallel fuld scanning gør det muligt for Loki at kontrollere systemomkostningerne. Det kan fleksibelt konfigureres og udvides i henhold til behov.
Loki-stakken består af tre komponenter: Promtail, Loki, Grafana. Promtail indsamler logs, behandler dem og sender dem til Loki. Loki opbevarer dem. Grafana kan forespørge data fra Loki og vise dem. Generelt kan Loki ikke kun bruges til opbevaring af logs og søgning i dem. Hele stakken giver store muligheder for behandling og analyse af de indkommende data ved hjælp af Prometheus-metoden.
Beskrivelse af installationsprocessen kan findes .
Søgning i logs
Du kan søge i logs i det specielle Grafana-interface — Explorer. Tilmeldings sproget LogQL anvendes, som ligner PromQL, der anvendes i Prometheus. I princippet kan det betragtes som en distribueret grep.
Søgegrænsefladen ser således ud:
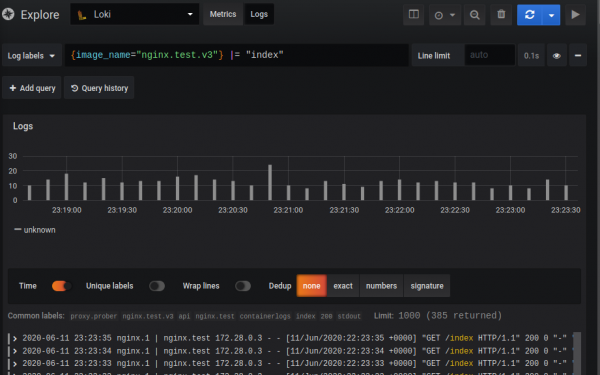
Selve forespørgslen består af to dele: selector og filter. Selector er søgningen i de indekserede metadata (labels), der er tildelt logs, mens filter er søgeordet eller regex, der bruges til at filtrere pladerne, der bestemmes af selector. I det angivne eksempel: I de krøllede parenteser — selector, alt hvad der følger — filter.
{image_name="nginx.promtail.test"} |= "index"På grund af den måde, Loki fungerer på, kan der ikke foregå forespørgsler uden en selector, men labels kan gøres så generelle som ønskes.
Selector er key-value værdier i krøllede parenteser. Du kan kombinere selectors og angive forskellige søgekriterier ved hjælp af operatorerne =, != eller regulære udtryk:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Finder logs with the label instance, having the values kafka-2, kafka-3, and excluding dev
En filter er en tekst eller regex, der filtrerer alle data indhentet af vælgeren.
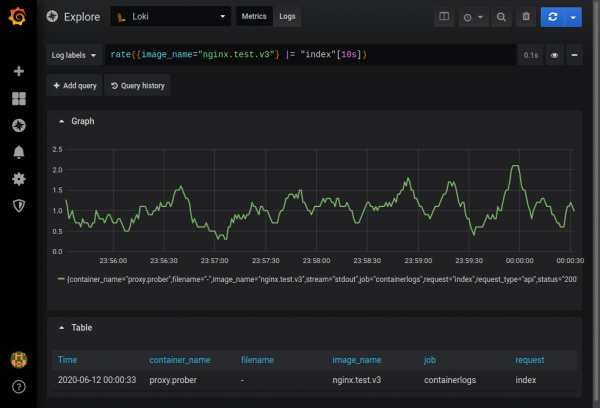
Der er mulighed for at generere ad-hoc grafer baseret på de indsamlede data i metrics-tilstand. For eksempel kan man finde frekvensen af forekomster i nginx-logs, der indeholder strengen index:
En komplet beskrivelse af funktionerne kan findes i dokumentationen .
Log Parsing
Der er flere måder at indsamle logs på:
- Ved hjælp af Promtail, den standardkomponent til indsamling af logs.
- Direkte fra docker-containeren ved hjælp af
- Brug Fluentd eller Fluent Bit, som kan sende data til Loki. I modsætning til Promtail har de færdige parsere til stort set alle typer logs og kan også håndtere multiline-logs.
Normalt bruges Promtail til parsing. Det udfører tre opgaver:
- Finder datakilder.
- Vedhæfter labels til dem.
- Sender data til Loki.
I øjeblikket kan Promtail læse logs fra lokale filer og fra systemd journal. Den skal installeres på hver maskine, hvor logs indsamles.
Der er integration med Kubernetes: Promtail finder automatisk tilstanden af klyngen via Kubernetes REST API og indsamler logs fra noden, servicen eller pod'en, samtidig med at den vedhæfter labels baseret på metadata fra Kubernetes (navn på pod', filnavn osv.).
Det er også muligt at vedhæfte labels baseret på data fra loggen ved hjælp af Pipeline. Promtail-pipeline kan bestå af fire typer faser. Mere detaljeret findes i , her vil jeg også nævne nogle nuancer.
- Parsing stages. Dette er en RegEx og JSON-fase. På dette stadie ekstrakterer vi data fra logs til den såkaldte 'extracted map'. Data kan udtrækkes fra JSON ved blot at kopiere de ønskede felter til den extracted map, eller ved hjælp af regulære udtryk (RegEx), hvor 'named groups' 'mapes' til extracted map. Den extracted map repræsenterer et key-value lager, hvor key er feltnavnet, og value er dets værdi fra logs.
- Transform stages. Denne fase har to muligheder: transform, hvor vi definerer transformationsregler, og source – datakilden til transformation fra extracted map. Hvis der ikke er et felt i extracted map, vil det blive oprettet. Dermed kan vi oprette labels, der ikke er baseret på extracted map. På dette stadie kan vi manipulere data i extracted map ved at bruge et ret kraftfuldt . Derudover skal man huske, at extracted map helt indlæses under parsing, hvilket giver mulighed for for eksempel at kontrollere værdien i den: “{{if .tag}tag value exists{end}}”. Template understøtter betingelser, løkker og nogle strengfunktioner som Replace og Trim.
- Handlingsfaser. I denne fase kan man gøre noget med det udtrukne:
- Opret en label fra extracted data, som vil blive indekseret af Loki.
- Ændre eller indstille tidspunktet for hændelsen fra loggen.
- Ændre dataene (logtekst), der skal sendes til Loki.
- Oprette metrikker.
- Filtreringsfaser. Match-fasen, hvor man enten kan sende unødvendige poster til /dev/null, eller lede dem til videre behandling.
Jeg vil vise, hvordan man kan parsere logs ved hjælp af Promtail på et eksempel med almindelige nginx-logs.
Til testen tager vi en modificeret version af nginx jwilder/nginx-proxy:alpine som nginx-proxy og en lille daemon, der kan spørge sig selv via HTTP. Daemonen har flere endpoints, som den kan give svar i forskellige størrelser, med forskellige HTTP-statusser og med forskellig latens.
Vi vil samle logs fra Docker-containere, som kan findes på stien /var/lib/docker/containers//-json.log
I docker-compose.yml konfigurerer vi Promtail og angiver stien til konfigurationen:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Vi tilføjer stien til logs i promtail.yml (i konfigurationen er der en mulighed "docker", som gør det samme i én linje, men det ville ikke være så klart):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # kun for linux
Når denne konfiguration aktiveres, vil logs fra alle containere blive sendt til Loki. For at undgå dette, ændrer vi indstillingerne for den testende nginx i docker-compose.yml — tilføjer loggér feltet tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Vi redigerer promtail.yml og konfigurerer Pipeline. Logs af følgende type kommer ind:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /api/index HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.096"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /200 HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.000"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Pipeline-fase:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Vi udtrækker fra den indkommende JSON felterne stream, attrs, attrs.tag (hvis de findes) og lægger dem i extracted map.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Hvis feltet tag blev lagt i extracted map, bruger vi regex til at udtrække navnene på billedet og containeren.
 - labels:
     image_name:
     container_name:
Vi tildeler etiketter. Hvis der findes nøglerne image_name og container_name i extracted data, vil deres værdier blive tildelt de tilsvarende etiketter.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Vi kasserer alle logs, hvor de tildelte etiketter image_name og container_name ikke er fundet.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
For alle logs, hvor image_name er nginx.promtail.test, udtrækker vi feltet log fra den oprindelige log og lægger det i extracted map med nøglen row.
  - regex:
         # suppress forego colors
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Vi renser indgangsstrengen med regulære udtryk og udtrækker nginx virtual host og nginx loglinje.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Vi parser nginx-log med regulære udtryk.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
Vi analyserer request_url. Ved hjælp af regex bestemmer vi anmodningens formål: til statiske filer, fotos, API, og tildeler den tilsvarende nøgle i extracted map.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Ved hjælp af betingede operatorer i Template tjekker vi de tildelte felter i extracted map og sætter de nødvendige værdier for feltet request_type: photo, static, API. Vi tildeler other, hvis det ikke lykkes. Nu indeholder request_type anmodningstypen.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Vi sætter etiketterne api_request, virtual_host, request_type og status (HTTP status) baseret på hvad der er blevet lagt i extracted map.
       - output:
           source: nginx_log_row
Vi ændrer output. Nu sendes den rensede nginx-log fra extracted map til Loki.
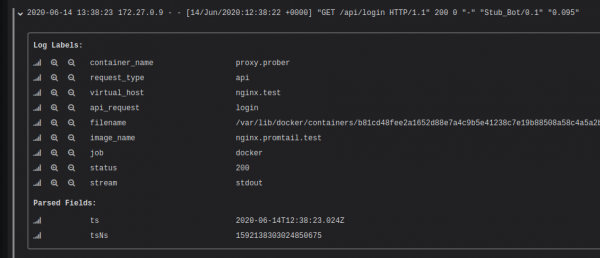
Efter at have kørt den angivne konfiguration kan man se, at hver post er blevet tildelt etiketter baseret på dataene fra loggen.
Det skal bemærkes, at udtrækning af etiket med et stort antal værdier (cardinalitet) kan væsentligt nedsætte ydeevnen af Loki. Det betyder, at man ikke bør placere user_id i indexet. Læs mere om dette i artiklen “”. Men det betyder ikke, at man ikke kan søge efter user_id uden indekser. Man skal bruge filtre i søgningen (f.eks. 'grep' i dataene), mens indekset fungerer som en identifikator for strømmen.
Visning af logs
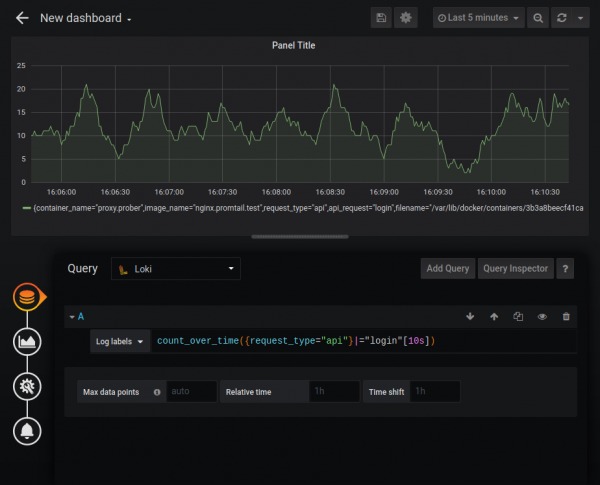
Loki kan fungere som en datakilde for diagrammer i Grafana ved at bruge LogQL. Følgende funktioner understøttes:
- rate — antal poster per sekund;
- count over time — antal poster inden for et givet interval.
Derudover er der aggregerende funktioner som Sum, Avg og andre. Man kan lave relativt komplekse diagrammer, for eksempel et diagram over antal HTTP-fejl:
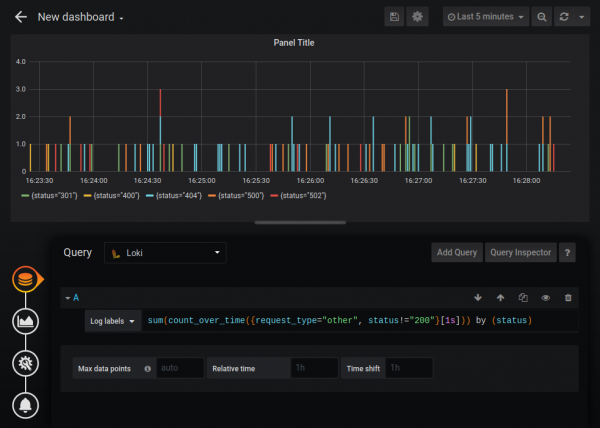
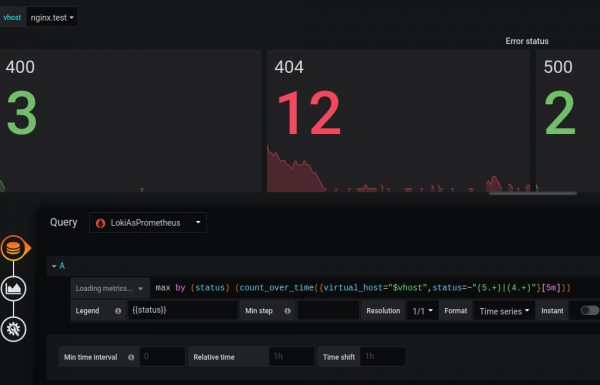
Den standard datakilde, Loki, er noget begrænset i funktionalitet sammenlignet med datakilden Prometheus (for eksempel kan man ikke ændre legenden), men Loki kan tilsluttes som en kilde af typen Prometheus. Jeg er ikke sikker på, at dette er dokumenteret adfærd, men ifølge udviklernes svar “”, for eksempel er dette helt legitimt, og Loki er fuldt kompatibel med PromQL.
Vi tilføjer Loki som datakilde af typen Prometheus og tilføjer URL /loki:

Og man kan lave diagrammer, som hvis vi arbejdede med målinger fra Prometheus:
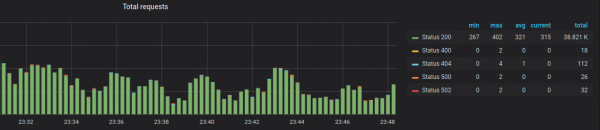
Jeg tror, at forskellen i funktionaliteten er midlertidig, og udviklerne vil rette det i fremtiden.
Målinger
I Loki er der mulighed for at udtrække numeriske målinger fra logs og sende dem til Prometheus. For eksempel findes der i nginx-loggen antal bytes på svaret, samt under bestemte modifikationer af den standard logformat, også den tid i sekunder, der var nødvendig for svaret. Disse data kan udtrækkes og sendes til Prometheus.
Vi tilføjer endnu et afsnit i promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "respons tid ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "respons byte sum"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "respons byte count"
           source: bytes_out
           config:
             action: inc
Muligheden giver dig mulighed for at definere og opdatere målinger baseret på data fra den udtrukne kort. Disse målinger sendes ikke til Loki - de vises ved Promtail /metrics endpointet. Prometheus skal konfigureres til at modtage data, der er opnået på dette stadium. I det angivne eksempel for request_type="api" indsamler vi en histogrammetrik. Med denne type målinger er det nemt at få percentiler. For statiske filer og billeder indsamler vi summen af bytes og antallet af rækker, hvor vi modtog bytes, for at beregne gennemsnitsværdien.
Læs mere om målingerne .
Åbn porten på Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
Sørg for, at målingerne med præfikset promtail_custom er dukket op:
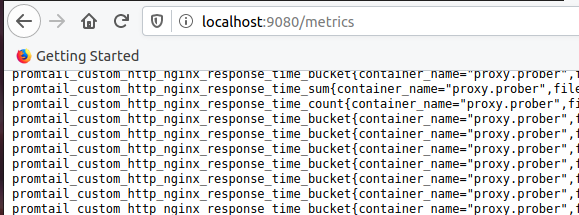
Konfigurer Prometheus. Tilføj job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
Og tegn grafen:
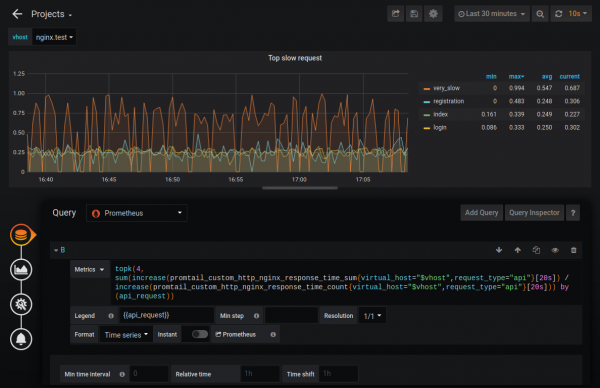
På denne måde kan man finde for eksempel de fire langsomste forespørgsler. Også for disse målinger kan man opsætte overvågning.
Skalering
Loki kan køre i både enkelt tilstand (single binary mode) og i sharded tilstand (horizontally-scalable mode). I sidstnævnte tilfælde kan den gemme data i skyen, idet chunks og indeks opbevares separat. I version 1.5 er der implementeret mulighed for at gemme dem på ét sted, men det anbefales ikke at bruge det i produktion endnu.
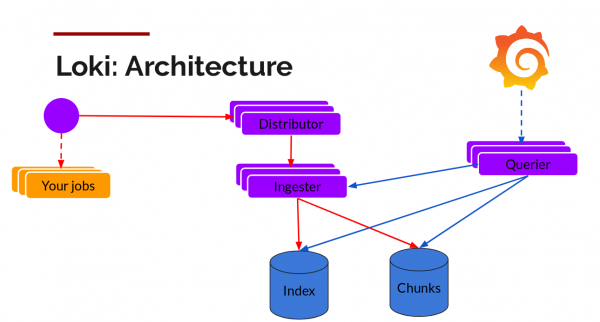
Chunks kan gemmes i S3-kompatible opbevaringssystemer, mens indeks kan gemmes i horisontalt skalerbare databaser: Cassandra, BigTable eller DynamoDB. Andre dele af Loki - Distributors (til skriveoperationer) og Querier (til forespørgsler) - er stateless og kan også skaleres horisontalt.
På DevOpsDays Vancouver 2019 nævnte en af deltagerne Callum Styan, at med Loki har hans projekt petabyte store logfiler med en indeksstørrelse på mindre end 1% af den samlede størrelse: “”.
Sammenligning af Loki og ELK
Indeksstørrelse
For at teste den opnåede indeksstørrelse brugte jeg loggene fra nginx-containeren, som pipeline-eksemplet ovenfor blev konfigureret til. Logfilen indeholdt 406.624 linjer med en samlet størrelse på 109 MB. Logs blev genereret i løbet af en time, med cirka 100 poster pr. sekund.
Eksempel på to linjer fra loggen:
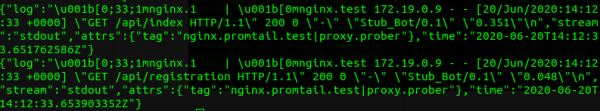
Ved indeksering af ELK gav dette en indeksstørrelse på 30,3 MB:
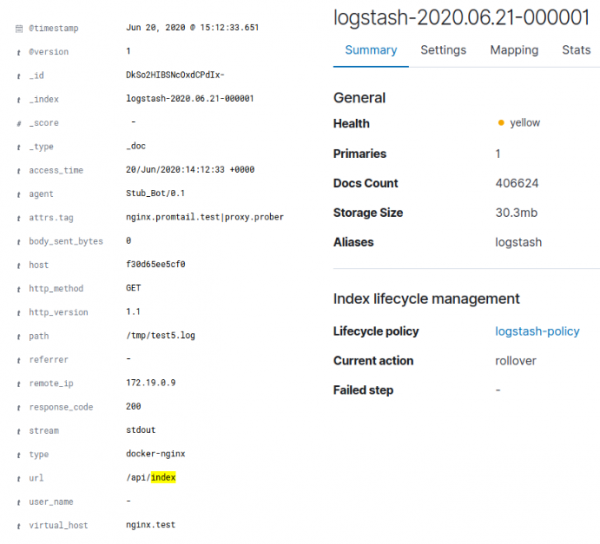
I tilfælde af Loki gav det cirka 128 Kb indeks og cirka 3,8 Mb data i chunks. Det skal bemærkes, at loggen var kunstigt genereret og ikke havde stor datavarianter. En simpel gzip på den oprindelige Docker JSON-log med data gav en kompression på 95,4%, og da der kun blev sendt en renset nginx-log til selve Loki, er komprimeringen til 4 Mb forståelig. Det samlede antal unikke værdier for Loki-etiketter var 35, hvilket forklarer den lille størrelse på indekset. For ELK blev loggen også renset. Således komprimerede Loki de oprindelige data med 96%, mens ELK komprimerede med 70%.
Hukommelsesforbrug
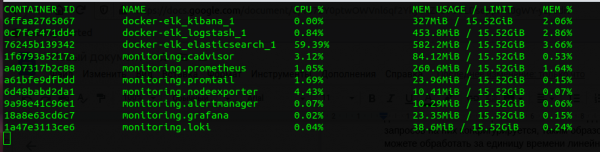
Sammenligner man hele Prometheus- og ELK-stakken, "spiser" Loki flere gange mindre. Det er klart, at en service på Go forbruger mindre end en service på Java, og sammenligningen mellem JVM Heap Elasticsearch og den tildelte hukommelse til Loki er ikke korrekt, men det skal nævnes, at Loki bruger meget mindre hukommelse. Dens fordel hvad angår CPU er ikke så åbenlys, men den er også til stede.
Hastighed
Loki "spiser" logs hurtigere. Hastigheden afhænger af mange faktorer - hvilken slags logs, hvor sofistikeret vi parser dem, netværk, disk osv. - men den er klart højere end hos ELK (i min test var den cirka dobbelt så hurtig). Dette skyldes, at Loki lægger langt mindre data i indekset, og dermed bruger mindre tid på indeksering. Med hensyn til søgehastigheden er situationen modsat: Loki bremser betydeligt ved data, der overstiger flere gigabyte, mens søgehastigheden hos ELK ikke afhænger af datastørrelsen.
Søgning i logs
Loki er betydeligt underlegen ELK hvad angår søgemuligheder i logs. Grep med regulære udtryk er en stærk ting, men det er underlegent en voksen database. Manglen på range-forespørgsler, aggregation kun efter etiketter, og umuligheden af at søge uden etiketter - alt dette begrænser os i at finde interessant information i Loki. Det betyder ikke, at man ikke kan finde noget med Loki, men det definerer flowet af arbejdet med logs, hvor man først finder problemet på graferne i Prometheus, og derefter søger man efter, hvad der skete i logs baseret på disse etiketter.
Interface
For det første er det flot (undskyld, kunne ikke lade være). Grafana har et behageligt grænseflade, men Kibana er langt mere funktionel.
Fordele og ulemper ved Loki
Fordele inkluderer, at Loki integreres med Prometheus, hvilket betyder, at vi får metrics og alerting out of the box. Det er praktisk til indsamling og opbevaring af logs fra Kubernetes Pods, da det har arvet service discovery fra Prometheus og automatisk tilføjer labels.
Ulemperne inkluderer svag dokumentation. Jeg opdagede nogle ting, som specialfunktioner og muligheder i Promtail, kun ved at studere koden, hvilket heldigvis er open-source. En anden ulempe er begrænsede parsing-muligheder. For eksempel kan Loki ikke parse multilinet logs. Desuden kan man nævne, at Loki er en relativt ung teknologi (version 1.0 blev udgivet i november 2019).
Konklusion
Loki er en teknologi, der er 100% interessant og egner sig til små og mellemstore projekter, hvilket muliggør løsning af mange opgaver inden for log aggregating, log søgning, overvågning og log analyse.
Vi bruger ikke Loki i Badoo, da vi har en ELK-stack, som vi er tilfredse med og som gennem årene er blevet beriget med forskellige skræddersyede løsninger. For os er log-søgning en udfordring. Med næsten 100 GB logs om dagen er det vigtigt for os at kunne finde alt og lidt mere og gøre det hurtigt. Til opbygning af grafer og overvågning bruger vi andre løsninger, der er tilpasset vores behov og er integreret med hinanden. Loki-stakken har betydelige fordele, men den vil ikke give os mere, end vi allerede har, og dens fordele vil ikke opveje omkostningerne til migrering.
Og selvom det efter undersøgelsen blev klart, at vi ikke kan bruge Loki, håber vi, at dette indlæg vil hjælpe dig i dit valg.
Repositoryet med koden, der blev brugt i artiklen, findes .
Kilde: habr.com
