

For nogen tid siden stod vi overfor spørgsmålet om valg af ETL-værktøj til arbejde med Big Data. Den tidligere anvendte løsning, Informatica BDM, tilfredsstillede os ikke på grund af dens begrænsede funktionalitet. Dens brug blev reduceret til et framework til at køre spark-submit kommandoer. Der var ikke så mange alternativer på markedet, der i princippet kunne arbejde med det datavolumen, vi står overfor dagligt. I sidste ende valgte vi Ab Initio. Under pilottestene viste produktet en meget høj databehandlinghastighed. Der er næsten ingen information om Ab Initio på russisk, derfor besluttede vi at dele vores erfaring på Habr.
Ab Initio har mange klassiske og usædvanlige transformationer, hvis kode kan udvides med det eget sprog PDL. For små virksomheder vil et så kraftigt værktøj sandsynligvis være overkill, og de fleste af dets funktioner kan vise sig at være dyre og ubenyttede. Men hvis dine skalaer nærmer sig Sberbank-niveau, kan Ab Initio være interessant for dig.
Det hjælper virksomheder globalt med at ophobe viden og udvikle økosystemet, mens det giver udvikleren mulighed for at forbedre sine færdigheder inden for ETL, styrke sine kendskaber til shell, giver mulighed for at lære PDL-sproget, giver et visuelt overblik over indlæsningsprocesserne og forenkler udviklingen takket være det store antal funktionelle komponenter.
I dette indlæg vil jeg fortælle om mulighederne i Ab Initio og give sammenlignende karakteristika for dets arbejde med Hive og GreenPlum.
- Beskrivelse af MDW-frameworket og arbejdet med dens tilpasning til GreenPlum
- Sammenlignende karakteristika for ydelsen af Ab Initio ved arbejde med Hive og GreenPlum
- Ab Initios arbejde med GreenPlum i Near Real Time-tilstand
Funktionaliteten af dette produkt er meget omfattende og kræver en del tid til at blive sat i standen. Men med de rette færdigheder og de korrekte ydeevneindstillinger kan resultaterne af databehandlingen være ganske imponerende. Brug af Ab Initio kan give udvikleren en interessant erfaring. Det er et nyt perspektiv på ETL-udvikling, en hybrid mellem et visuelt miljø og udviklingen af indlæsninger på et script-lignende sprog.
Virksomheder udvikler deres økosystemer, og dette værktøj kommer på et meget passende tidspunkt. Med Ab Initio kan man samle viden om den aktuelle forretning og bruge denne viden til at udvide gamle og åbne nye forretninger. Alternativer til Ab Initio inkluderer de visuelle udviklingsmiljøer Informatica BDM og de ikke-visuelle miljøer – Apache Spark.
Beskrivelse af Ab Initio
Ab Initio, ligesom andre ETL-værktøjer, er et sæt produkter.
Ab Initio GDE (Graphical Development Environment) er et miljø for udviklere, hvor de konfigurerer datatransformationer og forbinder dem i datastrømme i form af pile. Et sæt af sådanne transformationer kaldes et graf:
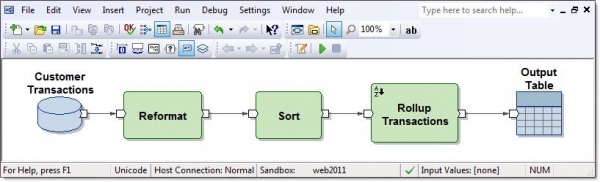
Ind- og udgangsforbindelser af funktionelle komponenter er porte og indeholder felter beregnet inden for transformationerne. Flere grafer, forbundet med strømme i form af pile i rækkefølge af deres udførelse, kaldes et plan.
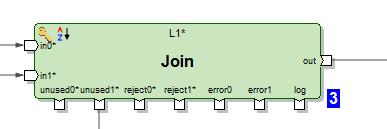
Der er flere hundrede funktionelle komponenter, hvilket er meget. Mange af dem er specialiserede. Mulighederne for klassiske transformationer i Ab Initio er bredere end i andre ETL-værktøjer. For eksempel har Join flere udgange. Udover resultatet af sammensmeltning af datasæt kan man også få optagelser af indgående datasæt, som ikke kunne forbindes. Man kan også få rejects, errors og en log over transformationens arbejde, som kan læses i denne graf som en tekstfil og behandles af andre transformationer:
Eller man kan for eksempel materialisere datamodtageren som en tabel og i denne graf læse data fra den.
Der er originale transformationer. For eksempel fungerer transformationen Scan på en måde, der ligner analytiske funktioner. Der er transformationer med sigende navne: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB osv. Grafer kan bruge parametre ved kørselstid, herunder muligheden for at overføre parametre fra operativsystemet eller til operativsystemet. Filer med et klart sæt af parametre, der skal overføres til grafen, kaldes parameter sets (psets).
Som det siges, har Ab Initio GDE sit eget repository, kaldet EME (Enterprise Meta Environment). Udviklere har mulighed for at arbejde med lokale versioner af koden og lave check in af deres udviklinger i det centrale repository.
Det er muligt at klikke på enhver forbindelse af transformationen af grafen under eller efter kørsel og se på de data, der er gået mellem disse transformationer:
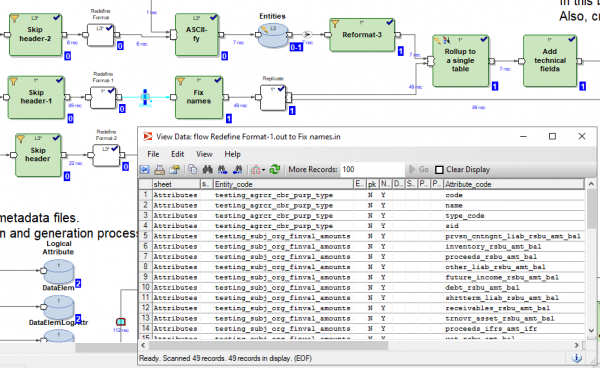
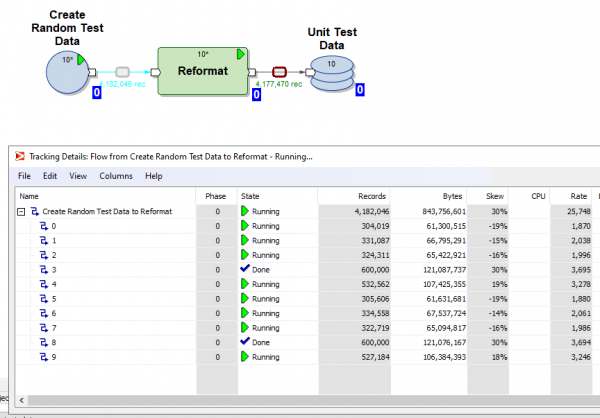
Der er også mulighed for at klikke på enhver strøm og se tracking details – hvor mange paralleller transformationen arbejdede i, hvor mange rækker og bytes der blev indlæst i hvilken af parallellerne:
Det er muligt at opdele udførelsen af grafen i faser og markere, at nogle transformationer skal udføres først (i nulfasen), de næste i første fase, de næste i anden fase osv.
For hver transformation kan man vælge en såkaldt layout (hvor den vil blive udført): uden paralleller eller i parallelle strømme, hvis antal kan angives. De midlertidige filer, som Ab Initio opretter under arbejdet med transformationer, kan placeres både i filsystemet server, såvel som i HDFS.
I hver transformation baseret på standard skabelon kan man oprette sit eget script i PDL-sproget, som minder lidt om shell.
Med PDL-sproget kan du udvide funktionaliteten af transformationer og specifikt generere vilkårlige kodefragmenter dynamisk (under kørsel) afhængig af runtime-parameterne.
Derudover er integrationen med OS gennem shell godt udviklet i Ab Initio. Specifikt i Sberbank anvendes linux ksh. Man kan udveksle variabler med shell og bruge dem som parameter i grafen. Man kan også kalde udførelsen af Ab Initio-grafen fra shell og administrere Ab Initio.
Udover Ab Initio GDE leveres mange andre produkter. Der er eget Co>Operation System, der hævder at være et operativsystem. Der er Control>Center, hvor man kan planlægge og overvåge indlæsningsstrømme. Der er produkter til udvikling på et mere primitivt niveau end hvad Ab Initio GDE tillader.
Beskrivelse af MDW-frameworket og arbejdet med dens tilpasning til GreenPlum
Sammen med sine produkter leverer leverandøren produktet MDW (Metadata Driven Warehouse), som er en konfigureringsværktøj til grafer designet til at hjælpe med typiske opgaver i datalagring eller data vaults.
Det indeholder brugerdefinerede (projektspecifikke) metadata-parsere og færdige kodegeneratorer “out of the box”.
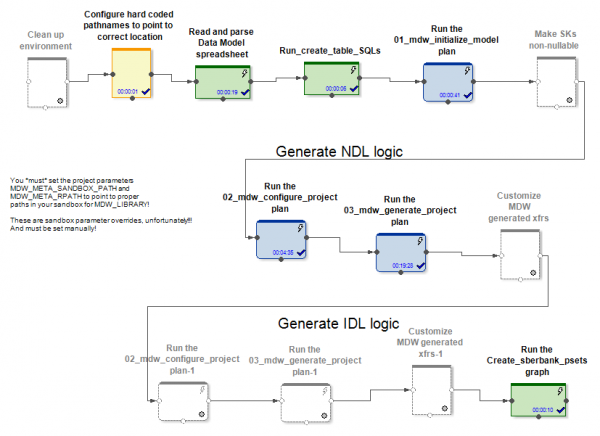
MDW modtager en datamodel, en konfigurationsfil til opsætning af forbindelse til databasen (Oracle, Teradata eller Hive) samt nogle andre indstillinger. Den projektspecifikke del, for eksempel, implementerer modellen i databasen. Produktets standarddel genererer grafer og konfigurationsfiler til dem ved indlæsning af data i modeltabellerne. I denne proces oprettes der grafer (og psets) til flere tilstande af indledende og inkrementel opdatering af enheder.
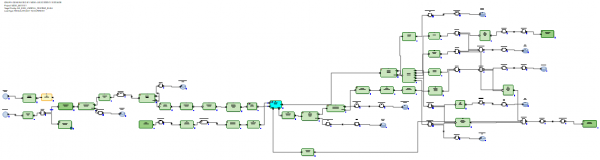
I tilfælde af Hive og RDBMS genereres forskellige grafer til indledende og inkrementel opdatering af data.
I tilfælde af Hive kombineres de modtagne delta-data med de data, der allerede var i tabellen før opdateringen, ved hjælp af Ab Initio Join. Dataopladere i MDW (både i Hive og RDBMS) indsætter ikke kun de nye data fra deltaen, men afslutter også datavaliditetsperioderne for de primære nøgler, som deltaen kom ind for. Desuden skal den uændrede del af dataene skrives om igen. Men det er nødvendigt, da Hive ikke har delete- eller update-operationer.
I tilfælde af RDBMS ser graferne for inkrementel opdatering af data mere optimale ud, fordi RDBMS har reelle opdateringsmuligheder.
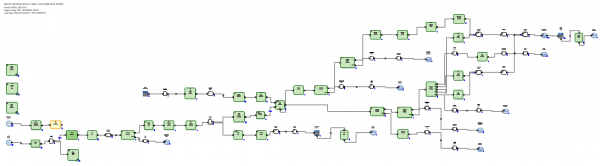
Den ankomne delta indlæses i en midlertidig tabel i databasen. Herefter forbindes deltaen med de data, der var i tabellen før opdateringen. Dette gøres ved hjælp af SQL via en genereret SQL-forespørgsel. Herefter indsættes de nye data fra deltaen i mål tabellen ved hjælp af SQL-kommandoer til delete+insert, og datavaliditetsperioderne afsluttes for de primære nøgler, som deltaen kom ind for.
Der er ikke behov for at skrive de uændrede data om.
Dermed konkluderede vi, at i tilfælde af Hive skal MDW gå ind for at omskrive hele tabellen, fordi Hive ikke har opdateringsfunktion. Der er ikke noget bedre end at omskrive dataene helt ved opdatering. I tilfælde af RDBMS anså produktudviklerne dog for nødvendigt at overlade forbindelsen og opdateringen af tabellerne til brugen af SQL.
For the Sberbank project, we created a new reusable implementation of a database loader for GreenPlum. This was based on the version generated by MDW for Teradata. It was Teradata, not Oracle, that was more suitable and closer in nature as it is also an MPP system. The working methods and syntax of Teradata and GreenPlum turned out to be similar.
Examples of critical differences for MDW between different RDBMS are as follows. In GreenPlum, unlike Teradata, when creating tables, one needs to write a clause
distributed byIn Teradata, one writes
slet <table> alle, while in GreenPlum, one writes
slet fra <table>In Oracle, for optimization purposes, one writes
delete from t where rowid in (), while in Teradata and GreenPlum, one writes
delete from t where exists (select * from delta where delta.pk=t.pk)It should also be noted that for Ab Initio to work with GreenPlum, the GreenPlum client had to be installed on all nodes of the Ab Initio cluster. This is because we connected to GreenPlum simultaneously from all nodes of our cluster. To ensure that reading from GreenPlum was parallel and each parallel Ab Initio stream read its portion of data from GreenPlum, it was necessary to include an Ab Initio-recognizable construct in the "where" section of the SQL queries
where ABLOCAL()and define the value of this construct by specifying the parameter for the transformation reading from the DB
ablocal_expr="string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))", which compiles into something like
mod(sk,10)=3, i.e., it is necessary to provide GreenPlum an explicit filter for each partition. For other databases (Teradata, Oracle), Ab Initio can perform this parallelization automatically.
Sammenlignende karakteristika for ydelsen af Ab Initio ved arbejde med Hive og GreenPlum
An experiment was conducted at Sberbank to compare the performance of the generated MDW graphs for Hive and GreenPlum. In this experiment, there were 5 nodes for Hive on the same cluster as Ab Initio, while GreenPlum had 4 nodes on a separate cluster. Hence, Hive had some advantage over GreenPlum in terms of hardware.
Two pairs of graphs were examined, performing the same data update task in Hive and GreenPlum. The graphs generated by the MDW configurator were run:
- initial load + incremental loading of randomly generated data into the Hive table
- initial load + incremental loading of randomly generated data into the equivalent GreenPlum table
I begge tilfælde (Hive og GreenPlum) kørte vi indlæsninger i 10 parallelle strømme på den samme Ab Initio-klynge. Mellemdata til beregningerne blev gemt i HDFS (i Ab Initio-termer blev der anvendt MFS layout using HDFS). En række tilfældigt genererede data tog i begge tilfælde 200 byte.
Resultatet blev:
Hive:
Initieringsindlæsning i Hive
Indsat rækker
6 000 000
60 000 000
600 000 000
Varighed af initieringsindlæsning
i sekunder
41
203
1 601
Inkrementel indlæsning i Hive
Antal rækker, der var i
målrettet tabel ved eksperimentets start
6 000 000
60 000 000
600 000 000
Antal delta rækker, der blev anvendt på
den målrettede tabel under eksperimentet
6 000 000
6 000 000
6 000 000
Varighed af den inkrementelle
i sekunder
88
299
2 541
GreenPlum:
Initieringsindlæsning i GreenPlum
Indsat rækker
6 000 000
60 000 000
600 000 000
Varighed af initieringsindlæsning
i sekunder
72
360
3 631
Inkrementel indlæsning i GreenPlum
Antal rækker, der var i
målrettet tabel ved eksperimentets start
6 000 000
60 000 000
600 000 000
Antal delta rækker, der blev anvendt på
den målrettede tabel under eksperimentet
6 000 000
6 000 000
6 000 000
Varighed af den inkrementelle
i sekunder
159
199
321
Vi ser, at hastigheden af den initierende indlæsning både i Hive og i GreenPlum er linear afhængig af datamængden, og på grund af bedre hardware er den noget hurtigere for Hive end for GreenPlum.
Den inkrementelle indlæsning i Hive er også linear afhængig af mængden af tidligere indlæste data i den målrettede tabel og foregår ret langsomt med stigende mængde. Dette skyldes, at det er nødvendigt at skrive den målrettede tabel helt om. Det betyder, at anvendelse af små ændringer i store tabeller – ikke er en særlig god brug for Hive.
Den inkrementelle indlæsning i GreenPlum er derimod svagt afhængig af mængden af tidligere indlæste data i den målrettede tabel og foregår ret hurtigt. Dette er muligt takket være SQL Joins og arkitekturen i GreenPlum, der tillader delete-operationer.
Således indsætter GreenPlum deltaen ved hjælp af delete+insert, mens Hive ikke har delete eller update-operationer, derfor var hele datasættet tvunget til at blive skrevet om ved inkrementel opdatering. Det mest slående sammenligning er af de fremhævede fed skuffer, da de svarer til den mest almindelige brug af ressourcekrævende indlæsninger. Vi ser, at GreenPlum vandt over Hive i denne test med 8 gange.
Ab Initios arbejde med GreenPlum i Near Real Time-tilstand
I dette eksperiment vil vi teste, om Ab Initio kan udføre en opdatering af GreenPlum-tabellen med tilfældigt genererede datamængder i en tilstand tæt på realtid. Lad os overveje tabellen GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, som arbejdet vil blive udført med.
Vi vil bruge tre Ab Initio-grafer til at arbejde med den:
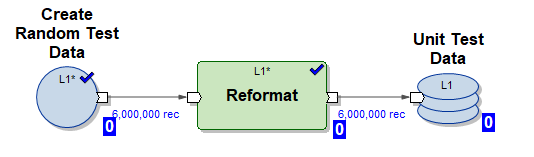
1) Graf Create_test_data.mp – opretter i 10 parallelle tråde filer med data i HDFS med 6.000.000 rækker. Dataene er tilfældige, deres struktur er organiseret til indsættelse i vores tabel.
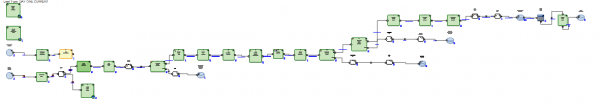
2) Graf mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – genereret MDW-graf til den initielle indsættelse af data i vores tabel i 10 parallelle tråde (testdata genereret af graf (1)).
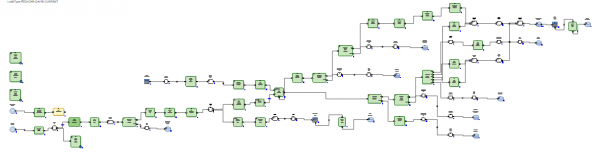
3) Graf mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – genereret MDW-graf til inkrementel opdatering af vores tabel i 10 parallelle tråde med brug af en portion friske indkomne data (deltaer), genereret af graf (1).
Vi vil udføre nedenstående scenarie i NRT-tilstand:
- generere 6.000.000 testlinjer.
- foretage den initiale indlæsning indsætte 6.000.000 testlinjer i en tom tabel.
- gentage den inkrementelle indlæsning 5 gange.
- generere 6.000.000 testlinjer.
- foretage en inkrementel indsættelse af 6.000.000 testlinjer i tabellen (mens de gamle data får tildelt udløbstidspunkt valid_to_ts, og nyere data med samme primære nøgle indsættes).
Dette scenarie emulerer tilstanden fra en virkelig forretningssystem – i realtid tilføjes en betydelig mængde nye data og integreres straks i GreenPlum.
Lad os nu se loggen for scenariets kørsel:
Start Create_test_data.input.pset den 2020-06-04 11:49:11.
Afslut Create_test_data.input.pset den 2020-06-04 11:49:37.
Start mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:49:37.
Afslut mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:50:42.
Start Create_test_data.input.pset den 2020-06-04 11:50:42.
Afslut Create_test_data.input.pset den 2020-06-04 11:51:06.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:51:06.
Afslut mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:53:41.
Start Create_test_data.input.pset den 2020-06-04 11:53:41.
Afslut Create_test_data.input.pset den 2020-06-04 11:54:04.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:54:04.
Afslut mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:56:51.
Start Create_test_data.input.pset den 2020-06-04 11:56:51.
Afslut Create_test_data.input.pset den 2020-06-04 11:57:14.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:57:14.
Afslut mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 11:59:55.
Start Create_test_data.input.pset den 2020-06-04 11:59:55.
Afslut Create_test_data.input.pset den 2020-06-04 12:00:23.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 12:00:23.
Afslut mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 12:03:23.
Start Create_test_data.input.pset den 2020-06-04 12:03:23.
Afslut Create_test_data.input.pset den 2020-06-04 12:03:49.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 12:03:49
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset den 2020-06-04 12:06:46
Det ser således ud:
Graf
Starttid
Sluttid
Længde
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Vi ser, at 6.000.000 rækker inkrementelt behandles på 3 minutter, hvilket er ganske hurtigt.
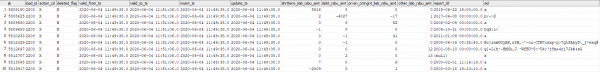
Dataene i den målrettede tabel er blevet fordelte på følgende måde:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 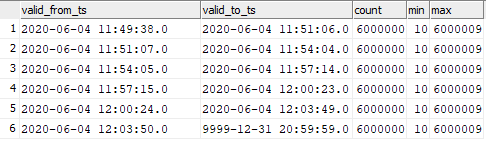
Det er muligt at se overensstemmelsen mellem de indtastede data og grafens opstartstidspunkter.
Det betyder, at man kan køre inkrementelle dataindlæsninger til GreenPlum i Ab Initio med meget høj frekvens og observere høj hastighed ved indsættelse af disse data i GreenPlum. Selvfølgelig vil det ikke være muligt at køre hvert sekund, da Ab Initio, ligesom ethvert ETL-værktøj, kræver tid til 'opstart'.
Konklusion
I øjeblikket anvendes Ab Initio i Sberbank til at opbygge et samlet semantisk datalag (ESS). Dette projekt involverer udviklingen af en samlet version af tilstanden for forskellige bankforretningsenheder. Oplysningerne kommer fra forskellige kilder, hvis replikaer forberedes på Hadoop. Baseret på forretningsbehovene udarbejdes en datamodel, og data transformations beskrives. Ab Initio indlæser oplysninger i ESS, og de indlæste data er ikke kun interessante for forretningen i sig selv, men også en kilde til opbygning af datavitriner. Produktets funktionalitet muliggør brug af forskellige systemer (Hive, Greenplum, Teradata, Oracle) som modtager, hvilket gør det muligt at forberede data til virksomheden i de forskellige formater, der er nødvendige.
Ab Initios muligheder er omfattende; for eksempel gør den medfølgende MDW-ramme det muligt at bygge teknisk og forretningshistorik af data 'out of the box'. For udviklere tilbyder Ab Initio muligheden for ikke at 'opfinde hjulet' igen, men at bruge mange eksisterende funktionelle komponenter, der i bund og grund er biblioteker, der er nødvendige ved arbejde med data.
Forfatteren er en ekspert i Sberbanks professionelle fællesskab SberProfi DWH/BigData. Det professionelle fællesskab SberProfi DWH/BigData er ansvarligt for udviklingen af kompetencer inden for områder som Hadoop-økosystemet, Teradata, Oracle DB, GreenPlum, samt BI-værktøjer som Qlik, SAP BO, Tableau osv.
Kilde: habr.com
