

Sådan ser redundans ud
Redundanskoder* anvendes i vid udstrækning i computersystemer for at øge pålideligheden af datalagring. I Yandex anvendes de i mange projekter. For eksempel sparer brugen af redundanskoder i stedet for replikation i vores interne objektlagersystem millioner uden at mindske pålideligheden. Men på trods af den brede anvendelse er en forståelig beskrivelse af, hvordan redundanskoder fungerer, meget sjælden. Dem, der ønsker at forstå det, støder ofte på følgende (fra ):
Mit navn er Vadim, og i Yandex arbejder jeg med udviklingen af det interne objektlagersystem MDS. I denne artikel vil jeg med enkle ord beskrive de teoretiske grundlag for redundanskoder (Reed-Solomon koder og LRC). Jeg vil forklare, hvordan det fungerer, uden kompliceret matematik og sjældne termer. Til sidst vil jeg give eksempler på brugen af redundanskoder i Yandex.
Jeg vil ikke gå i dybden med en række matematiske detaljer, men jeg vil give links til dem, der ønsker at dykke dybere ned i emnet. Jeg bemærker også, at nogle matematiske definitioner muligvis ikke er strenge, da artiklen ikke er beregnet til matematikere, men til ingeniører, der ønsker at forstå essensen af spørgsmålet.
* I den engelsksprogede litteratur kaldes redundanskoder ofte erasure codes.
1. Essence af redundanskoder
Essensen af alle redundanskoder er ekstremt simpel: at lagre (eller overføre) data på en måde, så de ikke går tabt ved fejl (diskfejl, dataoverførselsfejl osv.).
I de fleste* redundanskoder opdeles data i n datablokke, hvortil der genereres m redundansblokke, hvilket i alt giver n + m blokke. Redundanskoderne konstrueres, så det er muligt at genskabe n datablokke ved kun at bruge en del af n + m blokke. Her vil vi kun se på blok redundanskoder, det vil sige dem, hvor data opdeles i blokke.
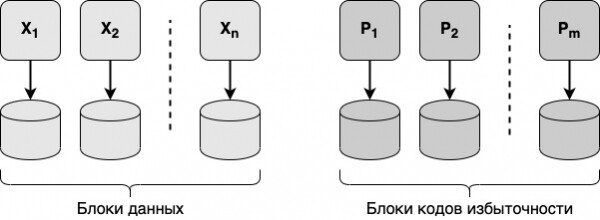
For recovering all n data blocks, you need at least n out of n + m blocks, as you cannot obtain n blocks with only n-1 block (in this case, you would have to take 1 block "out of thin air"). Are n arbitrary blocks from n + m blocks sufficient for recovering all data? This depends on the type of redundancy codes; for instance, Reed-Solomon codes allow recovering all data with arbitrary n blocks, while LRC redundancy codes do not always do so.
Dataopbevaring
In data storage systems, typically each of the data blocks and the redundancy code blocks is written to a separate disk. Thus, if any disk fails, the original data can still be recovered and read. Data can be recovered even in the case of simultaneous failures of multiple disks.
Overførsel af data
Redundancy codes can be used for reliable data transmission over unreliable networks. The transmitted data is divided into blocks, for which redundancy codes are calculated. Both data blocks and redundancy code blocks are transmitted over the network. In case of errors in arbitrary blocks (up to a certain number of blocks), the data can still be transmitted reliably over the network. Reed-Solomon codes, for example, are used for data transmission over optical communication lines and in satellite communication.
* There are also redundancy codes in which data is not divided into blocks, such as Hamming codes and CRC codes, widely used for data transmission in Ethernet networks. These are codes for error-resistant encoding, intended for error detection rather than correction (Hamming code also allows partial error correction).
2. Reed-Solomon Codes
Reed-Solomon codes are among the most widely used redundancy codes, invented back in the 1960s and first widely applied in the 1980s for mass production of compact discs.
There are two key questions for understanding Reed-Solomon codes: 1) how to create redundancy code blocks; 2) how to recover data using redundancy code blocks. Let's find the answers to them.
For simplicity, we will assume that n=6 and m=4. Other schemes are considered by analogy.
How to create redundancy code blocks
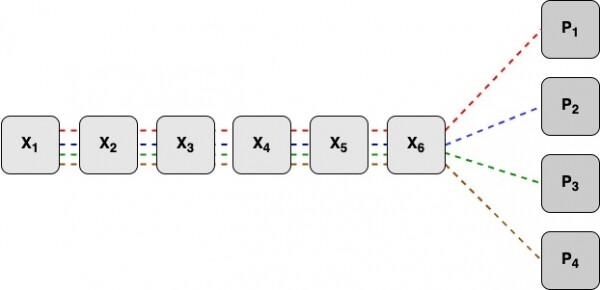
Hver blok af redundant kode betragtes uafhængigt af de andre. For at tælle hver blok anvendes alle n datablokke. På diagrammet herunder er X1-X6 datablokke, P1–P4 er blokke af redundant kode.
Alle datablokke skal have samme størrelse, skal nul-fyldte bits bruges til at justere. De resulterende blokke af redundant kode vil have samme størrelse som datablokkene. Alle datablokke opdeles i ord (f.eks. 16 bit). Antag, at vi opdeler datablokke i k ord. Så vil alle blokke af redundant kode også blive opdelt i k ord.
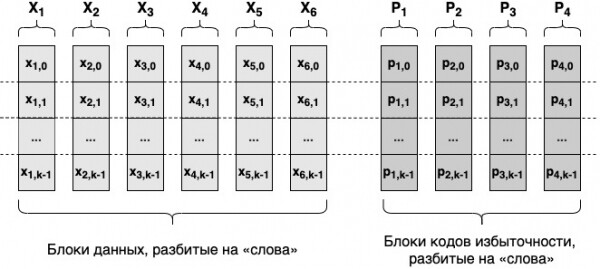
For at beregne det i'te ord i hver blok af redundant kode vil de i'te ord fra alle datablokke blive anvendt. De vil blive beregnet ved hjælp af følgende formel:
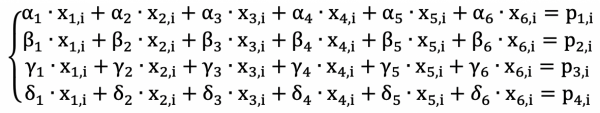
Her er værdierne x – ord fra datablokkene, p – ord fra blokke af redundant kode, alle alfa, beta, gamma og delta er specifikt udvalgte tal, der er ens for alle i. Det skal straks siges, at alle disse værdier ikke er almindelige tal, men elementer i Galois-feltet, operationerne +, -, *, / er ikke de velkendte operationer, men specielle operationer defineret over elementerne i Galois-feltet.
Hvorfor er Galois-felter nødvendige
Det synes at være enkelt: opdelt data i blokke, blokke i ord, ved hjælp af ord fra datablokkene beregner vi ord fra blokke af redundant kode – vi får blokke af redundant kode. Generelt fungerer det sådan, men detaljerne kan være komplicerede:
- Som nævnt er størrelsen af et ord fast, i vores eksempel 16 bit. Formlerne ovenfor for Reed-Solomon-koder er sådan, at ved brug af almindelige heltal kan resultatet af beregningen p muligvis ikke repræsenteres med et ord af en tilladt størrelse.
- Ved genopretning af data vil formlerne ovenfor blive betragtet som et system af ligninger, der skal løses for at genoprette data. Under løsningen kan det være nødvendigt at udføre division af heltal, hvilket resulterer i et reelt tal, som ikke kan repræsenteres præcist i computerens hukommelse.
Disse problemer forhindrer brugen af heltal til Reed-Solomon-koder. Løsningen på problemet er original og kan beskrives således: lad os finde specielle tal, der kan repræsenteres ved hjælp af ord af den nødvendige længde (f.eks. 16 bit), og resultatet af alle operationer (addition, subtraktion, multiplikation, division) udført på dem også vil blive repræsenteret i computeren med ord af den nødvendige længde.
Sådanne "specielle" tal er blevet studeret af matematik i lang tid, og de kaldes felter. Et felt er en samling af elementer med bestemte operationer for dem, såsom addition, subtraktion, multiplikation og division.
Galois-felter* er de felter, for hvilke der eksisterer en entydig udfald for hver operation (+, -, *, /) for enhver to elementer i feltet. Galois-felter kan konstrueres for tal, der er en potens af 2: 2, 4, 8, 16 osv. (faktisk en potens af ethvert primtal p, men i praksis er vi kun interesseret i potenser af 2). For eksempel, for ord med en størrelse på 16 bit, er dette feltet, der indeholder 65.536 elementer, for hvilket der for hvert par kan findes resultatet af enhver operation (+, -, *, /). Værdierne x, p, alfa, beta, gamma, delta fra de ovenstående ligninger vil blive betragtet som elementer i Galois-feltet til beregninger.
Dermed har vi et system af ligninger, som kan bruges til at konstruere redundanskoder, ved hjælp af et passende computerprogram. Med det samme system af ligninger kan data også genskabes.
* Dette er ikke en striks definition, snarere en beskrivelse.
Hvordan man genskaber data
Genskabelse er nødvendig, når en del af blokke fra n + m blokke mangler. Dette kan være både datablokke og redundansblokke. Manglende datablokke og/eller redundansblokke vil betyde, at de tilsvarende variable x og/eller p i de ovenstående ligninger er ukendte.
Ligningerne for Reed-Solomon-koder kan betragtes som et system af ligninger, hvor alle værdier alfa, beta, gamma, delta er konstanter, alle x og p, der svarer til tilgængelige blokke, er kendte variable, mens de øvrige x og p er ukendte.
For eksempel, lad os sige, at datablokkene 1, 2, 3, og redundansblokken 2 er utilgængelige, så for den i'te gruppe ord vil følgende system af ligninger være (ukendte markeret med rødt):
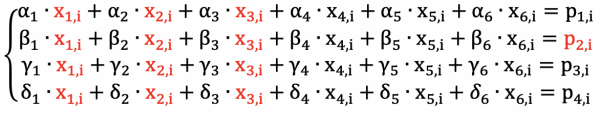
Vi har et system bestående af 4 ligninger med 4 ubekendte, hvilket betyder, at vi kan løse det og genoprette dataene!
Fra dette system af ligninger følger en række konklusioner om genopretning af data for Reed-Solomon-koder (n datablokke, m redundansblokke):
- Data kan genoprettes ved tab af enhver m blokke eller færre. Ved tab af m+1 eller flere blokke kan data ikke genoprettes: det er ikke muligt at løse et system med m ligninger og m + 1 ubekendte.
- For at genoprette selv én datablok kræves det at benytte enhver n af de resterende blokke, og enhver af redundanskoderne kan anvendes.
Hvad mere skal man vide
I beskrivelsen ovenfor overser jeg en række vigtige emner, som kræver en dybere forståelse af matematik. Specifikt nævner jeg ikke følgende:
- Systemet af ligninger for Reed-Solomon-koder skal have en (unik) løsning for alle kombinationer af ubekendte (højst m ubekendte). Baseret på dette krav vælges værdierne for alpha, beta, gamma og delta.
- Systemet af ligninger skal automatisk kunne konstrueres (afhængigt af hvilke blokke der ikke er tilgængelige) og løses.
- Det er nødvendigt at opbygge et Galois-felt: for en given ordsize skal det være muligt at finde resultatet af enhver operation (+, -, *, /) for ethvert to elementer.
I slutningen af artiklen er der links til litteratur om disse vigtige emner.
Valg af n og m
Hvordan vælger man n og m i praksis? I praksis anvendes redundanskoder i datalagringssystemer for at spare plads, derfor vælges m altid mindre end n. Deres specifikke værdier afhænger af en række faktorer, herunder:
- Dataopbevaringspålidelighed. Jo højere m, desto større antal diskfejl kan overleve, og dermed højere pålidelighed.
- Opbevaringsredundans. Jo højere forholdet m / n, desto højere vil opbevaringsredundansen være, og desto dyrere vil systemet blive.
- Behandlingstid for forespørgsler. Jo højere summen af n + m, desto længere vil svartiden være på forespørgsler. Da det for at læse data (under genopretning) er nødvendigt at læse n blokke, der er gemt på n forskellige diske, vil læsetiden blive bestemt af den langsomste disk.
Desuden lægger opbevaring af data i flere datacentre yderligere begrænsninger på valget af n og m: når ét datacenter er offline, skal data stadig være tilgængelige for læsning. For eksempel, når data opbevares i 3 datacentre, skal betingelsen m >= n/2 opfyldes; ellers kan der opstå en situation, hvor data ikke er tilgængelige for læsning, når ét datacenter er offline.
3. LRC — Lokale Rekonstruktionskoder
For at rekonstruere data ved hjælp af Reed-Solomon-koder er det nødvendigt at bruge n vilkårlige datablokke. Dette er en særlig ulempe for distribuerede datalagringssystemer, da det kræver, at der læses data fra de fleste resterende skiver for at rekonstruere data på én defekt skive, hvilket skaber en betydelig ekstra belastning på skiverne og netværket.
De mest almindelige fejl er utilgængeligheden af én datablok på grund af en skives fejl eller overbelastning. Kan man på nogen måde reducere den overdrevne belastning ved datagenoprettelse i sådan en (den mest almindelige) situation? Det viser sig, at det kan lade sig gøre: der findes specifikt koder til redundans, LRC, til dette formål.
LRC (Lokale Rekonstruktionskoder) er redundanskoder, opfundet i Microsoft til brug i Windows Azure Storage. Ideen bag LRC er ganske simpel: at opdele alle datablokke i to (eller flere) grupper og beregne en del af redundanskoderne for hver gruppe separat. Således vil en del af redundanskoderne blive beregnet ved hjælp af alle datablokke (i LRC kaldes de globale redundanskoder), mens en del vil blive beregnet ved hjælp af en af de to grupper af datablokke (de kaldes lokale redundanskoder).
LRC betegnes med tre tal: n-r-l, hvor n er antallet af datablokke, r er antallet af globale redundanskoder, l er antallet af lokale redundanskoder. For at læse data, når en datablok ikke er tilgængelig, skal man kun læse n/l blokke, hvilket er l gange mindre end med Reed-Solomon-koder.
Som eksempel kan vi se på LRC-schemas 6-2-2. X1–X6 er 6 datablokke, P1, P2 er 2 globale redundanskoder, P3, P4 er 2 lokale redundanskoder.
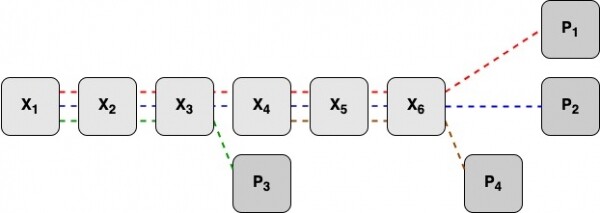
Redundanskoderne P1, P2 beregnes ved hjælp af alle datablokke. Redundanskoden P3 beregnes ved hjælp af datablokke X1–X3, og redundanskoden P4 beregnes ved hjælp af datablokke X4–X6.
Det øvrige udføres i LRC på samme måde som Reed-Solomon-koderne. Ligningerne til beregning af ord for redundansblokke vil være således:
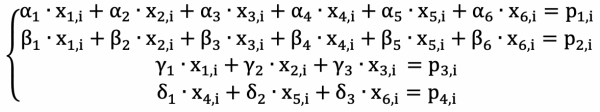
For at vælge tal som alpha, beta, gamma, delta, skal en række betingelser opfyldes for at sikre muligheden for datagendannelse (dvs. løsningen af ligningssystemet). Du kan læse mere om dem i .
Desuden anvendes operationen XOR i praksis til at beregne lokale redundanskoder P3, P4.
Fra ligningssystemet for LRC følger en række konklusioner:
- For at gendanne en hvilken som helst 1 datablok er det tilstrækkeligt at læse n/l blokke (n/2 i vores eksempel).
- Hvis der mangler r + l blokke, og alle blokke tilhører samme gruppe, kan dataene ikke gendannes. Dette kan let forklares med et eksempel. Antag, at blokke X1–X3 og P3 er utilgængelige: det er r + l blokke fra én gruppe, 4 i vores tilfælde. Så har vi et system af 3 ligninger med 4 ukendte, som ikke kan løses.
- I alle andre tilfælde, hvor r + l blokke er utilgængelige (når der er mindst én blok tilgængelig fra hver gruppe), kan dataene i LRC gendannes.
Således overgår LRC Reed-Solomon-koderne i datagendannelse efter enkeltfejl. I Reed-Solomon-koderne kræves n blokke for at gendanne selv én datablok, mens LRC kun kræver n/l blokke (n/2 i vores eksempel) til gendannelse af én datablok. På den anden side taber LRC mod Reed-Solomon-koderne med hensyn til det maksimale antal tilladte fejl. I de tidligere eksempler kan Reed-Solomon-koderne gendanne data med op til 4 fejl, mens der for LRC findes 2 kombinationer af 4 fejl, hvor dataene ikke kan gendannes.
Hvad der er vigtigere, afhænger af den specifikke situation, men ofte opvejer den besparelse i redundansbelastning, som LRC giver, den lidt lavere datalagringspålidelighed.
4. Andre redundanskoder
Udover Reed-Solomon- og LRC-koderne er der mange andre redundanskoder. Forskellige redundanskoder anvender forskellige matematikker. Her er nogle andre redundanskoder:
- Redundanskode ved hjælp af XOR-operatoren. XOR-operationen udføres over n datablokke, og der opnås 1 blok af redundanskode, dvs. schema n+1 (n datablokke, 1 redundanskode). Dette anvendes i , hvor datablokke og redundanskoder cyklisk skrives til alle diske i arrayet.
- Even-odd-algoritmen, baseret på XOR-operationen. Gør det muligt at opbygge 2 redundanskodeblokke, det vil sige en n+2 skema.
- STAR-algoritmen, baseret på XOR-operationen. Gør det muligt at opbygge 3 redundanskodeblokke, det vil sige en n+3 skema.
- Pyramidekoder — endnu en type redundanskoder fra Microsoft.
5. Brug i Yandex
En række infrastrukturprojekter fra Yandex anvender redundanskoder til sikret datalagring. Her er nogle eksempler:
- MDS, det interne objektlager, som jeg nævnte i begyndelsen af artiklen.
- — Yandexs MapReduce-system.
- (Yandex DataBase) — en distribueret NewSQL-database.
I MDS anvendes LRC-redundanskoder, skema 8-2-2. Data med redundanskoder skrives til 12 forskellige diske på forskellige servere i 3 forskellige datacentre: 4 servere i hver datacenter. Læs mere om dette i .
I YT anvendes både Reed-Solomon-koder (skema 6-3), som blev implementeret først, og LRC-redundanskoder (skema 12-2-2), hvor LRC er den foretrukne lagringsmetode.
I YDB anvendes redundanskoder baseret på even-odd (skema 4-2). Der er allerede blevet talt om redundanskoder i YDB .
Brugen af forskellige skemaer for redundanskoder skyldes forskellige krav, der stilles til systemerne. For eksempel, i MDS placeres data gemt med LRC straks i 3 datacentre. Det er vigtigt for os, at data forbliver tilgængelige for læsning, når et af datacentrene går ned, så blokkene skal fordeles mellem datacentrene på en måde, så mængden af utilgængelige blokke ikke overstiger det acceptable. I skema 8-2-2 kan der placeres 4 blokke i hvert datacenter, hvilket betyder, at der ved nedlukning af et hvilken som helst datacenter vil være 4 blokke utilgængelige, og dataene kan stadig læses. Uanset hvilket skema vi vælger til placering i 3 datacentre, skal der i hvert fald gælde, at (r + l) / n >= 0,5, det vil sige at redundansen vil være minimum 50%.
I YT er situationen en anden: hver YT-kluster ligger helt i 1 datacenter (forskellige kluster i forskellige datacentre), så der er ikke en sådan begrænsning. Skema 12-2-2 giver en redundans på 33%, hvilket betyder, at lagring af data bliver billigere, samtidig med at de kan modstå op til 4 samtidige diskfejl, ligesom skemaet i MDS.
Der er mange flere aspekter ved brugen af redundanskoder i datalagrings- og behandlingssystemer: nuancer ved datagendannelse, indflydelse af gendanserne på forespørgslernes udførelsestid, særlige forhold ved dataskrivning osv. Jeg planlægger at fortælle om disse og andre praktiske anvendelser af redundanskoder, hvis emnet har interesse.
6. Links
- En serie artikler om Reed-Solomon koder og Galois felter:
I dem forklares matematikken dybere på en tilgængelig måde. - Artikel fra Microsoft om LRC:
I afsnit 2 forklares teorien kort, hvorefter erfaringer med praktisk anvendelse af LRC gennemgås. - Even-odd schema:
- STAR schema:
- Pyramid koder:
- Redundanskoder i MDS:
- Redundanskoder i YT:
- Redundanskoder i YDB:
Kilde: habr.com
