

Background
Som retro hardware-entusiast købte jeg engang en ZX Spectrum+ fra en sælger i Storbritannien. Med computeren fik jeg også nogle audiokassetter med spil (i den originale emballage med instruktioner) samt programmer, der var optaget på kassetter uden særlige betegnelser. Overraskende nok blev dataene fra kassetterne fra for 40 år siden læst godt, og jeg kunne næsten indlæse alle spil og programmer fra dem.
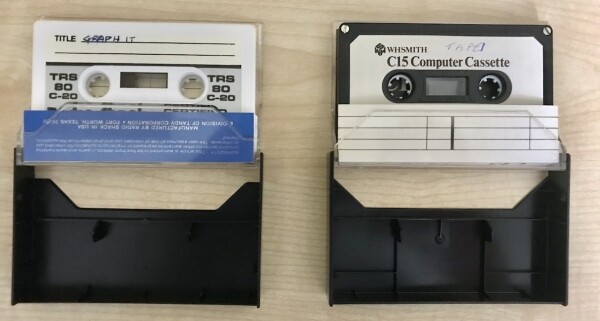
Dog fandt jeg på nogle kassetter optagelser, der åbenlyst ikke var lavet med ZX Spectrum. De lød helt anderledes og, i modsætning til optagelserne fra den nævnte computer, begyndte de ikke med den korte BASIC-loader, som normalt er til stede i optagelser af alle programmer og spil.
Et stykke tid gav dette mig ikke ro — jeg ønskede virkelig at finde ud af, hvad der var gemt i dem. Hvis jeg kunne læse audiosignalet som en sekvens af bytes, ville jeg kunne lede efter tegn eller noget, der indikerer signalets oprindelse. En slags retro-arkæologi.
Nu, når jeg ser tilbage på hele processen og kigger på etiketterne på selve kassetterne, smiler jeg, fordi
svaret har været lige foran øjnene hele tiden.
På etiketten af den venstre kassette er der navnet på computeren TRS-80, og lidt længere nede producentens navn: «Manufactured by Radio Shack in USA»
(Hvis du vil bevare spændingen til slutningen, så klik ikke på spoileren)
Sammenligning af audiosignaler
Først digitaliserer vi lydoptagelserne. Du kan lytte til, hvordan det lyder:
Og hvordan en optagelse fra ZX Spectrum normalt lyder:
I begge tilfælde er der i begyndelsen af optagelsen det, man kalder en pilottonen — en lyd med én frekvens (den første optagelse er meget kort <1 sek, men den er stadig genkendelig). Pilottonen fungerer som et signal til computeren om, at den skal forberede sig på at modtage data. Generelt genkender hver computer kun sin egen pilottonen baseret på signalets form og frekvens.
Det er værd at nævne signalets form. For eksempel på ZX Spectrum er dens form rektangulær:
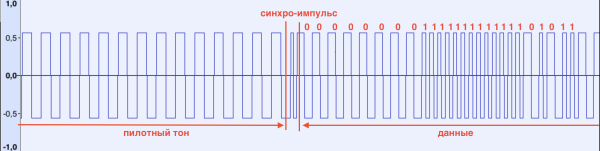
Når pilottonen opdages, viser ZX Spectrum skiftende røde og blå striber på skærmens kant, hvilket indikerer, at signalet er genkendt. Pilottonen afsluttes med en synkroniseringsimpuls., som signalerer computeren om at begynde at modtage data. Den kendetegnes ved en kortere varighed (sammenlignet med pilottonen og de efterfølgende data) (se billede)
Når synkroniseringsimpulsen er modtaget, registrerer computeren hver signalopgang/nedgang og måler dens varighed. Hvis varigheden er under den fastsatte grænse, gemmes en bit 1 i hukommelsen, ellers 0. Biterne samles i bytes, og processen gentages, indtil N bytes er modtaget. Antallet N tages som regel fra headeren af den downloadede fil. Downloadsekvensen er som følger:
- pilottonen
- header (af fast længde), indeholder størrelsen på de downloadede data (N), filens navn og type
- pilottonen
- selve dataene
For at sikre, at dataene er blevet downloadet korrekt, læser ZX Spectrum den sidste byte, kendt som paritetsbyte , som beregnes ved at anvende XOR-operationen på alle de bytes, der er gemt. Ved læsning af filen beregner computeren paritetsbyten ud fra de modtagne data, og hvis resultatet adskiller sig fra den gemte, vises en fejlmeddelelse "R Tape loading error". Strengt taget kan computeren give denne meddelelse tidligere, hvis den ikke kan genkende impulsen ved læsning (hvis den er sprunget over eller dens varighed ikke stemmer overens med de fastsatte grænser)
Lad os nu se på, hvordan et ukendt signal ser ud:
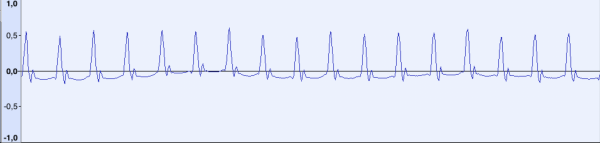
Dette er pilottonen. Signalformen adskiller sig betydeligt, men det kan ses, at signalet består af gentagne korte impulser med en bestemt frekvens. Ved en samplefrekvens på 44100 Hz er afstanden mellem "toppe" cirka 48 samples (hvilket svarer til en frekvens på ~918 Hz). Lad os huske dette tal.
Lad os nu se på et datafragment:
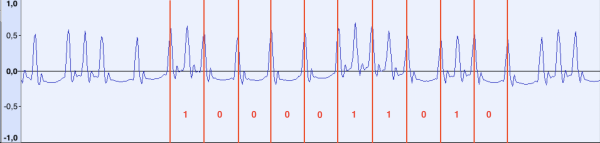
Hvis man måler afstanden mellem de enkelte impulser, viser det sig, at afstanden mellem de "lange" impulser stadig er ca. 48 samples, mens afstanden mellem de korte impulser er ~24. For at springe lidt fremad, vil jeg sige, at det i sidste ende viste sig, at de "reference" impulser med en frekvens på 918 Hz følger kontinuerligt fra begyndelsen til slutningen af filen. Man kan antage, at ved dataoverførsel, hvis der mellem referenceimpulserne optræder en ekstra impuls, betragtes den som bit 1, ellers 0.
Hvad med synkroniseringsimpulsen? Lad os se på begyndelsen af dataene:
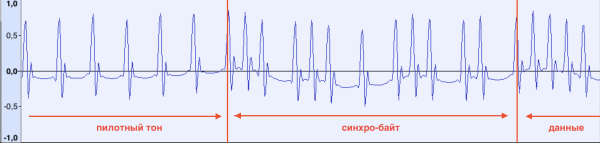
Pilottonen slutter, og straks begynder dataene. Lidt senere, efter at have analyseret forskellige lydoptagelser, blev det muligt at opdage, at den første byte data altid er den samme (10100101b, A5h). Det er muligt, at computeren begynder at læse data, efter at den har modtaget det.
Man kan også bemærke forskydningen af den første referenceimpuls lige efter den sidste '1' i synkro-biten. Den blev først opdaget meget senere i udviklingen af programmet til data genkendelse, da dataene i filens begyndelse ikke kunne læses stabilt.
Nu vil vi prøve at beskrive algoritmen, der vil behandle lydfilen og indlæse dataene.
Indlæsning af data
Lad os først overveje nogle antagelser for ikke at komplicere algoritmen:
- Vi vil kun betragte filer i WAV-format;
- Lydfilen skal starte med pilottonen og må ikke indeholde stilhed i starten.
- Den originale fil skal have en samplefrekvens på 44100 Hz. I så fald er afstanden mellem referenceimpulserne på 48 samples allerede defineret, og vi behøver ikke at beregne den programmatisk;
- Sampleformatet kan være hvilket som helst (8/16 bit/flytende punkt) - da vi kan konvertere det til det ønskede format under læsningen;
- Vi antager, at den originale fil er normaliseret i amplitude, hvilket bør stabilisere resultatet;
Læsealgoritmen vil være følgende:
- Vi læser filen ind i hukommelsen og konverterer samtidig sampleformatet til 8 bit;
- Vi bestemmer positionen for den første impuls i lyddataene. For at gøre dette skal vi beregne nummeret på samplet med den maksimale amplitude. For enkelhedens skyld beregner vi det én gang manuelt. Vi gemmer det i variablen prev_pos;
- Vi lægger 48 til positionen for den sidste impuls (pos := prev_pos + 48)
- Da stigningen til position 48 ikke garanterer, at vi rammer positionen for det næste referenceimpuls (båndfejl, ustabil drift af båndtransportmekanismen osv.), skal positionen for impulset pos justeres. For dette vil vi tage et lille datastykke (pos-8;pos+8) og finde maksimumværdien for amplituden. Positionen, der svarer til maksimum, gemmes i pos. Her er 8 = 48/6 — en eksperimentelt bestemt konstant, der sikrer, at vi identificerer det rigtige maksimum og ikke berører andre impulser, der kan være i nærheden. I meget dårlige tilfælde, hvor afstanden mellem impulserne er meget mindre eller større end 48, kan en tvungen søgning efter impulsen implementeres, men dette vil jeg ikke beskrive i algoritmen i denne artikel;
- I det forrige trin skal det også kontrolleres, at referenceimpulsen faktisk er fundet. Det vil sige, at det at søge efter maksimum ikke garanterer, at impulsen er til stede i dette datastykke. I min seneste implementering af læseprogrammet kontrollerer jeg forskellen mellem maksimum- og minimumværdien for amplituden i stykket, og hvis den overstiger en vis grænse, anser jeg forkomsten af impulsen. Spørgsmålet er også, hvad der skal gøres, hvis referenceimpulsen ikke findes. Her er der 2 muligheder: enten er dataene slut, og der følger stilhed, eller også bør det betragtes som en læsefejl. Men lad os undlade dette for at forenkle algoritmen;
- I det næste skridt skal vi bestemme tilstedeværelsen af datainput (bit 0 eller 1). For dette tager vi midten af stykket (prev_pos;pos) middle_pos lig med middle_pos := (prev_pos+pos)/2, og i en vis nærhed til middle_pos i stykket (middle_pos-8;middle_pos+8) beregner vi maksimum og minimum for amplituden. Hvis forskellen mellem dem er større end 10, registrerer vi bit 1 som resultat, ellers 0. 10 — en konstant opnået eksperimentelt;
- Vi gemmer den nuværende position i prev_pos (prev_pos := pos)
- Vi gentager fra trin 3, indtil vi har læst hele filen;
- Det bitarray, der er modtaget, skal gemmes som et sæt af bytes. Da vi ikke tog synkroniseringsbyte i betragtning ved læsning, kan antallet af bits vise sig ikke at være et multippel af 8, og det nødvendige bitoffset er også ukendt. I den første implementering af algoritmen kendte jeg ikke til eksistensen af synkroniseringsbyte og gemte derfor blot 8 filer med forskellige antal bitskift. En af dem indeholdt de korrekte data. I den endelige algoritme fjerner jeg simpelthen alle bits op til A5h, hvilket gør det muligt straks at få en korrekt fil som output.
Algoritmen i Ruby, til dem der er interesseret.
Til programmeringsspråket valgte jeg Ruby, da jeg i de fleste tilfælde programmerer i det. Varianten er ikke højtydende, men opgaven at gøre læsehastigheden så hurtig som muligt er ikke prioriteret.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Resultat
Efter at have prøvet flere varianter af algoritmen og konstanter, var jeg heldig at få noget ekstremt interessant:
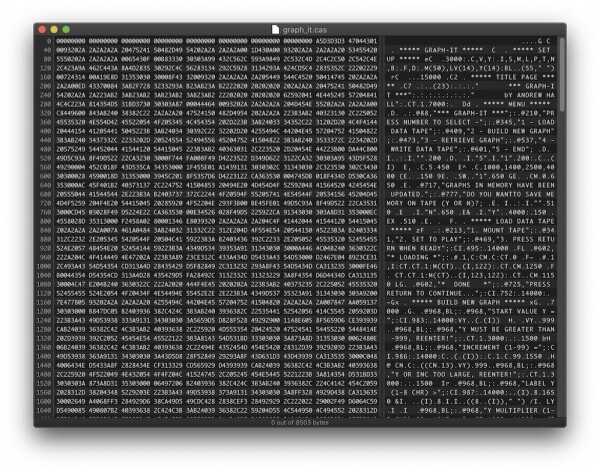
Så ifølge de tegnstrengene har vi et program til at bygge grafer. Men i programmets tekst mangler de nøgleord. Alle nøgleordene er kodet i form af bytes (hvis værdi er > 80h). Nu skal vi finde ud af, hvilken computer fra 80'erne der kunne gemme programmer i dette format.
Det ligner faktisk meget et program på BASIC-sproget. Cirka i det samme format gemmer og gemmer ZX Spectrum computeren programmer i hukommelsen og på bånd. For sikkerheds skyld tjekkede jeg nøgleordene i forhold til . Men resultatet var åbenbart negativt.
Jeg tjekkede også nøgleordene fra BASIC for populære computere fra den tid, såsom Atari, Commodore 64 og flere andre, hvor jeg fandt dokumentation, men uden held - mine kendskaber til varianter af retro-computere var ikke så brede.
Så besluttede jeg at gå efter , og her faldt mit blik på navnet fra producenten Radio Shack og computeren TRS-80. Netop disse navne var skrevet på etiketterne på de kassettebånd, der lå på mit skrivebord! Jeg kendte ikke tidligere disse navne og var ikke bekendt med computeren TRS-80, så det forekom mig, at Radio Shack var en producent af kassettebånd, ligesom BASF, Sony eller TDK, og TRS-80 - spiltid. Hvorfor ikke?
Computeren Tandy/Radio Shack TRS-80
Det er meget sandsynligt, at den audiodokumentation, jeg gav som eksempel i begyndelsen af artiklen, blev lavet på en sådan computer:
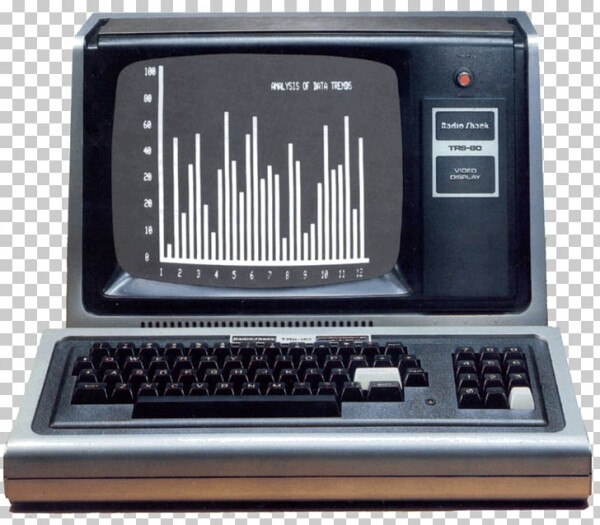
Det viste sig, at denne computer og dens varianter (Model I/Model III/Model IV osv.) var meget populære i sin tid (selvfølgelig ikke i Rusland). Bemærkelsesværdigt er, at processoren, der blev brugt i dem — også Z80. Der kan findes . I 80'erne blev oplysninger om computeren spredt i . I øjeblikket findes der flere af computeren til forskellige platforme.
Jeg downloadede emulatoren og jeg fik første gang mulighed for at se, hvordan denne computer arbejdede. Selvfølgelig understøttede computeren ikke farveudgang, skærmopløsningen var kun 128x48 punkter, men der fandtes mange udvidelser og modifikationer, der kunne øge skærmopløsningen. Der eksisterede også mange varianter af operativsystemer til denne computer og varianter af implementeringen af BASIC-sproget (som, i modsætning til ZX Spectrum, i nogle modeller endda ikke var "flash' kodet" i ROM, og enhver variant kunne indlæses fra diskette, ligesom selve OS)
Jeg fandt også et program til at konvertere lydoptagelser til CAS-format, som emulatorerne understøtter, men af en eller anden grund lykkedes det mig ikke at læse optagelserne fra mine bånd.
Efter at have forstået CAS filformatet (som viste sig blot at være en bit-for-bit kopi af dataene fra båndet, som jeg allerede havde i hænderne, bortset fra headeren med en synkroniseringsbyte), lavede jeg et par ændringer i mit program og kunne generere en fungerende CAS-fil, der virkede i emulatoren (TRS-80 Model III):
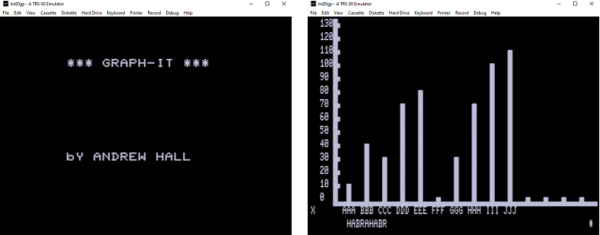
Den seneste version af værktøjet til konvertering med automatisk bestemmelse af det første signal og afstanden mellem referencesignalerne, har jeg gjort tilgængelig som en GEM-pakke, kildekoden er tilgængelig på .
Konklusion
Den rejse, jeg har været igennem, viste sig at være en fascinerende rejse tilbage i tiden, og jeg er glad for, at jeg til sidst fandt løsningen. Desuden har jeg:
- Forstået dataopbevaringsformatet i ZX Spectrum og undersøgt de indbyggede subroutiner i ROM til opbevaring/læsning af data fra båndoptagere
- Lært om computeren TRS-80 og dens varianter, studeret operativsystemet, set eksempelprogrammer og endda haft mulighed for at arbejde med debugging i maskinkode (alle Z80-mnemotekster er jo velkendte for mig)
- Jeg har skrevet et fuldt udbygget værktøj til konvertering af lydoptagelser til CAS-format, som kan læse data, der ikke genkendes af det "officielle" værktøj.
Kilde: habr.com
