

Oversættelsen af artiklen er udarbejdet forud for begyndelsen af kurset
Distribueret læring på flere højtydende beregningsinstanser kan reducere træningstiden for moderne dybe neurale netværk på store datamængder fra flere uger til timer eller endda minutter, hvilket gør denne læringsteknik fremtrædende i spørgsmål om praktisk anvendelse af dyb læring. Brugere skal forstå, hvordan man deler og synkroniserer data på flere instanser, hvilket igen har stor indflydelse på effektiviteten af skalaen. Derudover bør brugerne også vide, hvordan man implementerer et træningsscript, der kører på én instans, på flere instanser.
I denne artikel vil vi tale om en hurtig og enkel metode til distribueret læring ved hjælp af det åbne bibliotek til dyb læring, Apache MXNet, og rammeværket for distribueret læring, Horovod. Vi vil tydeligt vise fordelene ved Horovod-rammeværket med hensyn til ydeevne og demonstrere, hvordan man skriver et MXNet-træningsscript, så det fungerer distribueret med Horovod.
Hvad er Apache MXNet
er et åbent rammeværk til dyb læring, der bruges til at skabe, træne og implementere dybe neurale netværk. MXNet abstraherer kompleksiteterne ved implementering af neurale netværk, har høj ydelse og skalerbarhed og tilbyder API'er til populære programmeringssprog såsom , , , , , , og andre.
Distribueret læring i MXNet med parameterserver
bruger en parameterserver-tilgang. Den bruger et sæt parameterservere til at indsamle gradienter fra hver arbejdsenhed, udføre aggregering og sende de opdaterede gradienter tilbage til arbejdsenhederne til den næste iterations optimering. At finde det rette forhold mellem servere og arbejdsenheder er nøglen til effektiv skalerbarhed. Hvis der kun er én parameterserver, kan den blive en flaskehals i beregningerne. Omvendt, hvis der bruges for mange servere, kan forbindelsen 'mange-til-mange' blokere alle netværksforbindelser.
Hvad er Horovod
– et åbent rammeværk til distribueret dyb læring, udviklet af Uber. Det bruger effektive teknologier til interaktion mellem flere GPU'er og noder, såsom NVIDIA Collective Communications Library (NCCL) og Message Passing Interface (MPI) til at fordele og aggregere modelparametre mellem workere. Det optimerer brugen af netværksbåndbredde og skalerer godt, når det arbejdes med dybe neurale netværksmodeller. I øjeblikket understøtter det flere populære maskinlæringsrammer, nemlig , Tensorflow, Keras og PyTorch.
Integration af MXNet og Horovod
MXNet integreres med Horovod gennem API'er til distribueret læring, der er defineret i Horovod. I Horovod er kommunikations-API'erne horovod.broadcast(), horovod.allgather() og horovod.allreduce() implementeret ved hjælp af asynkrone callbacks fra MXNet-motoren, som en del af dens opgavegraf. Dermed behandles dataafhængigheder mellem kommunikation og beregninger nemt af MXNet-motoren for at undgå præstationsnedgang på grund af synkronisering. Objekter distribueret optimizer, defineret i Horovod horovod.DistributedOptimizer udvider Optimizer i MXNet på en måde, der får det til at kalde de relevante Horovod-API'er til distribueret opdatering af parametre. Alle disse implementeringsdetaljer er gennemsigtige for slutbrugerne.
Hurtig start
Du kan hurtigt begynde at træne et lille konvolutionsneuronnetværk på MNIST-datasættet ved hjælp af MXNet og Horovod på din MacBook.
For at komme i gang skal du installere mxnet og horovod fra PyPI:
pip install mxnet
pip install horovod
Bemærk: Hvis du får en fejl under pip install horovod, skal du muligvis tilføje variablen MACOSX_DEPLOYMENT_TARGET=10.vv, hvor vv – det er versionen af din version af MacOS, for eksempel for MacOSX Sierra skal du skrive MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Installer derefter OpenMPI .
Til sidst skal du downloade testscriptet mxnet_mnist.py og køre følgende kommandoer i terminalen på din MacBook i din arbejdsmappe:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pySådan starter du træningen på to kerner af din processor. Outputtet vil være som følger:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Ydelsesdemonstration
Når man træner ResNet50-v1 modellen på ImageNet-datasættet på 64 GPU'er med otte instanser p3.16xlarge EC2, hver af dem indeholder 8 NVIDIA Tesla V100 GPU'er i AWS-cloud, har vi opnået en træningsgennemstrømning på 45000 billeder/sek (dvs. antallet af trænede prøver pr. sekund). Træningen blev afsluttet efter 44 minutter efter 90 epoker med den bedste nøjagtighed på 75,7%.
Vi sammenlignede dette med distribueret træning af MXNet ved at bruge servere med parametre på 8, 16, 32 og 64 GPU'er med en server med én parameter og forholdet mellem servere og arbejdere 1 til 1 og 2 til 1 henholdsvis. Resultatet kan ses på Figur 1 nedenfor. På venstre y-akse afspejler søjlerne antallet af billeder til træning pr. sekund, linjerne afspejler skalerings effektivitet (dvs. forholdet mellem den faktiske gennemstrømning og den ideelle) på den højre y-akse. Som du kan se, påvirker valget af antallet af servere skalerings effektiviteten. Hvis serveren med parametre er én, falder skalerings effektiviteten til 38% ved 64 GPU'er. For at opnå samme skalerings effektivitet som med Horovod skal antallet af servere fordobles i forhold til antallet af arbejdere.
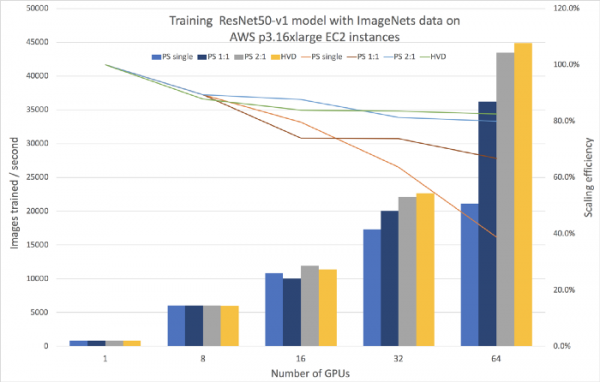
Figur 1. Sammenligning af distribueret træning med brug af MXNet med Horovod og med servere med parametre
I Tabel 1 nedenfor sammenlignede vi de samlede omkostninger ved instanser under udførelsen af eksperimenter på 64 GPU'er. Brug af MXNet sammen med Horovod sikrer den bedste gennemstrømning til de laveste omkostninger.
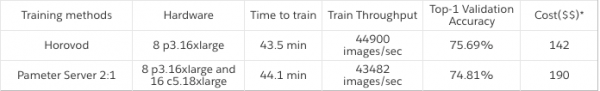
Tabel 1. Sammenligning af omkostninger mellem Horovod og servere med parametre med et forhold mellem servere og arbejdere på 2 til 1.
Trin til reproduktion
I de følgende trin vil vi vise, hvordan man reproducerer resultaterne fra distribueret træning med MXNet og Horovod. For at lære mere om distribueret træning med MXNet, læs .
Trin 1
Opret et klynge af ensartede instanser med MXNet version 1.4.0 eller nyere og Horovod version 0.16.0 eller nyere for at bruge distribueret træning. Du skal også installere biblioteker til træning på GPU. Vi valgte Ubuntu 16.04 Linux til vores instanser, med GPU-driver 396.44, CUDA 9.2, cuDNN-bibliotek 7.2.1, NCCL-kommunikator 2.2.13 og OpenMPI 3.1.1. Du kan også bruge , hvor disse biblioteker allerede er forudinstalleret.
Trin 2
Tilføj API Horovod-funktionalitet til dit træningsscript i MXNet. Scriptet nedenfor baseret på MXNet Gluon API kan bruges som en simpel skabelon. De fedthvindende linjer er nødvendige, hvis du allerede har et relevant træningsscript. Her er nogle kritiske ændringer, der skal foretages for at træne med Horovod:
- Indstil konteksten i henhold til Horovod-lokalrangen (linje 8), så du forstår, at træningen udføres på den rigtige grafiske kerne.
- Overfør de indledende parametre fra en arbejdstager til alle (linje 18) for at sikre, at alle arbejdstagere begynder med de samme indledende parametre.
- Opret Horovod DistributedOptimizer (linje 25) for at opdatere parametrene distribueret.
For at få det fulde script, se på eksemplerne Horovod-MXNet og .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: initialiser Horovod
5  hvd.init()
6
7  # Horovod: fastgør en GPU til lokalrang
8  context = mx.gpu(hvd.local_rank())
9
10 # Byg model
11 model = ...
12
13 # Initialiser parametre
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: broadcast parametre
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Opret optimizer
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: indpak optimizer med DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Opret træner og tabsfunktion
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Træn model
32 for epoch in range(num_epoch):
33    ...
Trin 3
Log ind på en af arbejderne for at starte distribueret træning med MPI-direktivet. I dette eksempel startes distribueret træning på fire instanser med 4 GPU'er hver, og med 16 GPU'er i alt i klyngen. Der vil blive brugt en stochastisk gradient descent (SGD) optimizer med følgende hyperparametre:
- mini-batch størrelse: 256
- lærehastighed: 0.1
- momentum: 0.9
- vægtfald: 0.0001
Efterhånden som vi skalerede fra én GPU til 64 GPU'er, skalerede vi linært læringshastigheden i forhold til antallet af GPU'er (fra 0,1 for 1 GPU til 6,4 for 64 GPU'er), mens vi holdt antallet af billeder pr. GPU på 256 (fra en batch på 256 billeder for 1 GPU til 16.384 for 64 GPU'er). Vægtfald og momentum blev justeret, når antallet af GPU'er steg. Vi brugte blandet præcisionstræning med datatype float16 i fremadrettet passage og float32 for gradienter for at fremskynde beregningerne i float16, der understøttes af NVIDIA Tesla GPU'er.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Konklusion
I denne artikel har vi undersøgt en skalerbar tilgang til distribueret træning af modellen ved hjælp af Apache MXNet og Horovod. Vi har vist effektiviteten af skaleringsmetoden og omkostningseffektiviteten sammenlignet med tilgangen med parameter-server på ImageNet-datasættet, hvor modellen ResNet50-v1 blev trænet. Vi har også præsenteret de trin, du kan følge for at ændre et eksisterende script for at starte træningen på flere instanser ved hjælp af Horovod.
Hvis du lige er begyndt at arbejde med MXNet og dyb læring, så besøg installationssiden , for at samle MXNet først. Vi anbefaler også stærkt at læse artiklen , for at komme i gang.
Hvis du allerede har arbejdet med MXNet og vil prøve distribueret træning med Horovod, så kig på , saml det med MXNet og følg eksemplet eller .
*prisen beregnes baseret på AWS for EC2-instanser
Lær mere om kurset
Kilde: habr.com
