

Overvågning er blevet en væsentlig komponent i voksende cloud-løsninger med den stigende kompleksitet af distribuerede systemer. Det er nødvendigt for at forstå deres adfærd. Der kræves skalerbare værktøjer, der kan indsamle data fra alle tjenester — og give specialisterne en samlet grænseflade med ydeevneanalyse, fejlvisning, tilgængelighed og logfiler.
Disse værktøjer skal også være effektive og ydedygtige. I denne artikel vil vi se på to populære teknologi-stakke: EFK (Elasticsearch) og PLG (Loki) og gennemgå deres arkitekturer og forskelle.
EFK-stakken
Måske har du allerede hørt om den meget populære ELK eller EFK. Stakken består af flere separate dele: Elasticsearch (objektlager), Logstash eller FluentD (indsamling og aggregering af logs) og Kibana til visualisering.
En typisk arbejdsmodel ser således ud:
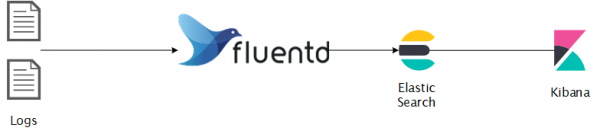
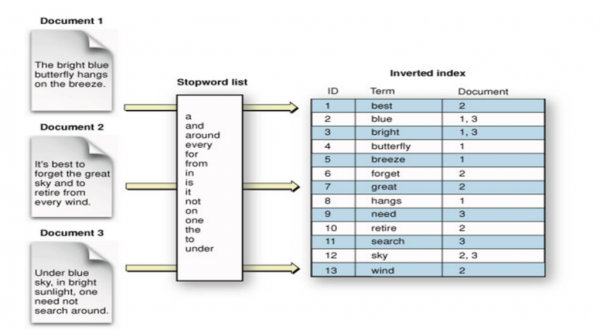
Elasticsearch — et distribueret objektlager med søgning og analyse i realtid. En fremragende løsning til delvist strukturerede data, som logs. Oplysninger gemmes i form af JSON-dokumenter, indekseres i realtid og distribueres på cluster-noder. Der anvendes et omvendt indeks, der indeholder alle unikke ord og de relaterede dokumenter til fuldtekst-søgning, som i øvrigt er baseret på søgemaskinen Apache Lucene.
FluentD — en datainnsamler, der søger at standardisere dataene ved indsamling og forbrug. Den prøver at organisere dataene i JSON så meget som muligt. Dens arkitektur er udvidelig, og der findes mere end , understøttet af fællesskabet, til alle mulige formål.
Kibana — et visualiseringsværktøj til Elasticsearch med forskellige ekstra funktioner, såsom tidsserieanalyse, grafanalyse, maskinlæring og meget mere.
Elasticsearch-arkitektur
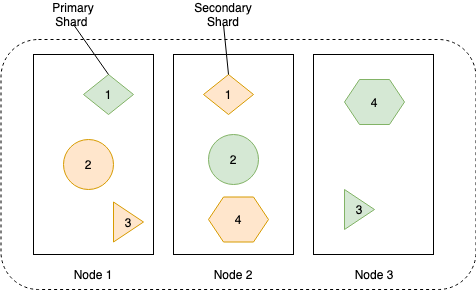
Dataene i Elasticsearch-clusteret gemmes spredt over alle dets noder. Clustret består af flere noder for at forbedre tilgængeligheden og robustheden. Enhver node kan udføre alle roller i clustret, men i store skalerbare implementeringer får noderne typisk tildelt specifikke opgaver.
Typer af cluster-noder:
- master node — styrer clustret, minimum tre nødvendige, én er altid aktiv;
- data node — gemmer indekserede data og udfører forskellige opgaver med dem;
- ingest node — organiserer pipelines til at transformere data før indeksering;
- coordinating node — rutinerer forespørgsler, forkorter søgebehandlingsfasen, koordinerer masseindeksering;
- alerting node — starter varslingopgaver;
- machine learning node — behandler maskinlæringsopgaver.
Diagrammet nedenfor viser, hvordan data gemmes og replikeres på noderne for at opnå højere datatilgængelighed.
Data fra hver replik gemmes i et inverteret indeks, skemaet nedenfor viser, hvordan dette sker:
Installation
Detaljerne kan ses , jeg vil bruge helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG stack
Du bør ikke blive overrasket, hvis du ikke kan finde denne forkortelse, da den bedst er kendt som Grafana Loki. Under alle omstændigheder vinder denne stack popularitet, da den anvender gennemtænkte tekniske løsninger. Du har måske allerede hørt om Grafana, det populære visualiseringsværktøj. Dets skabere, inspireret af Prometheus, udviklede Loki, et horisontalt skalerbart, højtydende system til aggregation af logs. Loki indekserer kun metadata, ikke selve loggene, hvilket har gjort det nemt at anvende og økonomisk fordelagtigt.
Promtail — agent til at sende logs fra operativsystemet til Loki-klyngen. Grafana — visualiseringværktøj baseret på data fra Loki.
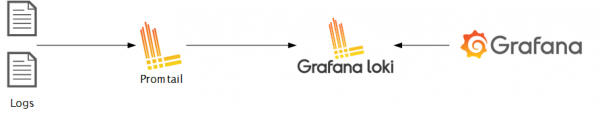
Loki er bygget på de samme principper som Prometheus, så det passer godt til lager og analyse af Kubernetes-logs.
Loki-arkitektur
Loki kan køre både i en enkelt proces og i flere processer, hvilket giver horisontal skalering.
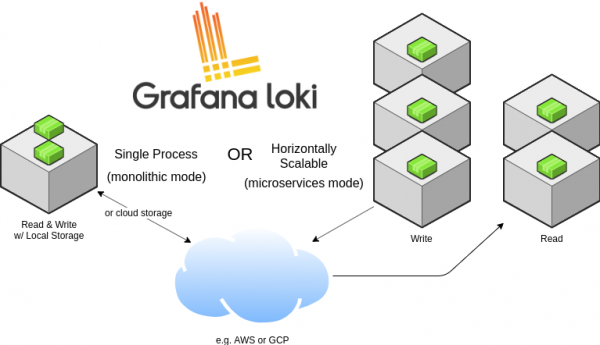
Det kan også fungere som en monolitisk applikation eller som en mikrotjeneste. Kørsel i en enkelt proces kan være nyttig til lokal udvikling eller til mindre overvågning. For industriel implementering og skalerbar belastning anbefales det at anvende mikrotjenestevarianten. Veje til at skrive og læse data er adskilt, så det kan justeres og skaleres efter behov.
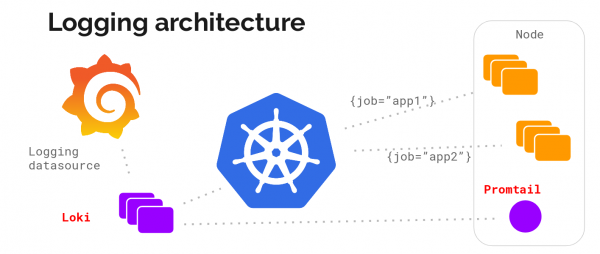
Lad os se på arkitekturen af logindsamlingssystemet uden detaljering:
Og her er en beskrivelse (mikrotjenestearkitektur):
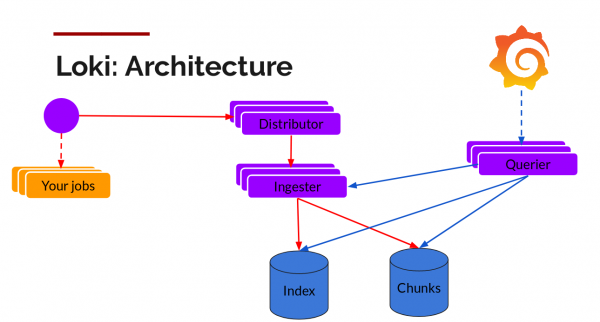
Bestanddele:
Promtail — en agent, der installeres på noder (i form af et sæt tjenester), indsamler logfiler fra opgaver og henter metadata via Kubernetes API, som loggene vil blive mærket med. Derefter sender den loggen til den primære Loki-tjeneste. De samme regler for mærkning som i Prometheus understøttes til matchning af metadata.
Distributor — en distributionsservice, der fungerer som en buffer. For at behandle millioner af poster pakker den de indkommende data og komprimerer dem i blokke, mens de modtages. Flere datamodtagere fungerer samtidigt, men logfiler, der tilhører en enkelt indkommende datastream, bør kun være i én af dem for alle dens blokke. Dette er organiseret i en ring af modtagere med sekventiel hashing. For fejltolerance og redundans gøres det n gange (3, hvis ikke konfigureret).
Ingester — en modtagerservice. Data blokke kommer komprimeret med tilføjede logfiler. Når en blok når en tilstrækkelig størrelse, udføres blokken i databasen. Metadata går til indekset, mens data fra blokken med loggen går til Chunks (normalt objektlagring). Efter nedskrivning opretter modtageren en ny blok, hvor nye poster skal tilføjes.
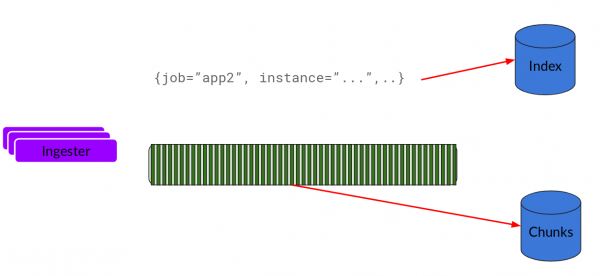
Index — database, DynamoDB, Cassandra, Google BigTable og andet.
Chunks — komprimerede logblokke, der normalt opbevares i objektlagring, f.eks. S3.
Querier — læsevejen, der udfører alt det hårde arbejde. Den ser på tidsintervallet og mærker, hvorefter den kigger på indekset for at finde matches. Derefter læser den datablokke og filtrerer dem for at få resultatet.
Lad os nu se alt i aktion.
Installation
For at installere i Kubernetes er det nemmeste at bruge helm. Vi antager, at du allerede har installeret og konfigureret det ( oversætterens bemærkning)
Tilføj repoet og installér stakken.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
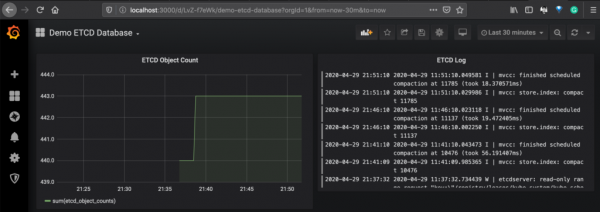
Her er et eksempel på et dashboard, der viser data fra Prometheus for Etcd-metrikker og Loki for Etcd-pod-logfiler.
Lad os nu diskutere arkitekturen af begge systemer og sammenligne deres funktionaliteter.
Sammenligning
Spørgesprog
Elasticsearch bruger Query DSL og Lucene forespørgselssprog, der muliggør fuldtekstsøgning. Det er en veletableret kraftfuld søgemaskine med bred støtte til operatorer. Med det kan man søge i konteksten og sortere efter relevans.
På den anden side af ringen er LogQL, der anvendes i Loki, en efterfølger til PromQL (Prometheus forespørgselssprog). Den bruger log-tags til at filtrere og vælge logdata. Der er mulighed for at bruge nogle operatorer og aritmetik, som beskrevet , men hvad angår muligheder er den bagud i forhold til Elastic-sproget.
Da forespørgsler i Loki er relateret til tags, er de lette at knytte til metrikker, hvilket gør det lettere at organisere operationel overvågning.
Skalering
Begge stacks er horisontalt skalerbare, men det er lettere med Loki, da den har adskilte veje for læsning og skrivning af data, samt en mikrotjenestearkitektur. Loki kan tilpasses til dine specifikationer og kan bruges til meget store mængder logdata.
Multi-leje
Multi-leje for klynger er et generelt emne til at reducere OPEX, begge stacks understøtter multi-leje. For Elasticsearch er der flere at adskille kunder: en separat indeks for hver kunde, kundebaseret routing, unikke kunde-felter, søgefiltre. I Loki er der i form af HTTP-headeren X-Scope-OrgID.
Omkostninger
Loki er meget omkostningseffektiv, da den ikke indekserer data, men kun metadata. Dette opnår og hukommelse (cache), da objektlagring er billigere end bloklagring, som bruges i Elasticsearch-klynger.
Konklusion
EFK-stakken kan bruges til forskellige formål, hvilket giver maksimal fleksibilitet og et multifunktionelt grænseflade i Kibana til analyse, visualisering og forespørgsler. Den kan yderligere forbedres med maskinlæringsevner.
Loki-stakken er nyttig i Kubernetes-økosystemet på grund af metadata-opdagelsesmekanismen. Det er nemt at matche data til tidsserieovervågning i Grafana og logs.
Når det kommer til omkostninger og langvarig opbevaring af logs, er Loki et fremragende valg for indtræden i cloud-løsninger.
Der er flere alternativer på markedet - nogle kan være bedre for dig. For eksempel tilbyder GKE en integration med Stackdriver, som giver en fremragende løsning til overvågning. Vi inkluderede ikke dem i vores analyse i denne artikel.
Links:
Artiklen er oversat og forberedt til Habr af medarbejdere – intensivkurser, videokurser og virksomhedstræning fra praktiserende specialister (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Kilde: habr.com
