

I dag findes der utallige kurser i Data Science, og det er velkendt, at den største indtjening inden for Data Science ofte kommer fra netop Data Science-kurser (hvorfor grave, når man kan sælge spader?). Den primære ulempe ved disse kurser er, at de ikke har noget med det virkelige arbejde at gøre: Ingen vil give dig rene, behandlede data i det ønskede format. Og når du afslutter dit kursus og begynder at tackle en ægte opgave, dukker der mange nuancer op.
Derfor starter vi en række noter ved navn "Hvad kan gå galt med Data Science", baseret på virkelige hændelser, der er sket for mig, mine venner og kolleger. Vi vil analysere typiske Data Science-opgaver med virkelige eksempler: sådan foregår det faktisk. Vi starter i dag med dataindsamlingsopgaven.
Og det første, folk støder på, når de begynder at arbejde med rigtige data, er faktisk at indsamle de relevante data. Den centrale pointe i denne artikel:
Vi undervurderer systematisk tid, ressourcer og indsats krævet til indsamling, rensning og forberedelse af data.
Og vigtigst af alt, vi vil diskutere, hvad der kan gøres for at undgå dette.
Ifølge forskellige vurderinger tager rensning, transformation, data processing, feature engineering osv. 80-90% af tiden, mens analysen tager 10-20%, mens næsten alt undervisningsmaterialet udelukkende fokuserer på analysen.
Lad os se på en typisk simpel analytisk opgave i tre versioner og se, hvilke "formildende omstændigheder" der kan være.
Og som eksempel vil vi igen se på lignende variationer af dataindsamlingsopgaven og sammenligning af fællesskaber for:
- To subreddits på Reddit
- To sektioner på Habr
- To grupper på Odnoklassniki
En hypotetisk tilgang i teorien
Åbne hjemmesiden og læse eksempler, hvis det giver mening, afsætte et par timer til læsning, et par timer til at kode efter eksemplerne og debugge. Tilføj et par timer til indsamling. Læg nogle timer til overs (gang med to og tilføj N timer).
Det centrale punkt: tidsvurderingen er baseret på antagelser og gætterier om, hvor lang tid det vil tage.
Analysen af tiden bør starte med vurderingen af følgende parametre for den hypotetiske opgave, som beskrevet ovenfor:
- Hvad er datastørrelsen, og hvor meget skal der indsamles fysisk (*se nedenfor*).
- Hvor lang tid tager det at samle en post, og hvor lang tid skal der ventes, inden man kan samle den anden.
- Implementer en kode, der gemmer tilstand og genstarter, når (og ikke hvis) alt går ned.
- Find ud af, om vi har brug for godkendelse, og planlæg tid til at få adgang via API.
- Planlæg antallet af fejl som en funktion af datakompleksitet — vurdér det ud fra den specifikke opgave: struktur, hvor mange transformationer, hvad og hvordan vi udtrækker.
- Planlæg netværksfejl og problemer med projektets uventede adfærd.
- Vurder, om de nødvendige funktioner er i dokumentationen, og hvis de ikke er, hvordan og hvor meget der kræves for en workaround.
Det vigtigste for tidsvurderingen er, at du faktisk skal investere tid og kræfter i »prøvehandling« — kun da vil din planlægning være passende. Så selvom du bliver presset til at sige »hvor lang tid tager det at indsamle data« — find tid til en foranalyse og argumentér for, hvor meget tiden vil variere afhængigt af de reelle parametre for opgaven.
Og nu vil vi demonstrere konkrete eksempler, hvor sådanne parametre vil ændre sig.
Det centrale punkt: vurderingen er baseret på analysen af nøglefaktorer, der påvirker omfanget og kompleksiteten af arbejdet.
Vurdering baseret på gættelser er en god tilgang, når de funktionelle elementer er relativt små, og der ikke er så mange faktorer, der væsentligt kan påvirke opbygningen af opgaven. Men i tilfælde af en række Data Science-opgaver bliver sådanne faktorer ekstremt mange, og denne tilgang bliver inadækvat.
Sammenligning af Reddit-fællesskaber
Lad os starte med det enkleste tilfælde (som senere vil vise sig). For at være helt ærlig, står vi over for et praktisk perfekt tilfælde, lad os tjekke vores kompleksitetscheckliste:
- Der er en pæn, forståelig og dokumenteret API.
- Meget enkelt, og vigtigst af alt, kan man automatisk generere en token.
- Der er — med en masse eksempler.
- Fællesskabet, der arbejder med dataanalyse og indsamling på Reddit (inklusive YouTube-videoer, der forklarer, hvordan man bruger python wrapper) .
- De nødvendige metoder findes sandsynligvis i API'et. Desuden ser koden kompakt og ren ud, nedenfor et eksempel på en funktion, der samler kommentarer til et indlæg.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Udtaget fra samlingen af nyttige værktøjer til indpakning.
Selvom vi har den bedste situation her, er der stadig flere vigtige faktorer fra det virkelige liv at overveje:
- API-limits — vi er nødt til at hente data i batch (vente mellem anmodninger osv.).
- Indsamlingstid — for en fuld analyse og sammenligning skal der afsættes betydelig tid til, at spiders kan gennemsøge subreddit.
- Botten skal køre på en server — du kan ikke bare starte den på din bærbare, pakke den væk i en rygsæk og tage af sted. Derfor kørte jeg alt på en VPS. Med promokoden habrahabr10 kan du spare yderligere 10%.
- Fysisk utilgængelighed af nogle data (de er synlige for administratorer eller for svære at indsamle) — det skal tages i betragtning, ikke alle data kan i praksis indsamles inden for rimelig tid.
- Netværksfejl: arbejde med netværket er svært.
- Dette er levende, rigtige data — de er ikke rene.
Selvfølgelig skal de nævnte nuancer indtænkes i udviklingen. De specifikke timer/dage afhænger af udviklingsoplevelsen eller erfaringen med lignende opgaver, men vi ser, at dette er en udelukkende ingeniøropgave og ikke kræver yderligere indgreb for at løse det — alt kan vurderes godt, nedskrives og gennemføres.
Sammenligning af sektioner på Habr
Lad os gå videre til en mere interessant og ikke-triviel situation med sammenligning af strømme og/eller sektioner på Habr.
Lad os tjekke vores kompleksitetstjekliste — her, for at forstå hvert punkt, skal man allerede lege lidt med selve opgaven og eksperimentere.
- Først tænker du, at der er et API, men det er der ikke. Ja, Habr har et API, men det er kun utilgængeligt for brugere (eller fungerer måske slet ikke).
- Så begynder du bare at parse html — «import requests», hvad kan gå galt?
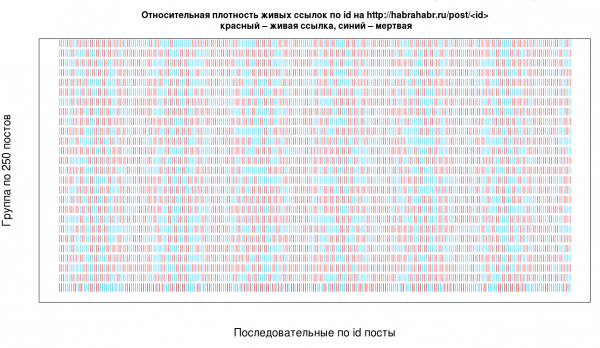
- Men hvordan parser man overhovedet? Den enkleste og mest brugte tilgang er at iterere over ID'er, men det er ikke den mest effektive, og man bliver nødt til at håndtere forskellige tilfælde — for eksempel tæthed af rigtige ID'er blandt alle eksisterende.

Udtaget fra af artiklen. - Rådata indhyllet i HTML over nettet er en smerte. For eksempel ønsker du at indsamle og gemme en artikels vurdering: du har udtrukket score fra HTML'en og besluttet at gemme den som et tal til videre behandling:
1) int(score) giver en fejl: da minus tegnet i Habré, som i strengen "–5", er et kort bindestreg og ikke et minus tegn (uventet, ikke?), så på et tidspunkt måtte jeg få parseren til at leve igen med en sådan frygtelig fix.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Der kan slet ikke være datoer, plusser eller minusser (som vi ser ovenfor i funktionen check_date, og det har været tilfældet).
2) Uescaped specialtegn - de vil komme, man skal være forberedt.
3) Strukturen ændrer sig afhængigt af postenstype.
4) Gamle indlæg kan have **mærkelig struktur**.
- I bund og grund skal man håndtere fejlbehandling og hvad der kan eller ikke kan ske, og man kan ikke forudsige med sikkerhed, hvad der vil gå galt, og hvordan strukturen kan være, og hvad der kan falde fra hinanden - man må bare prøve og tage hensyn til de fejl, som parseren kaster.
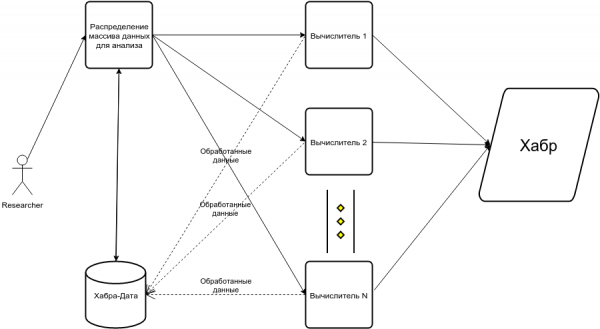
- Derefter indser du, at du skal parse i flere tråde ellers vil parsing i én tråd tage 30+ timer (det er ren køretid for den nuværende enkelttråd parser, der sover og ikke rammer under nogen bans). I artikkelen førte dette på et tidspunkt til en lignende ordning:
Så checklisten for kompleksitet:
- Arbejdet med netværket og parsing af HTML med iteration og looping over ID.
- Dokumenter af ikke-homogen struktur.
- Mange steder, hvor koden nemt kan gå ned.
- Det er nødvendigt at skrive || kode.
- Manglende nødvendig dokumentation, eksempler på kode og/eller et fællesskab.
Den betingede tidsvurdering for denne opgave vil være 3-5 gange højere end for indsamling af data fra Reddit.
Sammenligning af grupper på Odnoklassniki
Lad os gå videre til den mest teknisk interessante sag af dem, der er nævnt. For mig var den interessant, fordi den ved første øjekast ser temmelig triviel ud, men det viser sig slet ikke at være tilfældet - så snart du stikker en pind i den.
Vi starter med vores kompleksitetscheckliste og bemærker, at mange af dem vil være langt mere komplekse, end de ser ud ved første øjekast:
- API'et eksisterer, men det mangler næsten helt de nødvendige funktioner.
- Til bestemte funktioner skal du anmode om adgang via e-mail, så adgangsudbydelsen er ikke øjeblikkelig.
- Den er forfærdelig dokumenteret (for at begynde med, der blandes russiske og engelske termer overalt, og det er fuldstændig inkonsekvent — nogle gange skal du bare gætte, hvad de vil have dig til at gøre et sted) og desuden er den ikke designet til at indsamle data, for eksempel, .
- Den kræver session i dokumentationen, men i praksis bruger den ikke en — og der er ingen måde at forstå alle nuancerne i API-tilstandene på, bortset fra at trykke på og håbe, at noget fungerer.
- Der mangler eksempler og et fællesskab; den eneste støttepunkt til at samle information er en lille i Python (uden mange anvendelseseksempler).
- Den mest fungerende løsning ser ud til at være Selenium, da mange de nødvendige data er låst.
1) Det vil sige, at der er autorisation gennem en fiktiv bruger (og manuel registrering).2) Men med Selenium er der ingen garantier for korrekt og gentagelig funktion (i hvert fald ikke i tilfælde med ok.ru).
3) Ok.ru-webstedet indeholder JavaScript-fejl og opfører sig nogle gange mærkeligt og inkonsekvent.
4) Du skal arbejde med paginering, indlæsning af elementer osv.…
5) API-fejl, som wrapper'en returnerer, skal du håndtere med nødstrategier, for eksempel sådan her (et stykke eksperimentel kode):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#det giver mening at holde styr på allerede behandlede diskussioner
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Min yndlingsfejl var:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)”)6) I sidste ende ser kombinationen af Selenium + API ud til at være den mest rationelle løsning.
- Der er behov for tilstandens bevarelse og systemgenstart, behandling af mange fejl, herunder inkonsekvent opførsel fra webstedet — og disse fejl er ret svære at forestille sig (hvis du ikke professionelt skriver parsere, selvfølgelig).
Den omtrentlige tidsvurdering for denne opgave vil være 3-5 gange højere end for at indsamle data fra Habr. Selvom vi i tilfælde af Habr bruger en brutal tilgang med HTML-parsing, kan vi i kritiske områder med OK arbejde med API.
Konklusioner
Uanset hvor meget man end måtte forlange en vurdering af tidsrammen "på stedet" (vi planlægger trods alt i dag!), kan gennemførelsen af et omfattende data pipeline-modul sjældent vurderes præcist uden en analyse af opgaveparametrene.
Hvis man taler lidt mere filosofisk, så passer strategierne for vurdering i agile-retning godt til ingeniøropgaver, men der opstår vanskeligheder med mere eksperimentelle og på sin vis "kreative" og forskningsrelaterede opgaver, dvs. mindre forudsigelige, som i de eksempler vi har gennemgået her.
Selvfølgelig er dataindsamling et tydeligt illustrativt eksempel — det virker som en helt simpel og teknisk ukompliceret opgave, og det er netop i detaljerne, at dyret ofte gemmer sig. Og det er i denne opgave, man kan se hele spektret af mulige variationer af, hvad der kan gå galt, og hvor lang tid arbejdet faktisk kan tage.
Ser man overfladisk på opgavekarakteristikaene uden yderligere eksperimenter, så ligner Reddit og OK hinanden: der er en API, en python wrapper, men i bund og grund er forskellen enorm. Hvis man vurderer ud fra disse parametre, ser det ud til, at parsing af Habr er mere kompleks end OK — men i praksis er det helt omvendt, og det kan man finde ud af ved at lave simple eksperimenter til analyse af opgaveparametrene.
Efter min erfaring er den mest effektive tilgang en grov tidsvurdering for den indledende analyse og de første enkle eksperimenter, læsning af dokumentationen — det er disse, der vil gøre det muligt for dig at give en præcis vurdering af hele arbejdet. I termerne fra den populære agile metodologi beder jeg om at få oprettet en ticket til "vurdering af opgaveparametre", som jeg kan basere mine vurderinger af, hvad der er muligt at udføre inden for et "sprint", og give en mere præcis vurdering for hver opgave.
Derfor synes det mest effektivt at fremlægge et argument, der ville vise en "ikke-teknisk" specialist, hvor meget tiden og ressourcerne kan variere afhængigt af de parametre, der endnu skal vurderes.
Kilde: habr.com
