

Selvom der i dag findes mange data næsten overalt, er analytiske databaser stadig ret eksotiske. De er dårligt kendt og endnu dårligere udnyttet effektivt. Mange fortsætter med at "spise kaktus" med MySQL eller PostgreSQL, som er designet til andre scenarier, kæmper med NoSQL eller betaler for meget for kommercielle løsninger. ClickHouse ændrer spillereglerne og sænker markant barriererne for at træde ind i verden af analytiske DBMS.
Dette er en præsentation fra BackEnd Conf 2018 og er offentliggjort med foredragsholderens tilladelse.
Hvem er jeg, og hvorfor taler jeg om ClickHouse? Jeg er udviklingsdirektør hos LifeStreet, som bruger ClickHouse. Desuden er jeg grundlægger af Altinity. Dette er en partner til Yandex, der promoverer ClickHouse og hjælper Yandex med at gøre ClickHouse mere succesfuld. Jeg er også klar til at dele min viden om ClickHouse.
Og jeg er ikke bror til Petja Zaitsev. Jeg bliver ofte spurgt om det. Nej, vi er ikke brødre.
»Alle ved«, at ClickHouse:
- Er meget hurtig,
- Er meget brugervenlig,
- Bruges i Yandex.
Lidt mindre kendt er, i hvilke virksomheder og hvordan det bruges.
Jeg vil fortælle jer, hvad, hvor og hvordan ClickHouse bruges, udover Yandex.
Jeg vil fortælle, hvordan specifikke opgaver løses med ClickHouse i forskellige virksomheder, hvilke værktøjer ClickHouse kan bruges til i jeres opgaver, og hvordan de er blevet brugt i forskellige virksomheder.
Jeg har fundet tre eksempler, der viser ClickHouse fra forskellige vinkler. Jeg tror, det vil være interessant.
Det første spørgsmål: "Hvorfor er ClickHouse nødvendigt?" Det virker som et ret åbenlyst spørgsmål, men der er mere end ét svar på det.
- Det første svar – på grund af ydeevnen. ClickHouse er meget hurtig. Analyse med ClickHouse er også meget hurtig. Den kan ofte bruges der, hvor noget andet fungerer meget langsomt eller meget dårligt.
- Det andet svar – det er omkostningerne. Og i første omgang omkostningerne ved skalering. For eksempel er Vertica en fremragende database. Den fungerer rigtig godt, hvis du har ikke så mange terabyte data. Men når det drejer sig om hundreder af terabyte eller petabyte, bliver licens- og supportomkostningerne ret betydelige. Og det er dyrt. ClickHouse derimod er gratis.
- Den tredje respons er driftsomkostningen. Dette er en tilgang set fra en lidt anden vinkel. RedShift er et fremragende alternativ. Med RedShift kan man hurtigt finde en løsning. Det vil fungere godt, men man vil hver time, hver dag og hver måned betale en relativt høj pris til Amazon, fordi det er en betydeligt dyr service. Google BigQuery også. Hvis nogen har brugt det, ved de, at man kan køre flere forespørgsler og pludselig få en regning på hundrede dollars.
I ClickHouse er der ikke disse problemer.
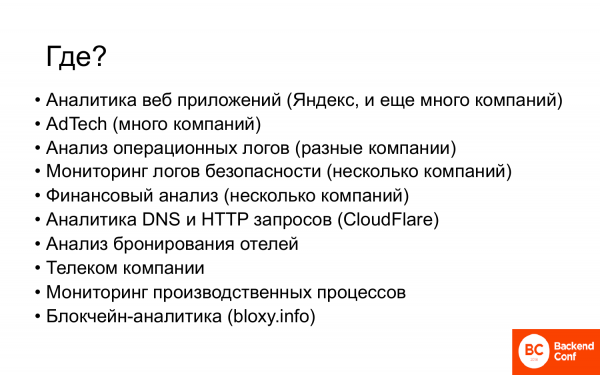
Hvor bruges ClickHouse nu? Udover Yandex bruges ClickHouse i mange forskellige forretninger og virksomheder.
- Først og fremmest til analyse af webapplikationer, dvs. det er et use case, der kommer fra Yandex.
- Mange AdTech-virksomheder bruger ClickHouse.
- Talrige virksomheder, der har brug for at analysere driftslogger fra forskellige kilder.
- Flere virksomheder bruger ClickHouse til overvågning af sikkerhedslogs. De uploader dem til ClickHouse, laver rapporter og får de nødvendige resultater.
- Virksomheder begynder at bruge det til finansiel analyse; dvs. gradvist også store virksomheder nærmer sig ClickHouse.
- CloudFlare. Hvis nogen følger med i ClickHouse, har de nok hørt om denne virksomhed. Det er en af de væsentlige bidragydere fra community'et. Og de har en meget seriøs ClickHouse-installation. For eksempel har de lavet Kafka Engine til ClickHouse.
- Telekommunikationsfirmaer er begyndt at bruge det. Flere virksomheder bruger ClickHouse enten som proof of concept eller allerede i produktion.
- Én virksomhed bruger ClickHouse til overvågning af produktionsprocesser. De tester mikrochips, registrerer mange parametre, omkring 2.000 karakteristika, og analyserer derefter – er det en god eller dårlig batch.
- Blockchain-analyse. Der er et russisk firma ved navn Bloxy.info. Dette er analyse af Ethereum-netværket. De har også lavet det på ClickHouse.
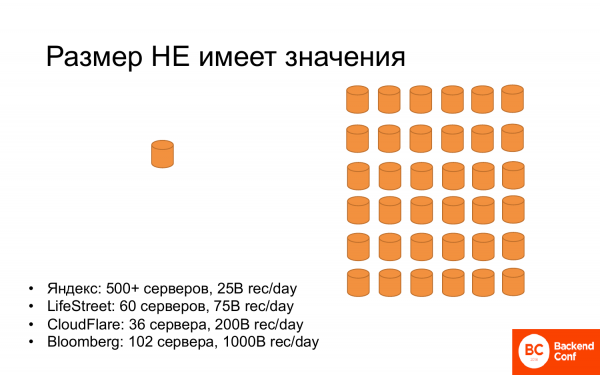
Desuden har størrelsen ingen betydning. Der er mange virksomheder, der bruger en lille server. Og den tillader dem at løse deres problemer. Endnu flere virksomheder bruger store klynger af mange servere eller dusinvis af servere.
Og hvis man ser på rekorderne:
- Yandex: 500+ servere, de gemmer 25 milliarder poster om dagen.
- LifeStreet: 60 servere, cirka 75 milliarder poster om dagen. Færre servere, flere poster end i Yandex.
- CloudFlare: 36 servere, de gemmer 200 milliarder poster om dagen. De har færre servere og gemmer endnu mere data.
- Bloomberg: 102 server, omtrent en billion poster om dagen. Rekordholder for poster.
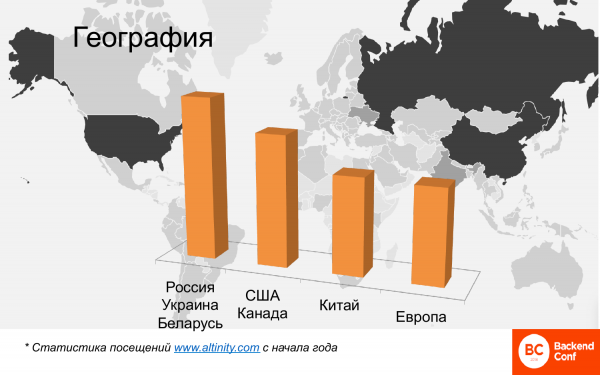
Geografisk set er det også meget. Kortet her viser heatmap, hvor ClickHouse bruges i verden. Her fremhæves Rusland, Kina, Amerika tydeligt. Der er få europæiske lande. Og vi kan udpege 4 klynger.
Dette er en komparativ analyse, her skal man ikke lede efter absolutte tal. Det er en analyse af besøgende, der læser engelsksprogede materialer på Altinitys hjemmeside, fordi der ikke er nogen russisktalende der. Rusland, Ukraine, Hviderusland, altså den russisk talende del af samfundet, er de mest talrige brugere. Derefter følger USA og Canada. Kina nærmer sig meget hurtigt. For seks måneder siden var Kina næsten ikke til stede, nu har Kina allerede overhalet Europa og fortsætter med at vokse. Gamle Europa hænger heller ikke bagefter, og overraskende nok er Frankrig lederen i brugen af ClickHouse.
Hvorfor fortæller jeg alt dette? For at vise, at ClickHouse bliver en standardløsning til analyse af store data og allerede bruges mange steder. Hvis du bruger det, er du med på den rigtige trend. Hvis du endnu ikke bruger det, behøver du ikke frygte at stå alene, og at der ikke er nogen, der vil hjælpe dig, for mange beskæftiger sig allerede med det.
Dette er eksempler på reel brug af ClickHouse i flere virksomheder.
- Det første eksempel er et annoncesystem: migration fra Vertica til ClickHouse. Jeg kender flere virksomheder, der har skiftet fra Vertica eller er i gang med at skifte.
- Det andet eksempel er et transaktionslager på ClickHouse. Dette eksempel er bygget på antipatterns. Alt, hvad man ikke skal gøre i ClickHouse ifølge udviklernes råd, er gjort her. Og alligevel er det gjort så effektivt, at det fungerer. Og det fungerer langt bedre end en typisk transaktionel løsning.
- Det tredje eksempel er distribuerede beregninger på ClickHouse. Der var et spørgsmål om, hvordan ClickHouse kan integreres i Hadoop-økosystemet. Jeg vil vise et eksempel på, hvordan en virksomhed har lavet noget, der ligner en map-reduce beholder på ClickHouse, mens de holder øje med dataenes lokalisering osv., for at løse en meget ikke-triviel opgave.
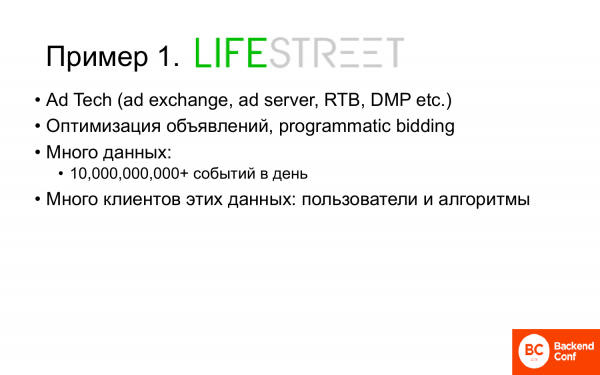
- LifeStreet – Dette er et Ad Tech-firma, der har alle de teknologier, der er forbundet med et annoncesystem.
- Det beskæftiger sig med optimering af annoncer, programmatisk budgivning.
- Store data: around 10 billion events per day. At the same time, these events can be split into several sub-events.
- Many clients require this data, and it’s not just people; there are numerous algorithms involved in programmatic bidding.
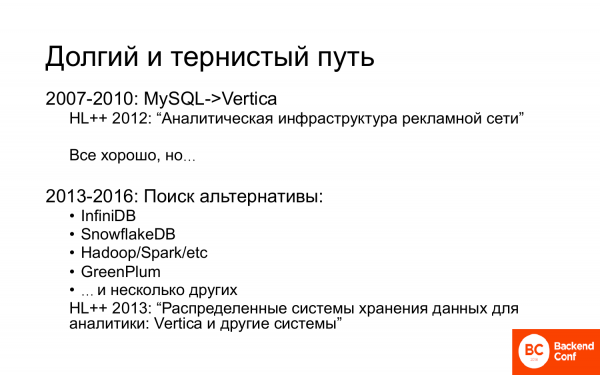
The company has gone through a long and challenging path. I shared details about it at HighLoad. Initially, LifeStreet transitioned from MySQL (with a brief stop at Oracle) to Vertica. You can find more about it.
Everything was going well, but it quickly became clear that data was growing and Vertica was expensive. Therefore, various alternatives were sought. Some of them are listed here. In fact, we conducted a proof of concept or performance testing for almost all databases available in the market from 2013 to 2016 that roughly matched our functional requirements. I discussed some of them at HighLoad as well.
The task was to migrate from Vertica first because data was growing. It grew exponentially for several years. Then it leveled off, but nevertheless. Anticipating this growth, and the business requirements for the volume of data to be analyzed, it was clear that discussions about petabytes would soon arise. And paying for petabytes is very costly, so we were looking for an alternative.
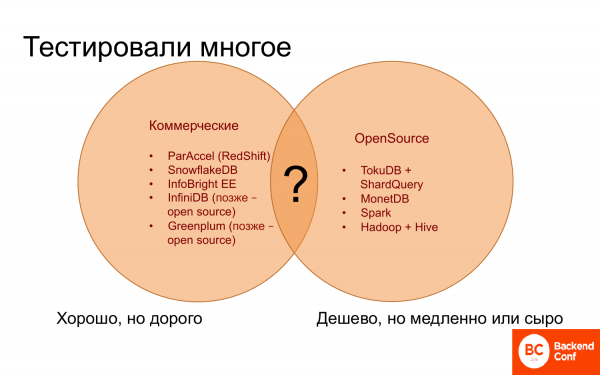
Where to go? For a long time, it was completely unclear where to go, because on one hand, there are commercial databases that seem to work quite well. Some perform almost as well as Vertica, while others are less effective. But they are all expensive, and nothing cheaper or better could be found.
On the other hand, there are a few open-source solutions which can be counted on your fingers for analytics. They are free or inexpensive, but operate slowly. Additionally, they often lack the necessary and useful functionalities.
And to find something that combines the best features of commercial databases and everything available in open source — there was nothing.
There was nothing until Yandex unexpectedly pulled ClickHouse out like a rabbit from a magician's hat. It was an unexpected solution, and questions like 'Why?' are still being asked, but nonetheless.
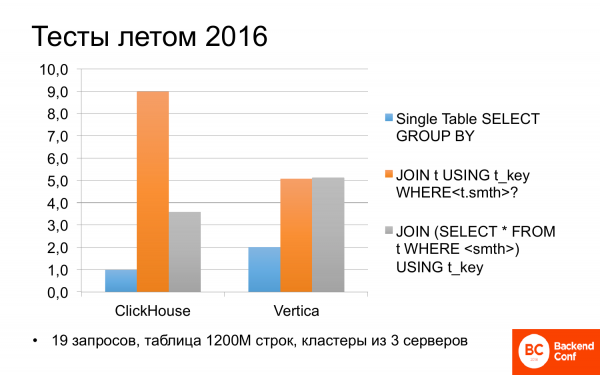
Og straks sommeren 2016 begyndte vi at se, hvad ClickHouse kunne. Og det viste sig, at det nogle gange kan være hurtigere end Vertica. Vi testede forskellige scenarier med forskellige forespørgsler. Og hvis forespørgslen kun brugte én tabel, altså uden nogen join, så var ClickHouse to gange hurtigere end Vertica.
Jeg gad ikke se bort fra, at jeg kiggede på Yandex' tests for nylig. Der var det det samme: ClickHouse var to gange hurtigere end Vertica, og derfor taler de ofte om det.
Men hvis der er joins i forespørgslerne, så bliver alt lidt mere uklart. Og ClickHouse kan være to gange langsommere end Vertica. Hvis vi justerer forespørgslen lidt og omskriver den, så bliver de nogenlunde lige. Ikke dårligt. Og gratis.
Og efter at have fået testresultaterne og set på det fra forskellige vinkler, tog LifeStreet over til ClickHouse.
Dette er 2016, husk. Det var som i en anekdote om musene, der græd og stak sig, men fortsatte med at spise kaktussen. Og dette blev beskrevet i detaljer, der findes videoer om det osv.
Derfor vil jeg ikke gå i detaljer om det, men kun fortælle om resultaterne og nogle interessante ting, som jeg ikke nævnte dengang.
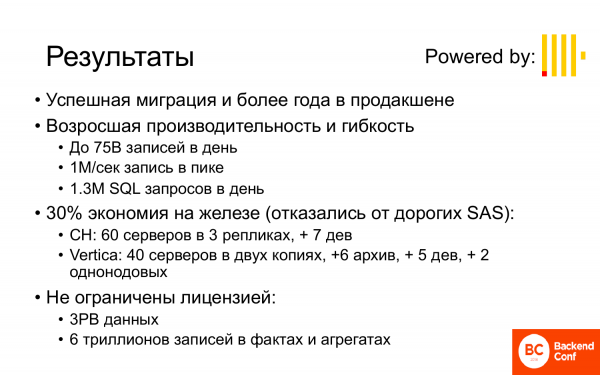
Resultaterne er:
- En vellykket migration, og systemet har allerede været i produktion i mere end et år.
- Ydelsen og fleksibiliteten er steget. Af de 10 milliarder poster, vi kunne tillade os at opbevare på en dag, men kun i kort tid, opbevarer LifeStreet nu 75 milliarder poster på en dag og kan gøre det i 3 måneder eller mere. I spidsbelastning er det op til en million hændelser pr. sekund, der gemmes. Mere end en million SQL-forespørgsler ankommer til dette system hver dag, primært fra forskellige bots.
- På trods af at der blev brugt flere servere til ClickHouse end til Vertica, opnåede vi besparelser på hardware, fordi Vertica brugte ret dyre SAS-diske. I ClickHouse blev der brugt SATA. Og hvorfor? Fordi vertica-inserts er synkrone. Og synkronisering kræver, at diskene ikke bremser for meget, og at netværket heller ikke bremser meget, det er en relativt dyr operation. Men i ClickHouse er insert asynkrone. Desuden kan man altid skrive lokalt, der er ingen ekstra omkostninger ved det, så data kan indsættes i ClickHouse meget hurtigere end i Vertica, selv på ikke de hurtigste diske. Læsning er omtrent den samme. Læsning på SATA, hvis de er i RAID, så går det hele ret hurtigt.
- Uden licensbegrænsninger, dvs. 3 petabyte data på 60 servere (20 servere – en kopi) og 6 trillioner optegnelser i fakta og aggregationer. Intet lignende kunne lade sig gøre på Vertica.
Nu går jeg videre til de praktiske aspekter i dette eksempel.
- Det første er et effektivt schema. Schemat afhænger af meget.
- Det andet er generation af effektiv SQL.
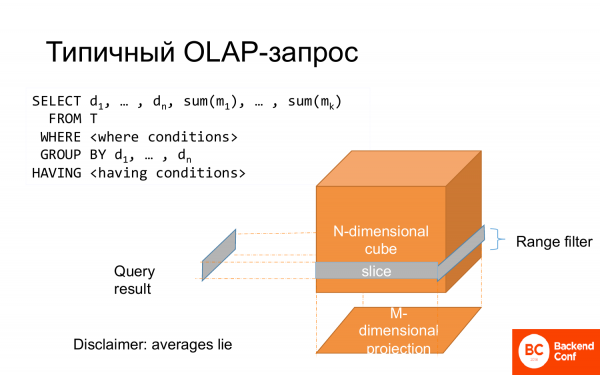
En typisk OLAP-forespørgsel er en select. Nogle kolonner går til group by, mens andre kolonner bruges i aggregatfunktioner. Der er en where-klausul, som kan betragtes som et udsnit af kuben. Hele group by kan ses som en projektion. Derfor kaldes det multimensionel dataanalyse.
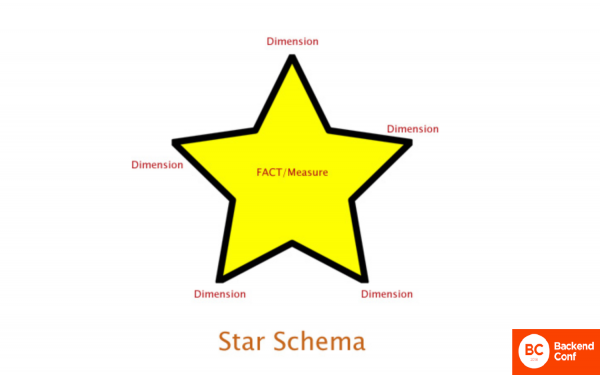
Oftest modelleres dette i form af et star-schema, hvor der er et centralt faktum og karakteristika for dette faktum i retningerne.
Og med hensyn til det fysiske design, dvs. hvordan det placeres i tabellen, laves der normalt en normaliseret repræsentation. Du kan denormalisere, men det er dyrt i diskplads og ikke særlig effektivt med forespørgsler. Derfor laver man normalt en normaliseret repræsentation, dvs. en fakta-tabel og mange-mange dimensions-tabeller.
Men i ClickHouse fungerer dette dårligt. Der er to grunde:
- Den første er, at ClickHouse ikke har særligt gode joins, dvs. der findes joins, men de er dårlige. Indtil videre er de dårlige.
- Den anden grund er, at tabellerne ikke opdateres. Normalt i disse små tabeller omkring star-schemaet, skal der ændres noget. For eksempel kunde-navn, firmanavn osv. Og det fungerer ikke.
Og der er en løsning på dette i ClickHouse. Faktisk er der to:
- Det første er brugen af ordbøger. Eksterne ordbøger er noget, der hjælper med at løse problemet med star-schemaet, opdateringer osv. med 99 %.
- Det andet er brugen af arrays. Arrays hjælper også med at slippe for joins og problemer med normalisering.
- Joins er ikke nødvendige.
- Opdaterbare. Fra marts 2018 blev der introduceret en uudokumenteret mulighed (du finder det ikke i dokumentationen) for delvist at opdatere ordbøger, dvs. de optegnelser, der er ændret. For praktisk talt er det som en tabel.
- Altid i hukommelsen, derfor fungerer joins med ordbøger hurtigere end hvis det var en tabel, der ligger på disken, og man kan ikke være sikker på, at den er i cache, sandsynligvis er den ikke.
- Joins er også ikke nødvendige.
- Dette er en kompakt repræsentation 1 til mange.
- Og efter min mening er arrays lavet til nørder. Det er lambda-funktioner og andet.
Dette er ikke bare for at sige det. Det er en meget kraftfuld funktionalitet, der gør mange ting meget enkelt og elegant.
Typiske eksempler, der hjælper med at håndtere arrays. Disse eksempler er enkle og ret illustrative:
- Søgning efter tags. Hvis du har hashtags der, og du vil finde nogle indlæg efter hashtag.
- Søgning efter key-value par. Der er også nogle attributter med værdier.
- Opbevaring af lister med nøgler, som du skal oversætte til noget andet.
Alle disse opgaver kan løses uden arrays. Tags kan placeres i en enkelt linje og vælges med et regulært udtryk, eller i en separat tabel, men så skal du lave joins.
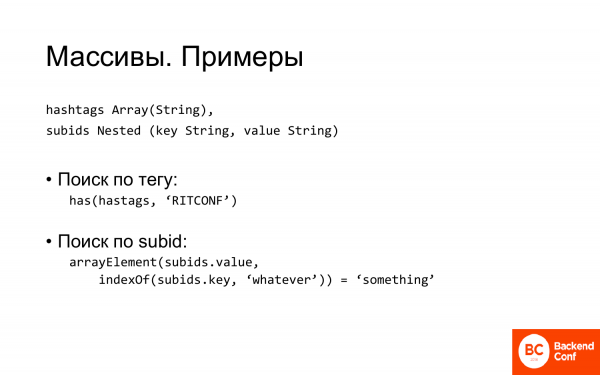
I ClickHouse skal du ikke gøre noget, det er nok at beskrive et array af string til hashtags, eller lave en indlejret struktur til systemer af typen key-value.
Indlejret struktur – det er måske ikke det bedste navn. Det er to arrays, der har en fælles del i navnet og nogle relaterede egenskaber.
Og det er meget enkelt at søge efter tags. Der er en funktion has, der kontrollerer, om der er et element i arrayet. Vi har fundet alle indlæg, der relaterer sig til vores konference.
Søgningen efter subid er lidt mere kompliceret. Vi skal først finde indekset af nøglen, og derefter tage elementet med dette indeks og kontrollere, at værdien er den, vi har brug for. Men det er stadig meget enkelt og kompakt.
Det regulære udtryk, du ville skrive, hvis du gemte alt dette i en enkelt linje, ville for det første være klodset. Og for det andet ville det tage meget længere tid at køre end to arrays.
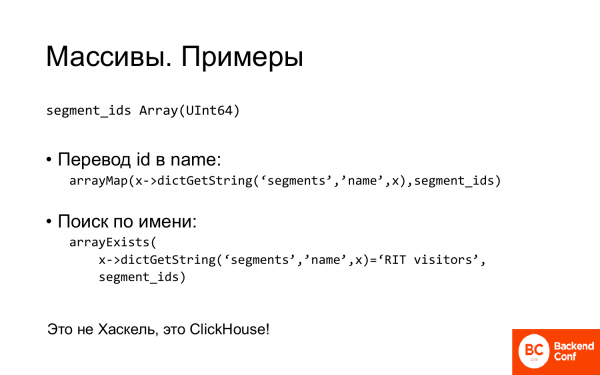
Et andet eksempel. Du har et array, hvor du gemmer ID'er. Og du kan oversætte dem til navne. Funktionen arrayMap. Dette er en typisk lambda-funktion. Du sender lambda-udtryk dertil. Og den henter værdien af navnet for hver ID fra ordbogen.
På samme måde kan du lave en søgning. En prædikatsfunktion sendes ind, der kontrollerer, hvad elementerne svarer til.
Disse ting forenkler helt klart skemaet og løser mange problemer.
Men det næste problem, vi stødte på, og som jeg gerne vil nævne, er effektive forespørgsler.
- I ClickHouse er der ingen forespørgselsplanlægger. Overhovedet ikke.
- Men komplekse forespørgsler skal stadig planlægges. I hvilke tilfælde?
- Hvis forespørgslen indeholder flere joins, som du pakker ind i underforespørgsler, så har rækkefølgen, de udføres i, betydning.
- Og for det andet – hvis forespørgslen er distribueret. Fordi i en distribueret forespørgsel udføres kun den inderste underforespørgsel distribueret, mens alt andet sendes til en server, som du er tilsluttet, og udføres der. Derfor, hvis du har distribuerede forespørgsler med mange joins, er det vigtigt at vælge rækkefølgen.
Og selv i enklere tilfælde kan det nogle gange være nødvendigt at udføre planlægningsarbejdet og ændre forespørgslerne en smule.
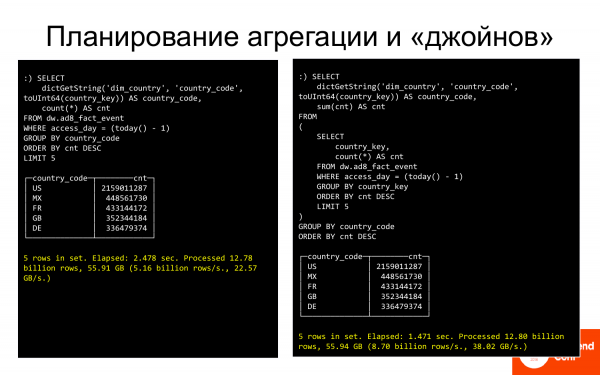
Her er et eksempel. I venstre side er der en forespørgsel, der viser de 5 bedste lande. Og den tager 2,5 sekunder, mener jeg. På højre side er den samme forespørgsel, men lidt ændret. Vi er i stedet for at gruppere efter streng, begyndt at gruppere efter nøgle (int). Og det er hurtigere. Derefter tilsluttede vi en ordbog til resultatet. I stedet for 2,5 sekunder tager forespørgslen 1,5 sekunder. Det er godt.
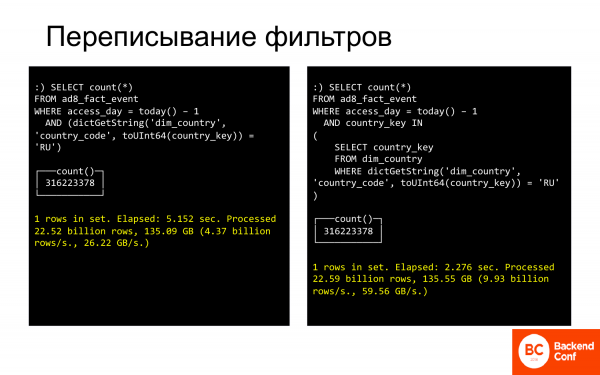
Et lignende eksempel med omskrivning af filtre. Her er der en forespørgsel om Rusland. Den tager 5 sekunder. Hvis vi omskriver den på en måde, så vi sammenligner igen ikke streng, men tal med et sæt af de nøgler, der relaterer til Rusland, så vil det være meget hurtigere.
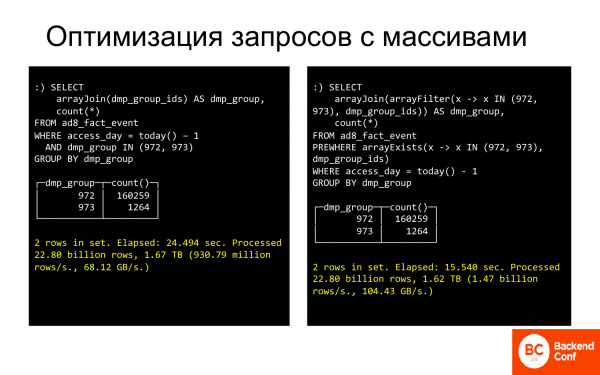
Der er mange sådanne tricks. Og de gør det muligt at væsentligt fremskynde forespørgsler, som du måske tror allerede fungerer hurtigt, eller omvendt, fungerer langsomt. De kan gøres endnu hurtigere.
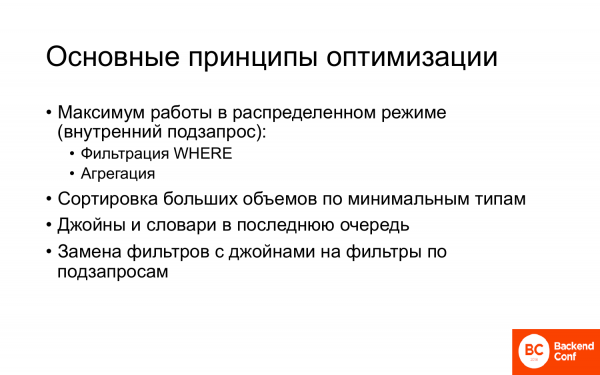
- Maksimal arbejdsindsats i distribueret tilstand.
- Sortering efter de mindste typer, som jeg gjorde med int.
- Hvis der er nogen joins, ordbøger, er det bedst at lave dem som det sidste, når du allerede har data, der i det mindste er delvist grupperet, så vil join- eller ordbogsoperationen blive kaldt færre gange, og det vil være hurtigere.
- Udskiftning af filtre.
Der er også andre teknikker, ikke kun dem, jeg har vist. Og alle disse tillader nogle gange at væsentligt fremskynde udførelsen af forespørgsler.
Lad os gå videre til det næste eksempel. Firma X fra USA. Hvad gør det?
Opgaven var:
- Offline forbindelser mellem reklame transaktioner.
- Modellering af forskellige forbindelsesmodeller.
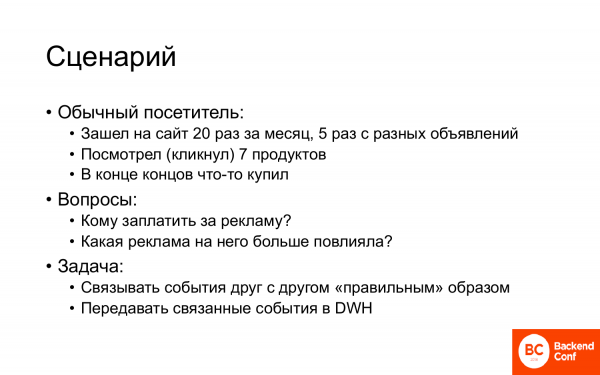
Hvad består scenariet i?
En almindelig besøgende besøger hjemmesiden eksempelvis 20 gange om måneden fra forskellige annoncer eller bare uafhængigt af annoncer, fordi de husker denne side. De ser på nogle produkter, lægger dem i kurven, fjerner dem fra kurven. Og til sidst køber de noget.
Relevante spørgsmål: "Hvem skal betale for reklamen, hvis det er nødvendigt?" og "Hvilken reklame påvirkede dem, hvis nogen?" Altså, hvorfor købte de, og hvordan kan vi få mennesker, der minder om denne person, til også at købe?
For at løse denne opgave skal man forbinde begivenhederne, der sker på webstedet på korrekt måde, altså skabe nogle forbindelser mellem dem. Derefter skal de sendes til analyse i DWH. På baggrund af denne analyse opbygges modeller for, hvem og hvilken reklame der skal vises.
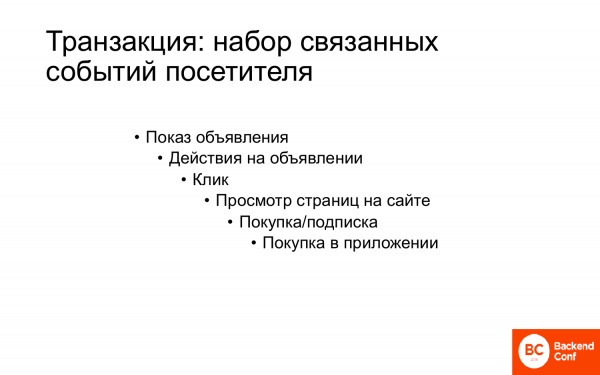
En reklame-transaction er et sæt af relaterede brugerbegivenheder, der starter med visningen af en annonce, derefter sker der noget, så måske et køb, og der kan muligvis være flere køb relateret til dette køb. For eksempel, hvis dette er en mobilapplikation eller et mobilspil, så sker installationen typisk gratis, men hvis der laves flere handlinger, kan det kræve penge. Og jo mere en person bruger i applikationen, jo mere værdifuld er de. Men for dette skal alt binds sammen.
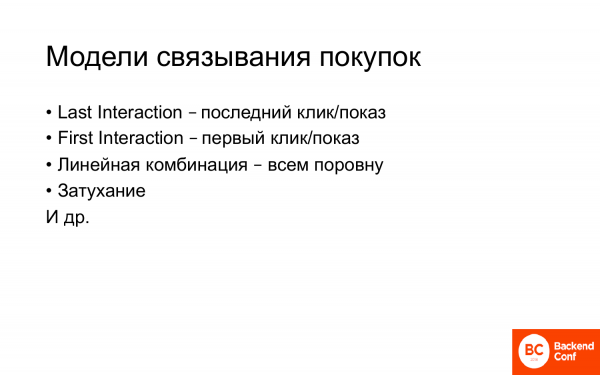
Der er mange modeller for at forbinde.
De mest populære er:
- Last Interaction, hvor interaction er enten et klik eller en visning.
- First Interaction, det vil sige den første ting, der førte personen til hjemmesiden.
- Lineær kombination – alle får lige meget.
- Uddøen.
- Og andet.
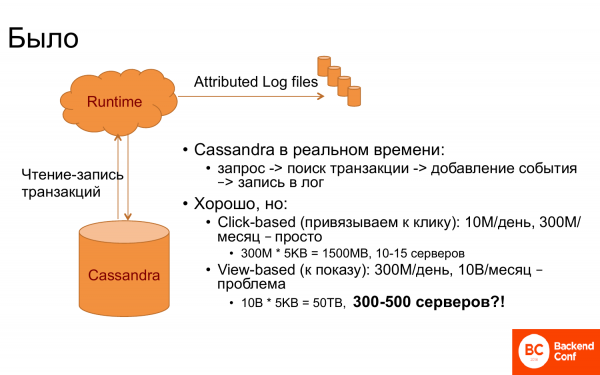
Og hvordan fungerede det hele oprindeligt? Der var Runtime og Cassandra. Cassandra blev brugt som transaction storage, det vil sige, at den opbevarede alle relaterede transaktioner. Når en begivenhed kom til Runtime, for eksempel visning af en side eller noget andet, blev der lavet en forespørgsel til Cassandra – eksisterede denne person eller ej. Derefter blev transaktionerne, der vedrørte dem, hentet. Og så blev der lavet en forbindelse.
Og hvis man var heldig, at forespørgslen indeholdt et transaction id, så var det nemt. Men ofte er man ikke heldig. Derfor skulle man finde den seneste transaktion eller transaktionen ved sidste klik osv.
Og det fungerede allesammen rigtig godt, så længe bindingen var til det sidste klik. Fordi der er 10 millioner klik om dagen, 300 millioner om måneden, hvis man sætter vinduet til en måned. Og da dette i Cassandra skal være i hukommelsen for at fungere hurtigt, fordi Runtime skal svare hurtigt, krævede det omtrent 10-15 servere.
Men da man ville knytte transaktionen til visningen, blev det med det samme ikke så sjovt. Og hvorfor? Det var tydeligt, at der skulle gemmes 30 gange flere begivenheder. Og derfor er der brug for 30 gange flere servere. Og det viser sig, at det er et astronomisk tal. At skulle holde op til 500 servere for at lave bindingen, samtidig med at der er betydeligt færre servere i Runtime, er et forkert tal. Man begyndte at tænke på, hvad der skulle gøres.
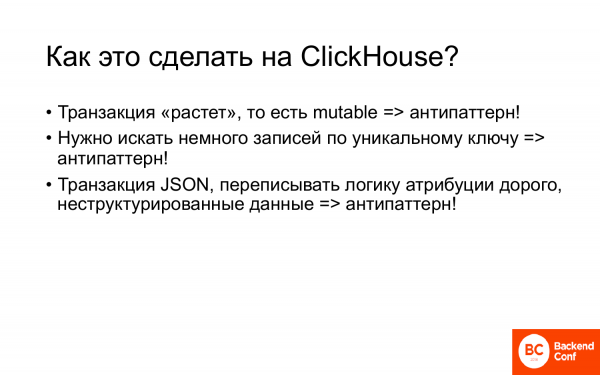
Og man endte med ClickHouse. Men hvordan gør man det på ClickHouse? Ved første øjekast virker det som et sæt antipatterns.
- Transaktionen vokser, vi tilknytter flere og flere nye begivenheder til den, det vil sige, den er mutable, og ClickHouse fungerer ikke så godt med mutable objekter.
- Når der kommer en besøgende til os, skal vi trække hans transaktioner ud efter nøglen, efter hans visit id. Det er også et point query, som ikke gøres sådan i ClickHouse. Normalt i ClickHouse er der store... scanninger, men her har vi brug for at få fat i et par poster. Også et antipattern.
- Derudover var transaktionen i json, men man ønskede ikke at omskrive den, så man ville opbevare json ustruktureret, og hvis det er nødvendigt, trække noget ud af den. Og det er også et antipattern.
Det vil sige et sæt antipatterns.
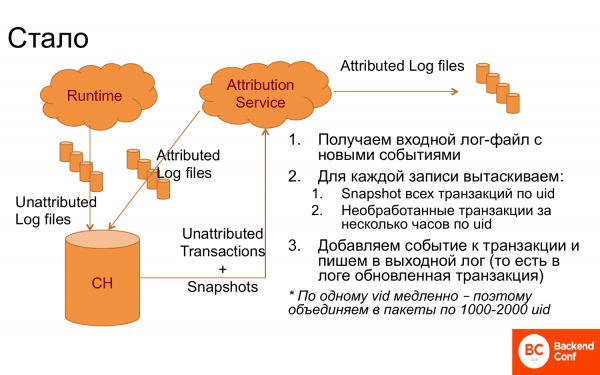
Men alligevel lykkedes det at lave et system, der fungerede meget godt.
Hvad blev gjort? ClickHouse dukkede op, hvor loggene blev kastet ind og opdelt i poster. Der kom en attributt service, som fik loggene fra ClickHouse. Derefter fik man for hver post efter visit id transaktioner, der muligvis ikke var blevet behandlet, og derudover snapshots, det vil sige transaktioner, der allerede var knyttet, nemlig resultatet af det tidligere arbejde. Herfra blev logikken lavet, den rigtige transaktion blev udvalgt, og nye begivenheder blev tilsluttet. Det blev igen skrevet til loggen. Loggen blev sendt tilbage til ClickHouse, det vil sige, dette er et konstant cyklisk system. Og derudover blev det sendt til DWH for at blive analyseret der.
Det fungerede ikke særlig godt i denne form. For at gøre det lettere for ClickHouse, når forespørgslen kom på visit id, blev disse forespørgsler grupperet i blokke af 1.000-2.000 visit id, og vi trak alle transaktioner for 1.000-2.000 personer. Så begyndte det hele at fungere.
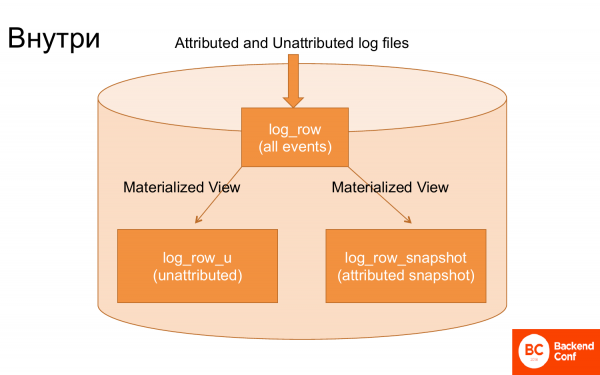
Hvis vi ser ind i ClickHouse, er der kun 3 hovedtabeller, der understøtter dette hele.
Den første tabel, hvor loggene indlæses, og loggene indlæses næsten uden behandling.
Den anden tabel. Gennem materialiseret visning blev de endnu ikke attribuerede hændelser fra disse logge udtrukket, altså urelaterede. Og via materialiseret visning blev transaktioner udtrukket fra disse logge for at danne et snapshot. Specifikt byggede en særlig materialiseret visning snapshot, nemlig den seneste akkumulerede tilstand af transaktionen.
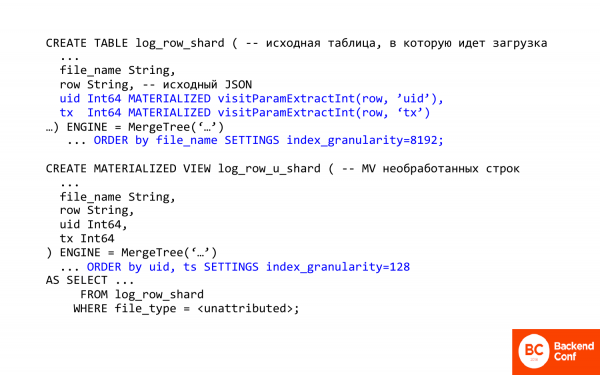
Her er teksten skrevet i SQL. Jeg vil gerne kommentere nogle vigtige ting i den.
Den første vigtige ting er muligheden for at trække kolonner, felter ud af json i ClickHouse. Der er nogle metoder til at arbejde med json. De er meget, meget primitive.
visitParamExtractInt gør det muligt at trække attributter ud af json, altså den første forekomst aktiveres. På den måde kan man udtrække transaction id eller visit id. Det er det første.
For det andet – her bruges et smart materialiseret felt. Hvad betyder det? Det betyder, at du ikke kan indsætte det i tabellen, altså det indsættes ikke; det beregnes og gemmes ved indsættelse. Ved indsættelse udfører ClickHouse arbejdet for dig. Og det, du senere har brug for, trækkes ud af json.
I dette tilfælde er materialiseret visning for ubehandlede rækker. Og den bruger den første tabel med næsten rå logs. Hvad gør det? For det første ændrer det sorteringen, altså sorteringen går nu efter visit id, fordi vi hurtigt skal trække transaktionen for en bestemt person.
Den anden vigtige ting er index_granularity. Hvis du har set MergeTree, så er index_granularity normalt sat til 8.192 som standard. Hvad er det? Dette er parameteren for indexets sparsommelighed. I ClickHouse er indekset sparsomt, det indekserer aldrig hver post. Det gør det hver 8.192. Og det er godt, når der kræves mange data at tælle, men dårligt, når det er lidt, fordi det giver en stor overhead. Hvis man reducerer index granularity, reducerer man overhead. Det kan ikke reduceres til én, fordi der måske ikke er nok hukommelse. Indekset opbevares altid i hukommelsen.
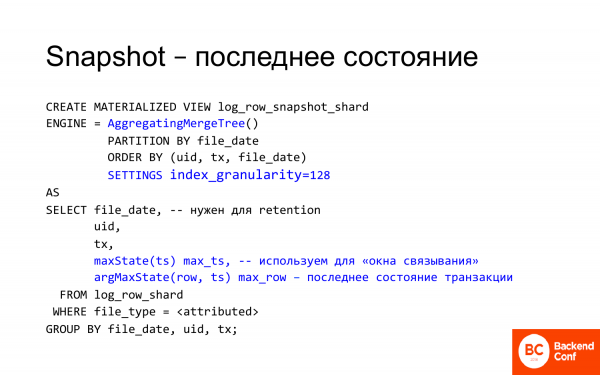
Og snapshot bruger nogle interessante funktioner i ClickHouse.
For det første er det AggregatingMergeTree. Og i AggregatingMergeTree opbevares argMax, dvs. det er tilstanden af transaktionen, der svarer til den seneste timestamp. Transaktioner genereres hele tiden nye for denne besøgte bruger. Og i den seneste tilstand af denne transaktion tilføjede vi en hændelse, og vi fik en ny tilstand. Den kom igen ind i ClickHouse. Og gennem argMax i denne materialiserede visning kan vi altid få den aktuelle tilstand.
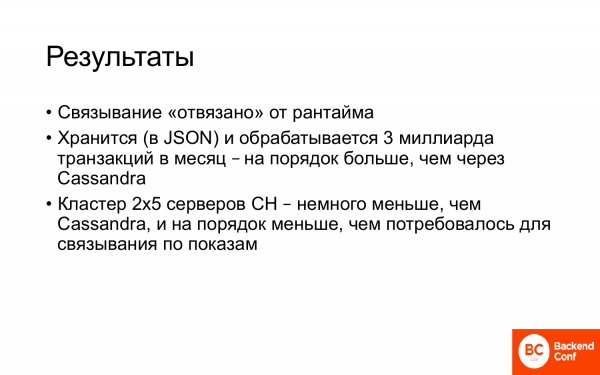
- Bindingen er 'uafhængig' af Runtime.
- Der gemmes og behandles op til 3 milliarder transaktioner om måneden. Det er en orden mere end i Cassandra, dvs. i et typisk transaktionssystem.
- Clusteret består af 2x5 ClickHouse-servere. 5 servere, og hver server har en replika. Det er endda færre end der var i Cassandra for at lave click based attribution, og her har vi impression based. Dvs. i stedet for at øge antallet af servere 30 gange, er det blevet muligt at reducere dem.
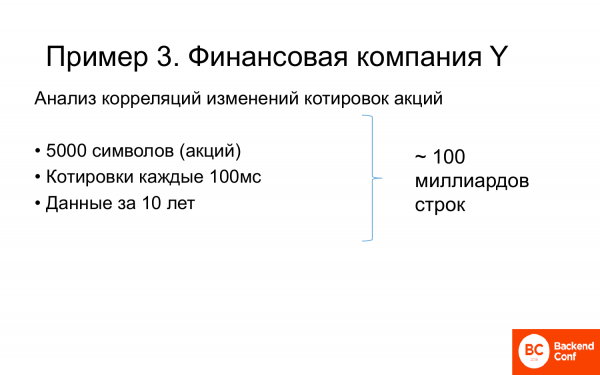
Og et sidste eksempel er finansfirma Y, som analyserede korrelationer mellem aktiekurser.
Og opgaven var som følger:
- Der er cirka 5.000 aktier.
- Kursene er kendt hvert 100. millisekund.
- Dataene er samlet i 10 år. For nogle virksomheder er det muligvis mere, for andre mindre.
- I alt cirka 100 milliarder rækker.
Og det var nødvendigt at beregne korrelationen mellem ændringerne.
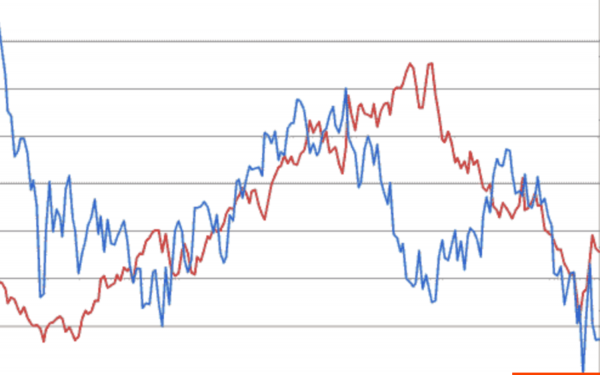
Her er der to aktier og deres kurser. Hvis den ene går op, og den anden går op, så er det en positiv korrelation, dvs. den ene stiger, og den anden stiger. Hvis den ene går op, som i slutningen af grafen, og den anden går ned, så er det en negativ korrelation, dvs. når den ene stiger, falder den anden.
Ved at analysere disse gensidige ændringer kan man lave forudsigelser på finansmarkedet.
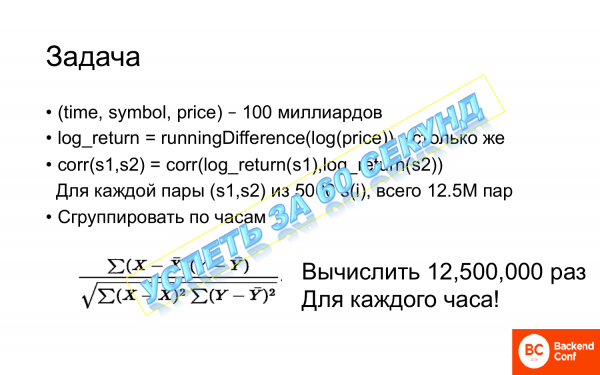
Men opgaven er kompleks. Hvad gøres der for dette? Vi har 100 milliarder poster, der indeholder: tid, aktie og pris. Vi skal først beregne runningDifference fra prisalgoritmen 100 milliarder gange. RunningDifference er en funktion i ClickHouse, der beregner forskellen mellem to rækker sekventielt.
Og efter dette skal korrelationen beregnes, og den skal beregnes for hvert par. For 5.000 aktier er der 12,5 millioner par. Og det er meget, dvs. 12,5 gange skal en sådan korrelationsfunktion beregnes.
Og hvis nogen har glemt det, så er ͞x og ͞y det matematiske forventningsværdi for prøverne. Det vil sige, at man ikke bare skal regne rødder og summer, men også lave yderligere summer inden for disse summer. En hel masse beregninger skal udføres 12,5 millioner gange, og så skal de grupperes efter timer. Og vi har også mange timer. Og det skal gøres inden for 60 sekunder. Det er en spøg.
Vi skulle helst nå det på en eller anden måde, for alt dette fungerede meget, meget langsomt, før ClickHouse kom.
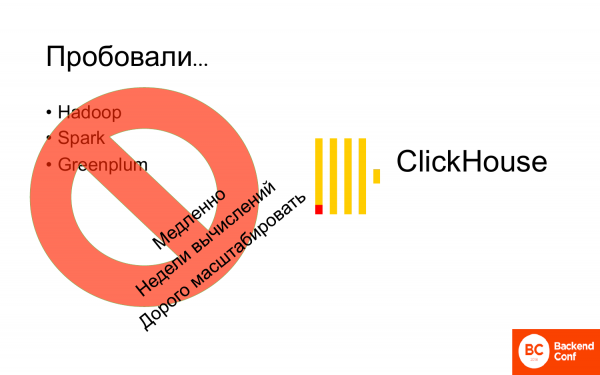
De prøvede at beregne det på Hadoop, på Spark, på Greenplum. Og alt dette var meget langsomt eller dyrt. Det vil sige, at det kunne beregnes på en eller anden måde, men det var derefter dyrt.
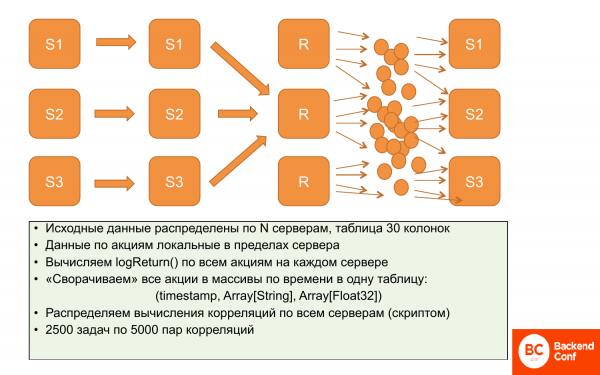
Og så kom ClickHouse, og alt blev meget bedre.
Jeg minder om, at vi har et problem med lokalitet af data, da korrelationer ikke kan lokaliseres. Vi kan ikke lægge en del data på én server, en del på en anden og derefter beregne; vi skal have alle data overalt.
Hvad gjorde de? Oprindeligt var dataene lokaliserede. På hver af serverne er der data om prissætning af et bestemt udvalg af aktier. Og de overlapper ikke. Derfor kan logReturn beregnes parallelt og uafhængigt, alt dette sker mens det er parallelt og distribueret.
Derefter besluttede de at reducere disse data uden at miste udtryksfuldheden. At reducere ved hjælp af arrays, altså for hver tidsperiode at lave et array af aktier og et array af priser. På den måde fylder dataene meget mindre. Og de er også lettere at arbejde med. Det er næsten parallelle operationer, det vil sige, at vi delvist beregner parallelt og derefter skriver til serveren.
Efter dette kan det replikeres. Bogstavet „r“ betyder, at vi har replikeret disse data. Det vil sige, at vi har de samme data på alle tre servere – netop disse arrays.
Og derefter kan man med et specielt script lave pakker fra dette sæt på 12,5 millioner korrelationer, der skal beregnes. Det vil sige 2.500 opgaver med 5.000 par korrelationer. Og denne opgave kan beregnes på en bestemt ClickHouse-server. Alle dataene er der, fordi dataene er ens, og den kan beregne dem sekventielt.
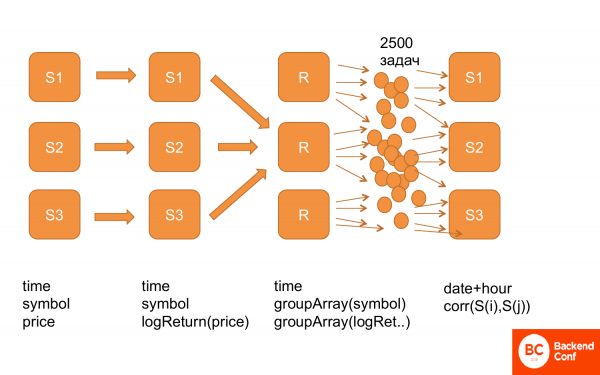
Endnu en gang, hvordan det ser ud. Først har vi alle data i sådan en struktur: tid, aktier, pris. Derefter har vi beregnet logReturn, dvs. data i samme struktur, men i stedet for prisen har vi nu logReturn. Derefter har vi ombearbejdet dem, så vi har tid og groupArray for aktierne og priserne. Vi har replikeret dem. Og derefter genererede vi en masse opgaver og fodrede ClickHouse, så den kunne beregne dem. Og det fungerer.
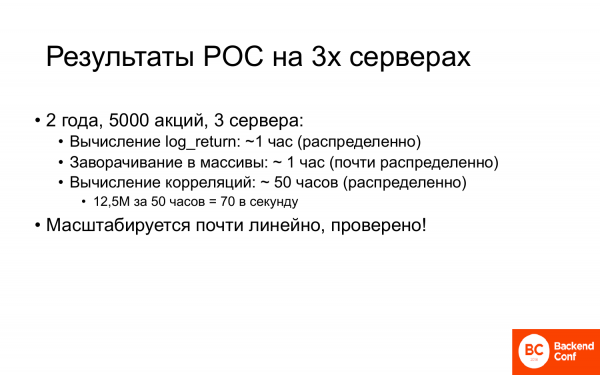
På proof of concept- opgaven var det en delopgave, dvs. vi tog færre data. Og det var alt sammen på tre servere.
De første to faser: beregning af Log_return og indpakning i arrays tog cirka en time hver.
Og beregningen af korrelationen tog omkring 50 timer. Men 50 timer er lidt, fordi tidligere kørte det i uger. Det var en stor succes. Og hvis man beregner det, blev alt regnet 70 gange i sekundet på dette cluster.
Men det vigtigste er, at dette system nærmest ikke har flaskehalse, dvs. det skalerer næsten lineært. Og de har testet det. De har med succes skaleret det.
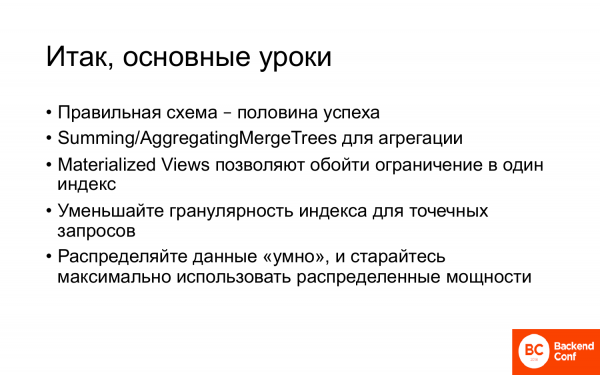
- Den rigtige skema er halvdelen af succesen. Og den rigtige skema er at bruge alle de nødvendige teknologier i ClickHouse.
- Summing/AggregatingMergeTrees er teknologier, der gør det muligt at aggregere eller beregne snapshot state som en særlig sag. Og det forenkler mange ting betydeligt.
- Materialized Views tillader at omgå begrænsningen til én indeks. Måske sagde jeg ikke det så klart, men når vi indlæste loggene, var de rå logs i en tabel med én indeks, mens attributloggene var i en tabel, dvs. de samme data, bare filtreret, men indekset var helt anderledes. Det synes at være de samme data, men med forskellig sortering. Og Materialized Views tillader, at hvis du har brug for det, at omgå denne ClickHouse-begrænsning.
- Reducer indeksets granularitet for punktforespørgsler.
- Og fordel dataene intelligent, forsøg at lokalisere dataene så meget som muligt inden for serveren. Og sørg for, at forespørgslerne også bruger lokalisering der, hvor det er muligt.
Og for at opsummere denne korte tale, kan man sige, at ClickHouse nu solidt har etableret sig både som en kommerciel database og som en open source database, dvs. specifikt til analyse. Det passer glimrende ind i dette landskab. Og mere end det, begynder det stille og roligt at udfordre andre, fordi når der er ClickHouse, har man ikke brug for InfiniDB. Vertica vil måske snart ikke være nødvendig, hvis de laver ordentlig SQL-support. Brug det!
—Tak for præsentationen! Meget interessant! Var der nogle sammenligninger med Apache Phoenix?
- Nej, jeg har ikke hørt om, at nogen har lavet sammenligninger. Vi og Yandex prøver at holde øje med alle sammenligninger af ClickHouse med forskellige databaser. Fordi hvis der pludselig er noget, der viser sig at være hurtigere end ClickHouse, så kan Alexey Milovidov ikke sove om natten og går hurtigt i gang med at optimere det. Jeg har ikke hørt om en sådan sammenligning.
(Alexey Milovidov) Apache Phoenix er en SQL-motor på Hbase. Hbase er primært designet til key-value arbejds-scenarier. I hver række kan der være et vilkårligt antal kolonner med vilkårlige navne. Dette gælder for systemer som Hbase, Cassandra. Og hårde analytiske forespørgsler vil ikke fungere ordentligt på dem. Eller man kunne tro, at de fungerer ordentligt, hvis man ikke har haft nogen erfaring med ClickHouse.
Tak
Goddag! Jeg har interesseret mig meget for dette emne, fordi jeg har et analytisk subsystem. Men når jeg ser på ClickHouse, får jeg indtryk af, at ClickHouse er meget velegnet til analyse af events, mutable. Og hvis jeg skal analysere mange forretningsdata med masser af store tabeller, så er ClickHouse, så vidt jeg kan forstå, ikke så velegnet for mig? Især hvis de ændrer sig. Er dette korrekt, eller findes der eksempler, der kan modsige dette?
Det er korrekt. Og det er sandt for de fleste specialiserede analytiske databaser. De er designet til at håndtere en eller flere store tabeller, som er muterbare, og mange små, der ændrer sig langsomt. Altså er ClickHouse ikke som Oracle, hvor man kan putte alt og lave meget komplekse forespørgsler. For at udnytte ClickHouse effektivt skal man opbygge schemaet på en måde, der fungerer godt i ClickHouse. Det vil sige, man skal undgå overdreven normalisering, bruge ordbøger og forsøge at lave færre lange relationer. Hvis man opbygger schemaet på denne måde, kan de samme forretningsopgaver på ClickHouse blive løst meget mere effektivt end med en traditionel relationsdatabase.
Tak for din præsentation! Jeg har et spørgsmål om den seneste finansielle sag. De havde en analyse. Det var nødvendigt at sammenligne, hvordan det gik op og ned. Og jeg forstår det sådan, at I byggede systemet specifikt til denne analyse? Hvis de i morgen for eksempel har brug for en anden rapport baseret på disse data, skal schemaet så bygges op fra bunden igen og dataene indlæses? Det vil sige, skal der laves en eller anden form for forbehandling for at få forespørgslen?
Selvfølgelig er dette brugen af ClickHouse til en ganske konkret opgave. Den kunne mere traditionelt have været løst inden for Hadoop. For Hadoop er det en ideel opgave. Men på Hadoop er det meget langsomt. Mit mål er at demonstrere, at man med ClickHouse kan løse opgaver, der normalt løses med helt andre værktøjer, men samtidig gøre det meget mere effektivt. Det er tilpasset en konkret opgave. Det er klart, at hvis man har en lignende opgave, kan man løse den på en tilsvarende måde.
Forstået. Du sagde, at der blev behandlet i 50 timer. Er det fra starten, da dataene blev indlæst, eller fra man fik resultaterne?
Ja- ja.
Godt, mange tak.
Det er på en 3-serverklynge.
Hej! Tak for din præsentation! Alt er virkelig interessant. Jeg vil ikke spørge så meget om funktionaliteten, men om brugen af ClickHouse set fra stabilitetens synspunkt. Er der sket nogen udfordringer, har I været nødt til at gendanne noget? Hvordan opfører ClickHouse sig i sådanne tilfælde? Har I oplevet, at en replika også er gået ned? Vi har for eksempel stødt på et problem med ClickHouse, når den faktisk overskrider sin grænse og går ned.
Selvfølgelig er der ikke perfekte systemer, og ClickHouse har også sine problemer. Men har du nogensinde hørt om, at Yandex.Metrica ikke fungerede i lang tid? Nok ikke. Den har fungeret pålideligt siden omkring 2012-2013 med ClickHouse. Jeg kan også tale om min egen erfaring. Vi har aldrig haft komplette nedbrud. Der kunne ske nogle delvise problemer, men de har aldrig været kritiske nok til at påvirke vores forretning alvorligt. Sådan har det aldrig været. ClickHouse er ret pålideligt og falder ikke tilfældigt ned. Det er noget, man ikke behøver at bekymre sig om. Det er ikke en beta-version. Det er bevist af mange virksomheder.
Hej! Du sagde, at man straks skal tænke godt over dataskemaet. Hvad hvis det er sket? Mine data flyder ind, og efter et halvt år indser jeg, at jeg ikke kan leve sådan, jeg skal genindlæse dataene og gøre noget ved dem.
Det afhænger selvfølgelig af dit system. Der er flere måder at gøre dette næsten uden nedetid. For eksempel kan du oprette en Materialized View med en anden dataskema, hvis det kan kortlægges entydigt. Det vil sige, hvis det tillader kortlægning med ClickHouse's midler, dvs. udtræk af visse elementer, ændring af primærnøglen, ændring af partitionering, så kan du lave en Materialized View. Dine gamle data kan skrives om til den, de nye vil blive skrevet automatisk. Og så kan du bare skifte til at bruge Materialized View og derefter skifte skrivningen og slette den gamle tabel. Dette er en metode helt uden nedetid.
Tak.
Kilde: habr.com
