

For some time now, colleagues in the field have been independently asking me how to capture all Bluetooth channels simultaneously from a single SDR receiver. The bandwidth allows it, as there are SDRs with an output bandwidth of 80 MHz or more. Of course, it can be done on an FPGA, but the development time for that would be quite substantial. I have long known that doing this on a GPU is fairly straightforward, but not to this extent!
The Bluetooth standard specifies the physical layer in two versions: Classic and Low Energy. The specification is available. The document is extremely large, reading it in its entirety can be dangerous for your brain. Fortunately, large companies that manufacture measurement equipment have the resources to create visual documents on the subject. og , for example. I have absolutely no chance of competing with them in the quality of material presentation. Those interested are encouraged to study it through the links.
Everything I need to know about the physical layer to create a multi-channel filter is the frequency grid step and the modulation speed. They are summarized in a table in one of the documents mentioned:
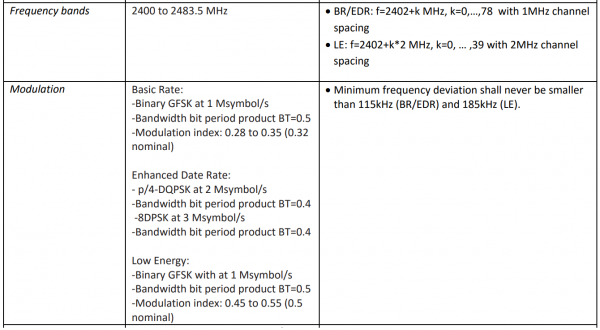
Thus, we need to divide the 80 MHz bandwidth into 79 filters with a tuning step of 1 MHz and simultaneously into 40 filters with a tuning step of 2 MHz. The sampling frequencies from the outputs of the filters should be 1 MHz and 2 MHz, respectively.
Therefore, we need two comb filters.
To start, let's choose the parameters of these filters based on the signal bandwidths of Bluetooth Classic and Bluetooth Low Energy. We need their impulse characteristics to calculate the computational load on the filter device. It should be noted immediately that we chose the lengths of the impulse characteristics based on the requirements of a 'fast' filtering algorithm. The essence does not change. The number of coefficients in the impulse response should not be too large, so the filter can be implemented on reasonable computational hardware.
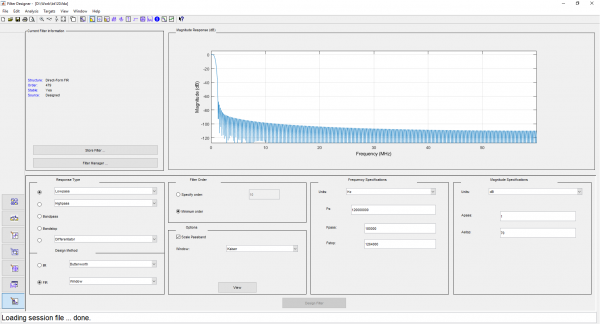
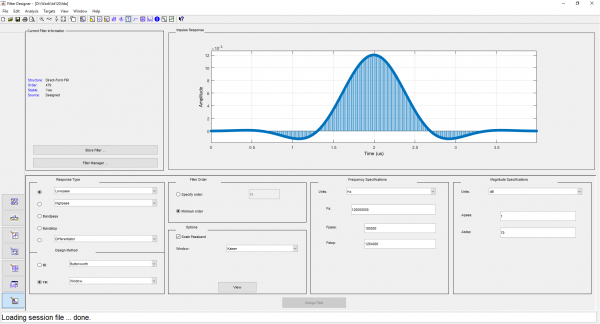
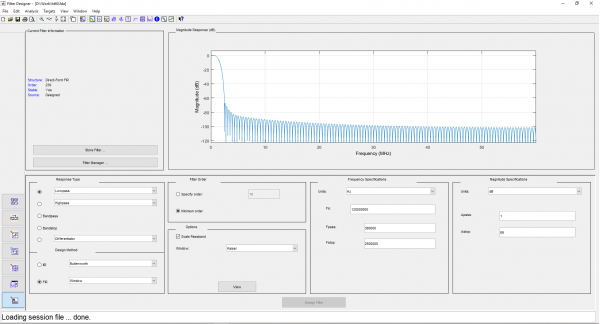
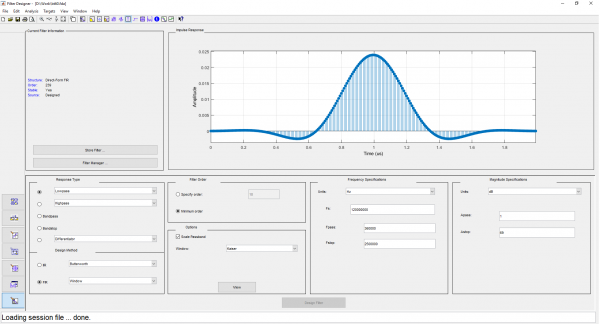
For the filters with a step of 1 MHz, we will choose a low-pass bandwidth (half the bandwidth of the bandpass filter) of 500 kHz, adjusting the length of the impulse response to 480 taps. For the filters with a step of 2 MHz, we will choose these parameters as 1 MHz and 240 taps, respectively. We will choose a Kaiser window. We will calculate the impulse characteristics in filterDesigner and export them in C-header format:
Screenshots from filterDesigner
Man kan løse opgaven direkte: opbygge et array DDC, der svarer til antallet af filtre (). Denne tilgang er god til FPGA'er, hvor man kan spare ved at reducere bitdybden af de beregnende enheder i de tidlige trin. Desuden er FPGA'er den mest energieffektive metode til implementering. Men arbejdsindsatsen ved denne metode er den højeste.
Når man udfører filterkamme på de populære GPU'er, åbner der sig mulighed for at implementere en mere sofistikeret algoritme: polytone filterkamme baseret på FFT, som er tilgængelig på CUDA fra biblioteket. I udenlandsk litteratur kaldes algoritmen Polyphase eller WOLA (Weight, Overlap and Add) FFT Filterbank. Mit dovenskab til tegning forhindrer mig i at lave en visuel forklaring selv. Der er mange materialer online om emnet, især en nyttig graf er udført på side 11 (stor tak til de respektive forfattere), her er den:
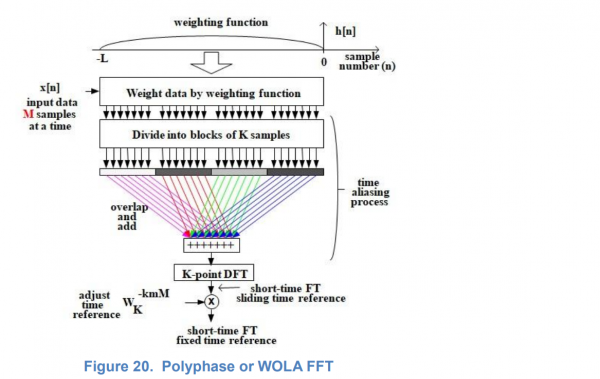
Jeg vil forsøge at forklare bearbejdningsskemaet med mine egne ord. Jeg beder de sarte sjæle om ikke at læse det.
Jeg vil prøve at forklare bearbejdningsskemaet med mine egne ord inden for mine metodiske muligheder. FFT er konvolutionen af det indkommende signal med hele spektret af komplekse ortogonale harmonikker, der ligger inden for intervallet af impulsresponsen. Impulsresponsen for filteret, som signalet ganges med inden FFT, moduleres af dette spektrum af harmonikker. Med andre ord bringes indpakningen af impulsresponsen for de resulterende filtre uden for parentes. Dernæst udtyndes spektret af harmonikkerne et vist antal gange, fordi båndbredden for filteret udvides i forhold til filteret i det rektangulære vindue. På tegningen ser vi en udtynding på fire. Med andre ord, efter at båndbredden er blevet udvidet med et Kaiser-vindue (samtidig med at dæmpningen i dæmpningsbåndet øges), har vi ikke brug for alle filtre, men kun en fjerdedel af dem. De øvrige er overflødige, deres frekvenskarakteristika overlapper. Af de fire på hinanden følgende FFT-punkter vælger vi kun det nulte punkt, hvis beregning er summen af de fire
indgangspunkter taget ved en tid, der svarer til en fjerdedel af varigheden af den oprindelige FFT.
Vi vælger det hardware, vi har ved hånden. Dette er inputkortet fra "Instrumental Systems" FMC126P. Jeg har allerede skrevet om det i en tidligere artikel. I FMC-stikket på kortet er der indsat en submodul fra samme virksomhed med AD9371-transceiver og en båndbredde på 100 MHz. Hele strømmen fra transceiveren kan kontinuerligt overføres til en computer til behandling.
Vi vælger et grafikkort med GPU GTX 1050. (Jeg lyver, det var det, der valgte os: det var alt, hvad der var til rådighed, blev revet ud af en computer til antenneberegning, men det var overraskende at se en fungerende gribebehandling). Lad os gå videre til den softwaremæssige del.
Desværre kan vi ikke offentliggøre den fulde kode på grund af licenser. Vi kan kun vise GPU-kernene. Resten af koden er dog heller ikke så interessant.
Her er kernen, der udfører multiplikationen af signalet med vinduet og summen, samt indpakningen til at kalde den:
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
Koden til signalbehandling, der kalder denne kerne, følger nøjagtigt den algoritmiske skema vist ovenfor, så jeg ser ikke nogen mening i at inkludere den her.
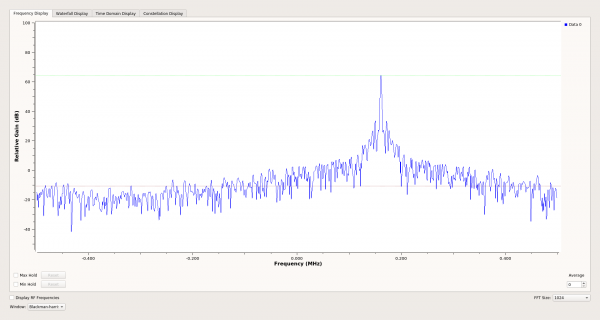
Gribebåndene blev testet på det udgående spektrum af kanaler i realtid. Signalgeneratorens input til AD9371 var på 2450 MHz, og filtrenes selektivitet svarede til det beregnede.
Planer: tilpasning af softwaren til XRTX-kortet og implementering af pakke-søgning, hvis nogen skulle få brug for det eller hvis der er tid til overs.
Alt arbejdet med softwaren er udført af , ære være ham!
Kilde: habr.com
