

I SQL beskriver du «hvad» du ønsker at få, ikke «hvordan» det skal udføres. Derfor har problemet med at udvikle SQL-forespørgsler i stil med «som høres, så skrives» sin ærefulde plads, side om side med .
I dag vil vi med ekstremt enkle eksempler se, hvad dette kan føre til i konteksten af brug GROUP/DISTINCT og LIMIT sammen med dem.
Hvis du har skrevet i forespørgslen «først skal du forbinde disse tabeller, og så skal du fjerne alle dubletter, der skal kun være én instans pr. nøgle» — sådan vil det fungere, selv hvis forbindelsen slet ikke var nødvendig.
Og nogle gange fungerer det «bare», nogle gange har det en ubehagelig indvirkning på ydeevnen, og nogle gange giver det helt uventede effekter set fra udviklerens synspunkt.
Nå, måske ikke så spektakulære, men…
«Den søde duo»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Det er klart, at de ønskede at udvælge sådanne poster X, for hvilke der i Y er tilknyttede poster, der opfylder den udførende betingelse.De skrev forespørgslen gennem JOIN — og fik nogle pk-værdier flere gange (præcis så mange som der var passende poster i Y). Hvordan fjerner man det? Selvfølgelig DISTINCT!
Er det særligt «glædeligt», når der til hver X-post findes flere hundrede tilknyttede Y-poster, og så bliver dubletterne heroisk fjernet…
Hvordan kan man rette det? For det første skal man indse, at opgaven kan modificeres til «udvælge sådanne poster X, for hvilke der i Y er MINIMUM ÉN tilknyttet post, der opfylder den udførende betingelse» — for fra selve Y-posten behøver vi ikke noget.
Nedlagte EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Nogle versioner af PostgreSQL forstår, at det i EXISTS er nok at finde den første tilfældige post, mens ældre versioner ikke gør. Derfor foretrækker jeg altid at angive LIMIT 1 indenfor EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Denne variant muliggør, hvis nødvendigt, straks at returnere nogle data fra den fundne relaterede Y-post. En lignende variant er behandlet i artiklen .
«Hvorfor betale mere»: DISTINCT [ON] + LIMIT 1
En ekstra fordel ved sådanne forespørgselsomdannelser er muligheden for nemt at begrænse gennemgangen af poster, hvis der kun er behov for en enkelt/flere af dem, som i følgende tilfælde:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Nu læser vi forespørgslen og forsøger at forstå, hvad der foreslås gjort af databasen:
- vi sammenkobler tabellerne
- vi unikaliserer efter X.pk
- fra de tilbageværende poster vælger vi en enkelt
Så hvad fik vi? «En enkelt post» fra de unikaliserede — og hvis vi tager denne enkelte fra de ikke-unikaliserede, vil resultatet så ændre sig?.. «Og hvis der ikke er nogen forskel, hvorfor betale mere?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- her kan passende betingelser tilføjes
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Og præcis det samme emne med GROUP BY + LIMIT 1.
«Jeg skal bare spørge»: implicit GROUP + LIMIT
Sådanne ting optræder under forskellige kontroller for tomhed af tabellen eller CTE under udførelsen af forespørgslen:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Aggregatfunktioner (count/min/max/sum/...) udføres med succes på hele sættet, selv uden eksplicit angivelse GROUP BY. Men de LIMIT er ikke rigtig kompatible.
Udvikleren kan tænke «hvis der er poster der, så skal jeg ikke mere end LIMIT».. Men sådan skal man ikke gøre! For databasen betyder det:
- tæl, hvad de ønsker giv så mange rækker, som de beder om
- Afhængigt af de målte betingelser er det her aktuelt at foretage en af erstatningerne:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)og få en fungerende kommando.(count + LIMIT 1) > 0EXISTS(LIMIT 1)og få en fungerende kommando.count >= N(SELECT count(*) FROM (... LIMIT N))og få en fungerende kommando.«Hvor meget skal der vejes i gram»: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
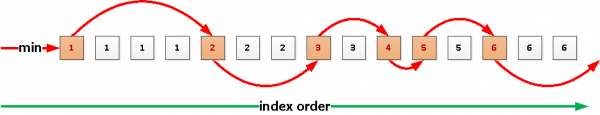
En naiv udvikler kan oprigtigt tro, at kørslen af forespørgslen stopper,så snart vi finder de første $1 tilfældige forskellige værdier. En gang i fremtiden kan det være, at det sådan vil fungere takket være den nye node.
Index Skip Scan , hvis implementering lige nu er under udvikling, men indtil videre — nej.Indtil videre vil alle poster blive hentet først,
unikaliseret, og kun derefter returneres så mange som anmodet. Det bliver særligt trist, hvis vi ønskede noget som , men der er hundredtusind poster i tabellen…For ikke at blive trist forgæves, lad os bruge en rekursiv forespørgsel $1 = 4«DISTINCT for fattige» fra PostgreSQL Wiki
PostgreSQL Antipatterns: beregning af betingelser i SQL :
Kilde: habr.com
