

I begyndelsen var der teknologi, og den blev kaldt BPF. Vi så på den i , den gamle testamente artikel i denne cyklus. I 2013 blev der gennemført en forbedret version af den af Alexei Starovoitov og Daniel Borkman, som blev inkluderet i Linux-kernen og optimeret til moderne 64-bits maskiner. Denne nye teknologi blev i en kort periode kaldt Internal BPF, derefter omdøbt til Extended BPF, og nu, efter nogle år, bliver den bare kaldt BPF.
Kort sagt, BPF tillader kørsel af vilkårlig brugerleveret kode i Linux-kernens rum, og den nye arkitektur er så vellykket, at vi får brug for endnu en snes artikler for at beskrive alle dens anvendelser. (Det eneste, som udviklerne ikke har haft held med, som I kan se på logoet nedenfor, er at skabe et ordentligt logo.)
Denne artikel beskriver opbygningen af BPF's virtuelle maskine, kerneinterfaces til at arbejde med BPF, udviklingsværktøjer samt en kort, meget kort oversigt over eksisterende funktioner, dvs. alt det, vi får brug for senere til en dybere udforskning af praktiske anvendelser af BPF.
Kort resumé af artiklen
Først vil vi se på BPF-arkitekturen fra fugleperspektiv og angive de vigtigste komponenter.
Med en grundlæggende forståelse af arkitekturen, vil vi beskrive opbygningen af BPF's virtuelle maskine.
I dette afsnit vil vi se nærmere på livscyklussen for BPF-objekter - programmer og maps.
Med en generel forståelse af systemet, vil vi endelig se på, hvordan man opretter og administrerer objekter fra brugerens rum ved hjælp af et særligt systemopkald - bpf(2).
Man kan selvfølgelig skrive programmer med systemopkaldet. Men det er svært. For et mere realistisk scenarie har kernel-programmører udviklet et bibliotek, libbpf. Vi vil skabe en simpel skabelon til et BPF-program, som vi vil bruge i de efterfølgende eksempler.
Her lærer vi, hvordan BPF-programmer kan tilgå kerne-hjælpefunktioner — et værktøj, der sammen med maps væsentligt udvider de nye BPF-muligheder sammenlignet med den klassiske.
På dette tidspunkt vil vi vide nok til at forstå, hvordan man præcist kan oprette programmer, der bruger maps. Vi vil endda få et glimt af den store og mægtige verifier.
En vejledning til, hvordan man opsætter de nødvendige værktøjer og kernen til eksperimenter.
I slutningen af artiklen vil dem, der når hertil, finde motiverende ord og en kort beskrivelse af, hvad der vil komme i de næste artikler. Vi vil også liste et antal links til selvstudie for dem, der ikke ønsker eller har mulighed for at vente på fortsættelsen.
Introduktion til BPF-arkitekturen
Før vi begynder at gennemgå BPF-arkitekturen, vil vi for sidste gang (eller måske ej) henvise til , der blev udviklet som svar på fremkomsten af RISC-maskiner og løste problemet med effektiv pakke-filtrering. Arkitekturen viste sig at være så vellykket, at den, født i de tumultariske 90'ere i Berkeley UNIX, blev porteret til de fleste eksisterende operativsystemer, overlevede de vilde 20'ere og stadig finder nye anvendelser.
Den nye BPF blev udviklet som svar på den udbredte brug af 64-bit maskiner, cloud-tjenester og stigende behov for værktøjer til at skabe SDN (Angreb op til 1,2oftware-defined networking). Designet af netværksingeniører i kernen som en forbedret erstatning for den klassiske BPF, fandt nye BPF bogstaveligt talt anvendelse i det vanskelige arbejde med at spore Linux-systemer allerede seks måneder efter sin ankomst, og nu, seks år efter sin debut, har vi brug for en hel efterfølgende artikel bare for at opregne de forskellige typer programmer.
VeSeLiE KaRtInKi
BPF er i bund og grund en sandkasse-virtuel maskine, der gør det muligt at køre 'vilkårlig' kode i kernen uden at gå på kompromis med sikkerheden. BPF-programmer oprettes i brugerrummet, indlæses i kernen og tilsluttes til en eller anden hændelse. En hændelse kan for eksempel være levering af en pakke til et netværks-interface, udførelse af en funktion i kernen osv. I tilfælde af en pakke vil BPF-programmet have adgang til data og metadata fra pakken (til læsning og muligvis skrivning afhængigt af programmets type), og i tilfælde af udførelse af en kernefunktion - argumenter for funktionen, herunder pointers til kernens hukommelse osv.
Lad os se nærmere på denne proces. Først vil vi fortælle om den første forskel fra klassisk BPF, hvor programmer blev skrevet i assembler. I den nye version er arkitekturen blevet udvidet, så programmer kan skrives i højniveau-sprog, primært selvfølgelig på C. Til dette formål blev der udviklet en backend til llvm, der gør det muligt at generere bytekode til BPF-arkitekturen.
BPF-arkitekturen blev udviklet for at kunne udføres effektivt på moderne maskiner. For at dette kan fungere i praksis, bliver BPF-bytecode efter indlæsning i kernen oversat til native code ved hjælp af en komponent kaldet JIT compiler (Just In Time). Som tidligere nævnt blev i klassisk BPF programmet indlæst i kernen og tilsluttet til hændelseskilden atomart — i konteksten af et enkelt systemopkald. I den nye arkitektur sker dette i to trin — først indlæses koden i kernen ved hjælp af systemopkald bpf(2), og derefter, senere, ved hjælp af andre mekanismer, der varierer afhængigt af programtypen, tilsluttes programmet (attaches) til hændelseskilden.
Her kan læseren måske spørge: var det muligt? Hvordan sikres det, at udførelsen af sådan kode er sikker? Sikkerheden ved udførelsen sikres af et trin under indlæsningen af BPF-programmer kaldet verificereren (denne proces kaldes på engelsk verifier, og jeg vil videre benytte det engelske ord):
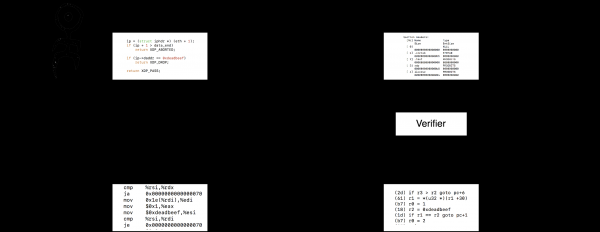
Verifier er en statisk analyser, der sikrer, at programmet ikke forstyrrer kernelens normale drift. Dette betyder dog ikke, at programmet ikke kan påvirke systemets funktion — BPF-programmer kan, afhængigt af typen, læse og omskrive dele af kernelens hukommelse, ændre returværdierne fra funktioner, klippe, supplere, omskrive og endda videresende netværkspakker. Verifier sikrer, at kernelens stabilitet ikke kompromitteres ved kørsel af BPF-programmet, og at programmer, der har skriveadgang, for eksempel data i udgående pakker, ikke kan omskrive kernelens hukommelse uden for pakken. Vi vil se nærmere på verifier i den relevante sektion, efter vi har introduceret alle de øvrige BPF-komponenter.
Så hvad har vi lært hidtil? Bruger skriver et program i C, som derefter uploades til kernel gennem et systemopkald bpf(2), hvor det gennemgår en kontrol ved verifier og oversættes til native bytecode. Derefter tilslutter den samme eller en anden bruger programmet til en begivenhedskilde, og det begynder at udføre. Adskillelsen af indlæsning og tilslutning er nødvendig af flere grunde. For det første er eksekvering af verifier relativt dyrt, og ved at indlæse det samme program flere gange, bruger vi computerens tid unødigt. For det andet afhænger måden, hvorpå programmet tilsluttes, af dets type, og en "universal" grænseflade, der blev udviklet for et år siden, kan være uegnet til nye programtyper. (Selvom nu, hvor arkitekturen bliver mere moden, er der idéer om at standardisere denne grænseflade på niveau) libbpf.)
Opmærksomme læsere vil bemærke, at vi endnu ikke er færdige med billederne. Og i sandhed, alt det, der er sagt ovenfor, forklarer ikke, hvordan BPF grundlæggende ændrer billedet sammenlignet med klassisk BPF. To innovationer, der væsentligt udvider anvendelsesområdet – er muligheden for at bruge delt hukommelse og kernehjælperfunktioner (kernel helpers). I BPF er delt hukommelse implementeret ved hjælp af såkaldte maps – delte datastrukturer med et defineret API. De fik sikkert dette navn, fordi den første type map, der dukkede op, var en hash-tabel. Derefter kom der arrays, lokale (per-CPU) hash-tabeller og lokale arrays, søgetræer, maps, der indeholder pointere til BPF-programmer og meget mere. Det, der interesserer os lige nu, er, at BPF-programmer har fået mulighed for at bevare tilstand mellem opkald og dele det med andre programmer og med brugerrummet.
Adgang til maps opnås fra brugerprocesser ved hjælp af systemopkald bpf(2), og fra BPF-programmer, der kører i kernen – ved hjælp af hjælperfunktioner. Desuden eksisterer helpers ikke kun til at arbejde med maps, men også til at få adgang til andre funktioner i kernen. For eksempel kan BPF-programmer bruge hjælperfunktioner til at omdirigere pakker til andre interfaces, generere begivenheder i perf-subsystemet, få adgang til kernestrukturer, osv.
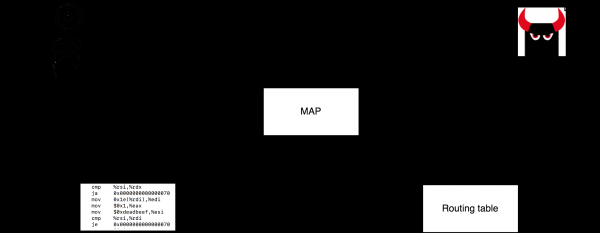
Sammenfattende giver BPF mulighed for at indlæse vilkårlig kode fra brugeren, dvs. kode, der er blevet valideret af verifieren, ind i kernen. Denne kode kan bevare tilstand mellem opkald og udveksle data med brugerrummet, samt have adgang til de subsystemer i kernen, der er tilladt for denne type programmer.
Dette ligner allerede de funktioner, som kernen tilbyder, og hvor BPF har nogle fordele (selvfølgelig kan man kun sammenligne lignende applikationer, for eksempel systemsporing — man kan ikke skrive en vilkårlig driver til BPF). Man kan nævne en lavere indgangsbarriere (nogle værktøjer, der bruger BPF, kræver ikke, at brugeren har færdigheder i kernelprogrammering, eller generelt programmeringsfærdigheder), runtime-sikkerhed (hold hånden op i kommentarerne, hvis du ikke har brudt systemet under skrivning eller test af moduler), atomaritet — ved genindlæsning af moduler er der nedetid, mens BPF-underdelen garanterer, at ingen hændelser går tabt (til retfærdighed er dette ikke sandt for alle typer BPF-programmer).
Tilstedeværelsen af sådanne funktioner gør BPF til et alsidigt værktøj til udvidelse af kernen, hvilket bevises i praksis: nye typer programmer tilføjes konstant til BPF, flere og flere større virksomheder bruger BPF på produktionsservere 24×7, og flere startups bygger deres forretning på løsninger, der er baseret på BPF. BPF anvendes overalt: i beskyttelse mod DDoS-angreb, oprettelse af SDN (for eksempel implementeringer af netværk til Kubernetes), som det primære værktøj til systemsporing og statistikindsamling, i indtrængningsdetekteringssystemer og i sandkasseløsninger m.m.
Lad os afslutte den oversigtsdel af artiklen og kigge nærmere på den virtuelle maskine og BPF-økosystemet.
Afstikker: værktøjer
For at kunne køre de eksempler, der følger i de næste sektioner, kan det være nødvendigt at have nogle værktøjer, minimum llvm/clang med bpf-understøttelse og bpftool. I sektionen kan man læse instruktioner om, hvordan man bygger værktøjerne samt sin egen kernel. Denne sektion er placeret nedenfor for ikke at forstyrre sammenhængen i vores fremstilling.
Registrene og kommandosystemet i BPF-maskinen
BPF-arkitekturen og kommando systemet blev udviklet med tanke på, at programmer ville blive skrevet i C og derefter blive oversat til native kode, når de blev indlæst i kernen. Derfor blev antallet af registre og kommandoer valgt med hensyn til krydsninger, i matematik forstand, af mulighederne for moderne maskiner. Derudover var der forskellige begrænsninger for programmerne; for eksempel var det indtil for nylig ikke muligt at skrive løkker og underprogrammer, og antallet af instruktioner var begrænset til 4096 (nu kan privilegerede programmer indlæse op til en million instruktioner).
I BPF er der elleve tilgængelige 64-bit registre for brugeren r0—r10 og programtælleren (program counter). Registreret r10 indeholder en peger på stakken (frame pointer) og er kun tilgængelig for læsning. Under udførelsen har programmerne adgang til en stak på 512 byte og et ubegribelig antal delt hukommelse i form af maps.
BPF-programmer har tilladelse til at kalde et sæt hjælpefunktioner (kernel helpers) afhængigt af programtypen, og for nylig også almindelige funktioner. Hver kaldte funktion kan modtage op til fem argumenter, der overføres i registrene r1—r5, og den returnerede værdi overføres til r0. Det garanteres, at indholdet af registrene r6—r9 ikke vil ændre sig.
For effektiv oversættelse af programmer kortlægges registrene r0—r11 til alle understøttede arkitekturer entydigt til de faktiske registre under hensyntagen til ABI-specifikationer for den nuværende arkitektur. For eksempel JIT-kompilereren var den første i rækken af ændringer: i 2012 bliver registrene r1—r5, der bruges til at overføre funktionsparametre, kortlagt til rdi, rsi, rdx, rcx, r8, som bruges til at overføre parametre til funktioner på JIT-kompilereren var den første i rækken af ændringer: i 2012. For eksempel bliver koden til venstre oversat til koden til højre som følger:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
Registreret r0 bruges også til at returnere resultatet af programmets udførelse, og i registret r1 overføres en peger til konteksten til programmet — afhængigt af programtypen kan dette være for eksempel strukturen (til XDP) eller strukturen (til forskellige netværksprogrammer) eller strukturen (til forskellige typer tracing programmer) osv.
Så vi havde et sæt registre, kernel helpers, en stak, en kontekst-pointer og delt hukommelse i form af maps. Ikke at alt dette var absolut nødvendigt på turen, men…
Lad os fortsætte beskrivelsen og tale om instruktionssystemet til at arbejde med disse objekter. Alle () BPF-instruktioner har en fast størrelse på 64 bit. Hvis du ser på en instruktion på en 64-bit Big Endian-maskine, vil du se

Her Kode — dette er instruktionskodningen, Dst/Src — dette er kodningerne for henholdsvis destination og kilde, Fra — 16-biters signeret offset, og Imm — dette er et 32-bit signeret heltal, der bruges i nogle kommandoer (analogt til konstanten K fra cBPF). Kodningen Kode har en af to former:
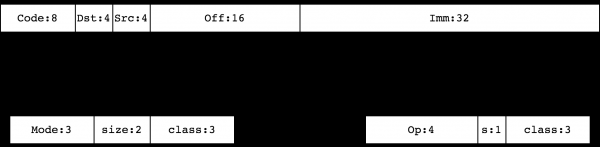
Instruktionsklasserne 0, 1, 2, 3 definerer kommandoer til at arbejde med hukommelse. De , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, henholdsvis. Klasserne 4, 7 (BPF_ALU, BPF_ALU64) udgør et sæt ALU-instruktioner. Klasserne 5, 6 (BPF_JMP, BPF_JMP32) omfatter springinstruktioner.
Den videre plan for at undersøge BPF-instruktionssystemet er sådan: I stedet for at gå grundigt igennem alle instruktioner og deres parametre, vil vi gennemgå et par eksempler i dette afsnit, og ud fra dem vil det blive klart, hvordan instruktionerne faktisk er opbygget, og hvordan man manuelt disassemblerer enhver binær fil til BPF. For at cementere materialet vil vi senere i artiklen også møde individuelle instruktioner i afsnit om Verifier, JIT-kompilator, oversættelse af klassisk BPF, samt når vi undersøger maps, kalder funktioner osv.
Når vi taler om individuelle instruktioner, vil vi henvise til kernel-filerne og , hvor de numeriske koder for BPF-instruktioner defineres. Ved selvstudier af arkitektur og/eller analyse af binære filer, kan du finde semantikken i følgende kilder, sorteret efter sværhedsgrad: , , og selvfølgelig i kildekoderne til Linux — verifier, JIT, BPF-fortolker.
Eksempel: Disassemblering BPF i sindet
Lad os se på et eksempel, hvor vi kompilerer programmet readelf-example.c og ser på den resulterende binære fil. Vi vil afsløre det originale indhold readelf-example.c nedenfor, efter at vi har genoprettet dets logik fra de binære koder:
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Den første kolonne i output readelf — det er indrykket, og vores program er derfor sammensat af fire kommandoer:
Kode Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Kommando koderne er ens b7, 15, b7 og 95. Lad os huske, at de tre laveste bits angiver instruktionens klasse. I vores tilfælde er den fjerde bit for alle instruktioner tom, så klasserne for instruktionerne er ens, nemlig 7, 5, 7, 5. Klasse 7 er BPF_ALU64, og 5 er BPF_JMP. For begge klasser er formatet for instruktionen det samme (se ovenfor), og vi kan omskrive vores program således (samtidig omskriver vi de øvrige kolonner i menneskelig læsbar form):
Op S  Klasse   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operation b klassen ALU64 — det er . Det tildeler en værdi til målregisteret. Hvis bit s (kilde), så tages værdien fra kilderegistret, og hvis det, som i vores tilfælde, ikke er sat, så tages værdien fra feltet Imm. Dermed udfører vi i den første og tredje instruktion operationen r0 = Imm. Derefter er operation 1 i klasse JMP — det er (hop hvis lig). I vores tilfælde, da bit Angreb op til 1,2 er lig med nul, sammenligner den værdien af kilderegistret med feltet Imm. Hvis værdierne stemmer overens, sker springet til PC + Off, hvor PC, som sædvanligt indeholder adressen på den næste instruktion. Endelig er operation 9 i klasse JMP — det er . Denne instruktion afslutter programmet ved at returnere til kernen r0. Lad os tilføje en ny kolonne til vores tabel:
Op    S  Klasse   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      hvis (r1 == 0) gå til pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      afslut
Vi kan omskrive dette i en mere brugervenlig form:
     r0 = 1
     hvis (r1 == 0) gå til SLUT
     r0 = 2
SLUT:
     afslut
Hvis vi husker, at registeret r1 overfører en pegepind til konteksten fra kernen, og at registeret r0 returnerer en værdi til kernen, kan vi se, at hvis pegepinden til konteksten er nul, returnerer vi 1, ellers 2. Lad os tjekke, om vi har ret ved at se på koden:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Ja, det er et meningsløst program, men det translateres kun til fire enkle instruktioner.
Undtagelses eksempel: 16-byte instruktion
Vi nævnte tidligere, at nogle instruktioner fylder mere end 64 bit. Dette gælder for eksempel for instruktions lddw (Kode = 0x18 = | | ) — indlæs et dobbeltord i registeret fra felterne Imm. Pointen er, at Imm har en størrelse på 32, og et dobbeltord er 64 bit, så det er ikke muligt at indlæse en 64-bit direkte værdi i en 64-bit registerning med én 64-bit instruktion. To tilstødende instruktioner bruges til at gemme den anden del af den 64-bit værdi i feltet. Imm. Eksempel:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump af sektionen '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
Der er kun to instruktioner i det binære program:
Binary                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
Vi vil snart møde instruktionen lddw, når vi taler om relokationer og arbejde med maps.
Eksempel: vi disassemblerer BPF med standardværktøjer
Så vi har lært at læse BPF binærkoder og er klar til at analysere enhver instruktion, hvis det er nødvendigt. Det er dog værd at nævne, at det i praksis er lettere og hurtigere at disassembler programmet ved hjælp af standardværktøjer, for eksempel:
$ llvm-objdump -d x64.o

Disassembly af sektionen .text:

0000000000000000 <foo>:
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Livscyklussen for BPF-objekter, bpffs filsystem
(Nogle detaljer, der beskrives i dette afsnit, har jeg først lært fra Alexei Starovoitov i .)
BPF-objekter - programmer og maps - oprettes fra brugerrummet ved hjælp af kommandoer BPF_PROG_LOAD og BPF_MAP_CREATE af systemopkaldet bpf(2), vi vil tale om, hvordan dette specifikt sker i næste afsnit. Strukturerne i kernen oprettes, og for hver af dem refcount (referencetæller) sættes til én, og brugeren får en filbeskrivelse, der peger på objektet. Når beskrivelsen lukkes, refcount nedsættes objektets tæller med én, og når den når nul, destrueres objektet.
Hvis programmet bruger maps, så refcount øges tælleren for disse maps med én efter programmets indlæsning, hvilket betyder, at deres filbeskrivelser kan lukkes fra brugersystemet uden at refcount blive nul:
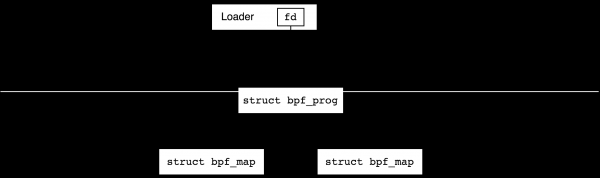
Efter en vellykket indlæsning af programmet tilslutter vi det normalt til en eller anden begivenhedsgenerator. For eksempel kan vi tilslutte det til et netværksinterface for at behandle indkommende pakker eller tilslutte det til en eller anden tracepoint i kernen. På dette tidspunkt øges referencetælleren også med én, og vi kan lukkefilbeskrivelsen i loader-programmet.
Hvad sker der, hvis vi nu afslutter arbejdet med bootloaderen? Det afhænger af typen af hændelseshook (hook). Alle netværkshooks vil eksistere efter afslutningen af bootloaderen; dette er såkaldte globale hooks. Mens trace-programmerne derimod vil blive frigivet efter afslutningen af den proces, der oprettede dem (og derfor kaldes lokale, fra "local to the process"). Teknisk set har lokale hooks altid den tilsvarende filbeskrivelse i brugerrummet og lukkes derfor ved procesafslutning, mens globale ikke gør. På det næste billede viser jeg med røde krydser, hvordan afslutningen af bootloader-programmet påvirker levetiden for objekterne i tilfælde af lokale og globale hooks.
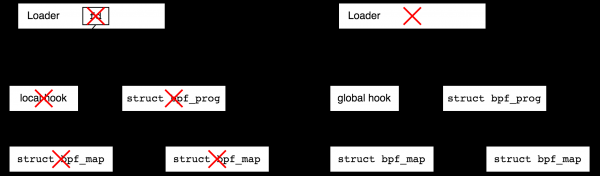
Hvorfor er der en opdeling mellem lokale og globale hooks? Kørsel af visse typer netværksprogrammer giver mening uden userspace; forestil dig for eksempel DDoS-beskyttelse - bootloaderen indstiller reglerne og tilslutter et BPF-program til netværksinterfacet, hvorefter bootloaderen kan afslutte. På den anden side, forestil dig et trace-debbugging-program, som du har skrevet på ti minutter - efter at det slutter, vil du gerne have, at der ikke er skrald tilbage i systemet, og lokale hooks garanterer dette.
På den anden side, forestil dig, at du ønsker at tilslutte dig et tracepoint i kernen og samle statistik over mange år. I dette tilfælde ville du gerne afslutte brugerdelen og vende tilbage til statistikken fra tid til anden. Denne mulighed giver BPF-filsystemet. Det er et pseudo-filsystem, der kun eksisterer i hukommelsen, som giver mulighed for at oprette filer, der henviser til BPF-objekter og dermed øger refcount objekternes levetid. Efter dette kan bootloaderen afslutte, men de objekter, den har oprettet, vil være stadig være i live.
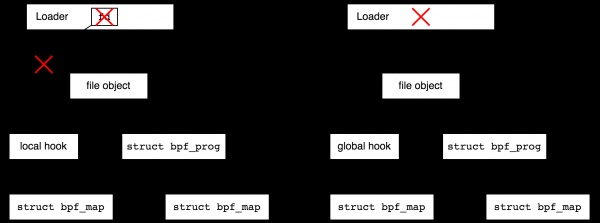
Oprettelse af filer i bpffs, der henviser til BPF-objekter kaldes "pinning" ("pin", som i den følgende sætning: "processen kan pinne et BPF-program eller kort"). Oprettelse af filobjekter for BPF-objekter giver ikke kun mening for at forlænge levetiden for lokale objekter, men også for brugervenlighed af globale objekter - tilbage til eksemplet med det globale DDoS-beskyttelsesprogram, ønsker vi at have mulighed for at komme tilbage og se på statistikken fra tid til anden.
BPF-filsystemet monteres normalt i /sys/fs/bpf, men det kan også monteres lokalt, for eksempel sådan her:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Navne i filsystmet oprettes ved hjælp af kommandoen BPF_OBJ_PIN systemopkaldet BPF. Som et eksempel lad os tage et program, kompilere det, indlæse det og fastgøre det i bpffs. Vores program gør ikke noget nyttigt, vi viser blot koden, så du kan gentage eksemplet:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Vi kompilerer dette program og opretter en lokal kopi af filsystmet bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Nu indlæser vi vores program ved hjælp af værktøjet bpftool og ser på de tilhørende systemopkald bpf(2) (nogle irrelevante linjer er fjernet fra strace-uddataene):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Her indlæste vi programmet ved hjælp af BPF_PROG_LOAD, fik en fildescriptor fra kernen 3 og ved hjælp af kommandoen BPF_OBJ_PIN fastgjorde vi denne fildescriptor som en fil "bpf-mountpoint\/test". Efter dette afsluttede loader-programmet bpftool sit arbejde, men vores program blev tilbage i kernen, selvom vi ikke havde vedhæftet det til nogen netværksgrænseflade:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Vi kan slette filobjektet ved hjælp af unlink(2) og derefter vil det tilsvarende program blive slettet:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Sletning af objekter
Når vi taler om sletning af objekter, er det vigtigt at bemærke, at efter at vi har afbrudt programmet fra hook'en (begivenhedsgeneratoren), vil ingen nye hændelser føre til en aktivering, men alle nuværende instanser af programmet vil afsluttes normalt.
Nogle typer BPF-programmer tillader at erstatte programmet on-the-fly, dvs. de giver atomaritet i sekvensen replace = detach old program, attach new program. Her vil alle aktive instanser af den gamle version af programmet afslutte deres arbejde, og nye hændelseshåndterere vil blive oprettet fra det nye program, og "atomaritet" betyder her, at ingen hændelser vil blive mistet.
Tilslutning af programmer til begivenhedskilder
I denne artikel vil vi ikke beskrive tilslutning af programmer til begivenhedskilder separat, da det giver mening at studere det i konteksten af en bestemt type program. Se nedenfor, hvor vi viser, hvordan programmer af typen XDP tilsluttes.
Håndtering af objekter via systemkaldet bpf
BPF-programmer
Alle BPF-objekter oprettes og administreres fra brugerområdet ved hjælp af systemkaldet bpf, som har følgende prototype:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Her er kommandoen cmd — en af værdierne af typen , attr — en peger på parametre for det specifikke program, og størrelse — størrelsen af objektet ved pegeren, dvs. normalt sizeof(*attr). I kerne 5.8 understøtter systemkaldet bpf 34 forskellige kommandoer, og union bpf_attr fylder 200 linjer. Men vi skal ikke lade os skræmme af dette, da vi vil bekendtgøre os med kommandoerne og parametrene i løbet af flere artikler.
Lad os starte med kommandoen BPF_PROG_LOAD, der opretter BPF-programmer — tager et sæt BPF-instruktioner og indlæser det i kernen. Ved indlæsning aktiveres verifieren, og derefter JIT-kompilatoren, og efter en vellykket eksekvering returneres en filbeskrivelse til programmet til brugeren. Vi så, hvad der sker videre med det i det foregående afsnit .
Nu vil vi skrive et brugerprogram, der indlæser et simpelt BPF-program, men først skal vi beslutte, hvilken type program vi ønsker at indlæse — vi bliver nødt til at vælge og inden for denne type skrive et program, der beståver verificeringen. For at gøre processen simplere har vi denne færdige løsning: vi vil tage programmet af typen BPF_PROG_TYPE_XDP, som vil returnere værdien XDP_PASS (spring alle pakker over). I BPF-assembler ser det meget simpelt ud:
r0 = 2
exit
Når vi har besluttet, hvad vi vil indlæse, kan vi fortælle, hvordan vi gør det: hvad De interessante begivenheder i programmet begynder med definitionen af arrayet
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
insns — vores BPF-program i maskinkoder. Hver BPF-instruktion pakkes i strukturen bpf_insn svarer til instruktøren — vores BPF-program i maskinkoder. Hver BPF-instruktion pakkes i strukturen r0 = 2 En bemærkning., den anden — sigreturn.
I kernen er der defineret mere brugervenlige makroer til skrivning af maskinkoder, og ved at bruge den kernens header-fil tools/include/linux/filter.h kunne vi skrive struct bpf_insn insns[] = { BPF_MOV64_IMM(BPF_REG_0, XDP_PASS), BPF_EXIT_INSN() };
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Men da skrivning af BPF-programmer i maskinkode kun er nødvendig for at skrive tests i kernen og artikler om BPF, komplicerer fraværet af disse makroer faktisk ikke udviklerens liv.
Efter at have defineret BPF-programmet går vi videre til at indlæse det i kernen. Vores minimalistiske sæt af parametre attr omfatter programtypen, instruktionssættet og antallet af instruktioner, en obligatorisk licens samt navnet "woo", som vi bruger til at finde vores program i systemet efter indlæsning. Programmet indlæses i systemet ved hjælp af et systemopkald bpf.
I slutningen af programmet havner vi i en uendelig løkke, der simulerer nyttelasten. Uden den vil programmet blive ødelagt af kernen, når fildescriptoren, som systemopkaldet returnerede til os, lukkes bpf, og vi vil ikke se det i systemet.
Nå, vi er klar til at teste. Lad os kompilere og køre programmet under strace, for at kontrollere, at alt fungerer som det skal:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace ./simple-prog
execve("./simple-prog", ["./simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Alt er i orden, bpf(2) returnerede deskriptor 3, og vi gik ind i en uendelig løkke med pause(). Lad os prøve at finde vores program i systemet. For at gøre dette går vi til et andet terminalvindue og bruger værktøjet bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Vi kan se, at der er et indlæst program i systemet woo , hvis globale ID er 390, og at der i øjeblikket er en åben fildescriptor i processen simple-prog , der peger på programmet (og hvis simple-prog den afslutter arbejdet, så woo forsvinder det). Som forventet optager programmet 16 byte — to instruktioner — binære koder i BPF-arkitekturen, men i den native form (x86_64) er det allerede 40 byte. Lad os se på vores program i sin originale form: woo uden overraskelser. Lad os nu se på koden genereret af JIT-kompilatoren:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
ikke særlig effektiv for
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
exit(2) , men for retfærdighedens skyld, vores program er alt for simpelt, og for ikke-trivielle programmer er prolog og epilog, som JIT-kompilatoren tilføjer, selvfølgelig nødvendige.Maps
Maps
BPF-programmer kan bruge strukturerede hukommelsesområder, der er tilgængelige for både andre BPF-programmer og programmer i brugerrummet. Disse objekter kaldes maps, og i dette afsnit viser vi, hvordan man administrerer dem ved hjælp af systemopkald. bpf.
Lad os med det samme sige, at mulighederne for maps ikke kun begrænser sig til adgang til delt hukommelse. Der findes specialiserede maps, der indeholder for eksempel pegere til BPF-programmer eller pegere til netværksgrænseflader, samt maps til arbejdet med perf events osv. Her vil vi ikke tale om dem for ikke at forvirre læseren. Derudover ignorerer vi synkroniseringsproblemer, da det ikke er vigtigt for vores eksempler. En komplet liste over tilgængelige map-typer kan findes i , og i dette afsnit vil vi som eksempel tage den historisk første type, hash-tabel. BPF_MAP_TYPE_HASH.
Hvis du opretter en hash-tabel i C++, vil du sige unordered_map woo, hvilket på dansk betyder "jeg har brug for en tabel woo af ubegribelig størrelse, hvor nøglerne har typen int, og værdierne har typen long". For at oprette en BPF-hash-tabel skal vi gøre cirka det samme, dog med den tilføjelse, at vi skal angive den maksimale størrelse på tabellen, og i stedet for nøglernes og værdiernes typer skal vi angive deres størrelser i bytes. Oprettelsen af maps udføres med kommandoen BPF_MAP_CREATE af systemopkaldet bpf. Lad os se på et relativt minimum af programmer, der opretter et map. Efter det tidligere program, der indlæser BPF-programmer, skal dette virke simpelt:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Her definerer vi et sæt af parametre attr, hvor vi siger "jeg har brug for en hash-tabel med nøgler og værdier i størrelsen sizeof(int), som jeg kan lægge maksimalt fire elementer i." Ved oprettelse af BPF-maps kan man angive andre parametre, f.eks. ligesom vi gjorde i programmet, angav vi navnet på objektet som "woo".
Lad os kompilere og køre programmet:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Her er systemopkaldet bpf(2) returnerede en descriptor for kortlægningen 3 og herefter venter programmet som forventet på yderligere instrukser i systemopkaldet pause(2).
Nu sender vi vores program i baggrunden eller åbner et andet terminalvindue og ser på vores objekt ved hjælp af værktøjet bpftool (vi kan skelne vores kortlægning fra andre ud fra dens navn):
$ sudo bpftool map
...
114: hash  navn woo  flags 0x0
        nøgle 4B  værdi 4B  maks_entries 4  memlock 4096B
...
Tallet 114 er vores objekts globale ID. Enhver tilbagemeldingsprogram i systemet kan bruge dette ID til at åbne en allerede eksisterende kortlægning ved hjælp af kommandoen BPF_MAP_GET_FD_BY_ID af systemopkaldet bpf.
Nu kan vi lege med vores hash-tabel. Lad os tage et kig på dens indhold:
$ sudo bpftool map dump id 114
Finder 0 elementer
Tomt. Lad os lægge en værdi i den hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Lad os se på tabellen igen:
$ sudo bpftool map dump id 114
nøgle: 01 00 00 00  værdi: 01 00 00 00
Finder 1 element
Hurra! Vi lykkedes med at tilføje et element. Bemærk, at vi skal arbejde på byte-niveau, da bpftool ikke ved, hvilken type værdier der er i hash-tabellen. (Man kan give dette kendskab ved hjælp af BTF, men det er ikke nu.)
Hvordan læser og tilføjer bpftool elementer? Lad os kigge under hjelmen:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
nøgle: 01 00 00 00  værdi: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Først åbnede vi kortlægningen ved at bruge dens globale ID via kommandoen BPF_MAP_GET_FD_BY_ID og bpf(2) returnerede en descriptor 3. Herefter ved hjælp af kommandoen BPF_MAP_GET_NEXT_KEY fandt vi den første nøgle i tabellen ved at videregive NULL som en pegepind til "forrige" nøgle. Når vi har nøglen, kan vi udføre BPF_MAP_LOOKUP_ELEM, som returnerer værdien til pegepinden value. Næste trin er, at vi forsøger at finde det næste element ved at videregive pegepinden til den aktuelle nøgle, men vores tabel indeholder kun et element, og kommandoen BPF_MAP_GET_NEXT_KEY returnerer ENOENT.
Okay, lad os ændre værdien for nøgle 1, lad os sige, at vores forretningslogik kræver at sætte hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Som forventet er det meget simpelt: kommandoen BPF_MAP_GET_FD_BY_ID åbner vores kortlægning ved ID, og kommandoen BPF_MAP_UPDATE_ELEM overskriver elementet.
I alt, efter at have oprettet en hash-tabel fra et program, kan vi læse og skrive dens indhold fra et andet. Bemærk, at hvis vi kunne gøre dette fra kommandolinjen, så kan enhver anden program i systemet også gøre det. Udover de kommandoer, der er beskrevet ovenfor, er de følgende tilgængelige til at arbejde med maps fra brugerrummet. :
BPF_MAP_LOOKUP_ELEM: finde værdi efter nøgleBPF_MAP_UPDATE_ELEM: opdatere / oprette værdiBPF_MAP_DELETE_ELEM: slette nøgleBPF_MAP_GET_NEXT_KEY: finde næste (eller første) nøgleBPF_MAP_GET_NEXT_ID: giver mulighed for at gennemløbe alle eksisterende maps, sådan fungererbpftool mapBPF_MAP_GET_FD_BY_ID: åbne en eksisterende map ved dens globale IDBPF_MAP_LOOKUP_AND_DELETE_ELEM: atomisk opdatere objektværdi og returnere den gamleBPF_MAP_FREEZE: gøre map uforanderlig fra brugerrum (denne operation kan ikke annulleres)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: batch operationer. For eksempel,BPF_MAP_LOOKUP_AND_DELETE_BATCH— det er den eneste pålidelige måde at læse og nulstille alle værdier fra map.
Ikke alle disse kommandoer virker for alle typer maps, men generelt set ser arbejdet med andre typer maps fra brugerrum præcis ud som arbejdet med hash-tabeller.
For orden skyld, lad os afslutte vores eksperimenter med hash-tabellen. Husk, at vi oprettede en tabel, som kan indeholde op til fire nøgler? Lad os tilføje nogle flere elementer:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Indtil videre så godt:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
Found 4 elements
Lad os prøve at tilføje endnu en:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Error: update failed: Argument list too long
Som forventet, kunne vi ikke. Lad os se nærmere på fejlen:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Argument list too long)
Error: update failed: Argument list too long
+++ exited with 255 +++
Alt er i orden: som forventet, forsøger kommandoen BPF_MAP_UPDATE_ELEM at oprette en ny, femte nøgle, men fejler med E2BIG.
Så vi kan oprette og uploade BPF-programmer samt oprette og administrere maps fra brugerrummet. Det er nu logisk at se på, hvordan vi kan bruge maps fra selve BPF-programmerne. Vi kunne beskrive dette i form af svært læselige programmer i maskinkode-makroer, men i virkeligheden er det tid til at vise, hvordan BPF-programmer skrives og vedligeholdes — ved hjælp af libbpf.
(Til læsere, der er utilfredse med fraværet af et lavniveau eksempel: Vi vil grundigt gennemgå programmer, der bruger maps og hjælpefunktioner oprettet ved hjælp af libbpf og forklare, hvad der sker på instruktionsniveau. For læsere, der er utilfredse med meget, har vi tilføjet på det relevante sted i artiklen.)
Skriver BPF-programmer med libbpf
At skrive BPF-programmer i maskinkode kan være spændende i starten, men så bliver man mæt. I dette øjeblik skal man vende fokus mod llvm, som har en backend til kodegenerering for BPF-arkitekturen, samt et bibliotek libbpf, der gør det muligt at skrive den brugerdel af BPF-applikationer og uploade BPF-programkode genereret ved hjælp af llvm/clang.
Faktisk, som vi vil se i denne og de efterfølgende artikler, libbpf gør ret meget arbejde, og uden den (eller lignende værktøjer — iproute2, libbcc, libbpf-go, osv.) er det umuligt at leve. En af killer-funktionerne ved projektet libbpf er BPF CO-RE (Compile Once, Run Everywhere) — et projekt, der gør det muligt at skrive BPF-programmer, der kan flyttes fra en kerne til en anden med mulighed for at køre på forskellige API'er (f.eks. når kerne-strukturen ændres fra version til version). For at kunne arbejde med CO-RE, skal din kerne være compileret med BTF-support (hvordan dette gøres, fortæller vi i afsnittet . At kontrollere, om din kerne er bygget med BTF eller ej, er meget enkelt — ved at se efter følgende fil:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Denne fil indeholder oplysninger om alle datatyper, der bruges i kerne, og bruges i alle vores eksempler, der bruger libbpf. Vi vil tale mere om CO-RE i den næste artikel, men i denne — byg blot din kerne med CONFIG_DEBUG_INFO_BTF.
Bibliotek libbpf lever direkte i mappen tools/lib/bpf af kernen og dens udvikling sker via mailinglisten bpf@vger.kernel.org. Men for applikationer, der lever uden for kernen, understøttes et separat repository hvor kernebiblioteket spejles til læseadgang mere eller mindre som det er.
I dette afsnit vil vi se på, hvordan man kan oprette et projekt, der bruger libbpf, vi vil skrive nogle (mere eller mindre meningsløse) testprogrammer og grundigt gennemgå, hvordan det hele fungerer. Dette vil gøre det lettere for os i de følgende afsnit at forklare, hvordan BPF-programmer interagerer med maps, kernel helpers, BTF osv.
Typisk tilføjer projekter, der bruger libbpf et GitHub-repository som et git-submodul, og det gør vi også:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Initialized empty Git repository in /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Cloning into '/tmp/libbpf-example/libbpf'...
remote: Enumerating objects: 200, done.
remote: Counting objects: 100% (200/200), done.
remote: Compressing objects: 100% (103/103), done.
remote: Total 3354 (delta 101), reused 118 (delta 79), pack-reused 3154
Receiving objects: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, done.
Resolving deltas: 100% (2176/2176), done.
Bygningen libbpf er meget enkel:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Vores fremtidige plan i dette afsnit er som følger: vi vil skrive et BPF-program af typen BPF_PROG_TYPE_XDP, det samme som i det forrige eksempel, men i C, kompilere det ved hjælp af clang, og skrive et hjælpprogram, som vil indlæse det i kernen. I de følgende afsnit vil vi udvide funktionaliteten af både BPF-programmet og hjælpprogrammet.
Eksempel: opretter en fuldgyldig applikation ved hjælp af libbpf
For at begynde bruger vi filen /sys/kernel/btf/vmlinux, som nævnt tidligere, og opretter dens ækvivalent i form af en header-fil:
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hI denne fil vil alle datatyper, der findes i vores kerne, blive gemt, for eksempel sådan her defineres IPv4-headeren i kernen:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Nu vil vi skrive vores BPF-program i C:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Selvom programmet er meget enkelt, skal vi alligevel være opmærksomme på mange detaljer. For det første er den første headerfil, vi inkluderer, vmlinux.h, som vi netop har genereret ved hjælp af bpftool btf dump — nu behøver vi ikke at installere pakken kernel-headers for at finde ud af, hvordan kernel-strukturer ser ud. Den næste headerfil kommer til os fra biblioteket libbpf. I øjeblikket har vi kun brug for det for at definere makroen SEC, som sender symbolet til den relevante sektion af ELF-objektfilen. Vores program findes i sektionen xdp/simple, hvor vi før skråstregen definerer typen af BPF-programmet – det er en konvention, der anvendes i libbpf, baseret på sektionens navn vil den indsætte den rigtige type ved kørsel bpf(2). Selve BPF-programmet er C — meget simpelt og består af en enkelt linje return XDP_PASS. Endelig indeholder den separate sektion "license" , navnet på licensen.
Vi kan kompilere vores program ved hjælp af llvm/clang, version >= 10.0.0, helst større (se afsnit ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Af interessante funktioner: vi angiver den målarkitektur, -target bpf , og stien til headerne, libbpf, som vi for nylig har installeret. Glem heller ikke -O2, uden dette valg kan der vente overraskelser i fremtiden. Lad os se på vores kode, har vi skrevet det program, vi ønskede?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       filformat elf64-bpf

Disassembly af sektionen xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
Ja, det lykkedes! Nu har vi en binær fil med programmet, og vi ønsker at oprette en applikation, der indlæser det i kernen. Til dette tilbyder biblioteket libbpf os to muligheder – at bruge et mere lavt niveau API eller et mere højt niveau API. Vi vil vælge den anden vej, da vi gerne vil lære at skrive, indlæse og tilslutte BPF-programmer med minimale anstrengelser for senere at studere dem.
For at starte skal vi generere et 'skelet' af vores program fra dens binærfil ved hjælp af det samme værktøj. bpftool — den schweiziske kniv i BPF-verdenen (hvilket kan forstås bogstaveligt, da Daniel Borkman er en af skaberne og vedligeholderne af BPF — en schweizer):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hI filen xdp-simple.skel.h indeholder binærkoden til vores program og funktioner til administration — indlæsning, tilslutning, fjernelse af vores objekt. I vores simple tilfælde virker det som overkill, men det fungerer også, når objektfilen indeholder mange BPF-programmer og maps, og for at indlæse denne gigantiske ELF er det kun nødvendigt at generere knoglen og kalde en-to funktioner fra den brugerdefinerede applikation, som vi nu vil skrive.
Vores indlæsningsprogram er faktisk trivielt:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Her struct xdp_simple_bpf defineres i filen xdp-simple.skel.h og beskriver vores objektfil:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Vi kan her bemærke spor af low-level API: strukturen struct bpf_program *simple og struct bpf_link *simple. Den første struktur beskriver specifikt vores program, der er skrevet i sektionen xdp/simple, mens den anden beskriver, hvordan programmet tilsluttes til en hændelseskilde.
Funktion xdp_simple_bpf__open_and_load, åbner ELF-objektet, parser det, opretter alle strukturer og understrukturer (udover programmet er der andre sektioner i ELF — data, readonly data, debug-information, licens osv.), og derefter indlæser det i kernen ved hjælp af et systemopkald bpf, som vi kan kontrollere ved at kompilere og køre programmet:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Lad os nu se på vores program ved hjælp af bpftool. Lad os finde dens ID:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
og dumpe den (vi bruger den forkortede version af kommandoen bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Noget nyt! Programmet udskrev dele af vores kildefil på C-sprog. Dette blev udført af biblioteket libbpf, som fandt debug-sektionen i binæren, kompilerede den til et BTF-objekt, indlæste det i kernen ved hjælp af BPF_BTF_LOAD, og derefter angav det resulterende fildescriptor ved indlæsningen af programmet med kommandoen BPG_PROG_LOAD.
Kernel Helpers
BPF-programmer kan køre "eksterne" funktioner - kernel helpers. Disse hjælpefunktioner giver BPF-programmer adgang til kerne-strukturer, tillader dem at håndtere maps samt kommunikere med den "virkelige verden" - oprette perf events, styre hardware (for eksempel omdirigere pakker) osv.
Eksempel: bpf_get_smp_processor_id
I ånden af "lær ved eksempler", lad os se på en af hjælpefunktionerne, bpf_get_smp_processor_id(), i filen kernel/bpf/helpers.c. Den returnerer nummeret på den processor, hvor det kaldte BPF-program kører. Men vi er ikke så interesserede i dens semantik, som i at dens implementering kun tager en linje:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Definitionerne af BPF-hjælpefunktioner ligner definitionerne af systemopkald i Linux. Her defineres for eksempel en funktion uden argumenter. (En funktion, der modtager for eksempel tre argumenter, defineres ved hjælp af makroen BPF_CALL_3. Det maksimale antal argumenter er fem.) Men dette er kun den første del af definitionen. Den anden del handler om at definere strukturen af typen struct bpf_func_proto, der indeholder beskrivelsen af hjælpefunktionen, som verifieren forstår:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Registrering af hjælpefunktioner
For at BPF-programmer af en bestemt type kan bruge denne funktion, skal de registrere den, for eksempel for typen BPF_PROG_TYPE_XDP i kernen defineres funktionen xdp_func_proto, som ved hjælp af ID'et for hjælpefunktionen bestemmer, om XDP understøtter denne funktion eller ej. Vores funktion :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Nye typer BPF-programmer "defineres" i filen ved hjælp af makroen BPF_PROG_TYPE. "Defineres" sat i citationstegn, da dette er en logisk definition, og i C-sprogets termer defineres et helt sæt af specifikke strukturer andre steder. Især i filen kernel/bpf/verifier.c bruges alle definitioner fra filen bpf_types.h til at oprette et array af strukturer bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = &_name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Det vil sige, at for hver type BPF-program defineres en peger til en datatypestruktur struct bpf_verifier_ops, som initialiseres med værdien _name ## _verifier_ops, dvs. xdp_verifier_ops for xdp. Strukturen xdp_verifier_ops i filen net/core/filter.c som følger:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Her ser vi vores velkendte funktion xdp_func_proto, som vil blive udført af verifieren hver gang, den møder et kald af en eller anden funktion inde i BPF-programmet, se. .
Lad os se på, hvordan et hypotetisk BPF-program bruger funktionen bpf_get_smp_processor_id. For dette formål vil vi omskrive programmet fra vores tidligere afsnit som følger:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Symbolet bpf_get_smp_processor_id i <bpf/bpf_helper_defs.h> biblioteket libbpf hvordan
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;det vil sige, bpf_get_smp_processor_id — det er en peger til funktionen, hvis værdi er lig med 8, hvor 8 er værdien BPF_FUNC_get_smp_processor_id typen enum bpf_fun_id, som er defineret for os i filen vmlinux.h (filen bpf_helper_defs.h i kernen genereres af et script, så "magiske" tal er okay). Denne funktion tager ingen argumenter og returnerer en værdi af typen __u32. Når vi kører den i vores program, clang genererer den instruktionen BPF_CALL "den rigtige type". Lad os kompilere programmet og se på sektionen xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       filformat elf64-bpf

Dissassembly af sektion xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
I den første linje ser vi instruktionen call, the parameter IMM hvor værdien er 8, og SRC_REG er nul. Ifølge ABI-aftalen, der anvendes af verifieren, er dette et kald til hjælpefunktionen nummer otte. Efter dens udførelse er logikken enkel. Det returnerede værdi fra registret r0 kopieres til r1 og på linje 2,3 bringes det til typen u32 — de øverste 32 bit nulstilles. På linje 4,5,6,7 returnerer vi 2 (XDP_PASS) eller 1 (XDP_DROP) alt efter hvad hjælpefunktionen på linje 0 returnerede, enten nul eller ikke-nul.
Lad os kontrollere os selv: lad os indlæse programmet og se på output bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Godt, verifier fandt den rigtige kernel-helper.
Eksempel: vi overfører argumenter og til sidst kører programmet!
Alle hjælpefunktioner på udførelsesniveau har en prototype
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Parametre til hjælpefunktioner overføres i registre r1—r5, og værdien returneres i registret r0. Der findes ingen funktioner, der tager mere end fem argumenter, og der er ikke planer om at tilføje support for dem i fremtiden.
Lad os se på den nye kernel helper og hvordan BPF overfører parametre. Lad os omskrive xdp-simple.bpf.c på følgende måde (de øvrige linjer er uændrede):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Vores program printer CPU-nummeret, som det kører på. Lad os kompilere det og se på koden:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
I linjerne 0-7 skriver vi en streng til stakken running on CPU%un, og derefter på linje 8 kalder vi den kendte bpf_get_smp_processor_id. I linjerne 9-12 forbereder vi argumenterne til hjælperen bpf_printk — registre r1, r2, r3. Hvorfor er der tre, og ikke to? Fordi bpf_printk — omkring den rigtige hjælper bpf_trace_printk, som kræver, at størrelsen af formatstrengen sendes.
Lad os nu tilføje et par linjer til xdp-simple.c, så vores program tilsluttes til grænsefladen lo og rent faktisk kører!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Her bruger vi funktionen bpf_set_link_xdp_fd, der forbinder BPF-programmer af typen XDP til netværksinterfaces. Vi har hardkodet interface-nummeret lo, som altid er lig med 1. Vi kører funktionen to gange for først at frakoble det gamle program, hvis det var tilsluttet. Bemærk, at vi nu ikke behøver at kalde pause eller en uendelig løkke: vores bootstrap-program vil afslutte, men BPF-programmet vil ikke blive destrueret, da det er tilsluttet til begivenhedskilden. Efter en vellykket indlæsning og tilslutning vil programmet køre for hver netværkspakke, der modtages på lo.
Lad os indlæse programmet og se på grænsefladen lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  navn simple  tag 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Programmet, vi har indlæst, har ID 669, og vi ser det samme ID på grænsefladen lo. Vi sender et par pakker til 127.0.0.1 (request + reply):
$ ping -c1 localhostog lad os nu se indholdet af den virtuelle debug-fil /sys/kernel/debug/tracing/trace_pipe, hvor bpf_printk skriver sine meddelelser:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
To pakker blev registreret på lo og behandlet på CPU0 — vores første fuldt fungerende meningsløse BPF-program har kørt!
Det er værd at bemærke, at bpf_printk det ikke er forgæves skriver til debug-filen: det er ikke den mest passende hjælper til brug i produktion, men vores mål var at vise noget simpelt.
Adgang til maps fra BPF-programmer
Eksempel: bruger en map fra BPF-programmet
I de foregående afsnit lærte vi at oprette og bruge maps fra brugerland, og lad os nu se på kernekomponenten. Vi begynder, som sædvanlig, med et eksempel. Lad os omskrive vores program xdp-simple.bpf.c som følger:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Vi har tilføjet definitionen af et map i starten af programmet woo: det er et array på 8 elementer, der gemmer værdier af typen u64 (i C ville vi definere et sådant array som u64 woo[8]). I programmet "xdp/simple" får vi nummeret på den aktuelle processor i variablen nøgle og derefter ved hjælp af hjælpefunktionen bpf_map_lookup_element får vi en peger til den tilsvarende post i arrayet, som vi øger med én. Oversat til dansk: vi tæller statistikken for, hvilken CPU de indkommende pakker blev behandlet på. Lad os prøve at køre programmet:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Lad os tjekke, at den er tilsluttet til lo og sende lidt pakker:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Nu ser vi på indholdet af arrayet:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Næsten alle processer blev behandlet på CPU7. Det er ikke vigtigt for os, det vigtigste er, at programmet fungerer, og at vi har forstået, hvordan man får adgang til kortene fra BPF-programmer — ved hjælp af .
Den mystiske pegger
Så vi kan få adgang fra BPF-programmet til kortet ved hjælp af kald af denne type
val = bpf_map_lookup_elem(&woo, &key);hvor hjælperfunktionen ser sådan ud
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)men vi sender jo en pointer &woo til en anonym struktur struct { ... }…
Hvis vi ser på assembleren af programmet, vil vi se, at værdien &woo faktisk ikke er defineret (linje 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       filformat elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
og findes i relokationerne:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

Relocation section '.relxdp/simple' at offset 0xe18 contains 1 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Men hvis vi ser på det allerede indlæste program, ser vi en pointer til det rigtige kort (linje 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Dermed kan vi konkludere, at ved opstarten af vores bootloader-programmet blev referencen til &woo blevet erstattet med noget af biblioteket libbpf. Til at begynde med, lad os se på output strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Vi ser, at libbpf oprettede et kort woo og derefter indlæste vores program simple. Lad os se nærmere på, hvordan vi indlæser programmet:
- vi kalder
xdp_simple_bpf__open_and_loadfra filenxdp-simple.skel.h - som kalder
xdp_simple_bpf__loadfra filenxdp-simple.skel.h - som kalder
bpf_object__load_skeletonfra filenlibbpf/src/libbpf.c - som kalder
bpf_object__load_xattraflibbpf/src/libbpf.c
Den sidste funktion vil, blandt andet, kalde bpf_object__create_maps, der opretter eller åbner eksisterende maps, og gør dem til filbeskrivelser. (Det er her, vi ser BPF_MAP_CREATE i udgangen strace.) Derefter kaldes funktionen bpf_object__relocate , som er af interesse for os, da vi husker, at vi har set woo i reloceringstabellen. Ved at undersøge den, ender vi til sidst i funktionen bpf_program__relocate, der håndterer :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Så vi tager vores instruktion
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 llog erstatter kilde-registeret med BPF_PSEUDO_MAP_FD, og den første IMM med filbeskrivelsen for vores map, og hvis den er for eksempel 0xdeadbeef, får vi instruktionen
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llDet er sådan, information om maps overføres til et specifikt indlæst BPF-program. Et map kan være oprettet ved hjælp af BPF_MAP_CREATE, eller åbnet via ID ved hjælp af BPF_MAP_GET_FD_BY_ID.
Sammenfattende, ved brug af libbpf er algoritmen som følger:
- under kompileringen oprettes der poster i reloceringstabellen for referencer til maps
libbpfåbner ELF-objektet, finder alle brugte maps og opretter filbeskrivelser for dem- filbeskrivelserne indlæses i kernen som en del af instruktionen
LD64
Som du forstår, er det ikke alt, og vi må kigge ind i kernen. Heldigvis har vi en ledetråd — vi har gemt værdien BPF_PSEUDO_MAP_FD i kilde-registeret og kan tage en log over det, hvilket vil føre os til helligdommen — kernel/bpf/verifier.c, hvor funktionen med det karakteristiske navn erstatter filbeskrivelsen med adressen på strukturen af typen struct bpf_map:
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) {
    ...

    f = fdget(insn[0].imm);
    map = __bpf_map_get(f);
    if (insn->src_reg == BPF_PSEUDO_MAP_FD) {
        addr = (unsigned long)map;
    }
    insn[0].imm = (u32)addr;
    insn[1].imm = addr >> 32;
(den fulde kode kan findes ). Så vi kan udvide vores algoritme:
- under indlæsningen af programmet kontrollerer verifieren korrektheden af brugen af map og indtaster adressen til den relevante struktur
struct bpf_map
Ved indlæsning af ELF-binære filer libbpf findes der mange andre hændelser, men vi vil diskutere det i rammerne af andre artikler.
Indlæs programmer og maps uden libbpf
Som lovet, her er et eksempel for læserne, der ønsker at vide, hvordan man opretter og indlæser et program, der bruger maps, uden hjælp libbpf. Dette kan være nyttigt, når du arbejder i et miljø, hvor du ikke kan samle afhængigheder, eller sparer hver enkelt byte, eller skriver et program af typen , der genererer BPF binærkode on-the-fly.
For at gøre det lettere at følge logikken, vil vi for disse formål omskrive vores eksempel xdp-simple. Den fulde og lidt udvidede kode for programmet, der behandles i dette eksempel, kan findes i denne .
Logikken i vores applikation er følgende:
- oprette et kort af typen
BPF_MAP_TYPE_ARRAYved hjælp af kommandoenBPF_MAP_CREATE, - oprette et program, der bruger dette kort,
- tilslutte programmet til interfacet
lo,
som oversættes til menneskesprog som
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Her map_create opretter et kort præcist ligesom vi gjorde i det første eksempel om systemopkald bpf — "kerne, vær venlig at lave et nyt kort i form af et array med 8 elementer af typen __u64 og returner mig en fildescriptor":
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Programmet indlæses også enkelt:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
Den svære del prog_load — er definitionen af vores BPF-program som et array af strukturer struct bpf_insn insns[]. Men da vi bruger et program, som vi har i C, kan vi snyde lidt:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Sammenfattende skal vi skrive 14 instruktioner i form af strukturer af typen struct bpf_insn (tip: Tag en dump ovenfra, læs sektionen om instruktioner, åbn og og prøv at bestemme struct bpf_insn insns[] selv):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* placeholder */

    /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
En øvelse for dem, der ikke skrev dette selv - find map_fd.
I vores program er der stadig en uløst del - xdp_attach. Desværre kan programmer af typen XDP ikke tilsluttes ved hjælp af systemopkald bpf. De mennesker, der skabte BPF og XDP, kom fra netværkssamfundet i Linux, hvilket betyder, at de brugte det mest fortrolige interface til deres (men ikke for almindelige mennesker) til interaktion med kernen: , se også . Den enkleste måde at implementere det på xdp_attach er at kopiere koden fra libbpf, nemlig fra filen , hvilket vi gjorde, og forkortede den lidt:
Velkommen til verden af netlink sockets
Åbner netlink socket af typen NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("netlink fejlrapportering understøttes ikke");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Vi læser fra en sådan socket:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "forkert pid");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); for meget kode at kopiere...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Endelig, her er vores funktion, der åbner socket'en og sender en særlig meddelelse til den, der indeholder en filbeskrivelse:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Så, alt er klar til testning:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Lad os se, om vores program er forbundet til lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Vi sender pinger og ser på kortet:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Found 8 elements
Hurra, alt fungerer. Bemærk for øvrigt, at vores kort endnu en gang vises som byte. Dette sker, fordi vi ikke har indlæst information om typer (BTF). Men det vil vi tale mere om næste gang. libbpf I denne sektion vil vi se på det minimale værktøjssæt til BPF-udviklerne.
Udviklingsværktøjer
Generelt kræver udviklingen af BPF-programmer ikke noget særligt — BPF fungerer på ethvert anstændigt distributionskernel, og programmer kan kompilere ved hjælp af
Generelt kræver udviklingen af BPF-programmer ikke noget særligt — BPF fungerer på enhver anstændig distributionskerne, og programmerne kompilieres ved hjælp af clang, som kan installeres fra pakken. Men da BPF er under udvikling, ændres kernen og værktøjerne konstant. Hvis du ikke ønsker at skrive BPF-programmer på gammeldags måde fra 2019, skal du samle
llvm/clangpahole- din egen kerne
bpftool
(Til reference: denne sektion og alle eksempler i artiklen blev kørt på Debian 10.)
llvm/clang
BPF fungerer sammen med LLVM, og selvom BPF-programmer for nylig også kan kompilere med gcc, foregår al nuværende udvikling for LLVM. Så først skal vi samle den nuværende version clang fra git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... mange timer senere
$
Nu kan vi kontrollere, om alt er blevet samlet korrekt:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  LLVM version 11.0.0git
  Optimeret bygning.
  Standardmål: x86_64-unknown-linux-gnu
  Vært CPU: znver1

  Registrerede mål:
    bpf    - BPF (vært endian)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - 32-bit X86: Pentium-Pro og op
    x86-64 - 64-bit X86: EM64T og AMD64
(Bygningsvejledning clang er taget af mig fra .)
Vi vil ikke installere de nyligt samlede programmer, men i stedet blot tilføje dem til PATH, for eksempel:
export PATH="`pwd`/bin:$PATH"(Dette kan tilføjes i .bashrc eller i en separat fil. Personligt tilføjer jeg sådanne ting i ~/bin/activate-llvm.sh og når det er nødvendigt, gør jeg . activate-llvm.sh.)
Pahole og BTF
Utility pahole bruges ved bygning af kernen for at skabe fejlsøgningsinformation i BTF-format. Vi vil ikke gå i dybden med detaljerne i BTF-teknologien i denne artikel, andet end at det er praktisk, og vi ønsker at bruge det. Så hvis du planlægger at samle din egen kerne, skal du først samle pahole (uden pahole du vil ikke kunne samle kernen med indstillingen CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Kerner til eksperimenter med BPF
Når man undersøger mulighederne for BPF, er det værd at samle sin egen kerne. Dette er overhovedet ikke nødvendigt, da du kan samle og indlæse BPF-programmer på en distributionskerne, men at have sin egen kerne giver mulighed for at bruge de nyeste BPF-funktioner, som kan komme i din distribution, måske først om flere måneder, eller i nogle tilfælde vil de slet ikke blive pakket ind i den nærmeste fremtid. At have sin egen kerne giver også en følelse af at kunne eksperimentere med koden.
For at bygge en kerne har du brug for, for det første selve kernen, og for det andet en konfigurationsfil til kernen. Til eksperimenter med BPF kan vi bruge en almindelig kerne eller en af udviklingskernerne. Historisk set er udviklingen af BPF foregået inden for det netværksmæssige fællesskab i Linux, og derfor går alle ændringer før eller siden gennem David Miller — vedligeholderen af den netværksmæssige del af Linux. Afhængigt af deres karakter — rettelser eller nye funktioner — havner de netværksmæssige ændringer i en af de to kerner — eller . Ændringer til BPF er på samme måde fordelt mellem og , som derefter bliver skudt i henholdsvis net og net-next. Se mere i og . Så vælg din kerne ud fra din smag og behov for systemets stabilitet, som du tester på (*-next kernerne er de mest ustabile blandt dem, der er nævnt).
Denne artikel omhandler ikke, hvordan man håndterer konfigurationsfilerne for kernen — det antages, at du enten allerede ved, hvordan man gør det, eller det selv. Men følgende instruktioner skulle være mere eller mindre tilstrækkelige til at få dit system til at fungere med BPF.
Download en af de ovennævnte kerner:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Saml en minimal fungerende kerne-konfiguration:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Aktiver BPF-indstillingerne i filen .config efter eget valg (sandsynligvis er selve CONFIG_BPF allerede aktiv, da det bruges af systemd). Her er en liste over indstillingerne fra den kerne, der blev brugt til denne artikel:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Here we can easily compile and install the modules and kernel (by the way, you can compile the kernel using just the compiled clang, adding CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
and reboot with the new kernel (I use kexec fra pakken kexec-tools):
v=5.8.0-rc6+ # if you are recompiling the current kernel, you can set v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
The most commonly used utility in the article will be the utility bpftool, delivered with the Linux kernel. It is written and maintained by BPF developers for BPF developers and allows you to manage all types of BPF objects — load programs, create and modify maps, explore the life of the BPF ecosystem, etc. Documentation in the form of source code for the man pages can be found or already compiled, .
På tidspunktet for skrivningen af artiklen bpftool is delivered ready-made only for RHEL, Fedora, and Ubuntu (see, for example, , which tells the unfinished story of packaging bpftool in Debian). But if you have already compiled your kernel, then compiling it is bpftool a piece of cake:
$ cd ${linux}/tools/bpf/bpftool
# ... enter the paths to the latest clang as described above
$ make -s

Auto-detecting system features:
...                        libbfd: [ on  ]
...        disassembler-four-args: [ on  ]
...                          zlib: [ on  ]
...                        libcap: [ on  ]
...               clang-bpf-co-re: [ on  ]

Auto-detecting system features:
...                        libelf: [ on  ]
...                          zlib: [ on  ]
...                           bpf: [ on  ]

$
(here ${linux} — is your kernel directory.) After executing these commands bpftool the build will be located in the directory ${linux}/tools/bpf/bpftool and can be added to the path (first of all for the user root) or simply copied to /usr/local/sbin.
It is best to compile using the latest bpftool , built as described above, and check if it was built correctly using, for example, the command clang$ sudo bpftool feature probe kernel Scanning system configuration... bpf() syscall for unprivileged users is enabled JIT compiler is enabled JIT compiler hardening is disabled JIT compiler kallsyms exports are enabled for root ...
which will show which BPF features are enabled in your kernel.By the way, the previous command can be run as
This is done similarly to the utilities from the package.
# bpftool f p kDette er gjort analogt med værktøjerne fra pakken iproute2, hvor vi kan sige for eksempel ip a s eth0 i stedet for ip addr show dev eth0.
Konklusion
BPF giver mulighed for effektivt at måle og ændre funktionaliteten i kernen 'on the fly'. Systemet er blevet meget vellykket, i bedste UNIX-tradition: en simpel mekanisme, der gør det muligt at (gen)programmere kernen, har givet en enorm mængde mennesker og organisationer mulighed for at eksperimentere. Og selvom eksperimenterne, ligesom udviklingen af selve BPF-infrastrukturen, langt fra er afsluttet, har systemet allerede en stabil ABI, der muliggør opbygningen af pålidelig og, vigtigst af alt, effektiv forretningslogik.
Det skal bemærkes, at efter min mening er teknologien blevet så populær, fordi den fra den ene side kan leg (maskinens arkitektur kan forstås nogenlunde på en aften), og fra den anden side - løse opgaver, der før dens fremkomst ikke kunne løses (smukt). Disse to komponenter tilsammen får folk til at eksperimentere og drømme, hvilket fører til, at der opstår nye og innovative løsninger.
Denne artikel, selvom den ikke blev alt for kort, fungerer kun som en introduktion til BPF-verdenen og beskriver ikke "avanserede" muligheder og vigtige dele af arkitekturen. Den videre plan er omtrent som følger: den næste artikel vil være en gennemgang af typerne af BPF-programmer (i kerne 5.8 understøttes 30 typer programmer), derefter vil vi endelig se på, hvordan man skriver rigtige applikationer i BPF med eksempler på kernekoblingsprogrammer, derefter kommer der tid til en mere dybdegående kursus om BPF-arkitekturen, og derefter - til eksempler på netværks- og sikkerhedsapplikationer for BPF.
De tidligere artikler i denne cyklus
Links
— dokumentation om BPF fra cilium, nærmere bestemt fra Daniel Borkman, en af skaberne og vedligeholderne af BPF. Dette er en af de første seriøse beskrivelser, der adskiller sig fra de andre ved, at Daniel præcist ved, hvad han skriver om, og der er ingen fejl. I dette dokument beskrives specifikt, hvordan man arbejder med BPF-programmer af typerne XDP og TC ved hjælp af det kendte værktøj
ipfra pakkeniproute2.— den originale fil med dokumentation om klassisk og derefter udvidet BPF. Det er nyttigt at læse, hvis du ønsker at dykke ned i assembly-sprog og tekniske detaljer om arkitekturen.
. Opdateres sjældent, men præcist, da Alexei Starovoitov (skaber af eBPF) og Andrii Nakryiko - (vedligeholder) skriver til den
libbpf).. En underholdende twitter-tråd fra Quentin Monnet med eksempler og hemmeligheder til brug af bpftool.
. Et gigantisk (og stadig vedligeholdt) linkbibliotek til BPF-dokumentation fra Quentin Monnet.
Kilde: habr.com
