

Hej alle sammen! Mit navn er Nikolaj Golov. Tidligere arbejdede jeg hos Avito, hvor jeg i seks år ledede Data Platform, hvilket betød, at jeg arbejdede med alle slags databaser: analytiske (Vertica, ClickHouse), streaming og OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). I løbet af denne tid har jeg fået indsigt i mange forskellige og specielle databaser samt de unikke anvendelsesscenarier for dem.
Nu arbejder jeg hos ManyChat. I bund og grund er det en startup - ny, ambitiøs og hurtigt voksende. Og da jeg første gang kom ind i virksomheden, opstod det klassiske spørgsmål: „Hvad bør en ung startup overveje at vælge fra markedet for DBMS og databaser?“
I denne artikel, baseret på mit foredrag ved , vil jeg svare på dette spørgsmål. Videoen af foredraget er tilgængelig på .
Almindeligt kendte databaser i 2020
Det er 2020, jeg kiggede mig omkring og så tre typer databaser.
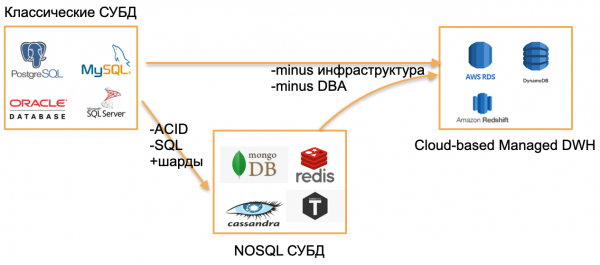
Den første type - klassiske OLTP databaser: PostgreSQL, SQL Server, Oracle, MySQL. De blev skrevet for lang tid siden, men er stadig relevante, fordi de er velkendte blandt udviklerfællesskabet.
Den anden type - databaser fra nullerne. De forsøgte at skille sig ud fra klassiske skabeloner ved at undvige SQL, traditionelle strukturer og ACID ved at implementere indbygget sharding og andre attraktive funktioner. For eksempel er dette Cassandra, MongoDB, Redis eller Tarantool. Alle disse løsninger ønskede at tilbyde markedet noget radikalt nyt og fandt deres niche, fordi de i bestemte opgaver viste sig at være ekstremt praktiske. Disse databaser vil jeg omtale med det overordnede begreb NOSQL.
Nullerne er slut, vi er blevet vant til NOSQL databaser, og verden er, efter min mening, gået til næste trin - til managed databaser. Disse databaser har samme kerne som klassiske OLTP databaser eller nye NoSQL. Men de kræver ikke DBA og DevOps, og de kører på administreret hardware i skyen. For udvikleren er det "bare en database", der fungerer et sted, og hvordan den er installeret på serveren, hvem der har konfigureret serveren, og hvem der opdaterer den, bekymrer ingen sig om.
Eksempler på sådanne databaser:
- AWS RDS - managed wrapper over PostgreSQL/MySQL.
- DynamoDB - AWS's svar på en dokumentbaseret database, der minder om Redis og MongoDB.
- Amazon Redshift - managed analytisk database.
I bund og grund er det gamle databaser, men løftet op i et managed miljø, uden behov for hardware arbejde.
Bemærk. Eksemplerne er taget fra AWS-miljøet, men deres analoger findes også i Microsoft Azure, Google Cloud eller Yandex.Cloud.
Hvad er så nyt i alt dette? I 2020 er der ikke noget af dette.
Serverless koncept
Virkelig nye på markedet i 2020 er serverless eller serverløse løsninger.
Jeg vil forsøge at forklare, hvad det betyder, ved at bruge et almindeligt service- eller backend-applikationseksample.
For at implementere en almindelig backend-applikation køber eller lejer vi en server, kopierer koden til den, offentliggør et endpoint, og betaler regelmæssigt for leje, elektricitet og datacenteroplysninger. Dette er den standardprocedure.
Er der en anden måde? Med serverless-tjenester er det muligt.
Hvad er essensen af denne tilgang: ingen server, ikke engang leje af en virtuel instans i skyen. For at implementere en service kopierer vi koden (funktioner) til et repository og offentliggør et endpoint. Derefter betaler vi blot for hver function-anrop, helt uafhængigt af det hardware, hvor den kører.
Jeg vil forsøge at illustrere denne tilgang med billeder.
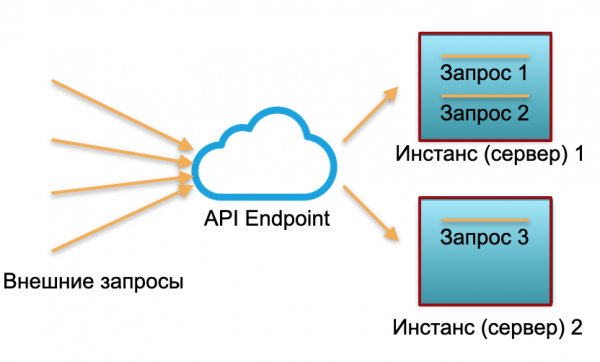
Klassisk deployment. Vi har en service med en bestemt belastning. Vi sætter to instanser op: fysiske servere eller instanser i AWS. Eksterne anmodninger rettes mod disse instanser, som derefter behandler dem.
Som vist på billedet, er serverne ikke udnyttet ens. En er udnyttet på 100%, der er to anmodninger, mens den anden kun er på 50% — den står delvist stille. Hvis der kommer ikke tre anmodninger, men 30, vil hele systemet ikke kunne håndtere belastningen og begynde at hænge.
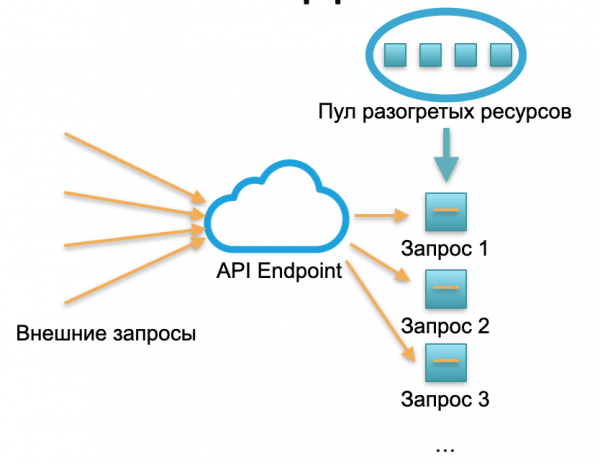
Serverless deployment. I et serverless-miljø har en sådan service ingen instanser og servere. Der er en pulje af opvarmede ressourcer — små forberedte Docker-containere med implementeret kode for funktionen. Systemet modtager eksterne anmodninger, og for hver enkelt hæver serverless-rammen et lille container med koden: det behandler netop denne anmodning og dræber containeren.
Én anmodning — én hævet container, 1000 anmodninger — 1000 containere. Og implementeringen på fysiske servere er allerede arbejdet fra cloud-udbyderen. Det er helt skjult af serverless-rammen. I dette koncept betaler vi for hver anmodning. For eksempel, hvis der kommer én anmodning om dagen — har vi betalt for én anmodning, kommer der en million på et minut — har vi betalt for en million. Eller pr. sekund, det sker også.
Koncepten for publicering af serverless funktioner er egnet til stateless tjenester. Hvis du derimod har brug for en stateful tjeneste, tilføjer vi en database til tjenesten. I dette tilfælde, når det kommer til arbejde med state, skriver og læser hver stateful funktion simpelthen fra databasen. Og det kan være fra en hvilken som helst af de tre typer databaser, der blev beskrevet i starten af artiklen.
Hvad er den samlede begrænsning for alle disse databaser? Det er omkostningerne ved en konstant anvendt cloud- eller hardware-server (eller flere servere). Uanset om vi bruger en klassisk database eller en managed database, er vi stadig nødt til at betale for hardware, elektricitet og leje af datacenter 24/7, uanset om vi har DevOps og administrator eller ej. Hvis vi har en klassisk database, betaler vi for master og slave. For en højtydende sharded database betaler vi for 10, 20 eller 30 servere, og det er en konstant udgift.
Tilstedeværelsen af permanent reserverede servere i udgiftsstrukturen blev tidligere betragtet som en uundgåelig plage. Almindelige databaser har også andre vanskeligheder, såsom grænser for antallet af forbindelser, begrænsninger for skalerbarhed og geodistribueret konsensus — nogle af disse kan løses i bestemte databaser, men ikke alle på én gang og ikke perfekt.
Serverless database — teori
Spørgsmålet i 2020: Kan man også lave en database serverless? Alle har hørt om serverless backend… lad os også forsøge at gøre databasen serverless.
Det lyder mærkeligt, fordi databasen jo er en stateful tjeneste, som ikke helt egner sig til serverless infrastruktur. Desuden er state for databasen meget stor: gigabyte, terabyte, og i analytiske databaser endda petabyte. Det kan ikke bare nemt implementeres i letvægts Docker-containere.
På den anden side er praktisk taget alle moderne databaser fyldt med en enorm mængde logik og komponenter: transaktioner, validering af integritet, procedurer, relationelle afhængigheder og meget logik. En ganske stor del af logikken i databasen kræver blot en lille smule state. Gigabyte og terabyte anvendes kun af en lille del af logikken i databasen, der er knyttet til konkret udførelse af forespørgsler.
Som følge heraf er idéen: hvis en del af logikken tillader stateless udførelse, hvorfor så ikke opdele databasen i stateful og stateless dele.
Serverless til OLAP-løsninger
Lad os se på, hvordan opdelingen af databasen i stateful og stateless dele kan se ud med praktiske eksempler.
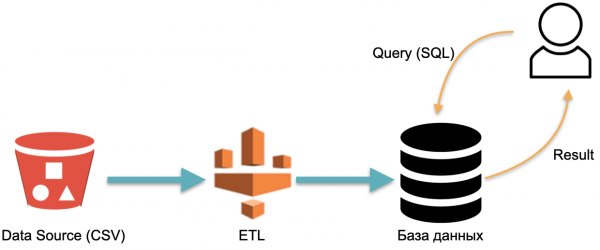
For example, we have an analytical database: external data (red cylinder on the left), an ETL process that loads data into the database, and an analyst who sends SQL queries to the database. This is a classic schema of how a data warehouse operates.
In this scheme, ETL is executed conditionally once. After that, you need to constantly pay for the servers on which the database with the ETL-loaded data operates to have something to query.
Let's consider an alternative approach implemented in AWS Athena Serverless. Here, there is no permanently allocated hardware that stores the loaded data. Instead:
- The user sends an SQL query to Athena. The Athena optimizer analyzes the SQL query and looks for specific data in the metadata storage needed to fulfill the request.
- Based on the collected data, the optimizer loads the necessary data from external sources into temporary storage (a temporary database).
- In the temporary storage, the SQL query from the user is executed, and the result is returned to the user.
- The temporary storage is cleared, and resources are freed up.
In this architecture, we only pay for the query execution process. No queries = no costs.
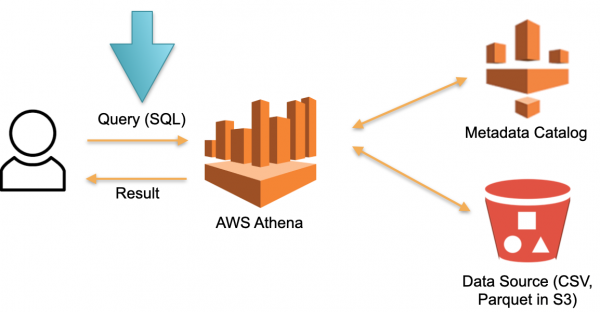
This is a working approach, and it is implemented not only in Athena Serverless but also in Redshift Spectrum (in AWS).
The example of Athena shows that the Serverless database operates on real queries with tens and hundreds of terabytes of data. For hundreds of terabytes, we need hundreds of servers, but we don't have to pay for them — we pay for the queries. The speed of each query is (very) low compared to specialized analytical databases like Vertica, but we do not pay for downtime.
Such a database is applicable for rare analytical ad-hoc queries. For example, when we spontaneously decide to test a hypothesis on a massive volume of data. For these cases, Athena is ideal. For regular queries, such a system becomes costly. In this case, cache the data in some specialized solution.
Serverless for OLTP solutions
The previous example discussed OLAP tasks (analytical). Now, let's consider OLTP tasks.
Lad os forestille os en skalerbar PostgreSQL eller MySQL. Lad os oprette en almindelig managed instance PostgreSQL eller MySQL med minimale ressourcer. Når der kommer mere belastning på instansen, tilslutter vi ekstra replikaer, som vi fordeler en del af læsebelastningen til. Hvis der ikke er nogen forespørgsler og belastning, slukker vi for replikaerne. Den første instans er master, mens de øvrige er replikaer.
Denne idé er realiseret i en database kaldet Aurora Serverless AWS. Princippet er enkelt: forespørgsler fra eksterne applikationer modtages af en proxy-flåde. Når den ser en stigning i belastningen, tildeler den beregningsressourcer fra forvarmede minimale instanser - tilslutningen sker så hurtigt som muligt. Afbrydelse af instanserne sker også på samme måde.
Inden for Aurora findes begrebet Aurora Capacity Unit, ACU. Dette er (betegnet) en instans (server). Hver specifik ACU kan være master eller slave. Hver Capacity Unit har sit eget RAM, processor og minimal disk. Dermed er én master, mens de øvrige er read-only replikaer.
Antallet af aktive Aurora Capacity Units er en konfigurerbar parameter. Det minimale antal kan være en eller nul (i så fald virker databasen ikke, hvis der ikke er forespørgsler).
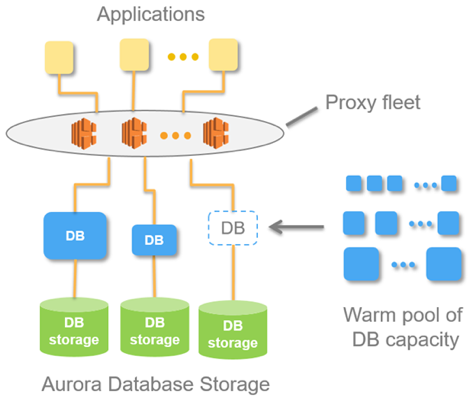
Når databasen modtager forespørgsler, aktiverer proxy-flåden Aurora Capacity Units, hvilket øger systemets ydeevne. Muligheden for at øge og mindske ressourcerne gør det muligt for systemet at "jonglere" med ressourcerne: automatisk at tage individuelle ACU offline (ved at erstatte dem med nye) og anvende alle aktuelle opdateringer på de offline ressourcer.
Aurora Serverless-databasen kan skalere læsebelastningen. Men dette nævnes ikke direkte i dokumentationen. Der kan opstå en følelse af, at de kan konfigurere multi-master. Der er dog ikke nogen magi involveret.
Denne database er velegnet til at spare penge på systemer med uforudsigelig adgang. For eksempel, når vi opretter MVP'er eller marketinglandingssider, forventer vi normalt ikke stabil belastning. Derfor betaler vi ikke for instanser, når der ikke er adgang. Når der pludselig opstår belastning, for eksempel efter en konference eller reklamekampagne, besøger mange mennesker siden, og belastningen stiger pludseligt. Aurora Serverless håndterer automatisk denne belastning og tilslutter hurtigt de nødvendige ressourcer (ACU). Efter konferencen glemmer alle prototypen, serverne (ACU) slukker, og omkostningerne falder til nul — det er praktisk.
Denne løsning er ikke velegnet til stabil høj belastning, fordi den ikke kan skalere skrivebelastningen. Alle disse tilslutninger og frakoblinger af ressourcer sker på et såkaldt 'scale point' — det tidspunkt, hvor databasen ikke er under en transaktion, og der ikke holdes midlertidige tabeller. For eksempel kan der i løbet af en uge ikke ske et scale point, og databasen fungerer med de samme ressourcer og kan simpelthen hverken udvides eller samles.
Der er ikke noget magisk — det er almindelig PostgreSQL. Men processen med at tilføje maskiner og frakoble dem er delvist automatiseret.
Serverless by design
Aurora Serverless er en gammel database, der er omskrevet til skyen for at udnytte de unikke fordele ved Serverless. Og nu vil jeg fortælle om en database, der oprindeligt er skrevet til skyen, til en serverless tilgang — Serverless-by-design. Den blev straks udviklet uden antagelsen om, at den kørte på fysiske servere.
Denne database kaldes Snowflake. Den har tre nøglekomponenter.
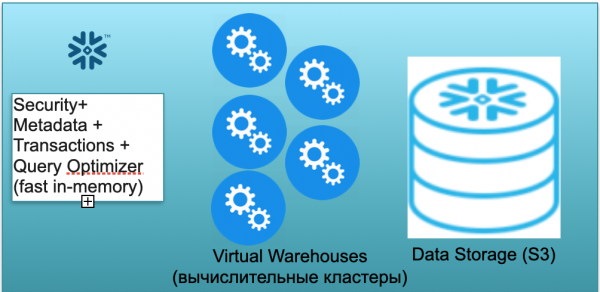
Den første er metadatabaseblokken. Det er en hurtig in-memory tjeneste, der håndterer sikkerhed, metadata, transaktioner, og optimering af forespørgsler (på illustrationen til venstre).
Den anden blok er et stort antal virtuelle compute-klynger til beregninger (i illustrationen — en samling blå cirkler).
Den tredje blok er et datalagringssystem baseret på S3. S3 er en ubegribelig objektlagring i AWS, lidt som en ubegribelig Dropbox til virksomheder.
Lad os se, hvordan Snowflake fungerer under antagelse af en kold start. Det vil sige, at databasen eksisterer, dataene er indlæst, og der er ingen aktive forespørgsler. Hvis der ikke er nogen forespørgsler mod databasen, så har vi den hurtige in-memory Metadata service (den første blok) kørende. Og vi har et S3-lager, hvor tabellerne er gemt, opdelt i såkaldte mikropartitioner. For enkelhedens skyld: hvis tabellen indeholder handler, så er mikropartitionerne dage med handler. Hver dag er en separat mikropartition, en separat fil. Når databasen kører i dette tilstand, betaler du kun for det plads, der optages af dataene. Desuden er taksten for pladsen meget lav (især i betragtning af den betydelige komprimering). Metadata tjenesten kører også konstant, men kræver ikke mange ressourcer for at optimere forespørgsler, og tjenesten kan betragtes som betinget gratis.
Lad os nu forestille os, at en bruger kommer til vores database og sender en SQL-forespørgsel. SQL-forespørgslen sendes straks til behandling i Metadata tjenesten. Tjenesten analyserer forespørgslen, de tilgængelige data, brugerens rettigheder, og hvis alt er i orden, udarbejder den en behandlingsplan for forespørgslen.
Derefter initierer tjenesten opstarten af beregningsklusteret. Beregningsklusteret er et cluster af servere, der udfører beregninger. Det er et cluster, der kan indeholde 1 server, 2 servere, 4, 8, 16, 32 — så mange du ønsker. Du sender en forespørgsel, og der startes straks dette cluster. Det tager virkelig kun sekunder.
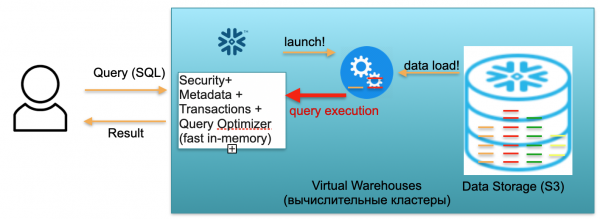
Når klyngen er startet, begynder mikropartitioner, som er nødvendige for at behandle din anmodning, at blive kopieret fra S3 til klyngen. Det vil sige, lad os forestille os, at der til udførelsen af en SQL-anmodning kræves to partitioner fra én tabel og én fra en anden. I så fald kopieres kun de tre nødvendige partitioner til klyngen, ikke alle tabellerne i sin helhed. Netop fordi alt er placeret i samme datacenter og forbundet med meget hurtige forbindelser, foregår hele overførselsprocessen meget hurtigt: på sekunder, meget sjældent på minutter, medmindre det drejer sig om nogle ekstremt komplekse anmodninger. Derfor kopieres mikropartitioner til beregningsklyngen, og når dette er afsluttet, udføres SQL-anmodningen på denne beregningsklynge. Resultatet af denne anmodning kan være en enkelt række, flere rækker eller en tabel - de sendes til brugeren, så de kan eksporteres, vises i deres BI-værktøj eller bruges på anden vis.
Hver SQL-anmodning kan ikke kun læse aggregater fra tidligere indlæste data, men også indlæse/andre nye data i databasen. Det vil sige, det kan være en anmodning, der for eksempel foretage en indsættelse af nye poster i en anden tabel, hvilket fører til oprettelsen af en ny partition på beregningsklyngen, som automatisk gemmes i det samlede S3-lager.
Det ovenfor beskrevne scenarie, fra brugerens ankomst til klyngens oprettelse, dataloading, udførelse af forespørgsler og modtagelse af resultater, afregnes med en takst pr. minut for brugen af den oprettede virtuelle beregningsklynge, den virtuelle warehouse. Taksten varierer afhængigt af AWS-zonen og klyngeens størrelse, men i gennemsnit koster det nogle få dollars i timen. En klynge med fire maskiner koster det dobbelte af en med to maskiner, og en med otte maskiner koster yderligere det dobbelte. Der er muligheder for 16, 32 maskiner, alt efter kompleksiteten af forespørgslerne. Men du betaler kun for de minutter, hvor klyngen faktisk er aktiv, fordi når der ikke er nogen forespørgsler, kan du næsten trække hænderne væk, og efter 5-10 minutters ventetid (justerbar parameter) slukker den selv, frigiver ressourcer og bliver gratis.
Det er helt realistisk, at du sender en forespørgsel, og klustret dukker op, så at sige, på et minut. Det tager et minut at beregne, yderligere fem minutter til at slukke, og du betaler i sidste ende for syv minutters brug af dette kluster i stedet for måneder og år.
Det første scenarie beskrev brugen af Snowflake i en enkeltbruger-opsætning. Lad os nu forestille os, at der er mange brugere, hvilket er tættere på et realistisk scenarie.
Lad os antage, at vi har mange analytikere og Tableau-rapporter, der konstant bombarderer vores database med et stort antal enkle analytiske SQL-forespørgsler.
Derudover, lad os antage, at vi har opfindsomme dataforskere, der forsøger at gøre frygtelige ting med dataene, arbejde med titusinder af terabyte, analysere milliarder og billioner af rækker af data.
For de to typer belastning, der er beskrevet ovenfor, tillader Snowflake at opsætte flere uafhængige beregningsklustre med forskellig kapacitet. Disse beregningsklustre arbejder uafhængigt, men med fælles konsistente data.
For et stort antal lette forespørgsler kan du opsætte 2-3 små klustre, hver med en størrelse på, lad os sige, 2 maskiner. Denne adfærd kan implementeres, blandt andet, ved hjælp af automatiske indstillinger. Det vil sige, at du siger: "Snowflake, opsæt et lille kluster. Hvis belastningen på det overstiger et bestemt parameter, opsæt en tilsvarende anden eller tredje. Når belastningen begynder at falde — sluk for de overskydende." Så alle får nok ressourcer uanset hvor mange analytikere der kommer og begynder at se rapporterne.
Hvis analytikerne derimod sover, og ingen ser på rapporterne, kan klustrene helt slukkes, og du stopper med at betale for dem.
For tunge forespørgsler (fra dataforskere) kan du opsætte et meget stort kluster med for eksempel 32 maskiner. Dette kluster vil også kun blive betalt for de minutter og timer, hvor dit enorme forespørgsel kører.
Den ovenfor beskrevne mulighed gør det muligt at opdele ikke kun 2, men også flere typer belastninger (ETL, overvågning, materialisering af rapporter,…).
Lad os opsummere Snowflake. Databasen kombinerer en smuk idé med en fungerende implementering. I ManyChat bruger vi Snowflake til analyse af alle tilgængelige data. Vi har ikke tre klynger som i eksemplet, men mellem 5 og 9, forskellige størrelser. Vi har nogle med 16 maskiner, 2-maskiner, og der er også super små 1-maskine klynger til visse opgaver. De fordeler belastningen effektivt og hjælper os med at spare penge.
Databasen skalerer effektivt både læse- og skrivebelastningen. Dette er en betydelig forskel og et stort gennembrud sammenlignet med "Aurora", som kun kunne håndtere læsebelastning. Snowflake muliggør skalering af disse beregningsklynger til også at håndtere skrivebelastning. Som nævnt bruger vi i ManyChat flere klynger; små og super små klynger bruges primært til ETL, til dataindlæsning. Analytikere arbejder allerede på mellemstore klynger, som slet ikke påvirkes af ETL-belastningen, og derfor arbejder de meget hurtigt.
Derfor er databasen velegnet til OLAP-opgaver. Desværre er den dog endnu ikke anvendelig til OLTP-belastninger. For det første er databasen kolonnebaseret, med alle de konsekvenser, det indebærer. For det andet er den tilgang, hvor man efter behov aktiverer en beregningsklynge for hver forespørgsel og fylder den med data, desværre ikke hurtig nok til OLTP-belastninger. Sekunder af ventetid for OLAP-opgaver er normalt, men for OLTP-opgaver er det uacceptabelt; 100 ms ville være bedre, og 10 ms ville være endnu bedre.
Resultat
En serverless database er mulig ved at opdele databasen i stateless og stateful dele. Du har måske bemærket, at i alle de nævnte eksempler er den stateful del, så at sige, opbevaringen af mikropartitioner i S3, mens den stateless del er optimereren, der arbejder med metadata, håndterer sikkerhedsspørgsmål, som kan aktiveres som uafhængige, letvægts stateless services.
Udførelsen af SQL-forespørgsler kan også betragtes som tjenester med en let state, der kan aktivere i serverless tilstand, ligesom beregningsklynger i Snowflake, hente kun de nødvendige data, udføre forespørgslen og "slukke".
Serverless databaser på produktionsniveau er nu tilgængelige og fungerer. Disse serverless databaser er allerede klar til at håndtere OLAP-opgaver. Desværre anvendes de til OLTP-opgaver... med nuancer, da der er begrænsninger. På den ene side er det et minus. Men på den anden side er det en mulighed. Måske finder nogle af læserne en måde at gøre en OLTP-database helt serverless uden begrænsninger i Aurora.
Jeg håber, det har været interessant for dig. For serverless fremtiden 🙂
Kilde: habr.com
